


Python怎么实现Apollo配置热更新:监听机制与代码示例
深入解析Python接入携程Apollo配置中心实现配置热更新的技术方案,包括HTTP长轮询监听机制、多线程安全缓存、事件驱动回调设计与可直接运行的完整代码示例。
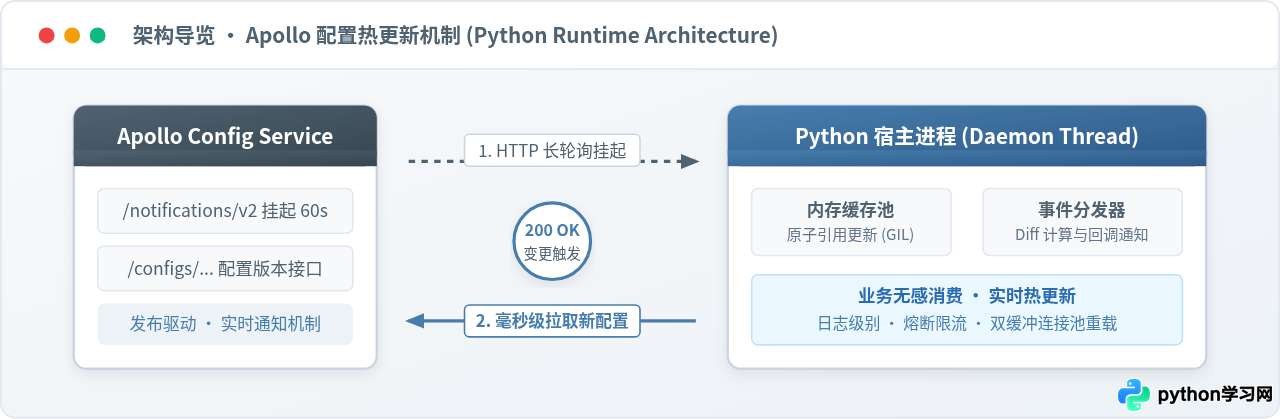
一、Apollo 配置热更新的底层通信机制
很多初学者容易将配置热更新理解为“写一个 while 循环,每隔几秒请求一次 API”。这种传统短轮询(Short Polling)存在无法调和的矛盾:若轮询间隔过短(如 1 秒),成百上千个微服务实例会迅速压垮 Apollo 服务端;若间隔拉长(如 1 分钟),配置生效的延迟又无法满足线上紧急降级或故障止血的要求。
Apollo 官方客户端采用的标准通信协议是基于 HTTP 的长轮询机制(Long Polling)。其交互由两个核心接口协作完成:
- 通知检测接口(
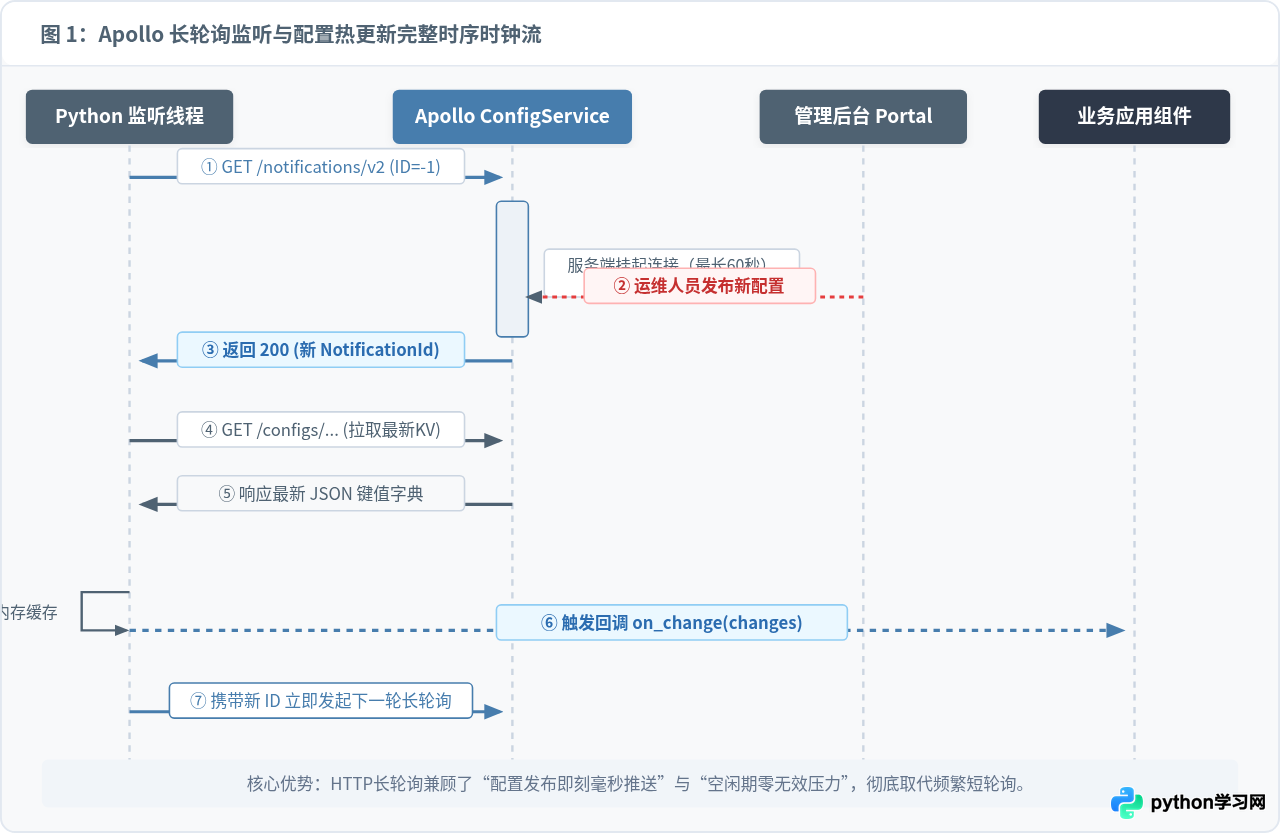
/notifications/v2):客户端发起 GET 请求,携带应用标识appId、集群名cluster以及各命名空间当前持有的notificationId。服务端收到请求后比对版本:若配置无变动,该 HTTP 连接将被挂起(默认保持 60 秒);若挂起期间有配置发布,服务端立即返回 HTTP 200 及最新的notificationId;若 60 秒内始终无变动,服务端返回 HTTP 304(Not Modified)。 - 完整配置拉取接口(
/configs/{appId}/{cluster}/{namespace}):只有当通知接口返回了 HTTP 200 且notificationId发生了递增时,客户端才会去请求此接口,拉取包含全部最新 Key-Value 的完整 JSON 字典。
二、Python 客户端的核心架构设计
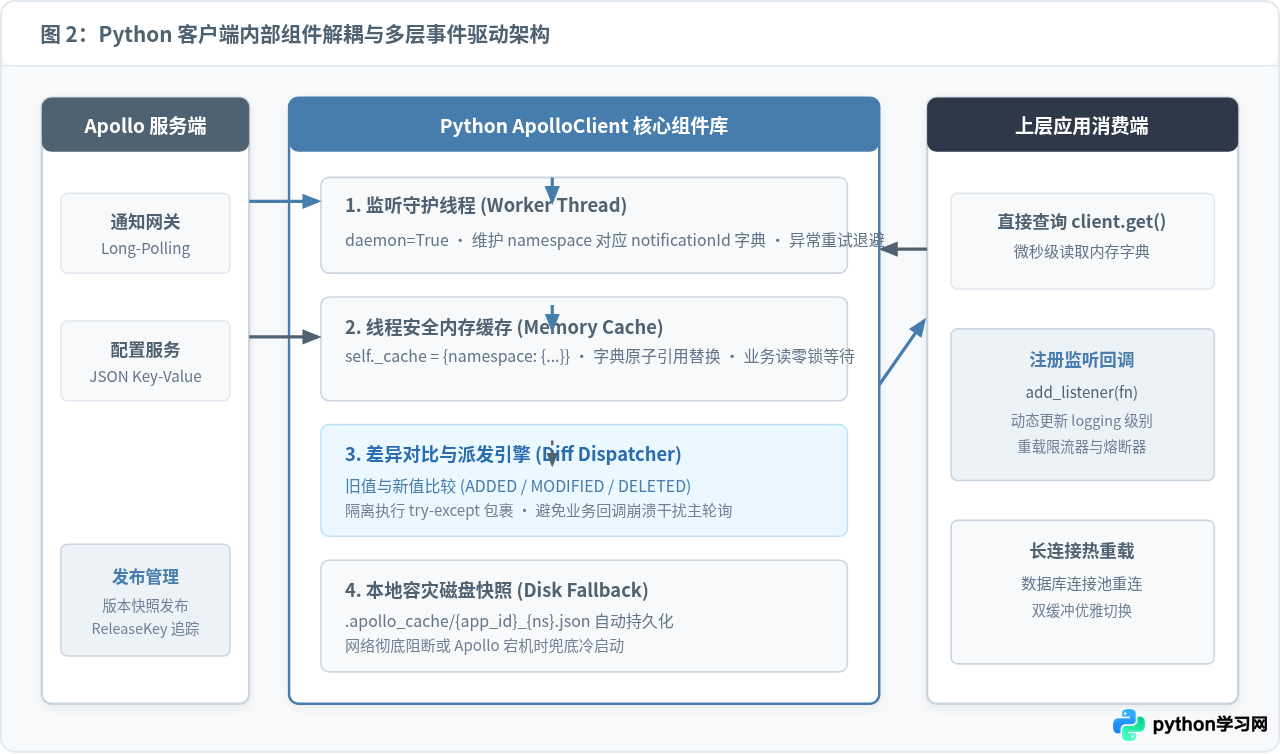
在 Python 进程中实现一套稳定可靠的热更新机制,需要在客户端内部完成线程管理、内存存储与事件通知的解耦。整体架构包含四个关键构件:
- 后台监听工作线程(Daemon Worker):必须将该线程设置为
daemon=True,保证主业务进程在退出或被终止时不会被监听循环阻塞。工作线程以无限循环的方式向 Apollo 发起/notifications/v2请求。 - 通知状态映射表(Notification Map):使用字典记录每个命名空间(Namespace)当前的最新
notificationId。首次启动时初始化为-1,服务端会返回当前的最新 ID 而不会误判为配置变更。 - 线程安全的内存缓存(In-Memory Cache):客户端内部维护一个形如
{namespace: {key: value}}的字典。在 CPython 环境下,对字典变量的引用赋值(如self._cache[namespace] = new_dict)由全局解释器锁(GIL)提供原子性保障。业务线程读取配置时直接读字典,全程无锁、无阻塞,性能达到微秒级。 - 观察者回调机制(Listener Callback Registry):允许业务代码针对特定命名空间或特定 Key 注册回调函数。当新旧配置拉取完成时,客户端对比差异(Diff),将发生变动的字段与新旧值作为参数逐一通知注册函数。
三、轻量级 Apollo 热更新客户端代码实现
以下给出一个基于标准库 threading 与 requests 实现的完整 Python 客户端代码示例。该代码实现了长轮询监听、配置拉取、增量差异比对以及回调触发逻辑,可以直接保存并在实际环境中运行:
import json
import logging
import threading
import time
from typing import Callable, Dict, Any, Optional
import requests

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(threadName)s: %(message)s")
logger = logging.getLogger("ApolloClient")

class ApolloClient:
    def __init__(self, config_server_url: str, app_id: str, cluster: str = "default", namespaces: list = None):
        """
        初始化 Apollo 客户端
        :param config_server_url: Apollo Config Service 地址,如 http://apollo-config.local:8080
        :param app_id: 应用唯一 ID
        :param cluster: 集群名称,默认 default
        :param namespaces: 需要监听的命名空间列表,默认包含 application
        """
        self.server_url = config_server_url.rstrip("/")
        self.app_id = app_id
        self.cluster = cluster
        self.namespaces = namespaces or ["application"]

        # 内部状态记录
        self._notifications: Dict[str, int] = {ns: -1 for ns in self.namespaces}
        self._cache: Dict[str, Dict[str, Any]] = {ns: {} for ns in self.namespaces}
        self._listeners: Dict[str, list] = {ns: [] for ns in self.namespaces}

        self._running = False
        self._session = requests.Session()
        self._thread: Optional[threading.Thread] = None

    def start(self):
        """启动客户端:先全量拉取一次初始配置,再启动后台长轮询守护线程"""
        logger.info("正在执行首次全量配置拉取...")
        for ns in self.namespaces:
            self._fetch_configs(ns)

        self._running = True
        self._thread = threading.Thread(target=self._listener_loop, name="ApolloWatcherThread", daemon=True)
        self._thread.start()
        logger.info("Apollo 监听守护线程启动完毕")

    def stop(self):
        """停止监听线程"""
        self._running = False
        if self._thread and self._thread.is_alive():
            self._thread.join(timeout=2.0)
        logger.info("Apollo 监听客户端已停止")

    def get(self, key: str, default: Any = None, namespace: str = "application") -> Any:
        """从内存缓存中高速读取配置项(业务线程安全读取)"""
        ns_cache = self._cache.get(namespace, {})
        return ns_cache.get(key, default)

    def add_listener(self, callback: Callable[[str, Dict[str, Any]], None], namespace: str = "application"):
        """
        注册配置变更监听器
        :param callback: 回调函数,入参为 (namespace, change_details)
        :param namespace: 监听的目标命名空间
        """
        if namespace in self._listeners:
            self._listeners[namespace].append(callback)

    def _fetch_configs(self, namespace: str):
        """调用 /configs/... 接口拉取全量 Key-Value,并触发差异对比与更新"""
        url = f"{self.server_url}/configs/{self.app_id}/{self.cluster}/{namespace}"
        try:
            resp = self._session.get(url, timeout=5)
            if resp.status_code == 200:
                data = resp.json()
                new_configurations = data.get("configurations", {})
                old_configurations = self._cache.get(namespace, {})

                # 计算新旧配置的增量差异
                changes = self._compute_diff(old_configurations, new_configurations)

                # 原子替换内存缓存指针
                self._cache[namespace] = new_configurations
                logger.info(f"命名空间 [{namespace}] 配置已更新,当前共包含 {len(new_configurations)} 项配置")

                # 若存在差异且注册了监听器,派发事件
                if changes:
                    self._dispatch_listeners(namespace, changes)
            else:
                logger.warning(f"拉取配置失败 [{namespace}],HTTP 状态码: {resp.status_code}")
        except Exception as e:
            logger.error(f"拉取配置发生异常 [{namespace}]: {e}")

    def _listener_loop(self):
        """长轮询核心主循环"""
        while self._running:
            try:
                notifications_param = [
                    {"namespaceName": ns, "notificationId": self._notifications[ns]}
                    for ns in self.namespaces
                ]
                params = {
                    "appId": self.app_id,
                    "cluster": self.cluster,
                    "notifications": json.dumps(notifications_param)
                }
                url = f"{self.server_url}/notifications/v2"

                # 长轮询挂起最长为60s,客户端设置超时时间为75s以包容网络传输耗时
                response = self._session.get(url, params=params, timeout=75)

                if response.status_code == 200:
                    # 收到变更通知
                    notification_list = response.json()
                    for item in notification_list:
                        ns = item.get("namespaceName")
                        new_id = item.get("notificationId")
                        if ns in self._notifications:
                            # 仅在 notificationId 递增时拉取新配置,防止重复触发
                            if new_id > self._notifications[ns]:
                                self._notifications[ns] = new_id
                                logger.info(f"检测到配置变更: 命名空间 {ns} 推进至版本 {new_id}")
                                self._fetch_configs(ns)

                elif response.status_code == 304:
                    # 60秒无变动,属于正常超时,立即进入下一次长轮询
                    logger.debug("长轮询挂起超时(304),配置未变动,继续挂起监听...")
                else:
                    logger.warning(f"长轮询接口异常,HTTP 状态码: {response.status_code}")
                    time.sleep(3)

            except requests.exceptions.Timeout:
                # 客户端网络超时,继续重试
                continue
            except Exception as ex:
                logger.error(f"长轮询发生异常: {ex},等待 3 秒后重试...")
                time.sleep(3)

    def _compute_diff(self, old: Dict[str, Any], new: Dict[str, Any]) -> Dict[str, Dict[str, Any]]:
        """计算键值差异:识别新增、修改与删除"""
        changes = {}
        for k, v in new.items():
            if k not in old:
                changes[k] = {"type": "ADDED", "old": None, "new": v}
            elif old[k] != v:
                changes[k] = {"type": "MODIFIED", "old": old[k], "new": v}
        for k, v in old.items():
            if k not in new:
                changes[k] = {"type": "DELETED", "old": v, "new": None}
        return changes

    def _dispatch_listeners(self, namespace: str, changes: Dict[str, Dict[str, Any]]):
        """逐一触发监听回调(严格隔离异常)"""
        for listener in self._listeners.get(namespace, []):
            try:
                listener(namespace, changes)
            except Exception as e:
                logger.error(f"执行监听回调发生异常: {e}", exc_info=True)
客户端运行与控制台输出示例
通过下述示例代码,我们可以启动客户端、注册配置监听并模拟业务代码消费配置:
# 业务端使用示例
if __name__ == "__main__":
    # 实例化 Apollo 客户端
    client = ApolloClient(
        config_server_url="http://127.0.0.1:8080",
        app_id="order-service",
        cluster="default",
        namespaces=["application"]
    )

    # 注册配置热更新回调函数
    def on_config_change(namespace: str, changes: dict):
        print(f"\n>>> [业务回调接收到变更通知 - 命名空间: {namespace}]")
        for key, change in changes.items():
            print(f"    变更项: {key} | 操作: {change['type']} | 旧值: {change['old']} -> 新值: {change['new']}")

    client.add_listener(on_config_change)
    client.start()

    # 业务主循环:持续从客户端读取最新配置
    try:
        while True:
            timeout_ms = client.get("request_timeout_ms", default=3000)
            log_level = client.get("app_log_level", default="INFO")
            print(f"[业务运行中] 当前生效的超时配置: {timeout_ms}ms, 日志级别: {log_level}")
            time.sleep(5)
    except KeyboardInterrupt:
        client.stop()
2026-11-01 20:00:00 [INFO] MainThread: 正在执行首次全量配置拉取...
2026-11-01 20:00:00 [INFO] MainThread: 命名空间 [application] 配置已更新,当前共包含 2 项配置
2026-11-01 20:00:00 [INFO] MainThread: Apollo 监听守护线程启动完毕
[业务运行中] 当前生效的超时配置: 3000ms, 日志级别: INFO
2026-11-01 20:00:08 [INFO] ApolloWatcherThread: 检测到配置变更: 命名空间 application 推进至版本 104
2026-11-01 20:00:08 [INFO] ApolloWatcherThread: 命名空间 [application] 配置已更新,当前共包含 2 项配置
>>> [业务回调接收到变更通知 - 命名空间: application]
变更项: app_log_level | 操作: MODIFIED | 旧值: INFO -> 新值: DEBUG
[业务运行中] 当前生效的超时配置: 3000ms, 日志级别: DEBUG
四、业务场景中的两类热更模式与落地实战
在实际生产系统中,单纯将配置值更新到字典并不总能解决所有问题。根据配置所驱动的底层资源属性,热更新可以分为无状态标量热更与有状态资源热重载两种不同模式。
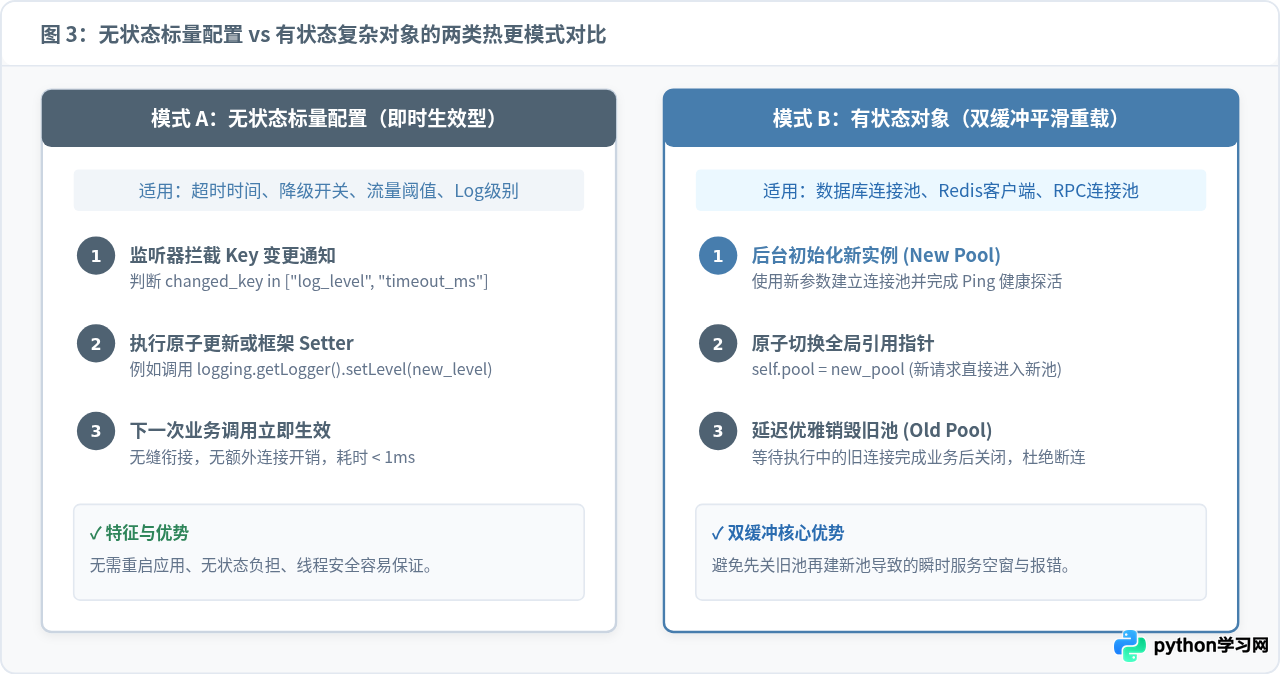
1. 模式 A:无状态标量与框架设置的即时更新
对于如日志级别、接口限流阈值、Feature Flag 业务开关等标量值,热更过程极其简单直接。例如动态修改全局日志级别,只需要在回调中直接调用标准库的设置方法即可:
def log_level_listener(namespace: str, changes: dict):
    if "app_log_level" in changes:
        new_level_str = changes["app_log_level"]["new"]
        level = getattr(logging, new_level_str.upper(), logging.INFO)
        logging.getLogger().setLevel(level)
        logger.warning(f"系统根日志级别已热更新为: {new_level_str}")
在线上突发异常时,运维人员可以在 Apollo 后台将日志级别从 INFO 调整为 DEBUG,几毫秒内即可在不重启实例的情况下收集完整的调试链路日志;排查完毕后再调回 INFO,有效兼顾了问题排查效率与磁盘 I/O 成本。
2. 模式 B:长生命周期复杂对象(数据库连接池)的双缓冲热重载
对于数据库连接池、Redis 连接池或 RPC 客户端,不能直接关掉旧连接池再去创建新连接池,否则在重建的几十到数百毫秒内,并发请求会因为找不到可用连接而引发大面积报错。
解决该问题的经典工程范式是双缓冲机制(Double Buffering),执行步骤如下:
- 创建新连接池并探活:在后台依照最新的数据库连接串或池大小配置,初始化全新的连接池实例,并执行一次
SELECT 1或PING验证连接可用性。 - 原子切换指针:健康检查通过后,将业务访问的全局连接池变量指针直接替换为新实例。随后的新请求将全部路由至新池。
- 平滑回收旧池:旧连接池不要立刻调用
close(),而是延迟 10 到 30 秒,等待当前正在执行 SQL 的长事务优雅完成退出,再执行资源销毁,实现业务全链路零中断。
五、生产环境高可用保障与容灾总结
配置中心作为基础设施,其自身可用性直接关乎整个微服务集群的存亡。一个工业级的 Python Apollo 客户端必须做好多维度的容错设计:
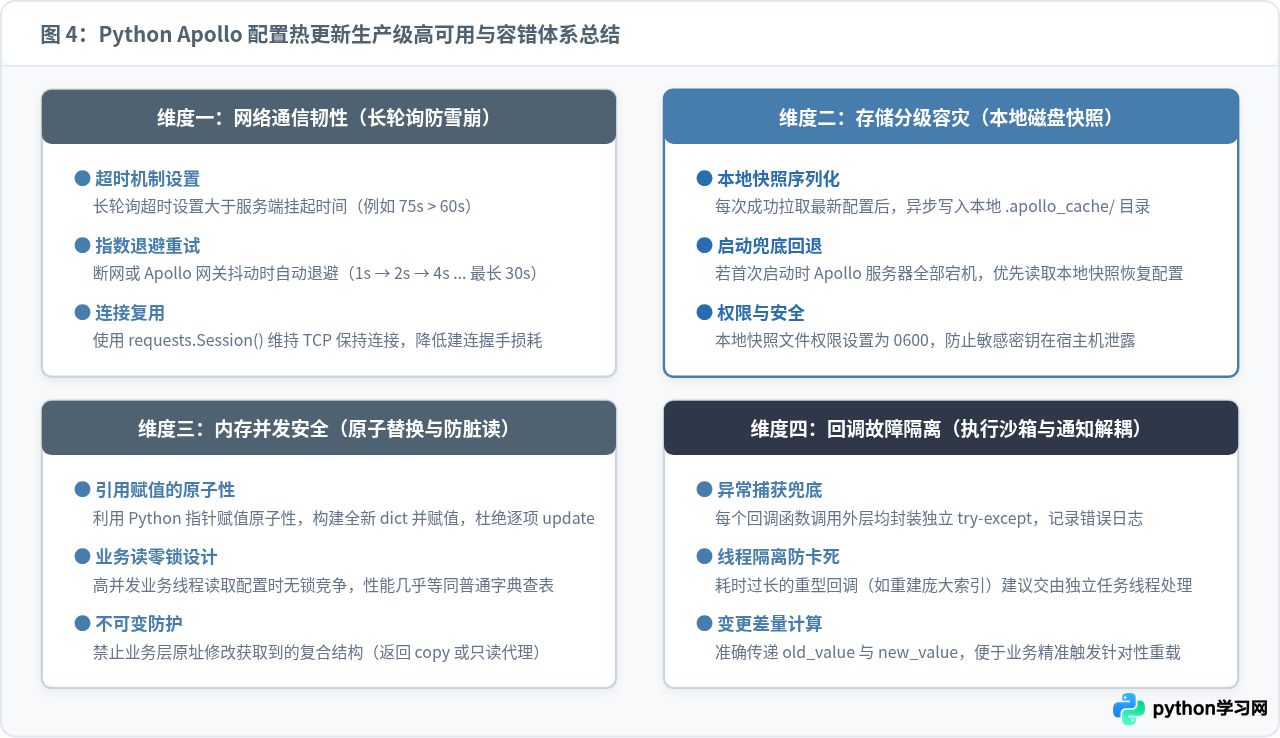
关键避坑要点:
| 风险类别 | 潜在危害 | 应对方案 |
|---|---|---|
| 网络风暴与雪崩 | Apollo 服务端网络抖动或重启时,成百上千个 Python 客户端同时以零间隔重试请求,导致 Apollo 刚恢复即被瞬间打死。 | 长轮询必须引入指数退避(Exponential Backoff)机制,网络异常时依次等待 1s、2s、4s ... 最大不超过 30s。 |
| 首次启动断网兜底 | 应用发布或容器冷启动时,恰逢 Apollo 服务端不可用,应用由于拉取不到基础配置而导致启动崩溃。 | 每次成功拉取配置后,异步序列化一份 JSON 快照到本地磁盘目录(如 .apollo_cache/);启动时若连接失败,自动降级读取本地缓存。 |
| 回调抛出异常阻断 | 某个业务监听器中编写的代码存在空指针或类型转换 Bug,抛出的未捕获异常导致后台监听守护线程退出。 | 在派发回调时,对每一个 listener 调用单独使用独立的 try-except 包裹,记录告警日志,阻断异常向上扩散。 |
| 内存脏读与并发篡改 | 业务代码直接修改通过 client.get() 获取到的复合对象(如 List、Dict),污染了全局只读配置。 |
业务读取复合对象时应使用浅拷贝(copy.copy)或将配置封装为只读对象(如 types.MappingProxyType)。 |
六、总结
在 Python 中实现 Apollo 配置热更新并不复杂,其核心在于理解并遵循 Apollo 的原生通信架构:
- 利用
/notifications/v2的 HTTP 长轮询机制取代短轮询,将配置更新的感知延迟降低到毫秒级,同时将网络通信开销降至最低; - 通过独立的后台守护线程维护长轮询连接,并配合 CPython 内存引用赋值的原子性,实现业务侧零锁等待的高性能配置读取;
- 结合事件驱动的差异分发机制,根据业务场景灵活选择即时替换或双缓冲平滑重载;
- 完备的本地磁盘容灾缓存与异常退避策略,是保障生产级高可用与系统稳健运行的基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















