


Python计算积分选SymPy还是SciPy?适用场景对比
深入对比Python中计算积分的两大核心库SymPy与SciPy,剖析符号积分与数值积分在工作原理、计算精度、执行速度及离散数据处理上的差异,并提供详细的代码示例与选型决策指南。
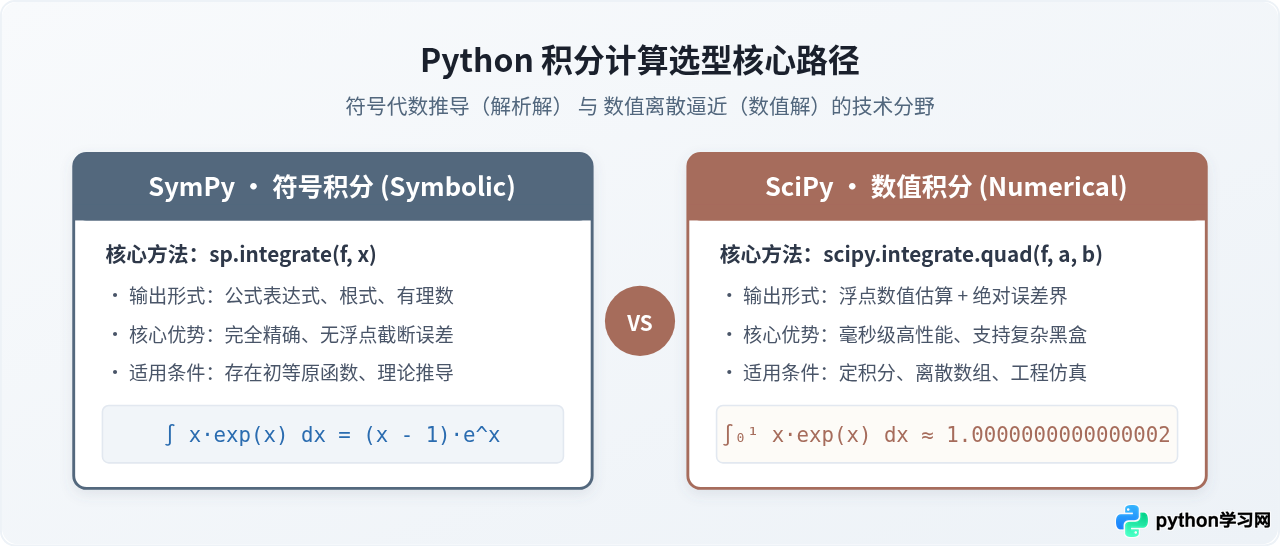
一、本质区别:代数符号推演与数值离散逼近
初学者面对 Python 的积分模块时,常疑惑为什么同样是“求积分”,标准生态库里会同时存在 sympy.integrate 和 scipy.integrate.quad 两种完全不同的接口。产生这种区分的原因并不在于实现优劣,而在于数学底层的计算范式不同。
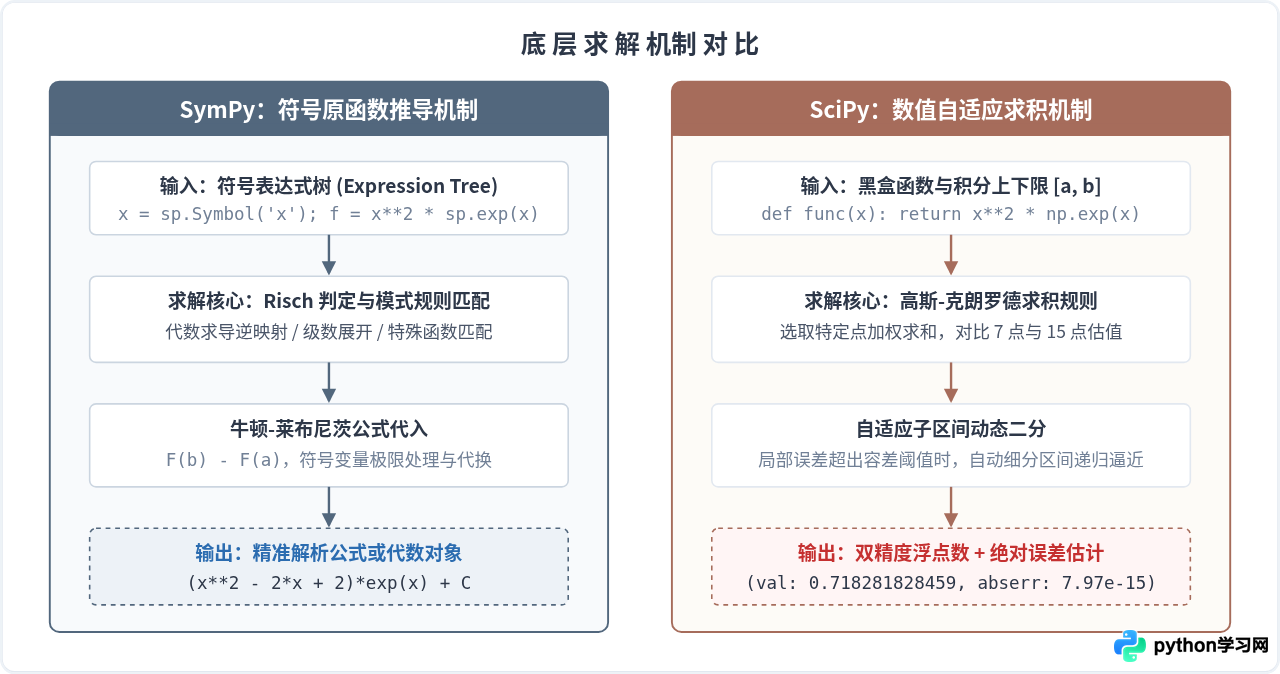
SymPy 的本质是计算机代数系统(CAS)。它把被积函数作为一棵符号表达式树来处理,依靠代数运算律、Risch 算法(判定初等函数是否存在初等原函数的经典算法)以及模式匹配表去寻找原函数 $F(x)$,使得 $F'(x) = f(x)$。如果求定积分,它会先尝试求出符号原函数,再运用微积分基本定理计算 $F(b) - F(a)$。这意味着 SymPy 返回的是一个数学结构对象,保留了 $\pi$、$\sqrt{2}$、$\frac{1}{3}$ 等符号原貌,完全不存在浮点截断误差。
SciPy 的本质是数值计算引擎。其定积分主力函数 scipy.integrate.quad 封装了经典的 Fortran 库 QUADPACK。它并不关心函数写成公式是什么形态,而是把被积函数视为一个可调用对象(Callable)。算法在给定的积分区间 $[a, b]$ 内动态撒入离散采样点,采用自适应高斯-克朗罗德(Gauss-Kronrod)求积公式计算各点函数值的加权和。如果遇到局部变化剧烈的区间,它会自动将区间细分,直到误差估计值低于用户指定的容差阈值。
二、典型场景与代码实现对比
为了让选择条件具体化,我们通过三个日常开发与科研中最常见的实际场景,观察两个库的代码写法、输入要求及最终输出。
场景 1:具有初等原函数的标准定积分
计算定积分 $\int_0^1 x^2 e^x dx$。该式可通过分部积分法得到精确解析解为 $e - 2$。
# 1. SymPy 求解方式:保留符号并获取精确解
import sympy as sp

x = sp.Symbol('x')
f_sym = x**2 * sp.exp(x)

# 不定积分求原函数
F_sym = sp.integrate(f_sym, x)
print("原函数表达式:", F_sym)  # (x**2 - 2*x + 2)*exp(x)

# 定积分求值
sym_exact = sp.integrate(f_sym, (x, 0, 1))
print("SymPy 精确符号解:", sym_exact)         # E - 2
print("SymPy 任意精度求值:", sym_exact.evalf(20)) # 0.71828182845904523536
# 2. SciPy 求解方式:直接传入数学函数求浮点近似
import numpy as np
from scipy import integrate
def f_numeric(x):
return x**2 * np.exp(x)
# 调用 quad,返回 (计算结果, 绝对误差上限)
result, error = integrate.quad(f_numeric, 0, 1)
print("SciPy 数值计算结果:", result) # 0.7182818284590453
print("SciPy 绝对误差估计:", error) # 7.974403330689958e-15
在这一场景下,如果你的目的是在学术论文中写出推导结论,SymPy 的 E - 2 能够无损表达数学本义;如果这是物理模拟、图形渲染管线中的某一帧计算,SciPy 能够在微秒级内返回符合 IEEE 754 双精度标准的浮点值。
场景 2:不存在初等原函数的积分(高斯积分变体)
许多自然界物理方程中的积分并不能用初等函数(多项式、三角函数、指数对数)表示,例如 $\int_0^1 e^{-x^2} dx$。
- SymPy 的应对:SymPy 会将其表示为特殊函数,返回
sqrt(pi)*erf(1)/2。虽然 mathematically 严谨,但如果下游代码不支持特殊函数对象的求值,你仍然需要调用.evalf()强行将其转为浮点数。 - SciPy 的应对:SciPy 完全不受初等原函数的限制。对它而言,这只是在曲线上均匀加权采样,调用
integrate.quad(lambda x: np.exp(-x**2), 0, 1)同样能瞬间给出0.746824132812427,绝对误差在 $10^{-14}$ 级别。
场景 3:无解析表达式的离散测量数据
在传感器监测、实验采集或财务数据处理中,很多时候我们根本没有 $f(x)$ 的解析公式,只有一系列等间隔或不等间隔的采样数组 (x_array, y_array)。
SciPy 则原生提供了基于离散阵列的牛顿-科特斯公式族:复合梯形法则 scipy.integrate.trapezoid 与复合辛普森法则 scipy.integrate.simpson。
import numpy as np
from scipy import integrate

# 模拟实验采集的离散时间与传感器读数
x_data = np.linspace(0, 2, 21)
y_data = np.sin(x_data) + np.random.normal(0, 0.01, size=len(x_data))

# 使用复合梯形法则或辛普森法则直接计算数据下面积
area_trapz = integrate.trapezoid(y_data, x_data)
area_simps = integrate.simpson(y_data, x=x_data)
print("梯形积分结果:", area_trapz)
print("辛普森积分结果:", area_simps)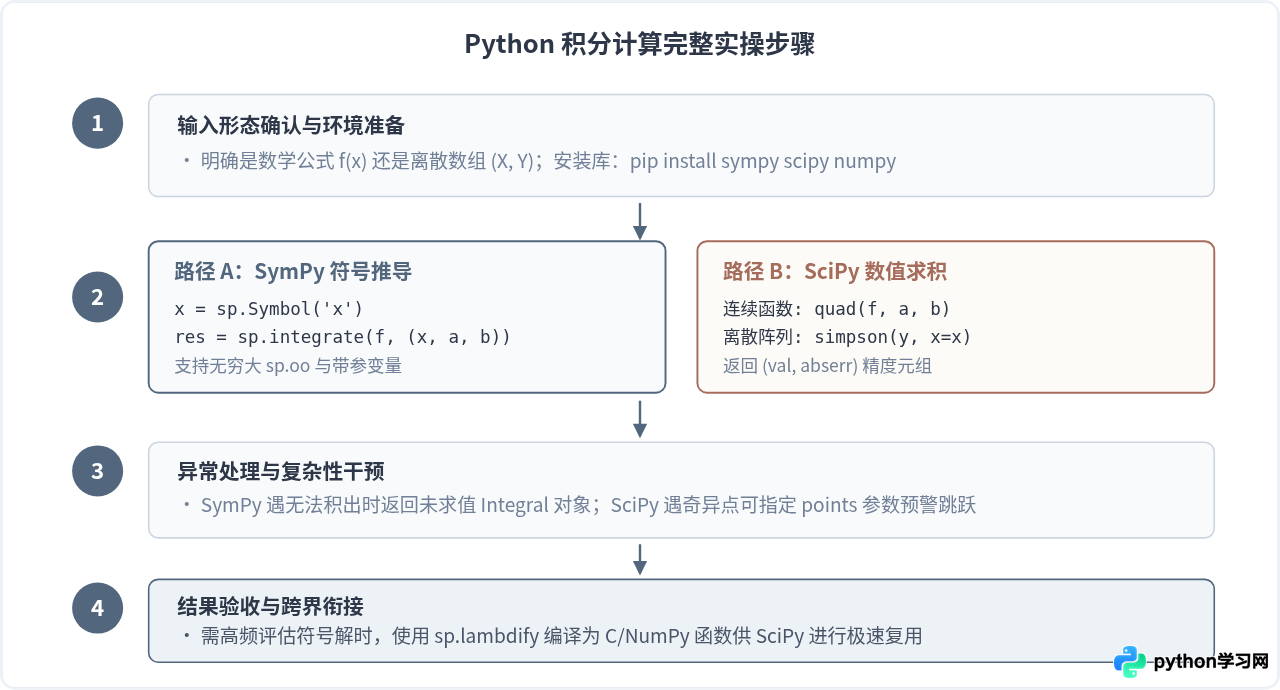
三、性能、精度与开销的客观权衡
在系统架构设计中,算法库的选择往往伴随着对耗时与计算开销的严格限制。SymPy 与 SciPy 在性能维度的表现相差数个数量级。
1. 执行耗时差异:SymPy 完全由纯 Python 构建(虽然底层可以接入 mpmath 做高精度评估),在解析符号、构建抽象语法树和遍历代数匹配规则时,一个简单积分的耗时通常在 5 毫秒到数十毫秒 级别,稍复杂的函数耗时甚至可达数百毫秒或出现求解挂起。反观 SciPy 的 quad,其核心计算在编译好的 Fortran 原生指令集中运行,单次定积分通常只需 10 微秒到 100 微秒。两者的速度差距在 100 倍至 10,000 倍之间。
2. 精度保障机制:SymPy 的精度是“无限”的,或者说它是解析保真的。即使需要数值展示,.evalf(50) 也可以轻松输出小数点后 50 位有效数字。SciPy 采用 IEEE 754 标准双精度浮点数(通常对应 float64),其最高精度上限约为 15~17 位有效数字。在绝大多数常规物理仿真与工程设计中,$10^{-12}$ 的相对误差已经远低于传感器噪声和材料误差,完全足够使用。
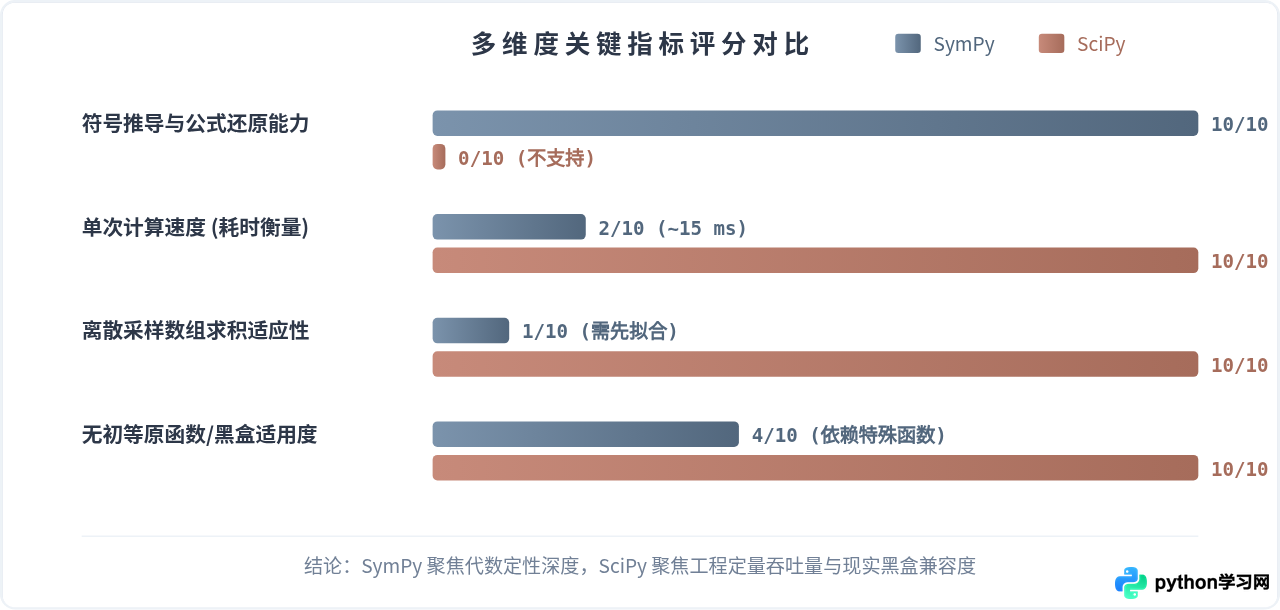
四、工程实战中的协同方案:SymPy 负责推导,SciPy 负责计算
在实际工业仿真与科学研究中,最佳实践往往并不是“非此即彼”,而是组合使用。
例如,我们需要对一个复杂的物理场进行上万次求值,但被积函数的微分或代数简化非常繁琐。如果直接把未化简的公式放进 SciPy 积分循环中,被积函数每次调用都要进行耗时的重复运算;而如果纯用 SymPy 积分,成千上万次迭代将耗时数小时。
此时,标准解决路径是:先用 SymPy 进行符号推导与原函数化简,然后使用 sympy.lambdify 将符号结果编译为底层的 NumPy/C 快速向量化函数,最后交由数值计算模块调用。
import sympy as sp
import numpy as np

x, a = sp.symbols('x a')
# 1. 符号推导阶段
sym_integrand = sp.sin(a * x)**2 * x
sym_antiderivative = sp.integrate(sym_integrand, x)

print("推导出的解析原函数:", sym_antiderivative)

# 2. 桥接转换:编译为利用 NumPy 底层加速的 Python 原生函数
fast_F = sp.lambdify((x, a), sym_antiderivative, modules='numpy')

# 3. 超高速度反复求值:直接利用解析公式作差计算定积分,完全避开数值迭代
a_val = 2.5
def_integral_val = fast_F(1.0, a_val) - fast_F(0.0, a_val)
print("极速解析求值结果:", def_integral_val)
五、选型决策指南与速查流程
在着手编写代码前,你可以依据以下四个具体问题快速确立技术选型:
- 是否必须得到含有变量的通用公式? 如果需要保留变量参数(如 $\int_0^t f(x, k) dx$ 结果中包含未知常数 $k$),必须选 SymPy。
- 数据是否来自外部传感器采样或只有散点列表? 没有解析公式时,直接选 SciPy(使用
trapezoid或simpson)。 - 积分是否嵌套在大规模优化、机器学习或微分方程求解器(如
scipy.integrate.solve_ivp)内部? 当需要在循环内调用该积分数万次以上时,必须选 SciPy,或者用 SymPy 离线推导后lambdify。 - 函数形式极其生僻,或包含分段奇异点? 选 SciPy 的
quad,其支持points参数显式告诉求解器区间内的奇异跳跃点位置,鲁棒性极高。
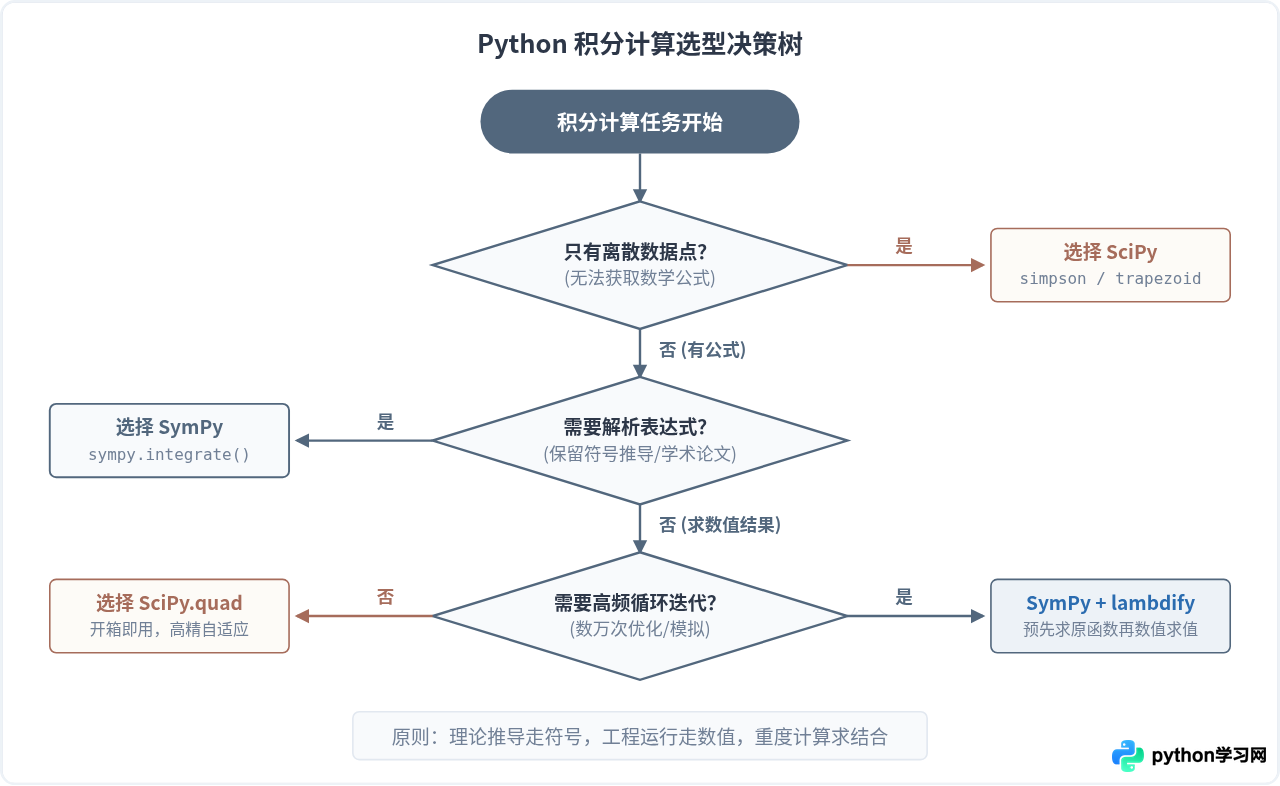
六、总结与功能速查表
为了方便日常开发中快速查阅,下表总结了 SymPy 与 SciPy 在计算积分时的关键特性与选型对照:
| 对比维度 | SymPy (sympy.integrate) |
SciPy (scipy.integrate) |
|---|---|---|
| 计算范式 | 符号代数(CAS 模式匹配与 Risch 判定) | 数值计算(QUADPACK 自适应高斯求积) |
| 输出结果 | 符号表达式、根式、有理数(精确解析解) | 双精度浮点数 + 绝对误差估计 |
| 执行性能 | 相对较慢(纯 Python,毫秒到秒级) | 极快(C/Fortran 原生优化,微秒级) |
| 离散数据积分 | 不支持直接对数据点积分 | 原生支持(trapezoid、simpson) |
| 无初等原函数问题 | 返回特殊函数(如 erf、Ei)或挂起 | 毫无压力,平滑自适应收敛 |
| 典型应用场景 | 数学公式推导、论文定理证明、教学展示 | 物理引擎、控制工程、信号处理、大规模仿真 |
简而言之,当你需要“知道为什么是这个公式”时,选择 SymPy;当你需要“在规定时间内得到这个数值”时,选择 SciPy。理清两者的边界,并在必要时运用 sp.lambdify 搭建二者之间的桥梁,是构建高效、稳健的 Python 科学计算工作流的关键所在。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















