


Python urllib、requests与aiohttp下载图片的优缺点分析
深入对比分析Python下载图片的三个主流方案:urllib、requests与aiohttp,剖析其实现机制、代码范式、性能差异与适用场景,帮助开发者根据实际项目规模做出合理技术选型。
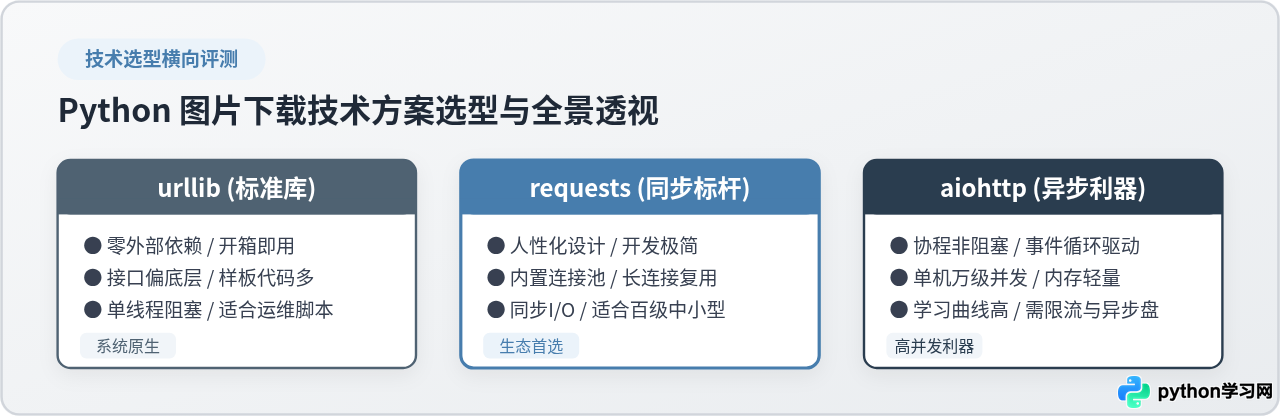
urllib、第三方同步标杆 requests 与异步协程库 aiohttp 分别代表了零依赖轻量、极简工程化与极致高并发三种取向。本文将从健壮下载流水线出发,深入剖析这三大库的实现范式、底层架构与适用边界。
一、图片下载的技术核心与通用流水线
很多开发者在刚接触图片下载时,往往习惯直接调用类似 response.read() 或 response.content 将完整的二进制数据一次性读入内存,再通过 file.write() 写入文件。这种做法在处理几十 KB 的小图标时尚可运行,但一旦遇到数十兆的原始高清图或相机 RAW 素材,内存占用便会瞬间激增;若在多任务环境下并行执行,极易耗尽系统可用内存造成进程崩溃。
因此,工业级健壮的图片下载必须建立在流式传输(Streaming)与防御性校验的基础之上。无论使用哪个网络库,一套完备可靠的图片下载流水线都应涵盖以下五个阶段:
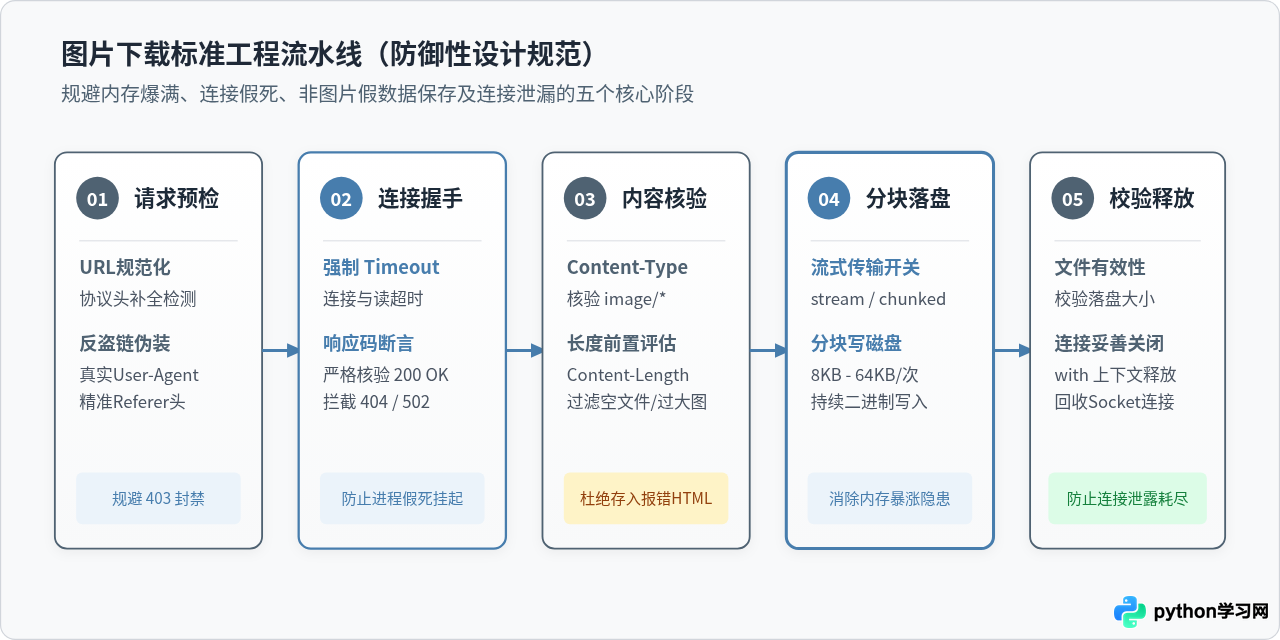
- 请求预检与头信息伪装:校验 URL 协议合法性,并按需注入
User-Agent与防盗链Referer标头,防止服务端因缺少浏览器标识而直接返回403 Forbidden。 - 建立连接与超时断言:显式声明连接超时与读取超时(Timeout),避免因目标服务器宕机或网络丢包而导致下载进程无限期挂起;同时校验 HTTP 状态码必须为
200 OK。 - 响应类型与格式核验:检查响应标头中的
Content-Type是否为image/*(如image/jpeg、image/png),防止将 404 错误页、反爬验证码网页等 HTML 假数据保存为伪装的图片文件。 - 分块流式读取与落盘:开启流式模式,以固定的数据块(常用 8KB 至 64KB)逐块迭代接收网络数据包并写入二进制文件,使内存占用始终恒定在极低水平。
- 完整性校验与连接释放:利用上下文管理器(
with语句)确保底层 Socket 连接被妥善关闭回收,并根据Content-Length校验落盘文件大小,杜绝因网络中断产生零字节损坏文件。
二、标准库 urllib:零外部依赖的开箱即用方案
urllib 是 Python 标准库自带的网络请求工具集,无需执行任何 pip install 即可直接导入使用。它在需要快速验证网络连通性、纯净系统运维脚本或严禁安装第三方轮子的封闭安全环境中具有天然优势。
1. 推荐的标准流式实现
在 urllib 中,虽然历史遗留方法 urllib.request.urlretrieve 能够一行代码保存文件,但它无法自定义请求头、难以设置超时且缺乏细粒度的流式控制。生产环境中应当使用基于 urlopen 的流式写法:
import urllib.request
import urllib.error

def download_image_urllib(url: str, save_path: str, timeout: int = 10) -> bool:
    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"}
    req = urllib.request.Request(url, headers=headers)

    try:
        with urllib.request.urlopen(req, timeout=timeout) as response:
            # 校验响应码与MIME类型
            if response.status != 200:
                return False
            content_type = response.headers.get("Content-Type", "")
            if not content_type.startswith("image/"):
                return False

            # 分块流式读取落盘 (8KB)
            with open(save_path, "wb") as f:
                while True:
                    chunk = response.read(8192)
                    if not chunk:
                        break
                    f.write(chunk)
            return True
    except (urllib.error.URLError, urllib.error.HTTPError, TimeoutError):
        return False
2. 优缺点深入剖析
核心优点:
- 零环境依赖:任何安装有 Python 的机器均可直接运行,适合嵌入到系统预装工具、Linux 安装脚本或 Docker 基础镜像检测程序中。
- 极高稳定性:作为语言标准库,其接口行为经过了数十年的长期维护,向后兼容性极高,基本不会受到外部第三方包版本升级破坏的影响。
核心缺点:
- 接口繁琐且抽象层级低:自定义请求头需要单独构造
Request实例;若需要支持 Cookie 管理、HTTP 代理或重定向追踪,必须手动组装OpenerDirector和各类Handler,样板代码量大。 - 缺乏内置连接池:每次发起
urlopen都会在底层重新创建 Socket 连接并完成三次握手,执行完后立即销毁,缺乏高效的长连接(HTTP Keep-Alive)复用机制,连续下载多张图片时耗时显著增加。 - 异常体系较分散:网络不通抛出
URLError,服务端返回 404/500 抛出HTTPError,超时则可能抛出TimeoutError或包装异常,开发者需要编写多重try-except才能确保健壮。
三、requests:优雅可靠的同步工业级标准
requests 是 Python 社区中最广为使用的第三方 HTTP 客户端,其倡导的“HTTP for Humans”设计哲学使得网络请求代码极其直观且符合直觉。对于绝大多数常规爬虫与自动化业务脚本,requests 都是事实上的首选方案。
1. 规范的流式写入实现
在利用 requests 下载图片时,最关键的是显式开启 stream=True 参数。此时只有响应头会被首先下载并解析,响应体内容直到调用 iter_content() 时才由底层 Socket 按块拉取:
import requests

def download_image_requests(url: str, save_path: str, session: requests.Session = None) -> bool:
    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"}
    client = session or requests.Session()

    try:
        # stream=True 确保不会将整张大图加载至内存
        with client.get(url, headers=headers, stream=True, timeout=(5, 15)) as resp:
            resp.raise_for_status()

            # 核验资源格式
            content_type = resp.headers.get("Content-Type", "")
            if not content_type.startswith("image/"):
                return False

            # 8KB分块写入文件
            with open(save_path, "wb") as f:
                for chunk in resp.iter_content(chunk_size=8192):
                    if chunk:
                        f.write(chunk)
            return True
    except requests.exceptions.RequestException:
        return False
2. 优缺点深入剖析
核心优点:
- 极简人性化的 API:方法命名清晰,支持链式异常校验(
raise_for_status())、统一配置超时元组(connect_timeout, read_timeout),开发体验极佳。 - 默认连接池复用:基于底层成熟的
urllib3构建。在同一个requests.Session()生命周期内,发往同一主机的请求会自动复用已建立的 TCP 连接,大幅降低重复 DNS 解析与握手开销。 - 完备健壮的生态:支持通过
HTTPAdapter轻松配置指数退避自动重试机制、自动管理会话 Cookies、透明支持 HTTP/SOCKS 代理与 SSL 证书校验。
核心缺点:
- 同步阻塞本质:发出请求后,当前操作系统线程会被完全阻塞挂起,直到网络数据传输完毕。单线程顺序下载成百上千张图片时总耗时随图片数量线性增长。
- 并发资源开销较大:为了加速下载,通常需要引入
ThreadPoolExecutor线程池。然而 Python 线程每个均占用数兆字节的独立栈内存,同时受全局解释器锁(GIL)影响,当并发线程数攀升至几百上千时,系统上下文切换开销和内存占用急剧恶化。
四、aiohttp:高并发吞吐的异步协程利器
当图片采集规模达到数千至数万张时,传统的同步多线程方案往往会遭遇带宽无法打满或线程栈内存溢出的瓶颈。aiohttp 基于 Python 的 asyncio 异步事件循环架构,可以在单进程内以极轻量的协程承载极高密度的并发网络请求。
1. 异步受控并发实现
编写 aiohttp 下载图片时,必须牢记必须配合信号量(Semaphore)控制并发度。否则,瞬间发起成千上万个协程不仅会瞬间耗尽操作系统的文件描述符(Too many open files),更容易触发目标 CDN 的频次防护导致大面积封禁:
import asyncio
import aiohttp

async def download_image_aiohttp(
    session: aiohttp.ClientSession,
    url: str,
    save_path: str,
    semaphore: asyncio.Semaphore
) -> bool:
    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"}

    async with semaphore:  # 控制全局瞬时并发上限
        try:
            timeout = aiohttp.ClientTimeout(total=20, connect=5)
            async with session.get(url, headers=headers, timeout=timeout) as resp:
                if resp.status != 200:
                    return False

                content_type = resp.headers.get("Content-Type", "")
                if not content_type.startswith("image/"):
                    return False

                # 异步流式分块读取 (8KB)
                with open(save_path, "wb") as f:
                    async for chunk in resp.content.iter_chunked(8192):
                        f.write(chunk)
                return True
        except (aiohttp.ClientError, asyncio.TimeoutError):
            return False

async def batch_download(urls: list, save_paths: list, max_concurrency: int = 50):
    semaphore = asyncio.Semaphore(max_concurrency)
    connector = aiohttp.TCPConnector(limit=100, limit_per_host=20)

    async with aiohttp.ClientSession(connector=connector) as session:
        tasks = [
            download_image_aiohttp(session, url, path, semaphore)
            for url, path in zip(urls, save_paths)
        ]
        results = await asyncio.gather(*tasks)
        print(f"成功下载完成 {sum(results)}/{len(urls)} 张图片")
with open(),在大多数机械硬盘或高速 NVMe SSD 环境下,配合异步网络 I/O 已可获得极佳性能。若需要实现极致的纯异步流式落地,可引入第三方包 aiofiles 或将写盘操作通过 loop.run_in_executor 委派至专用写盘线程池。
2. 优缺点深入剖析
核心优点:
- 极高并发吞吐:采用非阻塞 Socket 与操作系统多路复用(Linux 下的 epoll,macOS 下的 kqueue)。单个线程即可轻松调度上千个下载任务,只要带宽未饱和,下载吞吐量即可达到理论上限。
- 超低内存消耗:协程在 Python 中本质是微型的轻量级结构,单个协程仅占用几 KB 内存,远低于系统线程几 MB 的内存分配。并发两千个协程仅消耗几十兆内存。
- 高效异步连接池:
TCPConnector天然内置了主机级别的连接复用与连接总数限制,对批量爬取友善度极高。
核心缺点:
- 认知与语法门槛较高:需要熟练掌握
async/await语法、事件循环生命周期、上下文管理器以及任务编排方法,代码复杂度显著高于线性同步脚本。 - 调试排错成本增加:异步调用栈层级较深,发生异常或网络超时时堆栈信息包含大量事件循环底层调度帧,排查定位问题不如同步代码直观。
- 缺乏开箱即用的轻量性:若仅需下载一两张图片,搭建事件循环和
ClientSession的额外结构显得冗余,属于典型“大炮打蚊子”。
五、底层架构与执行模型深度剖析
为什么在同样千兆带宽的测试环境下,面对上千张图片的下载任务,aiohttp 往往比 urllib 快数十倍,而 requests 在多线程加持下仍难逃高内存消耗?关键在于三者在套接字生命周期管理与操作系统调度模型上的根本差异:
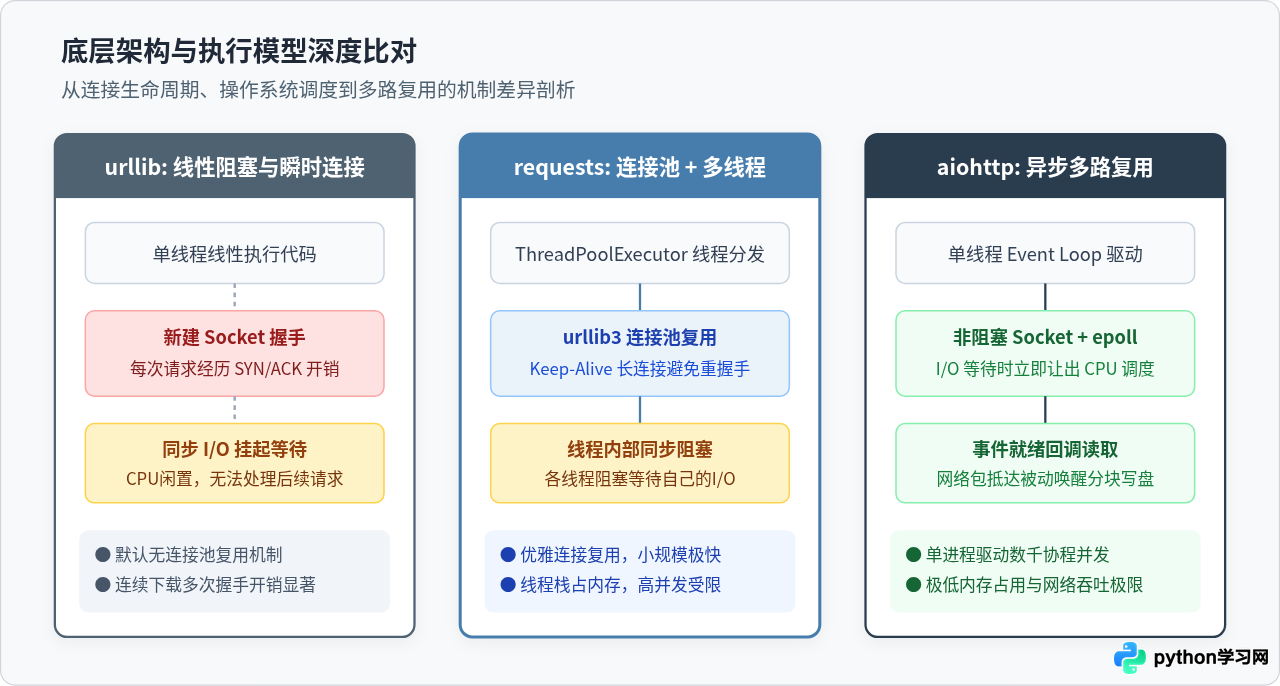
在底层网络通信中,建立一次完整的 HTTPS 连接需要经历 DNS 解析、TCP 三次握手以及 TLS 证书握手,网络往返(RTT)耗时通常在几十到几百毫秒之间:
- urllib:在常规调用中采取“按需新建、用毕即关”的单次连接策略。下载 100 张图片意味着重复经历 100 次三次握手与 TLS 协商,网络有效传输效率极低。
- requests:通过
requests.Session()绑定urllib3.HTTPConnectionPool,在单个线程或线程池中为同一个 Host 维持持久长连接(Keep-Alive)。后续请求可直接通过现有 Socket 发送,消除了重连时延;但受限于线程阻塞调度,多线程扩张会带来显著的内存与系统上下文切换开销。 - aiohttp:全面拥抱基于 epoll/kqueue 的事件驱动架构。它在单个工作线程内监听所有 Socket 的就绪状态。当请求发出后,Socket 进入等待状态,协程主动让出控制权让事件循环去处理下一个请求;当远端服务器的数据包到达触发读就绪中断后,操作系统通知事件循环唤醒对应协程读取分块数据,彻底消除了空转等待与线程阻塞。
六、核心维度量化对比与特性全景
为了帮助开发者根据项目实际情况建立清晰的技术画像,下表与对比图汇总了三者在各核心维度的横向打分与实战表现:
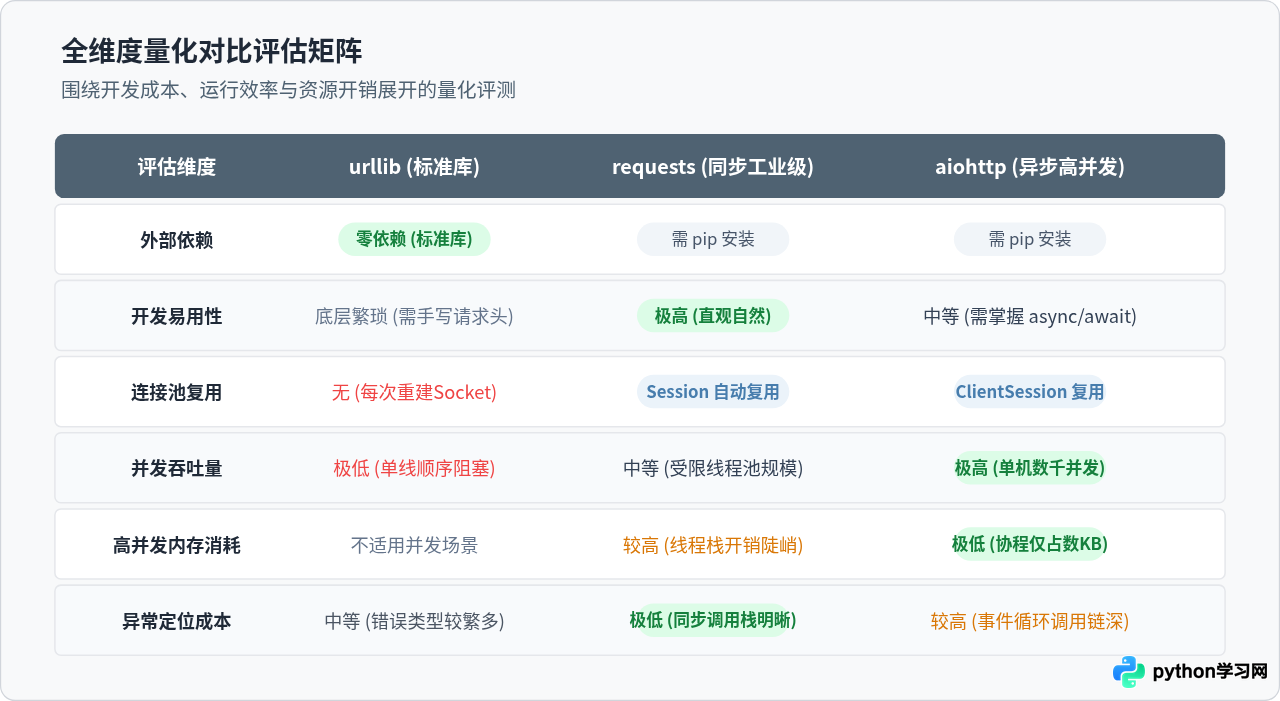
| 评估维度 | urllib (标准库) | requests (同步标杆) | aiohttp (异步利器) |
|---|---|---|---|
| 外部依赖情况 | 零依赖(Python 内置) | 需安装 requests(约 4 个间接依赖) |
需安装 aiohttp(含 yarl, multidict 等) |
| 代码简洁与易用度 | 低(样板代码冗长,需手动拼装) | 极高(语义清晰,开发速度最快) | 中等(需掌握 async/await 语法) |
| 长连接复用能力 | 弱(默认无连接池,需手写 Handler) | 强(Session 自动管理连接池) | 强(ClientSession 异步连接池) |
| 单机并发与吞吐 | 极低(单线程顺序阻塞) | 中等(依赖多线程池,吞吐受限) | 极高(事件循环调度,跑满单机带宽) |
| 高并发内存控制 | 低(仅单张小图片自身内存) | 较差(线程栈随并发度急剧扩张) | 优异(协程轻量,万级并发仅数十兆) |
| 调试与异常定位 | 中等(异常类型多,需多层捕获) | 极优(异常直观,调用栈明晰) | 较难(异步调用栈层级深,排错繁琐) |
| 最佳适用场景 | 运维排查脚本、受限内网、零依赖工具 | 中小规模批量、常规爬虫、数据交互 | 海量图库采集(>500张)、全异步微服务 |
七、选型决策指南与工程实践建议
在技术选型中,没有绝对最优的技术方案,只有与项目场景、交付周期及运维约束最匹配的选择。根据下载量级与系统约束,可参考以下决策树做出权衡:
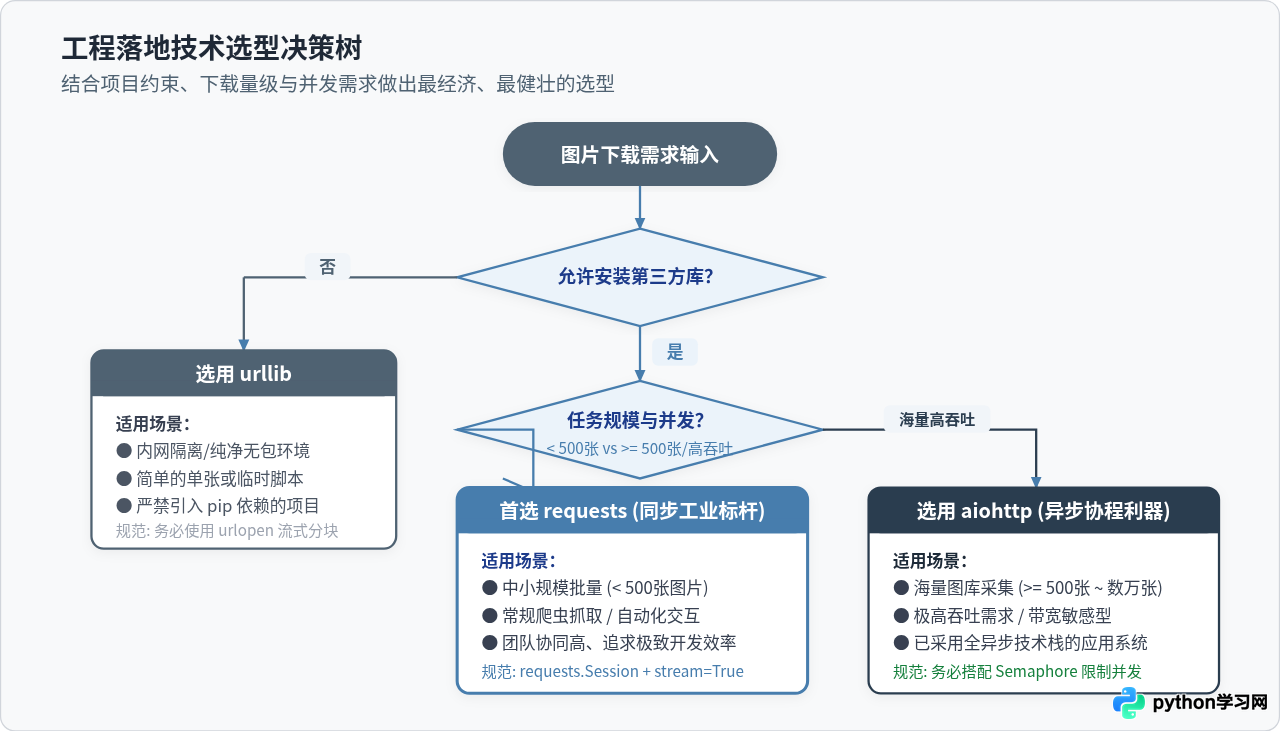
结合真实业务开发中的踩坑经验,给出以下四条黄金工程实践建议:
- 绝不裸调,必设超时:网络请求务必显式指定
timeout。在涉及 CDN 节点故障或防盗链握手挂起时,缺少超时参数会导致 Python 进程永久阻塞,成为隐藏的系统稳定性定时炸弹。 - 坚持流式传输(Streaming):除非图片大小已在业务上严格保证小于 100KB,否则统一养成使用
stream=True或iter_chunked()分块写盘的习惯,彻底杜绝内存突发飙升。 - 异步并发严禁“脱缰”:使用
aiohttp时,切勿将数万个任务直接全部推入asyncio.gather()。务必通过asyncio.Semaphore严格限制瞬时并发数(建议设置为 20 至 100 之间),同时兼顾本地磁盘 I/O 承载力与目标站点的防刷阈值。 - 严格校验 Content-Type 与文件后缀:网络请求返回 200 并不代表返回的内容一定是有效图片。必须提取响应头
Content-Type确认包含image/,或者利用imghdr/Pillow对下载完成的文件头魔数(Magic Number)进行校验,防止将反爬 HTML 页面当成有效图片写入库中。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















