


Python初学者与合格开发者的核心差距在哪里?面向对象与框架应用能力解析
深入解析Python初学者与合格开发者的本质差异,从面向对象领域建模、业务状态封装,到现代化Web框架的控制反转(IoC)、请求生命周期与工程化落地,全面拆解技术进阶路径。
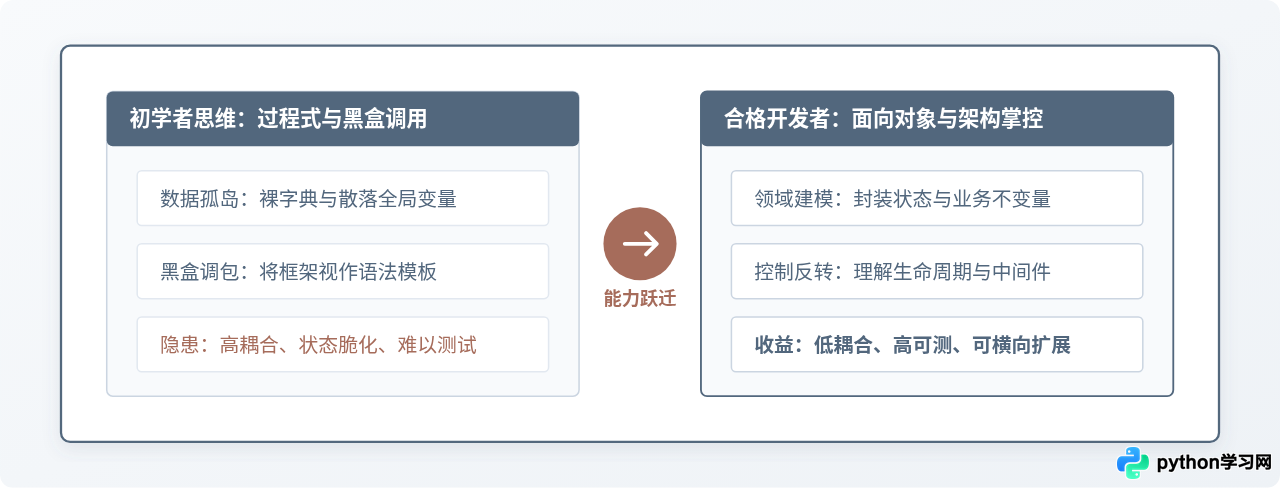
Python初学者与合格开发者之间最根本的差距,并不在于掌握了多少语法特性或能背诵多少标准库函数,而在于从“面向执行过程的单脚本思维”向“面向系统状态与约束的工程化思维”跨越。具体体现在两个核心维度:能否利用面向对象构建具有清晰边界与内聚状态的业务模型,以及能否跳出黑盒视角、透彻理解现代化Web框架的控制反转(IoC)与生命周期机制。
一、面向对象的核心差距:从数据孤岛到高内聚领域实体
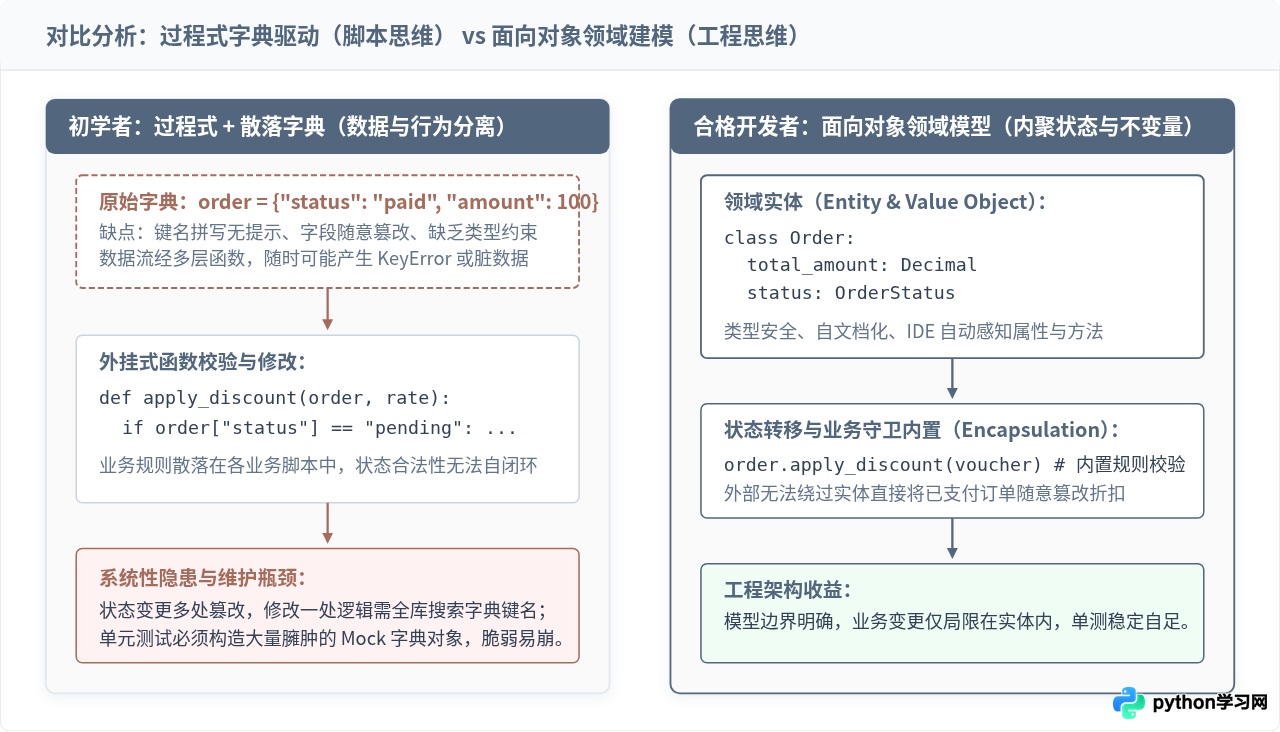
多数Python初学者在语法层面都接触过 class 关键字,甚至能顺畅写出动物类继承与打印问候语的示例。然而在真实业务中,初学者往往会不自觉退回到“过程式脚本”的舒适区:大量依赖无模式约束的字典(Dictionary-driven development),在数十个函数之间来回透传原始字典和全局变量。
这种模式被称为“贫血数据流”。由于字典本身对业务字段没有强校验约束,键名全凭字符串索引,开发初期看似轻快,但随着业务逻辑稍微复杂,就会暴露出巨大的隐患:
- 隐式结构与打字脆化:函数接收到的
user_dict究竟包含哪些字段,只能靠肉眼翻看上游调用链或陈旧的注释。只要一处拼写笔误(例如将status误写为stats),错误往往要等到运行时甚至线上特定分支被执行时才会暴露。 - 业务不变量(Invariants)失去守卫:订单状态何时可以变更为“已取消”、折扣何时不能叠加,这些核心规则散落各处。如果某个新入职的同事在另一处脚本中直接给
order["discount"] = 0.5,系统没有任何阻拦机制。
# 散落全局或在函数间随意传递字典
def apply_order_discount(order: dict, rate: float) -> dict:
    # 脆弱的状态判断:如果键名拼写错误,立刻产生 KeyError 或静默失败
    if order.get("status") != "pending_payment":
        raise ValueError("只有待支付订单可打折")

    # 缺乏数值守卫:若外部传入负数或超过1的值,将破坏业务规则
    order["discount_rate"] = rate
    order["final_price"] = order["total_price"] * (1 - rate)
    return order
相比之下,合格开发者会将“数据”与“操作数据的行为”封装在一起,通过领域实体(Entity)严格维护业务不变量。Python 3.7+ 提供的 dataclass 以及广泛使用的类型注解,为现代面向对象设计提供了轻量且严谨的支撑:
from dataclasses import dataclass
from decimal import Decimal
from enum import Enum, auto

class OrderStatus(Enum):
    PENDING_PAYMENT = auto()
    PAID = auto()
    CANCELLED = auto()

@dataclass
class Order:
    order_id: str
    total_amount: Decimal
    status: OrderStatus = OrderStatus.PENDING_PAYMENT
    discount_rate: Decimal = Decimal("0.00")

    def apply_discount(self, rate: Decimal) -> None:
        """封装业务规则:仅待支付状态可打折,且严格约束折扣区间"""
        if self.status != OrderStatus.PENDING_PAYMENT:
            raise ValueError(f"订单当前状态为 {self.status.name},不可调整折扣")
        if not (Decimal("0.00") <= rate <= Decimal("0.50")):
            raise ValueError("折扣率必须在 0% 到 50% 之间")

        self.discount_rate = rate

    @property
    def final_amount(self) -> Decimal:
        """派生计算属性,确保业务金额计算全局唯一且不可外部强行篡改"""
return self.total_amount * (Decimal("1.00") - self.discount_rate)在合格开发者的设计中,Order 对象是一个自给自足的领域模型。外部调用者无需关心打折公式的内部细节,也无法绕过校验逻辑直接篡改派生出的 final_amount。这种高内聚低耦合的代码风格,使得单元测试变得极其简单,不再需要构造庞大而易崩的 Mock 字典。
二、面向对象的进阶跨越:从分支堆叠到多态与依赖倒置
初学者容易陷入的第二个泥潭是分支膨胀。当业务需要支持多种形态(如不同支付渠道、不同数据导出格式、不同通知渠道)时,初学者最习惯的直觉操作是在每个关键执行点编写冗长的 if/elif/else 判断。
当系统接入微信支付、支付宝、Stripe 后,如果再接入 PayPal,初学者就必须全局检索所有包含 if channel == "wechat" 的代码块逐个修改。这直接违反了面向对象设计的核心法则——开闭原则(Open/Closed Principle):软件实体应当对扩展开放,对修改关闭。
合格开发者会通过定义抽象契约,将分支逻辑转化为基于多态的策略模式(Strategy Pattern)。在现代 Python 中,typing.Protocol 提供了强大的结构化子类型(鸭子类型)支持,无需显式继承基类即可实现类型安全的依赖抽象:
from typing import Protocol
from decimal import Decimal

# 1. 定义支付处理协议契约
class PaymentProcessor(Protocol):
    def charge(self, order_id: str, amount: Decimal) -> bool:
        ...

# 2. 独立实现具体渠道,互不干扰
class WeChatPayProcessor:
    def charge(self, order_id: str, amount: Decimal) -> bool:
        # 实现微信特有的签名与请求通道
        return True

class AliPayProcessor:
    def charge(self, order_id: str, amount: Decimal) -> bool:
        # 实现支付宝特有的支付逻辑
        return True

# 3. 业务服务仅依赖抽象协议,通过依赖注入解耦
class CheckoutService:
    def __init__(self, processor: PaymentProcessor) -> None:
        self._processor = processor

    def process_order(self, order: Order) -> bool:
return self._processor.charge(order.order_id, order.final_amount)很多开发者在刚学会设计模式时,容易走向过度设计的另一个极端(为了几行逻辑硬套抽象工厂)。重构的核心动力来源于“业务变动的真实摩擦力”。当一个业务实体的数据被超过 3 处函数肆意修改,或一个条件分支连续增补超过 3 个业务方时,就是开展面向对象重构的最佳时刻。
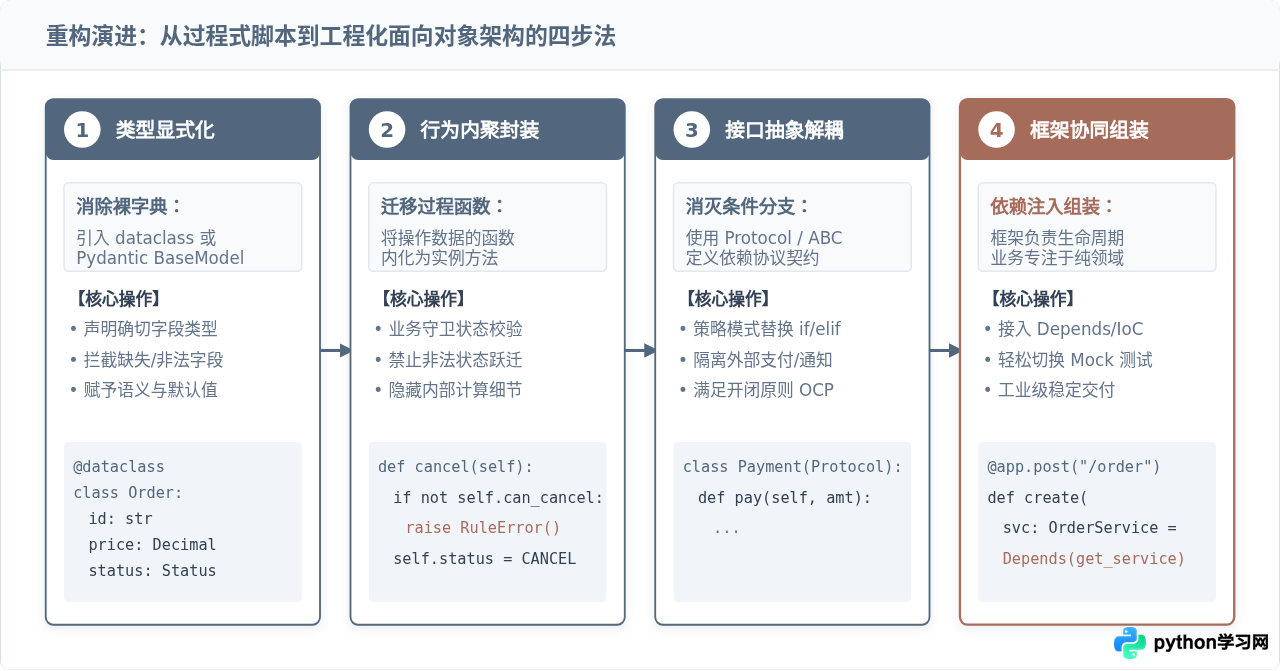
为了直观展现从初学脚本向对象化工程的演进过程,下图总结了标准的重构四步操作路线:
三、框架应用能力的分水岭:从黑盒调包到掌控控制反转(IoC)
如果说面向对象考验的是代码的组织能力,那么框架应用能力则直接检验开发者对系统运行时机制的认知深度。初学者使用 Django、Flask 或 FastAPI 时,通常处于“黑盒状态”:从官方文档或博客中复制几段路由定义、依样画葫芦写几个数据库模型,一旦出现 404、500、连接超时或跨域报错,就只能无目的性地搜索复制粘贴。
初学者与合格开发者的根本分水岭在于:初学者认为自己在“调用框架”,而合格开发者深刻理解是“框架在调度自己的代码”。 这就是软件架构中经典的控制反转(Inversion of Control, IoC)与好莱坞原则(“Don't call us, we'll call you”)。
1. 请求管道与中间件洋葱模型
合格开发者在编写任何一个路由函数前,脑海中都有清晰的请求生命周期拓扑图。以现代基于 ASGI 规范的框架(如 FastAPI / Starlette)为例,一个 HTTP 请求从进入服务器到最终返回响应,历经清晰的层级流转:
- 底层网络网关:Uvicorn 监听 TCP 端口,解析 HTTP 协议头,封装为符合 ASGI 规范的标准字典(
scope,receive,send)。 - 中间件洋葱链(Middleware Stack):请求从最外层的 CORS、认证、安全标头中间件依次向内层渗透;任何一个中间件若产生拦截(例如鉴权失败),将提前掉头返回。
- 路由树匹配与反向依赖解析:框架根据 URL 路径在路由树中定位目标函数,并通过 Python 的
inspect模块反向解析函数的参数签名。 - 依赖注入容器(Dependency Injection):逐级解析
Depends。例如在进入处理函数之前,自动从连接池申请数据库 Session 并绑定事务,将模型校验后的 Pydantic 对象注入参数。 - 响应退出与资源回收:函数执行完成后,数据经响应模型脱敏与序列化,随后倒序触发 Depends 的
yield后置逻辑(如自动commit或rollback,并将数据库连接稳妥归还连接池)。
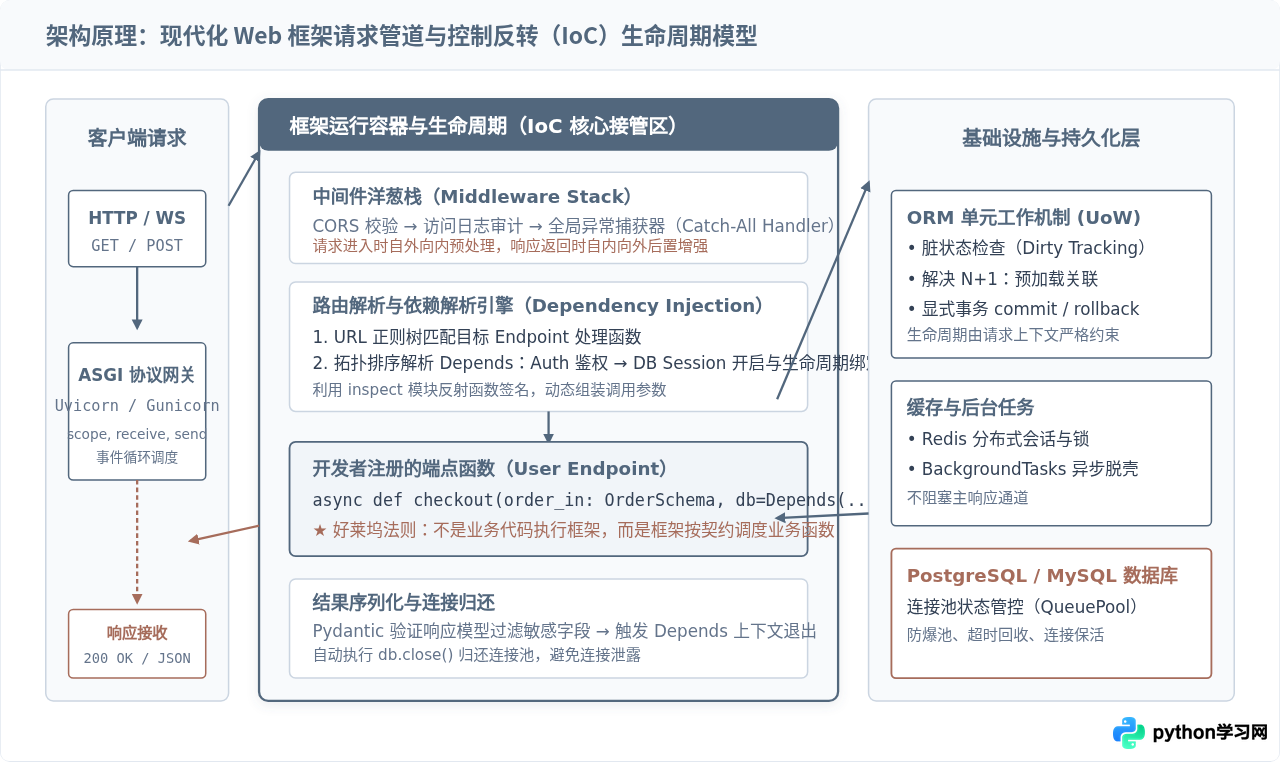
2. 依赖注入(DI)的正确使用与测试价值
初学者常在路由函数内部直接 import db 并创建数据库连接。这种写法让函数与全局状态死死绑定在一起,无法进行隔离测试。而理解 IoC 的开发者,会充分利用框架的依赖注入机制:
from typing import Annotated
from fastapi import FastAPI, Depends, HTTPException, status
from sqlalchemy.orm import Session

app = FastAPI()

# 依赖项严格管理生命周期:请求到来时生成,请求完毕后安全释放
def get_db():
    db = SessionLocal()
    try:
        yield db
    finally:
        db.close()

# 业务路由:由框架容器负责注入依赖
@app.post("/orders/{order_id}/pay", status_code=status.HTTP_200_OK)
def pay_order(
    order_id: str,
    db: Annotated[Session, Depends(get_db)]
):
    service = OrderService(db)
    success = service.checkout(order_id)
    if not success:
        raise HTTPException(status_code=400, detail="支付处理失败")
    return {"status": "success", "order_id": order_id}
当编写集成测试时,合格开发者只需要一行 app.dependency_overrides[get_db] = get_test_db,就能零侵入地将生产数据库替换为内存数据库(SQLite Memory)或 Mock 对象。这就是理解框架设计思想所带来的工程收益。
四、数据持久化与高并发:ORM 与异步机制的避坑法则
在框架的实战应用中,ORM(对象关系映射)与并发处理是初学者频频受挫的重灾区。
1. ORM 不是纯字典:根治 N+1 查询与事务泄露
初学者往往误把 SQLAlchemy 或 Django ORM 的查询集当做普通的 Python 列表。典型错误是在视图中循环遍历主表,并在循环内部读取关联字段:
# 典型的初学者灾难代码:N + 1 次数据库查询
orders = db.query(OrderModel).limit(100).all()
for o in orders:
    # 每次访问 o.user.username,ORM 都会向数据库触发一次单独的 SELECT 查询!
    print(o.user.username)
这种代码在开发环境面对几条测试数据时运行顺畅,一旦部署到线上,100 条订单就会瞬间产生 101 次网络 I/O,直接打满数据库连接池。合格开发者对生成的原始 SQL 保持高度敬畏,熟练运用贪婪加载(Eager Loading):在 SQLAlchemy 中使用 joinedload() 或 selectinload(),在 Django 中使用 select_related() 或 prefetch_related(),将查询次数压缩为 1 次或固定的 2 次。
2. 异步(async/await)生态的致命踩坑
许多初学者看到 FastAPI 的高并发宣传,便在所有路由前机械地加上 async def。然而紧接着,他们就在异步路由内部直接调用 requests.get()、time.sleep() 或同步数据库驱动。
Python 的异步运行在单线程事件循环(Event Loop)之上。在 async def 内部执行任何阻塞式 I/O 操作,都会直接冻结整个事件循环线程,导致所有并发访问的用户全部陷入等待卡顿。如果必须使用同步阻塞库,要么使用普通的 def(框架会自动将其放入后台线程池中执行),要么通过 asyncio.to_thread() 显式交出调度权。
五、全景总结:从“能跑就行”到工程化跨越
初学者到合格开发者的进阶,是一个从“关注语法指令”到“掌控系统生命周期与架构边界”的心智模型升级。写出“能跑”的代码只是入门的第一步,写出“易读、自守卫、低耦合、可测试、可扩展”的代码才是合格工程师的专业底色。
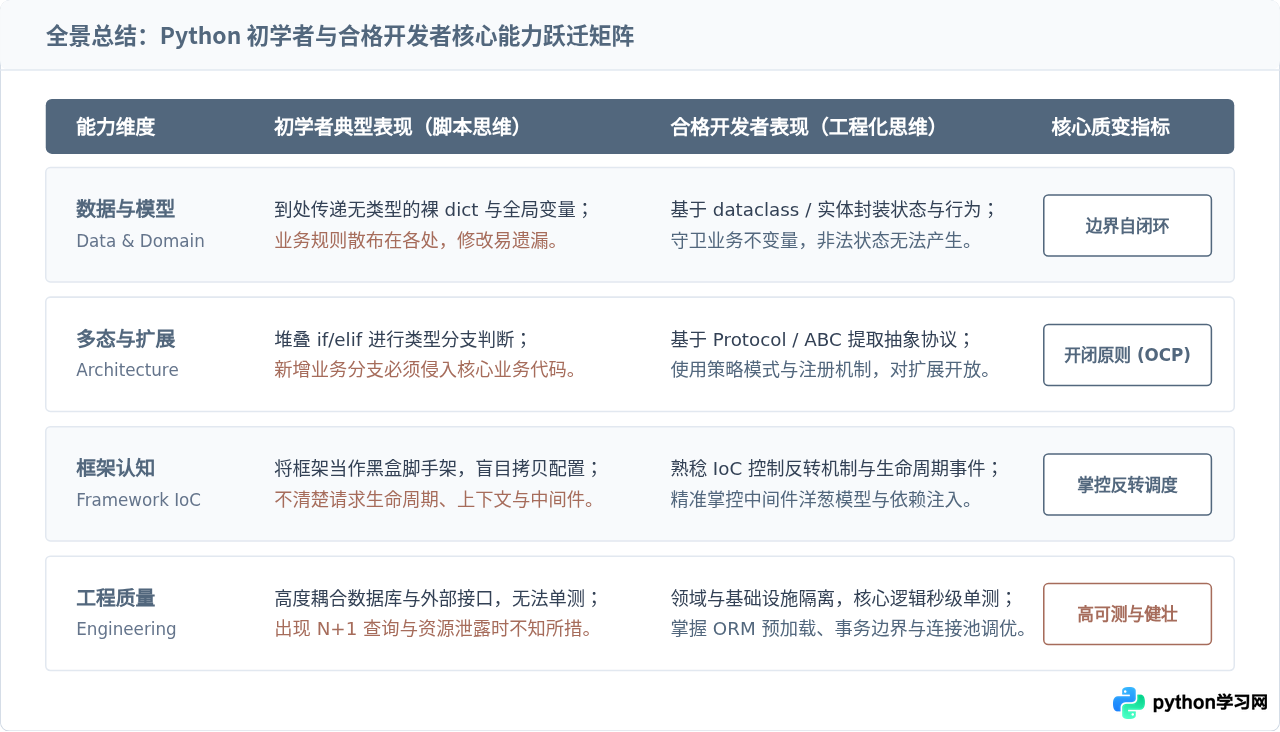
在日常开发中,跨越这一差距的最高效途径,并不是通读语法手册,而是:
- 在每次动手写代码前,先建模:放弃直接开辟字典的做法,先用
dataclass或领域类明确数据的属性类型与不可变边界。 - 定期重构分支逻辑:当代码中出现重复的条件分支时,尝试用策略模式或
Protocol进行抽象解耦。 - 深入断点调试框架源码:在进入框架的第一个中间件和路由分发处打下断点,单步跟进一次请求的完整生命周期,彻底拆开黑盒。
- 坚持编写单元测试:当发现自己的代码难以编写单元测试时,往往正是代码缺乏面向对象抽象与依赖注入的直接信号。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















