


Python用当前时间字符串生成文件名实战
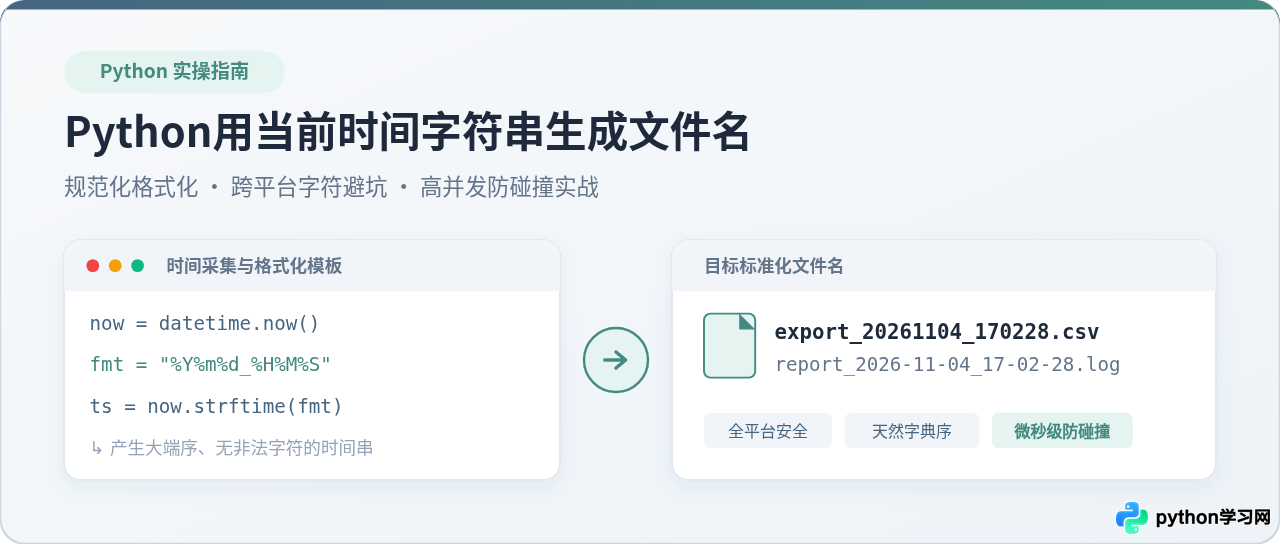
深入讲解在Python中使用当前时间字符串生成文件名的完整实战方案,涵盖datetime模块格式化、跨平台字符安全规范、高并发防重名策略与pathlib工程化封装。
datetime 模块获取时间对象,利用 strftime 方法按照安全字符模板格式化为时间字符串,再结合前缀、后缀及 pathlib.Path 构建目标路径。本文通过具体的代码示例、跨平台安全规范、防碰撞策略以及工程化封装函数,系统讲解从零实现规范化时间戳文件名的完整流程。
一、核心机制:datetime 模块与 strftime 格式化
Python 标准库中的 datetime 模块提供了完备的日期与时间处理能力。生成时间字符串的第一步是调用 datetime.now() 捕获当前系统时间对象,随后调用 strftime()(即 String Format Time)方法把时间对象按照指定的占位符转换为字符串。
格式化字符串由各种占位符构成,每个占位符以 % 开头,指代特定的时间单位。为了生成跨平台安全且语义明确的文件名,通常使用以下占位符:
| 占位符 | 含义说明 | 取值范围与示例 | 在文件名中的工程意义 |
|---|---|---|---|
%Y |
四位完整年份 | 如 2026 |
避免跨年或长期归档时的世纪混淆 |
%m |
两位月份(带前导零) | 01 - 12 |
保持月份宽度一致,满足字典序排列 |
%d |
两位日(带前导零) | 01 - 31 |
保证日期宽度统一为两位 |
%H |
24小时制小时数 | 00 - 23 |
消除 12 小时制上午与下午造成的命名歧义 |
%M |
两位分钟数 | 00 - 59 |
保证分钟对齐 |
%S |
两位秒数 | 00 - 59 |
秒级精确定位 |
%f |
微秒(6位数字) | 000000 - 999999 |
高频批量落盘时的防冲突扩展 |
基础生成示例
在实际生产中,最常见的两类格式是紧凑型(无标点连接)与分隔型(连字符与下划线连接)。利用 Python 的 f-string 语法,能够清晰地将业务前缀、时间串和文件扩展名进行组装:
from datetime import datetime

# 1. 采集当前本地时间
now = datetime.now()

# 2. 模式 A:紧凑型(年月日_时分秒,推荐用于备份、日志归档与程序解析)
ts_compact = now.strftime("%Y%m%d_%H%M%S")
filename_compact = f"backup_{ts_compact}.tar.gz"

# 3. 模式 B:分隔型(连字符分隔,推荐用于业务报表人工查阅)
ts_readable = now.strftime("%Y-%m-%d_%H-%M-%S")
filename_readable = f"report_{ts_readable}.xlsx"

print("紧凑型文件名:", filename_compact)
print("易读型文件名:", filename_readable)易读型文件名: report_2026-11-04_17-02-28.xlsx
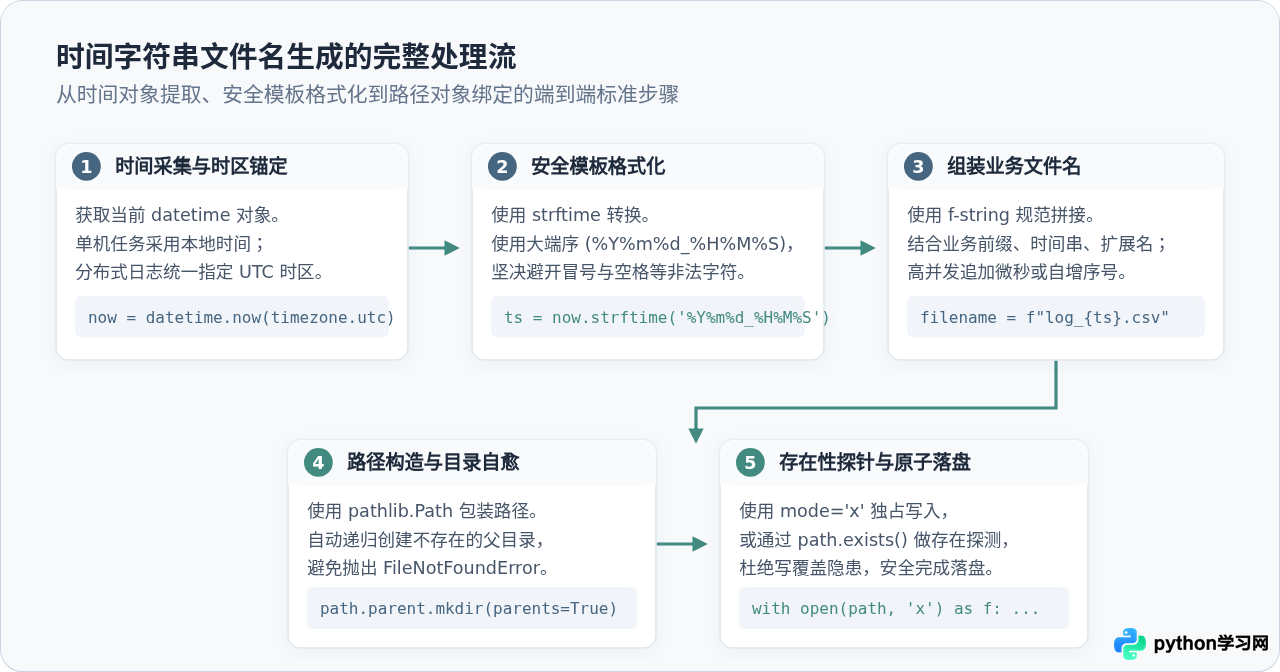
这一过程体现了时间文件名生成的规范流转:从时间对象采集,到安全模板格式化,再到组装落地为有效路径。
二、跨平台安全规范与字符避坑指南
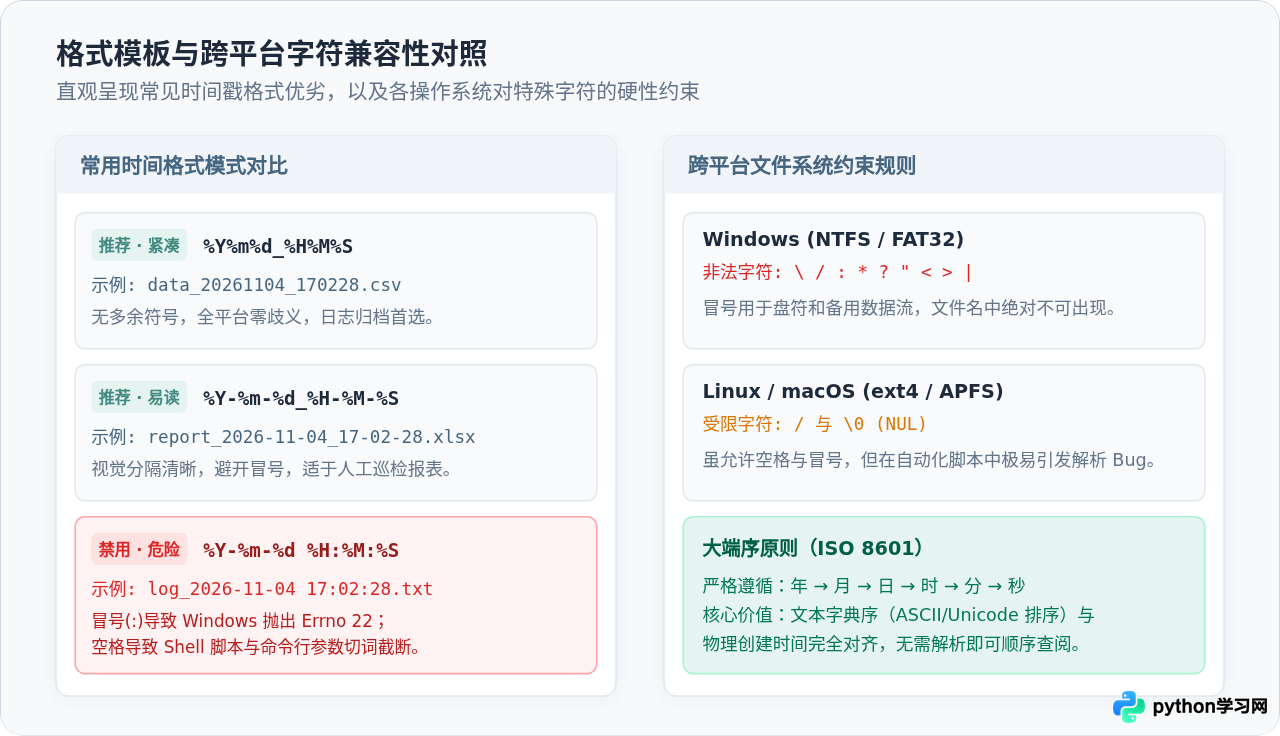
初学者在用时间生成文件名时,常习惯性直接套用日常显示格式(如 2026-11-04 17:02:28)。这种写法在控制台打印时清晰易读,但直接作为文件名在多平台部署时会引发严重的系统错误。
1. 为什么文件名中绝对不能出现冒号(:)?
在 Windows 系统的 NTFS 与 FAT32 文件系统中,冒号 : 属于严格保留字符。它不仅用于指示驱动器盘符(如 C:),还用于标识 NTFS 的备用数据流(Alternate Data Streams, ADS)。
如果在 Windows 下尝试执行 open("2026-11-04_17:02:28.log", "w"),操作系统内核会把冒号后的内容判定为数据流名称,进而引发底层系统调用失败:
OSError: [Errno 22] Invalid argument: '2026-11-04_17:02:28.log'这会导致在 Linux/macOS 环境下开发测试一切正常的程序,一旦移交到 Windows 服务器运行就会直接崩溃。
2. 为什么应尽量避免空格与斜杠?
- 斜杠
/与反斜杠\: 在 POSIX 和 Windows 系统中均被固化为路径分隔符。如果模板写为%Y/%m/%d_%H%M%S,Python 会将其识别为“在名为%Y的子目录下创建文件”,在目录未提前建立时直接抛出FileNotFoundError。 - 空格字符: 尽管现代操作系统允许文件名存在空格,但在 Linux 终端、Shell 管道、Docker 容器脚本或 CI/CD 自动化构建中,含空格的文件名若未严格加引号转义,会被解析为多个独立命令行参数,造成脚本中断或误删文件。
3. 大端序(Big-Endian)保障天然字典排序
根据 ISO 8601 国际标准,时间表示法应当按由大到小的层级排列:年 → 月 → 日 → 时 → 分 → 秒。切忌采用部分西方地区的 %d-%m-%Y(日月年)或 %m-%d-%Y(月日年)。
在大端序下,文件名的字符串字典序(ASCII / Unicode 字母排序)与真实物理时间的先后顺序完全重合。在操作系统文件管理器按名称排序,或使用 Shell 命令 ls -l 时,最新产生的文件自然排列在最后,极大方便了历史文件的归档、巡检与轮转清理。
三、高并发与高频写入场景下的防碰撞策略
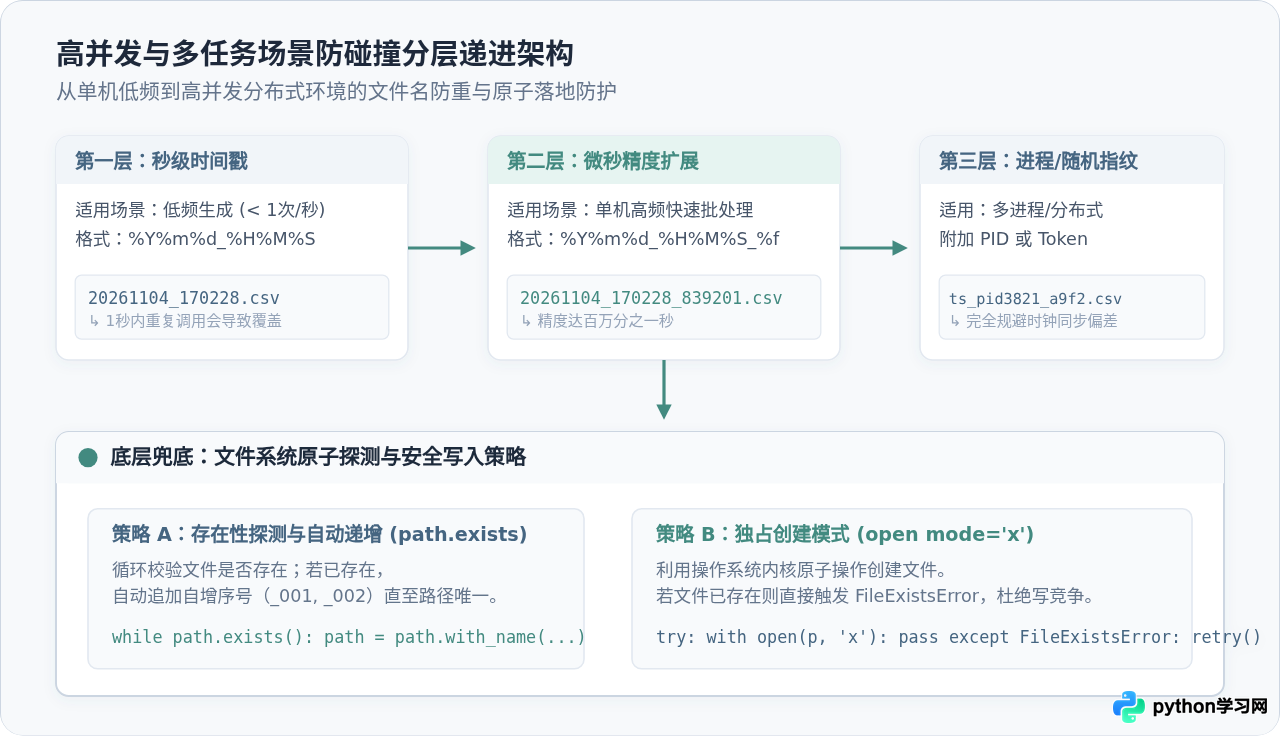
在低频触发任务(例如每小时执行一次的汇总脚本)中,秒级粒度(%Y%m%d_%H%M%S)已经足够区分文件。然而,在快速批量循环导出、网络爬虫多协程落盘或高并发 Web 服务的场景中,1 秒内可能产生数十甚至上千个文件。如果仅依赖秒级时间戳,后续写入会直接覆盖先前写入的文件,导致不可逆的数据损坏。
防碰撞分层防护设计
-
微秒级精度扩展(
%f):
在格式中引入%f占位符。%f固定生成 6 位微秒数字(例如20261104_170228_839201)。在单机单进程普通循环中,循环体执行开销通常在几十微秒以上,微秒级精度即可彻底杜绝绝大多数同秒覆盖问题。 -
递增序号避让(Counter Suffix):
在紧凑批处理中,即便出现同微秒冲突,也可在检测到路径存在时自动追加_001、_002等三位前导零序号,形成闭环递增重试。 -
多进程/分布式随机指纹:
在 Celery 异步工作节点或多进程 Worker 中,各节点系统时钟可能存在微小纳秒同步误差,可能在同一微秒生成任务。此时在文件名末尾附加当前进程号(os.getpid())或由secrets.token_hex(2)生成的 4 位随机字符,能有效切分各节点的命名空间。
底层防线:使用独占创建模式 mode='x' 杜绝竞态漏洞
很多代码习惯采用“先检查再写入”的逻辑:通过 os.path.exists() 检查文件是否存在,确认不存在后再执行 open(path, 'w')。在多进程并发环境下,这构成了典型的 TOCTOU(Time-of-check to time-of-use)竞争条件:两进程几乎同时检查到文件不存在,随后先后执行 'w' 模式,导致后写入者强行覆盖先写入者。
Python 提供了原生原子独占创建模式 open(path, 'x')(底层绑定操作系统的 O_CREAT | O_EXCL 标志位)。如果文件已存在,内核会以原子方式直接抛出 FileExistsError,绝不会损坏已有文件内容,配合捕获异常即可实现安全的重试轮询。
四、工程化封装与实战代码
在工程落地时,应避免在各业务模块中重复散落时间格式化代码。借助现代 Python 标准库的 pathlib.Path,可以构建一个健壮、支持时区切换、自动建立多级目录且具备防重名能力的通用函数。
工业级封装函数实现
以下函数封装了时区识别、精度切换、跨平台路径构造以及文件存在性自动递增避让,可直接作为通用工具函数集成:
import os
import secrets
from datetime import datetime, timezone
from pathlib import Path
from typing import Union

def generate_timestamped_filepath(
    directory: Union[str, Path] = "./output",
    prefix: str = "export",
    suffix: str = ".csv",
    use_utc: bool = False,
    include_microsecond: bool = False,
    include_token: bool = False,
    auto_increment_if_exists: bool = True
) -> Path:
    """
    生成规范、安全、防碰撞的时间戳文件完整路径。

    参数:
        directory: 目标存放目录(自动创建缺失的多级父目录)
        prefix: 文件名前缀(如业务标识、模块名)
        suffix: 文件扩展名(自动清洗并补齐前导点)
        use_utc: 是否采用 UTC 时区(跨区域服务、服务器日志推荐 True)
        include_microsecond: 是否引入微秒(高频批量落盘推荐 True)
        include_token: 是否追加 4 位短随机十六进制串(多进程并发推荐 True)
        auto_increment_if_exists: 目标文件若已存在,是否自动递增序号重试

    返回:
        pathlib.Path: 规范化且可直接用于文件写入的 Path 对象
    """
    dir_path = Path(directory)
    # 自动安全建立多级父目录,已存在则静默忽略
    dir_path.mkdir(parents=True, exist_ok=True)

    # 规范化扩展名格式,确保以点号开头
    clean_suffix = suffix if (suffix.startswith(".") or not suffix) else f".{suffix}"

    # 选定时间基准
    now = datetime.now(timezone.utc) if use_utc else datetime.now()

    # 根据精度要求选定时间模板
    if include_microsecond:
        time_str = now.strftime("%Y%m%d_%H%M%S_%f")
    else:
        time_str = now.strftime("%Y%m%d_%H%M%S")

    # 组装基础文件名各组成单元
    parts = []
    if prefix:
        parts.append(prefix.strip("_-/\\"))
    parts.append(time_str)

    if include_token:
        parts.append(secrets.token_hex(2))  # 4 位十六进制防冲突随机串

    base_stem = "_".join(parts)
    candidate_path = dir_path / f"{base_stem}{clean_suffix}"

    # 防碰撞处理:若路径已存在,自动通过自增序号进行避让
    if auto_increment_if_exists and candidate_path.exists():
        counter = 1
        while candidate_path.exists():
            candidate_path = dir_path / f"{base_stem}_{counter:03d}{clean_suffix}"
            counter += 1

    return candidate_path
场景调用示例与结果验证
下面演示三种常见业务场景下的调用方式及其生成的文件路径形态:
# 场景 1:常规单机报表导出(本地时间,秒级精度)
path_report = generate_timestamped_filepath(
    directory="./reports",
    prefix="sales_summary",
    suffix=".xlsx"
)

# 场景 2:分布式日志归档(强制 UTC 时区,微秒精度 + 随机防重标识)
path_log = generate_timestamped_filepath(
    directory="./logs/audit",
    prefix="audit_event",
    suffix=".json",
    use_utc=True,
    include_microsecond=True,
    include_token=True
)

# 场景 3:快速高频循环生成(验证自增防重名机制)
batch_paths = [
    generate_timestamped_filepath(
        directory="./batch_jobs",
        prefix="task",
        suffix=".dat",
        include_microsecond=False
    )
    for _ in range(3)
]

print("场景 1 输出路径:", path_report)
print("场景 2 输出路径:", path_log)
print("场景 3 循环输出:")
for p in batch_paths:
print(" ->", p)场景 2 输出路径: logs/audit/audit_event_20261104_090228_654120_8f3a.json
场景 3 循环输出:
-> batch_jobs/task_20261104_170228.dat
-> batch_jobs/task_20261104_170228_001.dat
-> batch_jobs/task_20261104_170228_002.dat
观察场景 3 的输出可见,即使在同一秒内高频触发且未启用微秒选项,内部探测逻辑也能自动平滑延展出 _001、_002 后缀,有效保障已有数据不被覆写。
五、生产实践规范与检查清单
为了确保团队开发中时间戳文件命名规范的一致性与健壮性,建议在代码评审时对照以下四项维度进行检查。
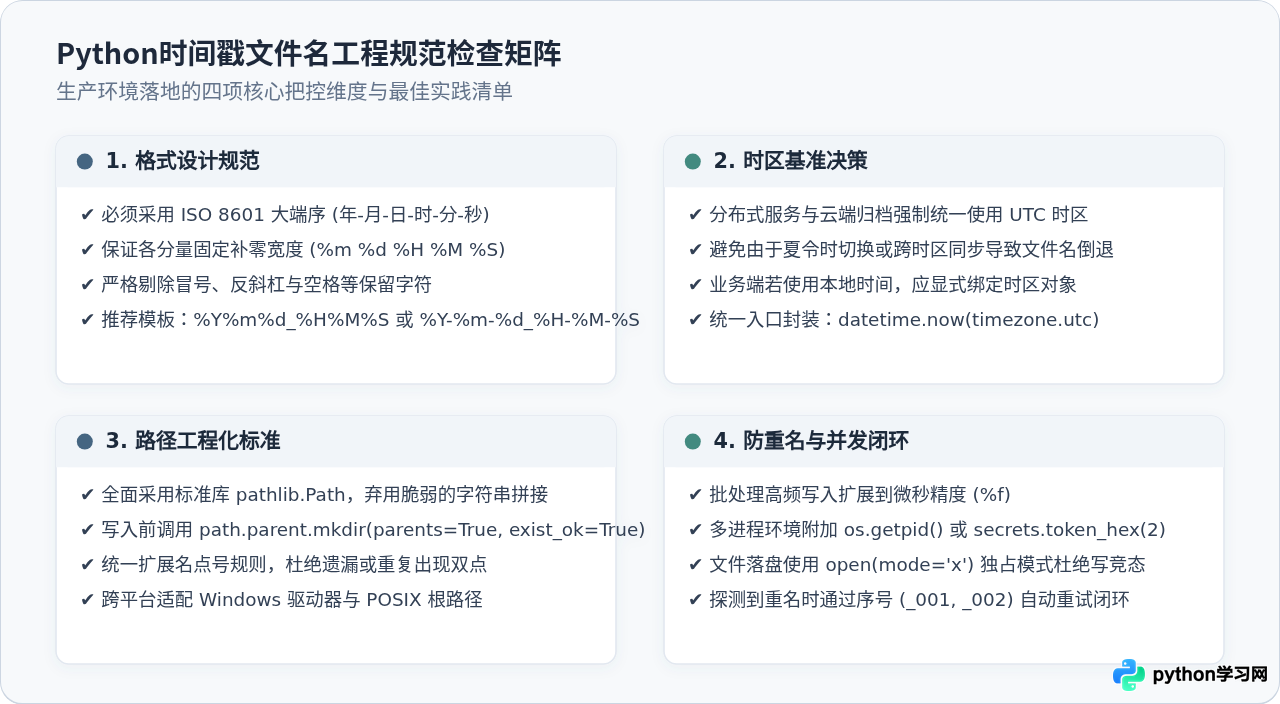
落地实施时,可重点把控以下四条法则:
-
大端序与合法字符集: 严格按照由大到小次序排布(
%Y%m%d_%H%M%S),坚决杜绝在文件名中加入冒号:、反斜杠\、正斜杠/与空格。 -
时区明确化管理: 单机桌面工具使用本地时间便于用户检索;涉及云端日志、分布式服务、跨地域多集群写入时,强制绑定
timezone.utc,防范夏令时调表或跨时区同步导致的文件名时间倒置。 -
全面普及
pathlib.Path: 弃用易出错的字符串路径拼凑,统一通过Path / name构造跨平台路径,并在写入前执行path.parent.mkdir(parents=True, exist_ok=True)确保目录就绪。 -
依并发等级追加冗余: 低频秒级足够,批处理追加微秒
%f,高并发多进程追加 PID 与随机 Token,并结合open(path, 'x')独占模式实现底层原子防御。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















