


Python嵌套for循环遍历二维列表的方法
深入讲解Python中使用嵌套for循环遍历二维列表的核心方法、执行机制、带索引坐标定位、原位元素修改与锯齿列表安全处理技巧。
for 循环:由外层循环按序提取每一行(即内部子列表),再由内层循环遍历当前行中的每个具体元素。本文将完整讲解基础元素遍历、带坐标索引定位、原位元素修改、不规则锯齿列表处理及列表推导式等实用方案与关键避坑要点。
一、二维列表的基础结构与只读元素遍历
在处理表格、矩阵或棋盘这类网格型数据时,Python 通常使用嵌套列表表示。最基础的需求是顺序读取每一个单元格的数值(例如求和、查找或打印展示)。此时直接使用双层变量解包遍历,代码结构最为简明清晰。
1. 完整代码示例
以下示例创建了一个标准的 3×3 二维整数列表,并通过外层与内层循环依次访问各元素:
# 基础环境:Python 3.6+
# 运行位置:本地任意 Python 脚本或交互式终端

matrix = [
    [10, 20, 30],
    [40, 50, 60],
    [70, 80, 90]
]

# 外层循环逐行遍历
for row in matrix:
    # 内层循环遍历当前行的每个元素
    for item in row:
        print(f"{item:2d}", end="  ")
print() # 换行输出,保持矩阵外观40 50 60
70 80 90
在这段代码中,外层变量 row 在每一次迭代中依次绑定 [10, 20, 30]、[40, 50, 60] 和 [70, 80, 90]。在每次外层迭代未结束前,内层循环会立即接管当前的 row,将其中的每个数字赋给 item 并打印。
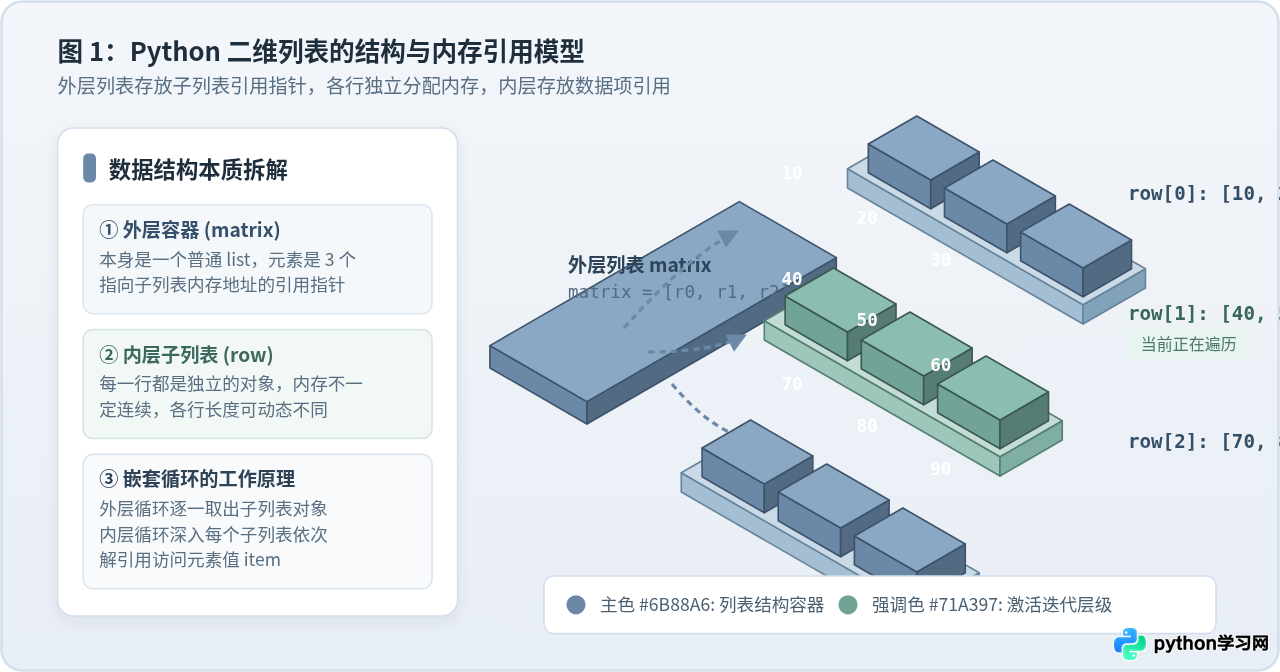
row 是一个真实的子列表对象引用。
二、嵌套 for 循环的操作执行步骤与指针流转机制
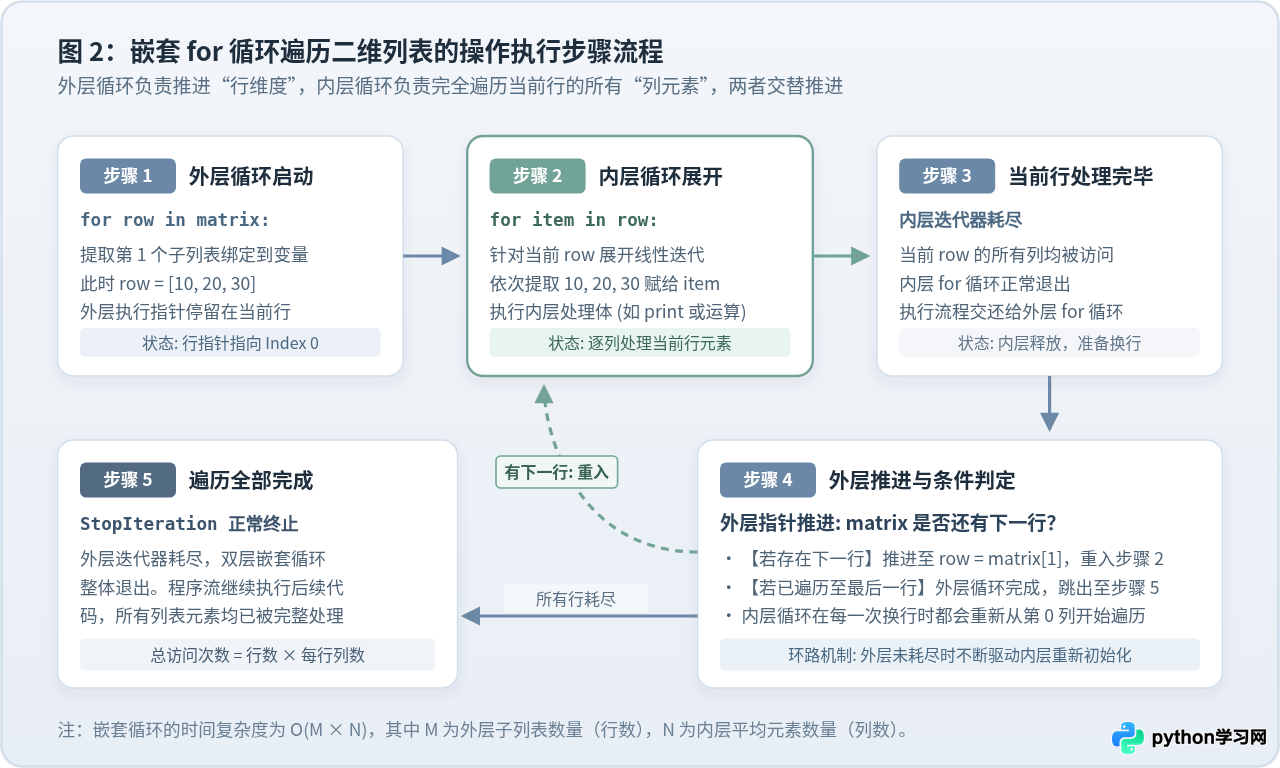
初学者在编写嵌套循环时,常会对代码的实际执行次序产生混淆。理解嵌套循环的关键在于建立清晰的“行推进”与“列推进”交替时序。
嵌套循环的具体操作过程可以分为以下五个标准阶段:
- 外层循环指针就位:外层迭代器访问
matrix的第 0 个槽位,提取第 0 行子列表并赋给变量row; - 内层循环从头展开:针对当前的
row,内层迭代器启动,从下标 0 开始依次获取元素,执行循环体中的业务逻辑; - 内层循环耗尽退出:当前行的所有列元素访问完毕,内层循环触发
StopIteration并退出; - 外层循环步进换行:执行完内层循环及外层紧随其后的代码(如换行符
print())后,外层指针向后推进一步,取出下一行子列表,重新进入步骤 2; - 全量遍历终止:当外层列表的所有子列表均已被取尽后,外层循环正常结束,程序流继续向下执行。
三、带索引坐标的遍历:使用 enumerate 获取行列下标
当业务场景不仅需要获取数值,还需要确切知道元素所在的行号与列号(例如定位某个特定数据在第几行第几列,或者需要根据坐标修改列表元素)时,直接遍历元素就无法满足需求了。
部分习惯传统语言的开发者可能会使用 range(len(matrix)) 和 range(len(matrix[i]))。但在 Python 中,更推荐使用内置函数 enumerate(),它能在迭代的同时提供自然递增的计数索引,语法更具表现力且不易写错边界。
1. 完整代码示例:坐标定位与搜索
# 使用双层 enumerate 获取行列坐标
grid = [
    ['A', 'B', 'C'],
    ['D', 'E', 'F'],
    ['G', 'H', 'I']
]

target = 'E'

for row_idx, row in enumerate(grid):
    for col_idx, val in enumerate(row):
        if val == target:
            print(f"目标值 '{target}' 匹配成功,位于坐标: 行 {row_idx}, 列 {col_idx}")
break2. 遍历修改原列表元素的关键陷阱
许多开发者在尝试批量修改二维列表时容易落入一个典型陷阱:试图在 for val in row: 中直接对 val 赋值(如 val = val * 2)。这种修改完全无效,因为 val 只是循环迭代过程中产生的临时局部变量,重新绑定它不会对原列表产生任何影响。
要真正修改原列表中的元素,必须使用双层坐标通过下标语法原地赋值:
scores = [
    [60, 75, 80],
    [55, 90, 85]
]

# 给所有低于 70 分的成绩加上 5 分奖励分(原位修改)
for r_idx, row in enumerate(scores):
    for c_idx, val in enumerate(row):
        if val < 70:
            scores[r_idx][c_idx] = val + 5  # ✔ 正确:原位写入内存槽位

print("修改后的二维列表:", scores)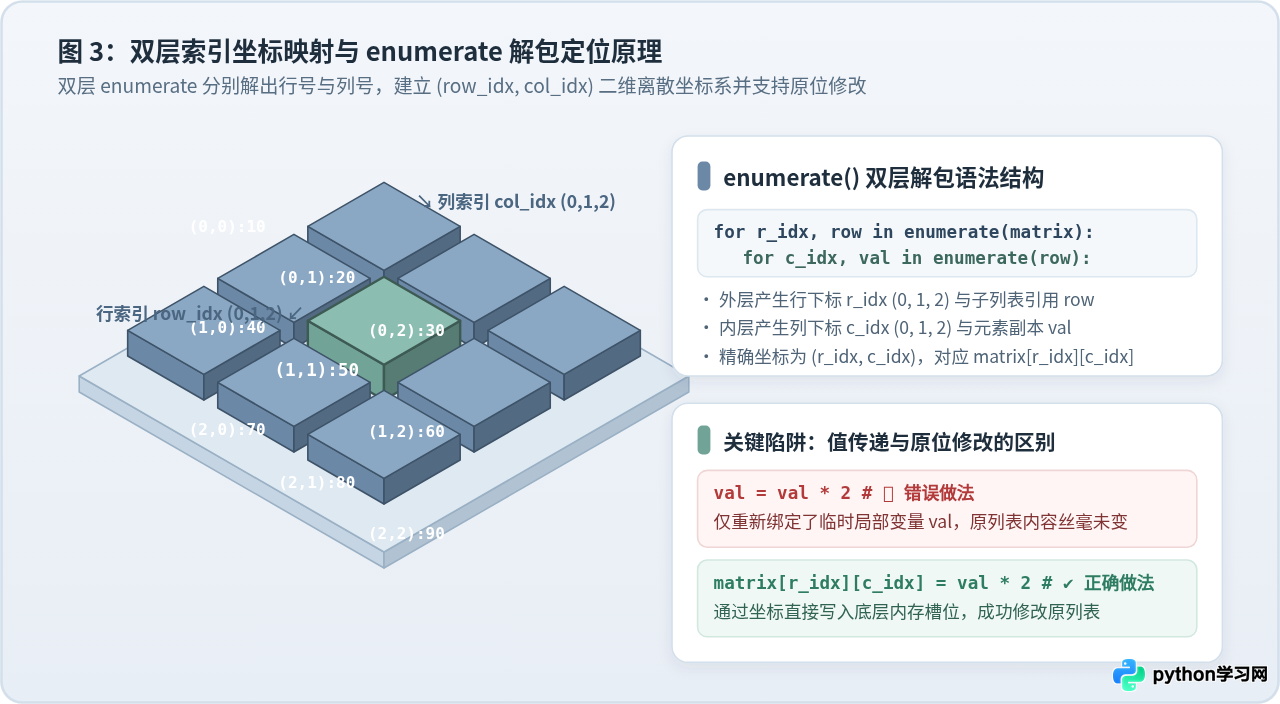
val = val + 5。Python 中的整数、浮点数和字符串均为不可变对象(Immutable),修改必须落实到 matrix[row_idx][col_idx] = new_value 才能持久化生效。
四、不规则锯齿列表(Jagged List)的安全遍历
在实际生产环境中,二维列表中的各个子列表长度可能并不完全相等,这种结构被称为“不规则二维列表”或“锯齿列表(Jagged List)”。
例如,存储不同用户的历史登录时间戳,或者不同部门的员工名单时,每一行的元素个数通常不同。
# 不规则锯齿列表:各行长度不一致
jagged_list = [
    ["Python", "Go"],
    ["C++", "Java", "Rust", "Swift"],
    ["SQL"]
]

# 原生嵌套循环自适应遍历
for row_idx, row in enumerate(jagged_list):
    print(f"第 {row_idx} 行包含 {len(row)} 个元素: ", end="")
    for item in row:
        print(item, end=" | ")
print()第 1 行包含 4 个元素: C++ | Java | Rust | Swift |
第 2 行包含 1 个元素: SQL |
鲁棒性分析:基于迭代器协议的 for item in row 具有天生的自适应能力。内层循环会在当前子列表耗尽时自动终止,绝不会发生越界。反之,如果错误地硬编码了固定列数(例如使用 range(4)),在访问第 0 行时就会立刻抛出 IndexError: list index out of range。
五、嵌套列表推导式:单行高效扁平化与过滤
当遍历二维列表的最终目的是生成一个新的一维列表(即“扁平化”操作)或者按照特定条件筛选元素时,嵌套列表推导式(List Comprehension)提供了更加紧凑、高效的替代方式。
1. 扁平化二维列表
将二维矩阵拍平成一维连续序列:
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

# 列表推导式展开二维列表
flattened = [item for row in matrix for item in row]
print("扁平化结果:", flattened)for 的书写顺序与普通嵌套 for 循环完全一致——外层循环在前,内层循环在后。即先 for row in matrix,紧接着 for item in row。
2. 带条件过滤的嵌套推导式
# 仅筛选出其中的所有偶数并求平方
even_squares = [item ** 2 for row in matrix for item in row if item % 2 == 0]
print("偶数平方结果:", even_squares)六、遍历过程中的严禁操作:禁止在循环中增删元素
在双层循环遍历过程中,严禁直接在内层循环中调用 row.remove()、row.pop() 或者 del row[i]。
这是因为 Python 的列表迭代器是通过内部整数索引指针依次向前移动的。如果删除了某个元素,其后方所有元素的索引都会向前移位,导致指针下一次步进时直接跳过紧邻的下一个元素,造成“漏项”逻辑故障,在不规则删除时还可能引起边界异常。
正确修复方案:若需要过滤删除元素,应通过列表推导式构建新的清洗后列表,或者使用深拷贝/倒序遍历进行操作。
七、遍历方法选型与最佳实践总结
针对不同的工程应用场景,应根据具体的数据形态和操作目的选择最适宜的遍历方案:
| 遍历方式 | 核心语法结构 | 典型适用场景 | 主要优势与特点 |
|---|---|---|---|
| 纯元素嵌套循环 | for row in matrix: |
只读访问、控制台打印、累加求和 | 语法最为直观,代码可读性最高,零额外开销 |
| 双层 enumerate 循环 | for r, row in enumerate(matrix): |
需要行列坐标、定位查找、原位覆写元素 | 直接提供解包坐标,杜绝手动维护计数器的冗余 |
| 嵌套列表推导式 | [x for row in matrix for x in row] |
二维列表扁平化、结合 if 条件过滤生成新列表 | 代码极其紧凑,底层由 C 级别执行,速度更快 |
| 锯齿数组迭代 | for row in matrix: |
各行长度不一致的动态稀疏网格 | 原生支持子列表长度差异,天然杜绝越界异常 |
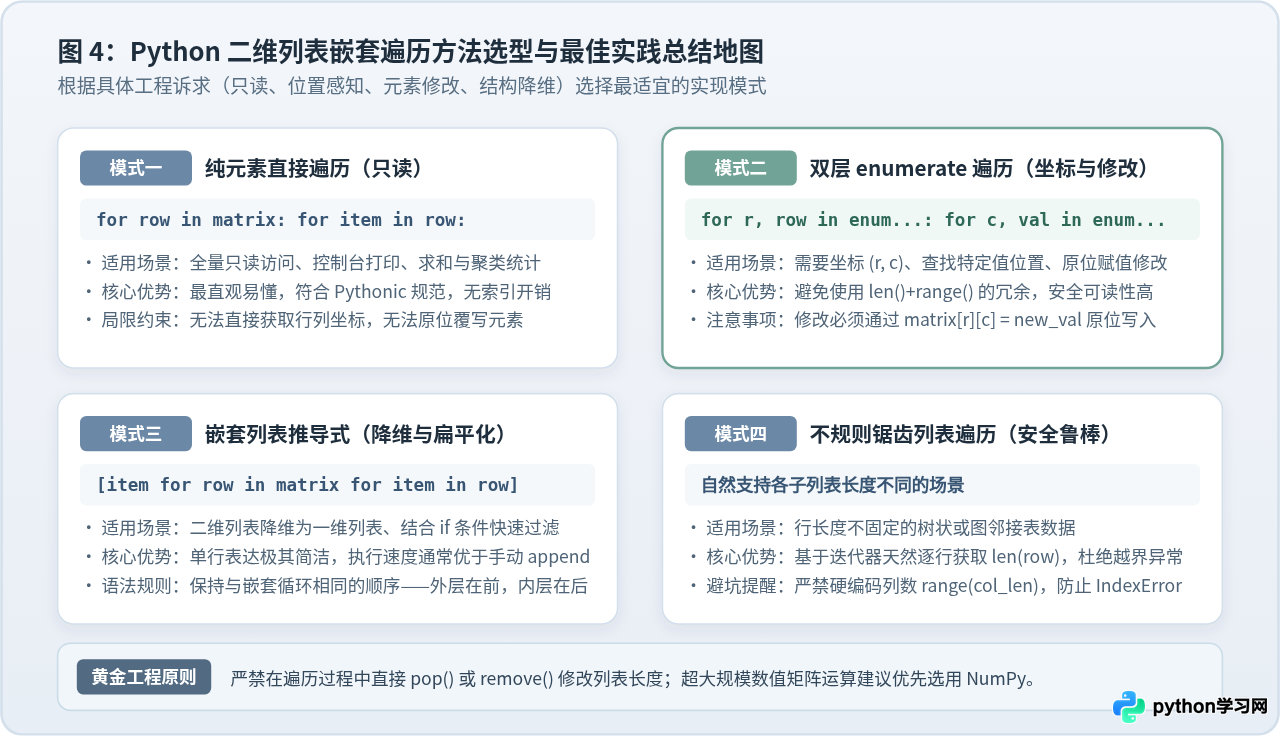
掌握嵌套 for 循环的核心逻辑,是编写健壮、可维护 Python 数据处理代码的基石。在常规业务开发中,应遵循“能只读则只读、需位置用 enumerate、需降维用推导式”的选型原则,并在高吞吐或密集科学计算场景下合理评估升级为 NumPy 数组的必要性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















