


Python做数据分析会取代R语言吗?两者未来发展趋势解析
针对Python是否会在数据分析领域彻底取代R语言的核心疑问,深入解析两者的底层设计定位、生态边界、工程协同架构及未来演进趋势,提供清晰的选型决策方法。
在数据分析与工程实践中,Python不会彻底取代R语言。虽然Python在通用编程、工程落地和机器学习工程化领域占据绝对主导地位,但R语言在严谨统计推断、学术科研、生物信息分析以及专业统计出版级制图领域拥有不可替代的专业壁垒。两者的关系正由早期的单向替代争论,演变为长期的生态分工与跨语言混合协同。
一、生态边界与设计哲学的本质差异
判断一种工具是否会被另一种工具淘汰,核心不在于用户规模的增减,而在于两者的系统底层设计与目标场景是否存在根本重叠。Python与R语言从诞生之初,设计定位就走向了不同的技术路径。
Python是一门具备通用开发能力的全功能面向对象编程语言。数据处理在Python中是作为扩展库(如NumPy、Pandas)挂载在语言之上的。Python的设计追求语法的一致性、代码的可读性以及与下游生产环境(如后端微服务、分布式计算集群、自动化运维)的无缝拼接。
R语言则是一门由统计学家专门为数据分析和统计计算打造的交互式数学语言。在R中,向量、因子、数据框是原生一等公民,统计分布函数直接内置在基础库中。其设计优先保证的是统计检验方法的数学严谨性与探索性数据分析的思维直达性。
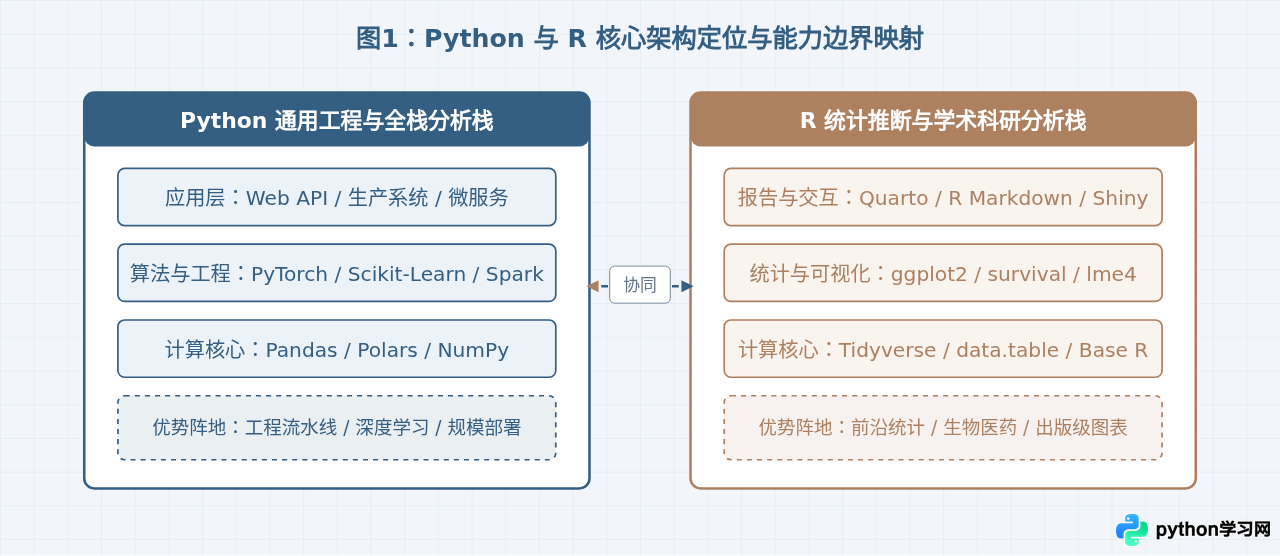
从上图可以看出,两者的价值重心并不在同一层面上。Python从下往上构建,天然贴合现代软件架构;R从统计方法与数据探索出发,天然贴合科研论文与统计实验。
二、关键任务维度的直接对比
在日常数据分析工作中,我们通常需要处理数据清洗、统计检验、专业建模与系统集成。以下表格清晰列举了两个工具在常见任务中的特性:
| 分析维度 | Python 表现与工具 | R 语言表现与工具 | 胜出场景与判断依据 |
|---|---|---|---|
| 数据清洗与转换 | Pandas, Polars 链式调用支持好,通用性强 |
Tidyverse (dplyr, tidyr), data.table 语法高度统一,流式管道体验佳 |
持平:通用系统偏向Polars,探索分析偏向Tidyverse |
| 传统统计检验与建模 | statsmodels, scipy.stats 覆盖经典方法,细节输出相对精炼 |
Base R, lme4, survival, car 涵盖全球最新统计论文成果,输出极详尽 |
R 胜出:药物临床、社会学推断、复杂混合效应模型首选R |
| 机器学习与深度学习 | Scikit-Learn, PyTorch, HuggingFace 工业标准,生态极其庞大 |
tidymodels, caret, mlr3 接口标准化高,但前沿算力框架多为封装 |
Python 胜出:神经网络、生产部署、计算机视觉与NLP完全主导 |
| 静态图表与科研制图 | Matplotlib, Seaborn, Plotly 支持精细定制,但底层语法层级较繁琐 |
ggplot2, lattice 基于“图形语法”设计,分面与出版级排版极快 |
R 胜出:Nature、Science等科研期刊发表级图表首选R |
| 工业化工程集成 | FastAPI, Airflow, Docker 原生融入DevOps工具链 |
Plumber, Shiny Server 适合搭建分析原型,大型高并发系统门槛高 |
Python 胜出:微服务交付、CI/CD与自动化管道必备 |
三、具体分析任务的代码实现差异
为了直观说明两者思维逻辑的不同,我们以一个标准的“按类别分组计算统计量,并进行两独立样本t检验”为例。对比两者的代码组织与结果呈现。
1. Python 实现(Pandas + SciPy)
import pandas as pd
from scipy import stats

# 1. 模拟实验数据
data = {
    'group': ['Treatment'] * 5 + ['Control'] * 5,
    'score': [88.5, 92.0, 79.5, 85.0, 91.0, 75.0, 80.5, 72.0, 78.0, 81.5]
}
df = pd.DataFrame(data)

# 2. 分组聚合统计
summary = df.groupby('group')['score'].agg(['mean', 'std', 'count'])
print("--- 分组描述统计 ---")
print(summary)

# 3. 双样本 t 检验 (假设方差非齐性)
treatment = df[df['group'] == 'Treatment']['score']
control = df[df['group'] == 'Control']['score']
t_stat, p_val = stats.ttest_ind(treatment, control, equal_var=False)

print("\n--- Welch's t-test 结果 ---")
print(f"t-statistic: {t_stat:.4f}, p-value: {p_val:.4f}")--- 分组描述统计 ---
mean std count
group
Control 77.40 3.847077 5
Treatment 87.20 5.130789 5
--- Welch's t-test 结果 ---
t-statistic: 3.4150, p-value: 0.01012. R 语言实现(Base R + Tidyverse)
library(dplyr)

# 1. 模拟实验数据
df <- data.frame(
  group = rep(c("Treatment", "Control"), each = 5),
  score = c(88.5, 92.0, 79.5, 85.0, 91.0, 75.0, 80.5, 72.0, 78.0, 81.5)
)

# 2. 分组聚合统计 (dplyr 管道)
summary_stat <- df %>%
  group_by(group) %>%
  summarise(
    mean = mean(score),
    sd = sd(score),
    n = n()
  )
print(summary_stat)

# 3. 双样本 t 检验 (公式语法)
t_test_result <- t.test(score ~ group, data = df, var.equal = FALSE)
print(t_test_result)# A tibble: 2 × 4
group mean sd n
<chr> <dbl> <dbl> <int>
1 Control 77.4 3.85 5
2 Treatment 87.2 5.13 5
Welch Two Sample t-test
data: score by group
t = -3.415, df = 7.4332, p-value = 0.01011
alternative hypothesis: true difference in means between group Control and group Treatment is not equal to 0
95 percent confidence interval:
-16.488339 -3.111661
sample estimates:
mean in group Control mean in group Treatment
77.4 87.2 逻辑对比分析:
- Python将过程拆解为独立模块(Pandas处理表格,SciPy处理检验),检验返回数值元组,便于后续写入数据库或接入API。
- R语言原生支持公式语法(
score ~ group),t.test直接输出自由度校正、置信区间、备择假设等完整统计学断言,无需开发者额外编写提取格式。这是统计学者青睐R的核心原因。
四、企业与科研中的协同工作流程
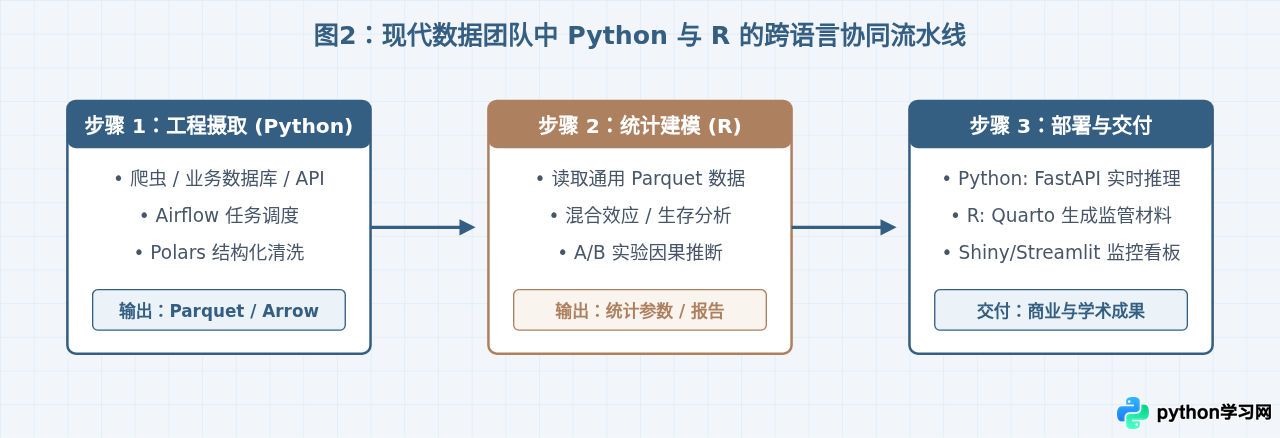
在实际生产中,成熟的技术团队不再将两者看作零和博弈,而是构建“Python负责工程基础设施,R负责核心洞察与统计验证”的双轨协同架构。借助现代序列化格式(如Apache Arrow、Parquet)和跨语言接口,两者的流转开销已被大幅压缩。
五、面向未来的选择逻辑与决策路径
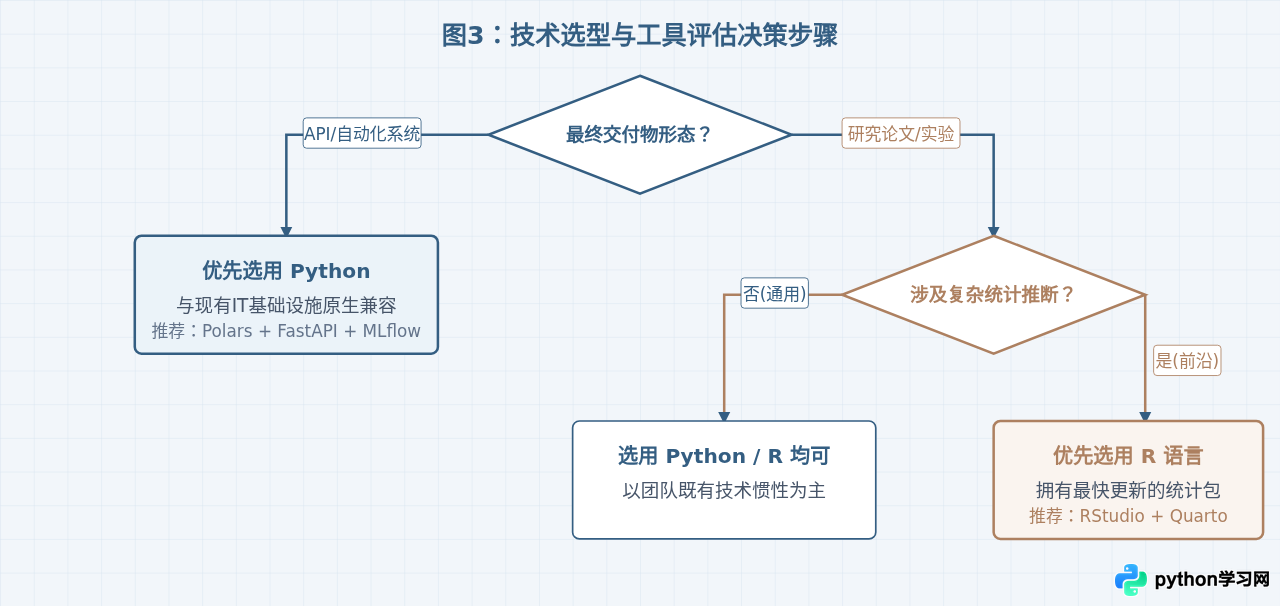
对学习者与团队负责人而言,争论“谁淘汰谁”不如明确“何时选谁”。以下决策树可作为实际选型或学习路线规划的操作依据:
六、未来发展趋势解析
结合当前计算框架与工具链的演进,两种语言在未来的格局呈现以下三个确定趋势:
- Python继续虹吸工业界与AI工程生态: 随着大语言模型(LLM)开发、向量检索和工业智能体系统的普及,Python作为主流大模型框架的通用“胶水语言”,在商业公司的技术栈中权重会进一步增加,成为企业数据分析师必须掌握的基础工具。
- R语言在特定垂直纵深领域形成高粘性护城河: 生物医学、临床试验监管(如FDA在新药申报中对R和SAS的严格审计标准)、计量经济学和学术出版领域,短时间内没有动力迁移到Python。这些领域的代码资产积累极深,统计口径容错率极低,构成了R难以撼动的护城河。
- 统一运行时与通用中间格式成为常态: 随着Posit(原RStudio公司)全力拥抱Python,其推出的通用科学排版系统Quarto已经能够原生混合渲染Python与R代码块。与此同时,基于内存级共享的标准格式(如Arrow)正在消解跨语言调用的性能惩罚。
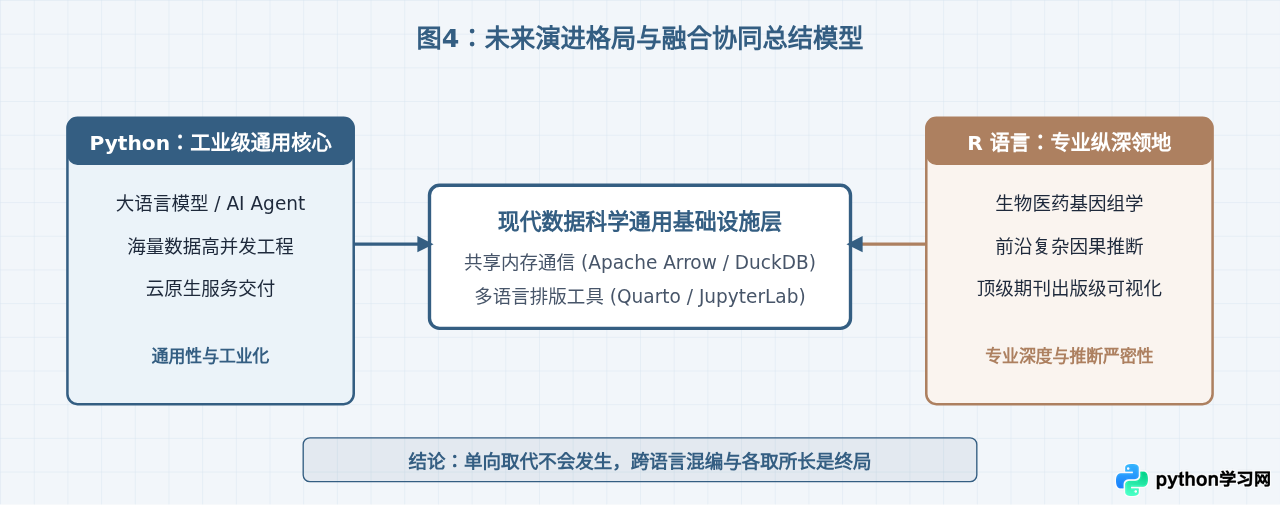
对个人学习与实际工作的建议是:以Python作为核心工程与通用分析骨架,按需在统计检验和高质量报告中引入R。不需要把两者对立起来,掌握两者各自的边界与协同方法,能够让数据工作的效率和严谨性同时达到最佳状态。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















