


Python怎么利用enumerate和zip优化for循环遍历
深入解析如何在Python中利用enumerate和zip内置函数优化for循环遍历,告别冗余计数与多重下标索引,提升代码可读性与运行性能。
编写 Python 循环时,通过下标访问列表或在循环外部手动维护递增计数器是典型的低效写法。使用内置的 enumerate() 与 zip() 函数,能够消除对 range(len(...)) 索引的依赖,将多源数据的对齐与索引追踪转化为原生的迭代器解构,不仅使代码逻辑清晰紧凑,还能有效避免下标越界和多余的索引开销。
传统索引遍历的痛点与重构诉求
在 C 或 Java 风格的早期编程习惯中,遍历通常围绕“下标”展开。当开发者需要同时获取列表中的元素及其所在位置时,常见的方式是先求取容器长度,再通过 range() 生成整型序列进行切片访问;或者在循环体外初始化一个整型变量,在每一轮迭代结束时手动加一。
# 传统方式一:使用 range(len(...))
items = ['任务A', '任务B', '任务C']
for i in range(len(items)):
    print(f"序号 {i}: {items[i]}")

# 传统方式二:手动维护外部变量
index = 0
for item in items:
    print(f"序号 {index}: {item}")
    index += 1
这两种写法存在明确的维护隐患:前者充斥着 items[i] 形式的索引寻址,降低了代码可读性;后者一旦在循环内部出现 continue 或发生异常跳转,外部变量 index 的自增逻辑极易遗漏,从而引发数据错位。为了从机制上彻底解耦下标维护与业务操作,Python 提供了 enumerate() 函数。
利用 enumerate 消除外部计数器
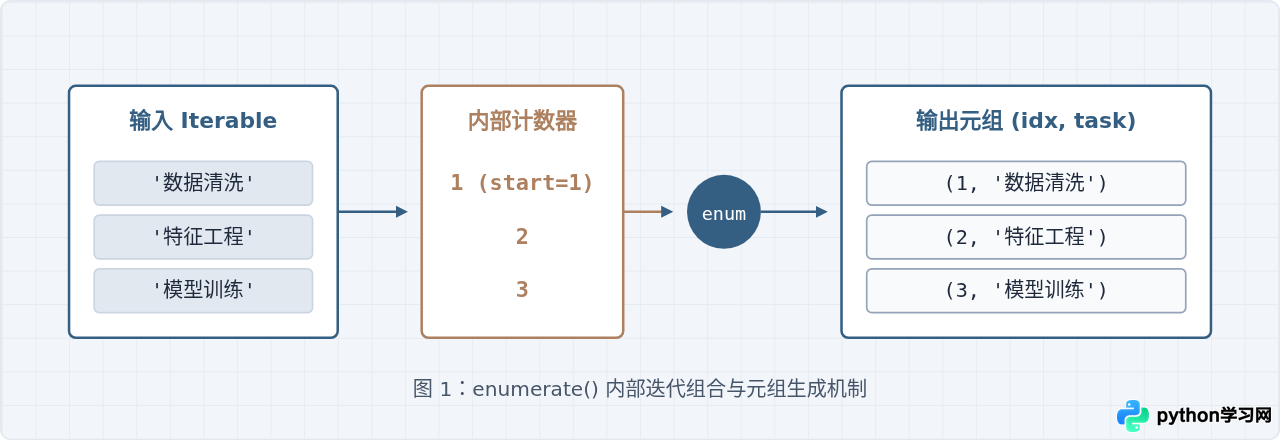
enumerate(iterable, start=0) 接收一个可迭代对象,并返回一个枚举迭代器。在每一次迭代中,它会产生一个包含计数值和当前元素的二元元组 (index, item)。结合 Python 的元组拆包机制,可以在 for 语句声明时直接捕获这两个变量。
tasks = ['数据清洗', '特征工程', '模型训练']

# 利用 enumerate 优化后的循环
for idx, task in enumerate(tasks, start=1):
    print(f"步骤 {idx}: {task}")
start 参数允许指定计数的起始基数。在日志输出、用户交互或命令行输出等场景中,往往需要从 1 开始计数,直接传入 start=1 即可规避在循环内部书写 idx + 1 的重复计算。
利用 zip 实现多序列并行同步遍历
当遇到需要同时遍历两个或更多序列并处理对应位置的数据时,使用传统的下标索引会使代码充斥着多维取值操作,极难维护。
names = ['Alice', 'Bob', 'Charlie']
scores = [85, 92, 78]
departments = ['研发', '市场', '运维']

# 不推荐:通过 range(len(...)) 依次通过下标寻址
for i in range(len(names)):
    print(f"{names[i]} | {scores[i]} | {departments[i]}")
zip(*iterables) 将多个可迭代对象作为输入,把对应位置的元素聚合成元组。它也是惰性求值的迭代器,不会在内存中创建完整的组合大列表,在大数据量下内存表现稳定。
# 优化后:直接解构多序列对应项
for name, score, dept in zip(names, scores, departments):
    print(f"{name} | {score} | {dept}")
长度不一时的数据对齐策略
使用 zip() 时必须关注各序列长度一致性问题。默认情况下,zip() 遵循“短板截断”原则:一旦最短的序列被耗尽,整个迭代即刻停止。如果在业务场景中不允许丢弃长列表后半段的数据,应使用标准库 itertools.zip_longest(),并显式指定 fillvalue 参数进行缺项填充。
from itertools import zip_longest

keys = ['ID', 'IP', 'Port', 'Protocol']
values = [1001, '192.168.1.1', 8080]

# 默认截断:只会产出 3 组数据,'Protocol' 被丢弃
# 优化填充:缺项补 None 或指定默认值
for k, v in zip_longest(keys, values, fillvalue='未配置'):
    print(f"{k}: {v}")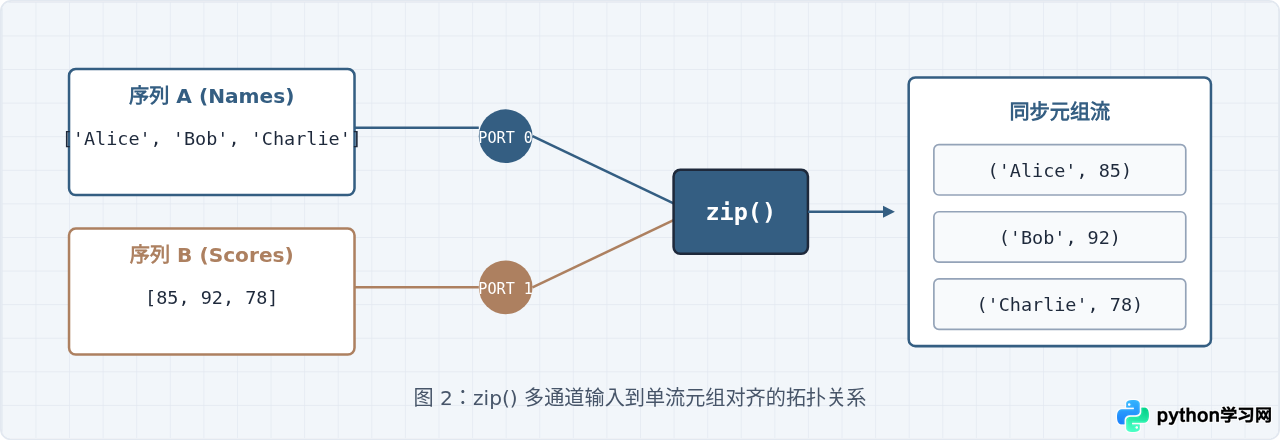
进阶组合:enumerate 与 zip 嵌套联动
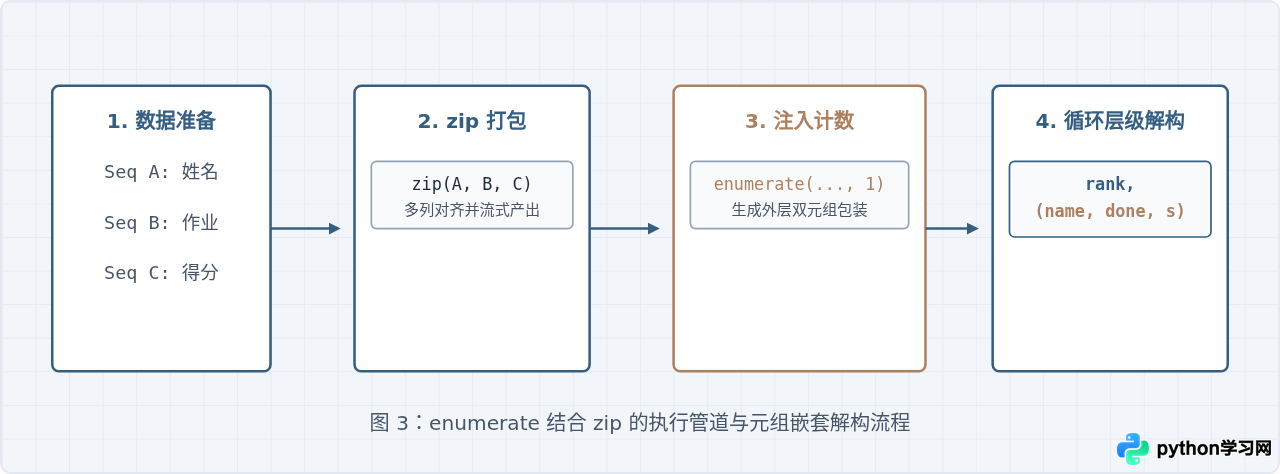
当遇到“既要并行消费多个序列,又要同时记录当前处理步骤”的复杂业务场景时,可以将 enumerate() 与 zip() 嵌套使用。此时核心考量在于解构的层级括号匹配。
students = ['张三', '李四', '王五']
homework_done = [True, False, True]
quiz_scores = [90, 60, 85]

# 组合遍历:enumerate 包装 zip
for rank, (name, done, score) in enumerate(zip(students, homework_done, quiz_scores), start=1):
    status = "已交" if done else "未交"
print(f"名次 {rank}: 学生={name}, 作业={status}, 测验分={score}")for rank, (name, done, score) in ... 中,(name, done, score) 外围的圆括号必不可少。因为 enumerate() 的输出结构永远是 (索引, 元素),在此处“元素”本身就是 zip() 生成的三元元组。如果不加圆括号,Python 将抛出 ValueError: not enough values to unpack 异常。
性能考量与使用禁区
为了在开发中做出准确的技术选型,需要明确 enumerate 与 zip 的运行时特征以及适用边界:
| 场景需求 | 推荐写法 | 替代方案与注意事项 |
|---|---|---|
| 单一序列 + 下标追踪 | enumerate(seq) |
避免手写 count += 1;支持自定义 start |
| 多序列等长对齐 | zip(seq1, seq2) |
当长度不一时默认截断,需要短板保护 |
| 多序列非等长对齐 | itertools.zip_longest() |
必须传入 fillvalue 明确缺项填充语义 |
| 原列表原地修改 | 不建议在两者的循环中修改原列表 | 修改正在迭代的容器会导致跳项或指针错位,应采用列表推导式生成新对象 |
常见误区:遍历中修改容器
enumerate() 与 zip() 都依赖底层序列的迭代协议。如果在迭代过程中向原列表执行 append() 或 pop(),迭代器的内部偏移指针不会随之调整,从而导致不可预期的漏读或重复读。如果必须更新元素,可以通过下标回写原列表,但更推荐的做法是使用列表推导式重新生成新的数据结构。
选型总结与演进全景
从直接下标索引迁移到 enumerate 和 zip,是写出地道(Pythonic)代码的关键一步。以下决策树可作为日常编码时的模式判断基准:
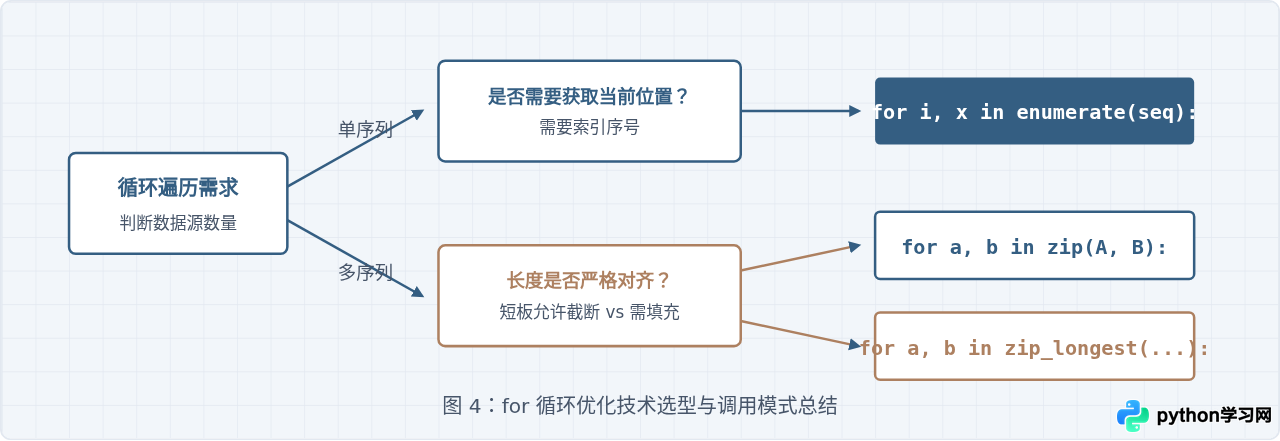
归纳而言,当需要在单序列中同步获知元素与位置时,选用 enumerate;当需要同步消费多个序列时,选用 zip;当两者交织时,使用括号正确嵌套解构。遵循这一范式,可以免去所有繁冗的手动下标与边界计算,使代码兼具良好的运行性能与自解释性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















