


Python在人工智能与机器学习中的应用:为什么它是AI开发首选语言
深入解析Python在人工智能与机器学习中的核心应用场景,剖析其凭借胶水语言架构、统一科学计算基座与深度学习生态霸权成为AI首选开发语言的底层原理与工程实践。
设想一个典型的工业级算法研发任务:工程师需要为在线系统构建一套高维点击率预估模型。任务不仅要从数据湖中抽取千万条样本、执行特征编码与矩阵变换,还需在两周内快速验证逻辑回归、梯度提升决策树(GBDT)以及深度残差网络等不同算法,并最终导出低延迟推理服务。若采用 C++ 等静态语言,团队大量时间将耗费在显式内存管理、类型映射和样板代码中;若采用 R 等统计脚本,又难以无缝衔接现代大规模 GPU 并行加速与生产微服务集群。
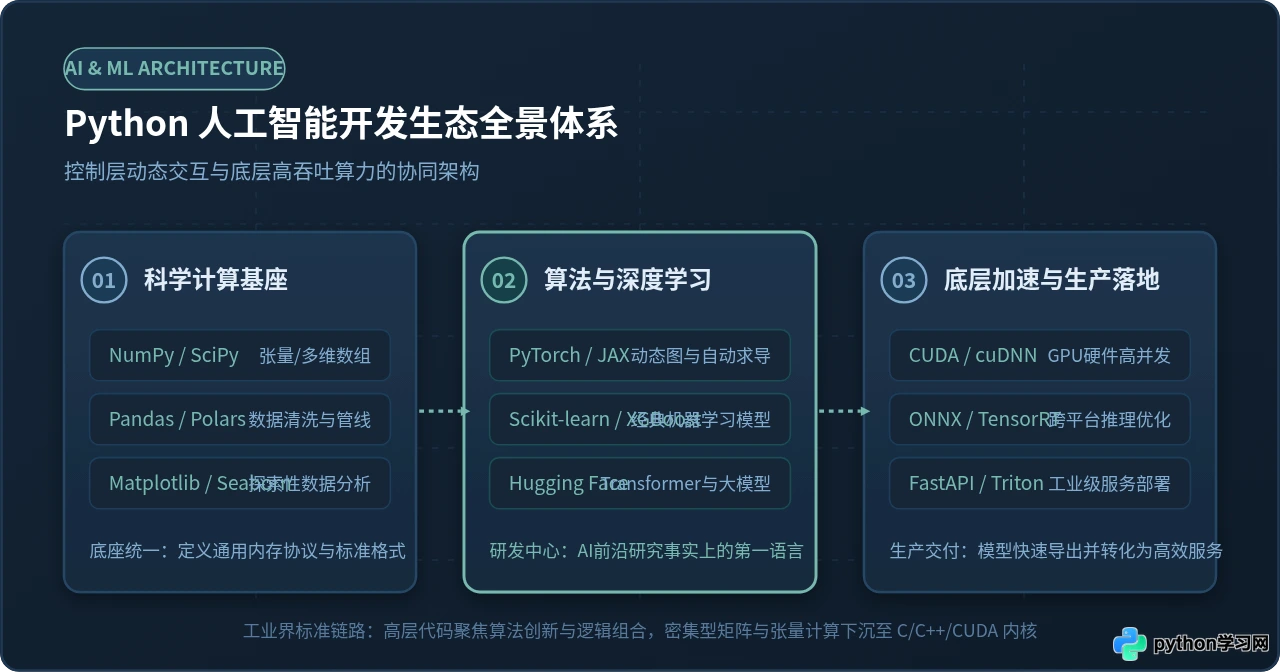
核心结论:Python 成为人工智能与机器学习领域无可争议的首选语言,其根本原因不在于 Python 解释器本身的运行速度,而在于其“高层极简胶水语法 + 底层高性能 C/C++/CUDA 算力内核”的双层解耦架构。它消除了算法研发的高昂试错成本,并由 NumPy、Pandas、Scikit-learn、PyTorch 构筑了跨越“数据清洗、模型训练到推理部署”的全生命周期标准生态。
一、胶水语言架构:Python如何解决“开发效率”与“计算性能”的矛盾
初次接触 AI 开发的工程师常有一个直观疑问:Python 作为一门动态解释型语言,存在全局解释器锁(GIL)和动态对象开销,单线程运行速度远落后于 C/C++ 或 Rust,为何却能承载需要极致算力的人工智能训练任务?
答案隐藏在现代 AI 系统的架构分层中。在人工智能的运算过程中,核心计算通常表现为密集型线性代数运算(例如通用矩阵乘法 GEMM、高维张量卷积与多头注意力机制),这类操作往往占据整个模型执行时间的 95% 以上;而模型结构的定义、超参数调整、训练循环调度及损失函数的求值控制,仅占总计算时间的极小比例。
Python 在这一格局中扮演了极为精确的角色——控制平面的编排者与胶水粘合剂。开发者编写的 Python 代码并不直接执行底层的密集浮点运算,而是通过轻量级的 API 调用,将计算任务打包传递给底层的高度优化内核:
- 顶层用户空间(Python):负责逻辑组装、模型结构定义、数据加载批处理以及交互式探索,语法极简且容错率高。
- 中间桥接与协议层(C-API / DLPack):利用 Python C-API、PyBind11 以及 Python Buffer Protocol 规范,直接传递连续物理内存地址指针,实现跨语言运行时的零拷贝数据共享。
- 底层执行平面(C/C++ & CUDA):运算下沉至 OpenBLAS、Intel MKL 等高度向量化 CPU 库,或直接由 NVIDIA CUDA、cuDNN 内核驱动数万个 GPU 算力单元并行运算,并在计算执行期间主动释放 GIL。
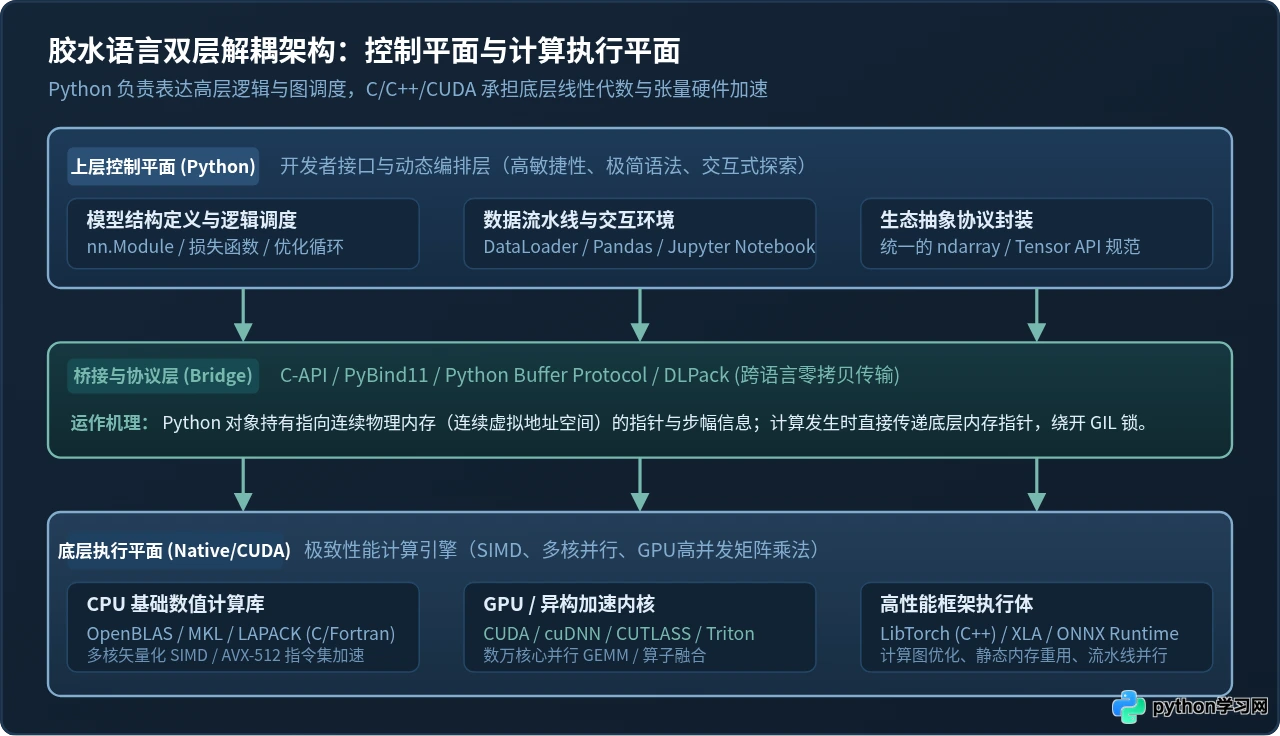
这种双层架构使算法工程师既获得了类似写数学公式般的研发自由度,又享受了硬件底层的原生算力吞吐。相比要求研究员同时精通 CUDA 内存对齐、模板元编程和线程块调优的传统开发方式,Python 将技术门槛大幅降低,使得整个学术界和工业界能够将精力完全聚焦在算法创新本身。
二、从数据准备到推理交付:端到端AI工作流中的Python应用
Python 之所以无法被轻易取代,更深层次的原因是它覆盖了机器学习工程从最初的数据摄取到最终模型上线的每一个关键节点,不存在生态断层。其他语言往往只能解决工作流中的某一单点,而 Python 则构筑了一条完整通畅的数字化管道。
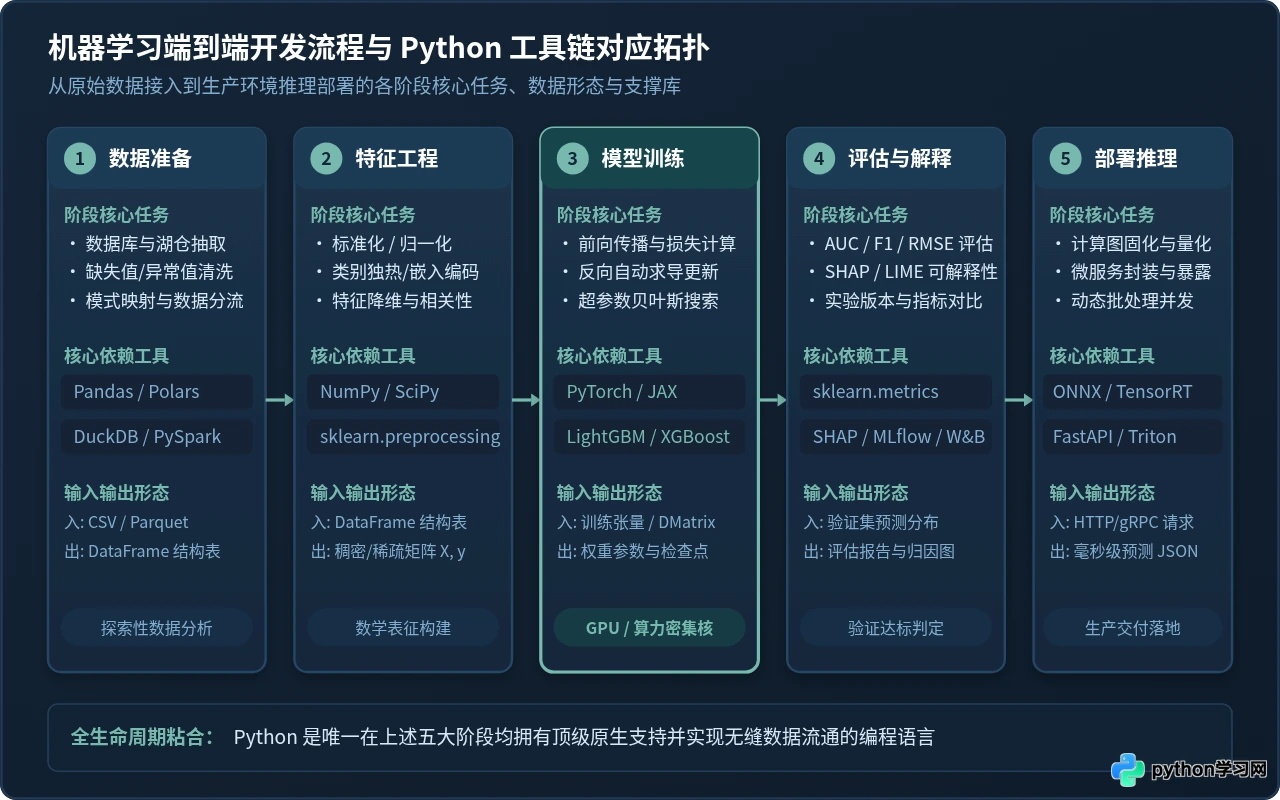
1. 全流程支撑工具链细分
- 数据准备与清洗阶段:通过
Pandas、Polars与DuckDB,工程师能够用极具表现力的向量化语法完成 TB 级数据切片、缺失值填补与时间序列对齐。 - 特征工程与矩阵化阶段:
NumPy提供了底座级别的 N 维数组容器,与SciPy的稀疏矩阵算法配合,将非结构化业务数据映射为几何空间中的密集张量。 - 模型训练与自动调优阶段:经典表格式数据由
LightGBM、XGBoost与Scikit-learn高效拟合;复杂感知、多模态与大语言模型则交由PyTorch或JAX进行基于自动微分(Autograd)的动态梯度反向传播。 - 模型评估与可解释性阶段:利用
Scikit-learn.metrics计算混淆矩阵、ROC-AUC 与 PR 曲线,并通过SHAP(Shapley Additive exPlanations)基于博弈论对特征重要性进行归因分析。 - 模型导出与生产推理阶段:模型通过
ONNX格式固化计算图,结合TensorRT进行算子融合与 FP16/INT8 量化,最终通过FastAPI或 NVIDIA Triton 推理服务器对外部业务暴露高并发服务。
2. 典型端到端可执行实践示例
为具体展示 Python 在机器学习工程中的实际运用,以下提供一个完整可执行的工业分类流程脚本。该示例在单文件内涵盖了虚拟数据构造、特征标准化、逻辑回归训练、准确率验证及模型权重持久化:
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, classification_report
import joblib

# 步骤 1:构建模拟高维分类数据集(1000个样本,20个输入特征)
X, y = make_classification(
    n_samples=1000,
    n_features=20,
    n_informative=15,
    n_redundant=5,
    random_state=42
)

# 步骤 2:数据集切分(80% 训练集,20% 验证集)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.20, random_state=42, stratify=y
)

# 步骤 3:特征归一化工程(基于训练集统计量转换测试集,防止数据泄露)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 步骤 4:模型实例化与训练收敛
classifier = LogisticRegression(solver='lbfgs', max_iter=200, random_state=42)
classifier.fit(X_train_scaled, y_train)

# 步骤 5:验证集预测与评估指标计算
y_pred = classifier.predict(X_test_scaled)
acc = accuracy_score(y_test, y_pred)
print(f"验证集分类准确率 (Accuracy): {acc:.4f}")
print("
分类指标详细报告:")
print(classification_report(y_test, y_pred, digits=4))

# 步骤 6:模型与预处理器管线持久化导出
joblib.dump({'scaler': scaler, 'model': classifier}, "model_checkpoint.joblib")
print("模型检查点已成功序列化保存为 model_checkpoint.joblib")
在上述步骤 3 中,必须严格使用 scaler.fit_transform(X_train) 计算训练集均值与方差,而对测试集仅执行 scaler.transform(X_test)。如果对全量数据集统一调用 fit_transform,会导致测试集分布信息泄露到训练流程中,造成模型泛化能力评估虚高。
三、主流开发语言多维对比:为什么不是 C++、Java 或 R?
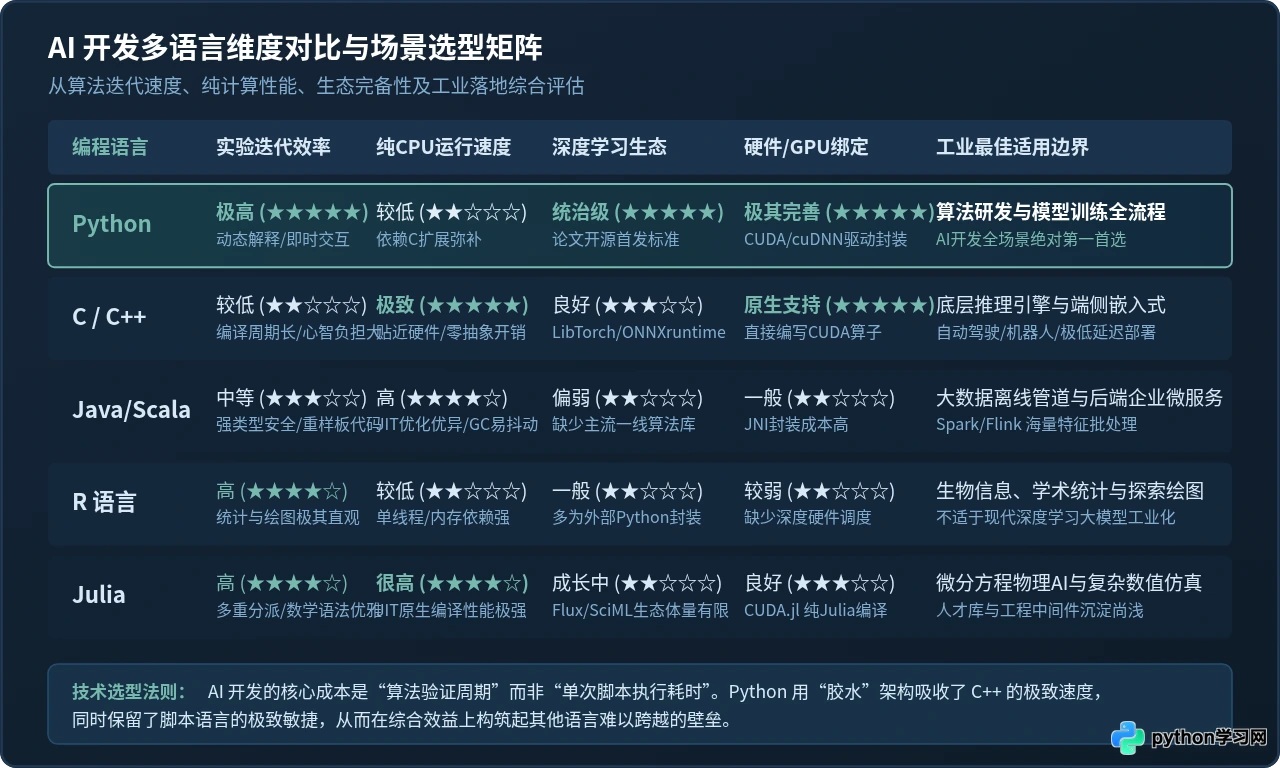
在计算机科学史上,并不缺乏在纯执行性能或数学表达上极具特色的语言。为何在人工智能的大规模竞争中,最终胜出的是 Python?通过与几种典型语言进行横向对照,可以清晰看清技术选型的本质边界:
1. 关键差异与选型依据
- 对比 C / C++: C/C++ 拥有无可匹敌的纯计算速度与硬件底层把控力,是所有主流深度学习框架(LibTorch、ONNX Runtime、TensorRT)底层的共同宿主。然而,C++ 缺乏灵活的动态交互式解释环境(如 Jupyter),类型系统严格,内存指针与头文件依赖复杂。在探索性极强的算法试验期,使用 C++ 验证假设的迭代周期往往是 Python 的数倍以上。因此,工业界形成了“Python 探索训练 + C++ 嵌入式部署”的标准分工。
- 对比 Java / Scala: Java 与 Scala 凭借健壮的静态类型和 JVM 垃圾回收机制,统治了大数据离线计算(Hadoop、Spark、Flink)与微服务架构。但在 AI 核心领域,JVM 缺乏直接对接 GPU 原生张量计算的标准抽象,JNI 交互损耗较大,且缺乏类似 PyTorch 的统一前沿生态支持。算法团队通常更倾向于使用 Python 进行算法开发,通过接口或消息总线与 Java 后端交互。
-
对比 R 语言:
R 是统计学与生物医学领域的利器,其内置的向量操作与
ggplot2绘图语法极其优美。然而,R 在非结构化深度学习(计算机视觉、NLP、大模型分布式训练)和高性能工程系统构建上较为羸弱,工业微服务部署路径长,逐渐退守至统计建模与学术报告领域。 - 对比 Julia: Julia 凭借多重分派(Multiple Dispatch)和高效的 LLVM 即时编译(JIT),完美解决了“高层脚本灵活度”与“底层 C 语言运行速度”共存的双语言难题(Two-Language Problem)。然而,Julia 诞生时 Python 的科学计算飞轮早已加速运转,其现阶段在工业级生产中间件、模型预训练权重库(如 Hugging Face Hub)及开发者基数上尚不足以撬动 Python 的先发网络优势。
四、面对现实限制:Python在现代AI中的边界与应对策略
任何工程语言都有其客观限制。在追求高并发、低延迟或海量特征计算时,Python 存在若干典型痛点,掌握这些痛点的边界及规避方案是成熟算法开发者的必备素养。
| 固有局限 | 底层原因表现 | 工程影响场景 | 推荐应对策略 |
|---|---|---|---|
| 全局解释器锁 (GIL) | CPython 内部机制,同一时刻仅允许一个线程执行字节码 | 多线程 CPU 密集计算(如纯 Python 循环预处理海量图像)无法利用多核 |
1. 计算下沉至 C 扩展(NumPy/Torch 计算自动释放 GIL) 2. 使用 multiprocessing 或 concurrent.futures 多进程3. 采用分布式调度框架(如 Ray、Dask) |
| 动态类型的隐式错误 | 运行时确定变量类型,缺乏编译期静态类型检查 | 数据管道长、张量维度变化多,维度不匹配在运行数小时后才崩溃 |
1. 全面采用 Python typing 提示与 mypy 静态校验2. 深度学习模型输入前强制进行 assert tensor.shape == (...) 校验3. 微服务层使用 Pydantic 进行强数据校验
|
| 内存膨胀与GC抖动 | Python 纯对象包装器开销大,垃圾回收引发停顿 | 处理数十 GB 级别结构化数据集时极易触发 OOM(内存溢出) |
1. 优先使用 NumPy 视图(View)与原地修改(inplace),避免隐式拷贝 2. 引入列式存储与零拷贝内存映射(Apache Arrow / Polars) 3. 采用迭代批处理生成器(Generators / DataLoader)流式读取 |
五、总结:Python 稳固 AI 首选地位的基石与认知建议
技术的发展历史证明,决定一门编程语言在特定领域垄断地位的,从来不是某项单一指标的极值,而是综合工程摩擦力的最小值。
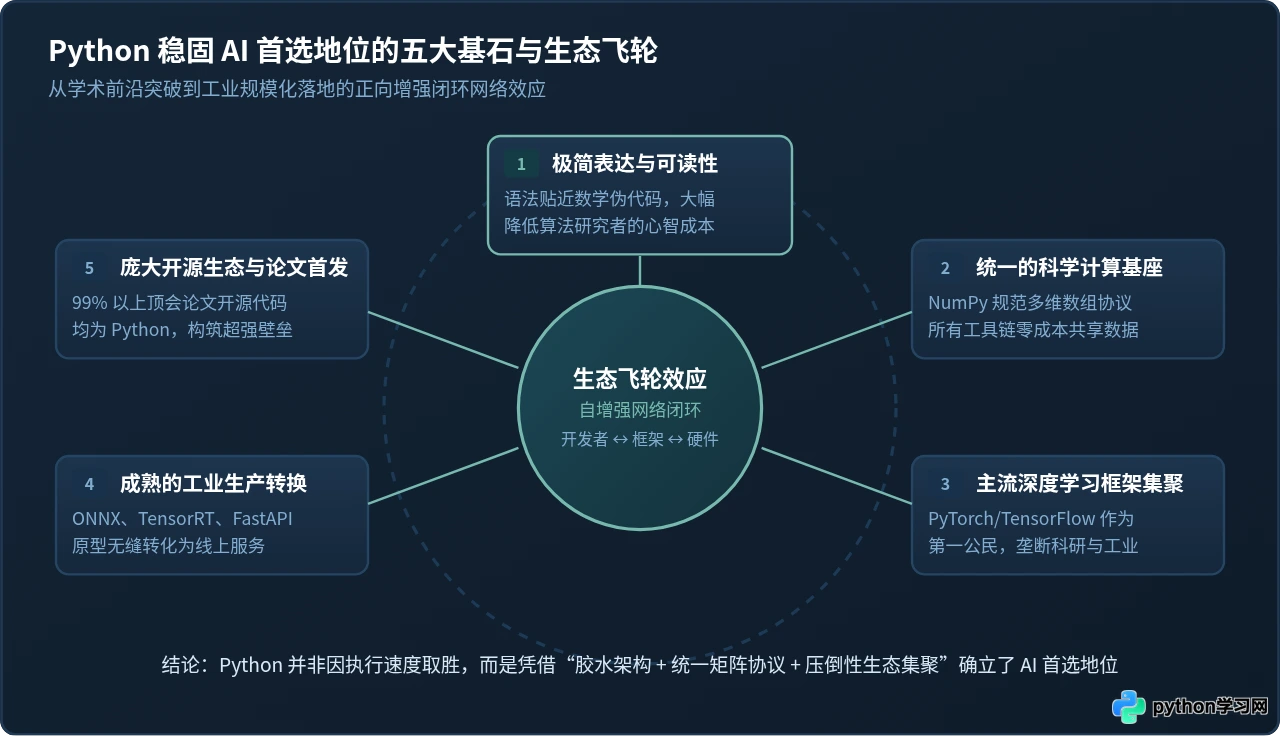
Python 在人工智能与机器学习中的核心优势可以总结为五大互为咬合的齿轮:
- 极简直观的语法表达:将代码语法对研究人员心智的消耗降至最低,让研究人员能够像推导数学公式一样编写算法。
- 统一的矩阵协议基座:从 NumPy 确立的
ndarray协议开始,所有库之间数据无缝流通,消除了跨工具链的序列化开销。 - 深度学习框架的集聚效应:PyTorch、TensorFlow、JAX 与 Hugging Face 均以 Python 为第一公民,几乎所有前沿论文的第一版开源实现均采用 Python。
- 全栈工程与落地生态:从 Jupyter 的快速原型设计,到 ONNX、TensorRT 的工业推理与 FastAPI 容器化服务,形成了从实验室到生产环境的平滑闭环。
- 自增强的开发者飞轮:庞大的开发者群体吸引了硬件厂商(如 NVIDIA、Google TPU、Intel)第一时间为 Python 适配最完善的底层驱动支持,进一步巩固了其不可撼动的生态壁垒。
对于初学者与工程开发者而言,掌握 Python 在人工智能中的应用,核心不在于去背诵枯燥的语法细节,而在于深入理解“高层动态编排与底层硬件加速的分工逻辑”,熟练运用 NumPy、Pandas 和 PyTorch 等核心工具链组织张量与数据流,并学会在面对高并发与极端延迟挑战时合理结合 C++、ONNX 等工具进行下沉优化,从而真正发挥 Python 这一现代 AI 第一语言的强大生产力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















