


提升Python自动化脚本稳定性:日志记录与异常处理最佳实践
深入讲解如何通过结构化日志记录、分层异常捕获、指数退避重试以及资源安全回收,全面提升无人值守Python自动化脚本的运行稳定性与故障排查效率。
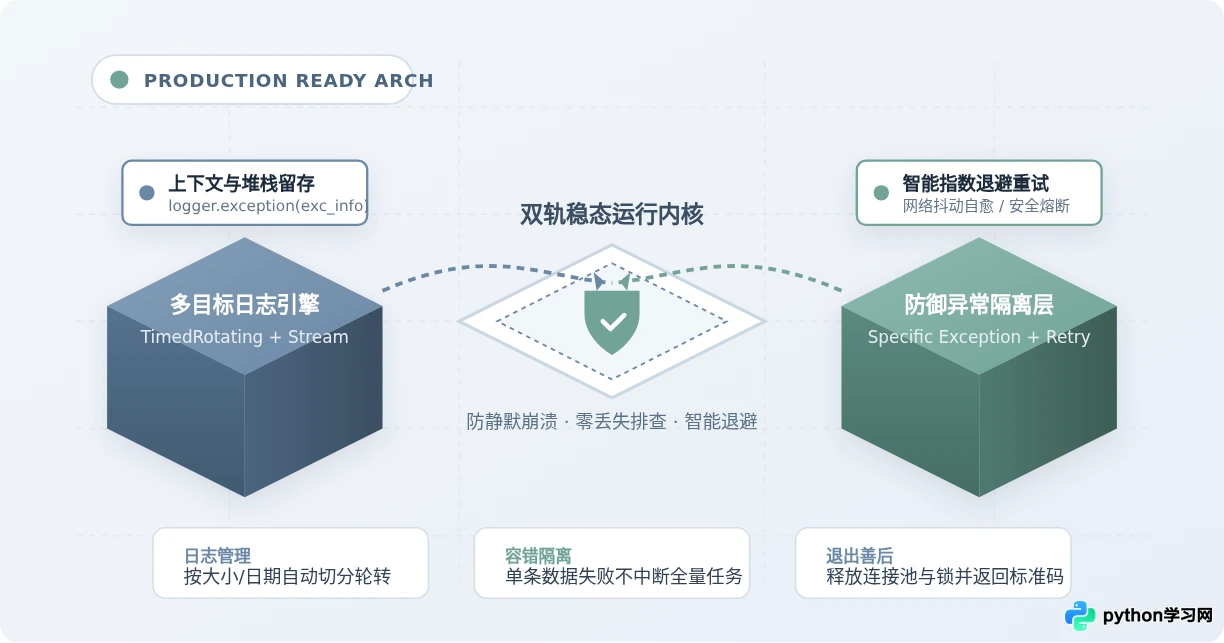
编写一个在本地终端运行一次成功的自动化脚本并不困难,但要让脚本在无人值守的服务器、定时任务(Cron)或后台守护进程中持续稳定运行数周甚至数月,核心关键在于建立“防御性异常隔离”与“结构化日志溯源”双轨机制。本文将直接从无人值守场景的核心痛点切入,提供一套开箱即用的分层异常处理模型、生产级多目标日志配置方案以及自动重试退避模板,帮助你彻底告别脚本静默崩溃与日志排查死局。
一、自动化脚本为何容易意外中断:核心痛点与稳定性目标
自动化脚本通常面临与交互式程序截然不同的运行环境。在无人值守的服务器或定时调度的作业中,脚本崩溃往往发生在凌晨或节假日。导致自动化脚本“夭折”的原因通常集中在以下三个典型维度:
- 瞬时外部抖动引发未捕获异常:网络请求临时丢包、三方 API 偶发 502/504、数据库连接因闲置超时关闭。一旦代码缺少细分捕获或重试机制,整个任务流水线直接暴毙。
- 隐蔽的“静默吞错”导致坏死数据蔓延:使用无差别的
except Exception: pass,表面上脚本没有报错退化,实际上业务数据早已中断写入,运维人员几天后才发现数据库颗粒无收。 - 依赖
print()输出导致排查无门:控制台输出在终端关闭或 Docker 容器销毁后荡然无存;缺乏统一的时间戳、代码行号、执行进程号和异常堆栈回溯,线上 Bug 复现变成无头公案。
因此,构建健壮自动化脚本的目标可以概括为八个字:“容错自愈、留存现场”。对于瞬时波动,系统应具备受控的退避重试能力;对于不可恢复的硬性错误,系统应隔离单点影响,记录结构化堆栈信息,并触发标准退出码。
二、架构设计:日志流转与分层异常防护体系
要保障脚本持续可靠,不能依靠零散的 try...except,而需要在脚本设计之初就确立双轨防护架构。该架构将运行机制划分为三层:任务执行层、容错控制层与日志存储层。
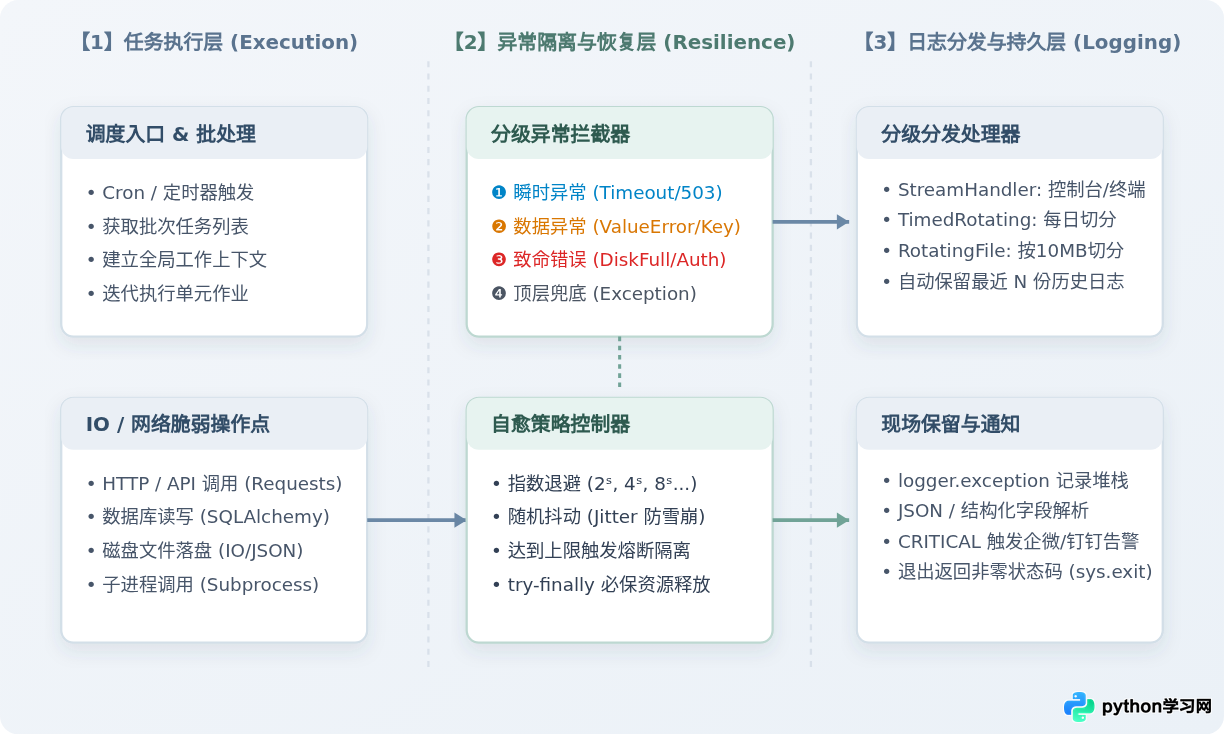
如图 1 所示,双轨架构的核心在于:异常处理负责业务流程的“分流与止损”,日志记录负责执行过程的“证据保全与复盘”。两个机制在自动化脚本中互为表里,缺一不可。
三、规范化日志实施:从 print 转向生产级 logging 体系
许多自动化脚本初学者习惯使用 print() 打印调试信息。但在生产环境或自动化运行场景中,print() 存在几个致命硬伤:
- 无法区分消息级别:正常的心跳消息与严重的数据库连接中断混杂在一起,无法通过配置动态过滤。
- 缺乏上下文元数据:缺少精确的时间戳(甚至毫秒)、所属函数名、代码行号和进程/线程 ID。
- 缺乏自动切分与存储管理:直接重定向到文本文件(如
python script.py >> run.log)会导致单个文件无限膨胀,最终写满服务器磁盘 inode 或存储空间。
1. 搭建标准双输出与轮转的 Logger 实例
生产级脚本应使用 Python 内置的 logging 模块,并组合 StreamHandler(输出到控制台供调试查看)与 RotatingFileHandler 或 TimedRotatingFileHandler(写入本地磁盘并定期按文件大小或天数归档)。以下是经过生产检验的标准初始化函数:
import logging
import os
import sys
from logging.handlers import RotatingFileHandler

def setup_production_logger(log_dir: str = "logs", app_name: str = "auto_task") -> logging.Logger:
    """
    配置并返回一个生产级双通道日志记录器。

    :param log_dir: 日志存储目录
    :param app_name: 应用标识,用作日志文件名前缀
    :return: 配置完成的 logging.Logger 实例
    """
    os.makedirs(log_dir, exist_ok=True)
    log_file_path = os.path.join(log_dir, f"{app_name}.log")

    logger = logging.getLogger(app_name)
    logger.setLevel(logging.DEBUG)  # 根收集级别为 DEBUG,具体由各 Handler 过滤

    # 防止重复添加 Handler 导致日志多倍打印
    if logger.handlers:
        return logger

    # 1. 结构化格式器:包含时间、级别、进程、代码文件名及行号
    formatter = logging.Formatter(
        fmt="%(asctime)s [%(levelname)s] [PID:%(process)d] [%(filename)s:%(lineno)d - %(funcName)s]: %(message)s",
        datefmt="%Y-%m-%d %H:%M:%S"
    )

    # 2. 控制台 Handler (输出 INFO 及以上级别)
    console_handler = logging.StreamHandler(sys.stdout)
    console_handler.setLevel(logging.INFO)
    console_handler.setFormatter(formatter)
    logger.addHandler(console_handler)

    # 3. 文件轮转 Handler (单文件最大 10MB,自动保留最新 5 个历史备份)
    file_handler = RotatingFileHandler(
        filename=log_file_path,
        maxBytes=10 * 1024 * 1024,  # 10 MB
        backupCount=5,
        encoding="utf-8"
    )
    file_handler.setLevel(logging.DEBUG)  # 文件中记录详细的 DEBUG 轨迹
    file_handler.setFormatter(formatter)
    logger.addHandler(file_handler)

    return logger

# 初始化模块全局 logger
logger = setup_production_logger()
2026-11-01 02:15:31 [INFO] [PID:48921] [task_runner.py:85 - process_item]: 成功抓取条目 [ID: 1001],耗时: 124ms
logger.handlers 检查现有 Handler 数量。如果在循环或被多次导入的模块中重复调用 logger.addHandler(),会导致每一条日志被重复打印数次,迅速挤爆日志文件。
四、科学落地 4 步执行流:从异常捕获到上下文留存
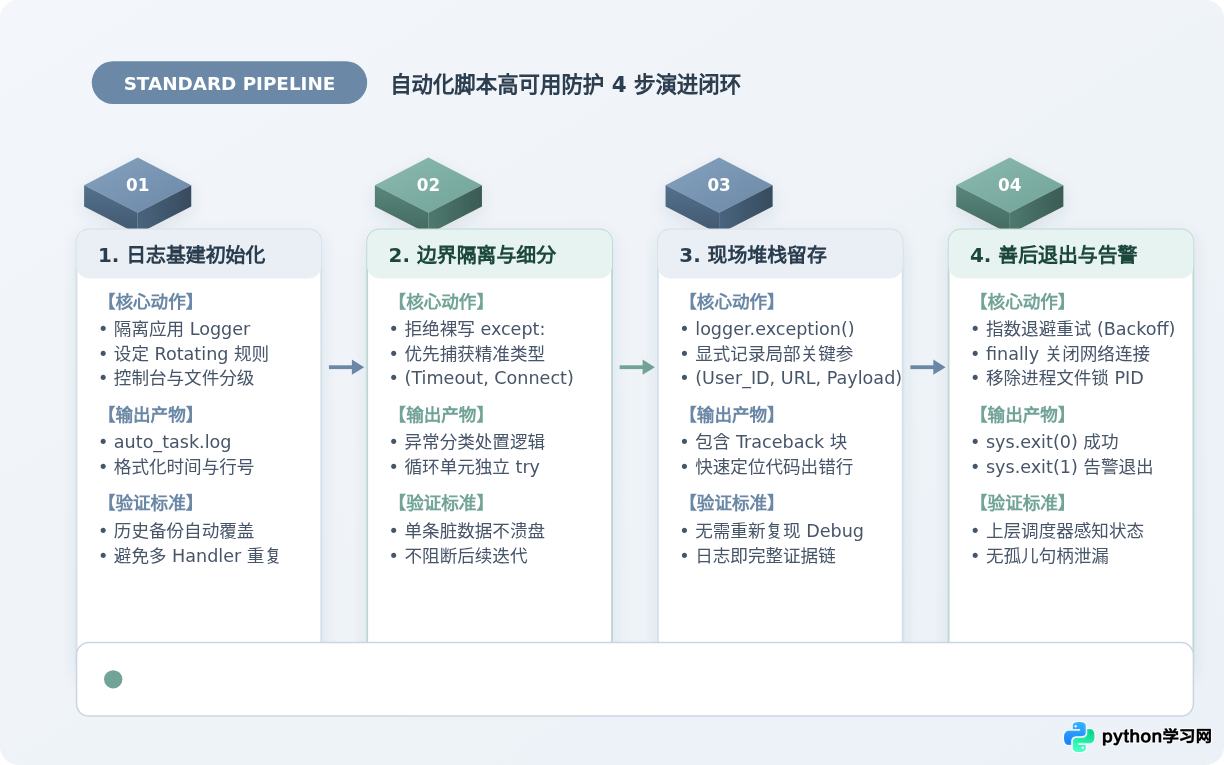
自动化脚本执行过程中,异常不应被视作“突发事故”,而应被视为“控制流的一部分”。为了让团队成员在发生故障时能在 3 分钟内准确定位原因,我们需要严格遵循如下 4 步落地执行流:
2. 正确保留现场:logger.exception() 与 exc_info
在捕获异常时,很多开发者喜欢写 logger.error(f"处理失败: {e}")。这种写法只打印了错误类型的简短描述(例如 处理失败: 'name'),却彻底丢弃了代码是在哪一行、被谁调用、调用栈上下文是什么等核心诊断信息。
正确的做法是在 except 块中使用 logger.exception(),或者在 logger.error() 中传入 exc_info=True。这会自动将 Python 完整的调用堆栈(Traceback)追加到日志中:
# ❌ 错误示范:丢失堆栈现场
try:
    data = fetch_remote_resource(task_id)
except Exception as e:
    logger.error(f"任务 {task_id} 失败: {e}")  # 日志仅显示: 任务 102 失败: 'items'

# ✅ 正确示范:记录关键上下文,并自动附加完整堆栈
try:
    data = fetch_remote_resource(task_id)
except KeyError:
    # 针对已知的格式问题,记录关键参数与字段说明
    logger.warning("响应数据中缺少预期字段 [items],任务参数: %s", {"task_id": task_id})
except Exception:
    # 针对未知的严重异常,完整保留现场
    logger.exception("处理远程资源时发生未预期崩溃,task_id=%s, 当前上下文=%s", task_id, {"retry_count": 2})
五、异常处理的精准控制:反模式与健壮模式深度对比
在自动化任务中,写得差的异常处理甚至比不写异常处理危害更大。不写异常处理至少会立刻崩溃报错,而错误的异常处理模式则会将错误粉饰太平。下文通过立体维度对比常见反模式与健壮模式的差异:
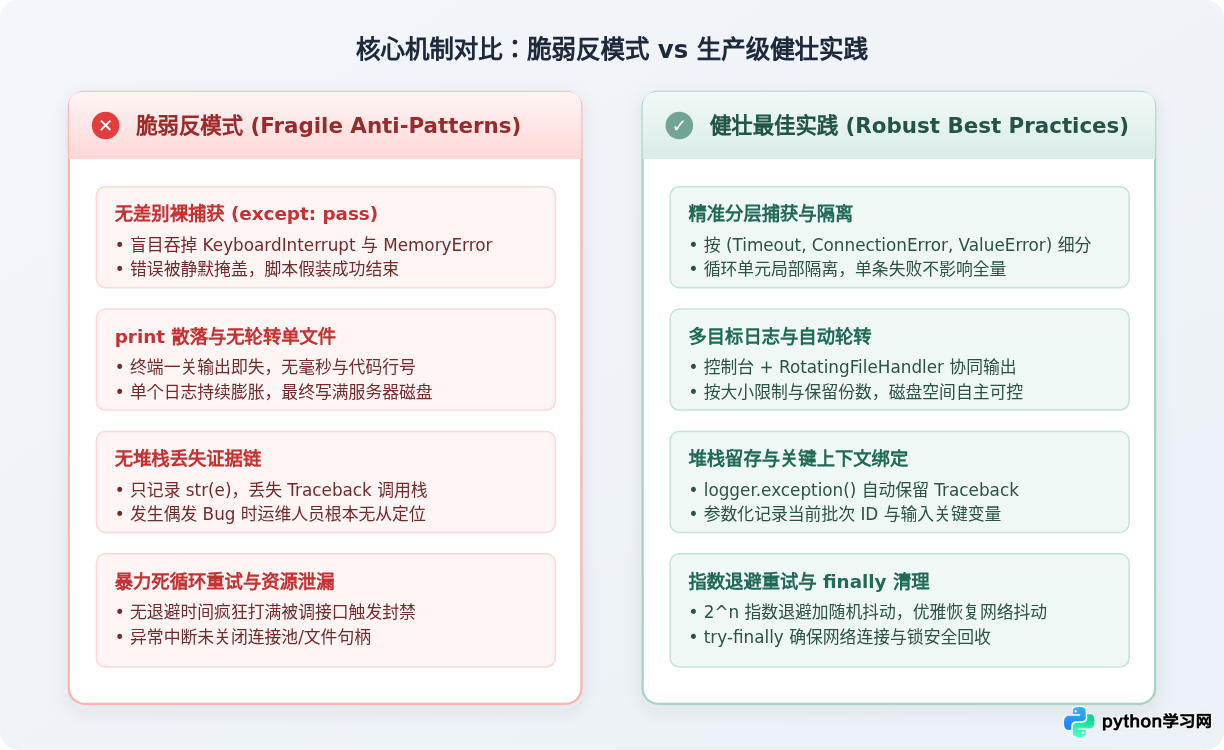
BaseException!Python 中的异常继承层级中,
BaseException 是所有异常的基类,包含了 KeyboardInterrupt(用户按下 Ctrl+C 终止)和 SystemExit(系统退出信号)。如果写了 except BaseException: 且吞掉了它,脚本将变成一个无法正常杀死的“僵尸进程”,甚至阻碍操作系统的正常重启。在绝大多数情况下,即使是兜底捕获,也只能捕获 Exception。
六、自动化特有场景实战:重试策略、优雅停机与完整工程模板
自动化脚本通常需要调用外部 HTTP 接口或抓取第三方服务。面对瞬时网络断流,直接退出任务代价过高;无脑死循环请求又会导致雪崩。最佳方案是实现带有指数退避(Exponential Backoff)与随机抖动(Jitter)的重试机制。
下面给出一个可以直接复用的自动化批处理任务脚手架,集成了配置化日志、指数退避装饰器、批处理单项隔离与优雅退出码管理:
import time
import random
import sys
import logging
from typing import Callable, Any, Optional
from logging.handlers import RotatingFileHandler

# 1. 生产环境日志配置
logger = logging.getLogger("batch_worker")
logger.setLevel(logging.DEBUG)

if not logger.handlers:
    formatter = logging.Formatter("%(asctime)s [%(levelname)s] [PID:%(process)d]: %(message)s")

    # 终端输出
    ch = logging.StreamHandler(sys.stdout)
    ch.setLevel(logging.INFO)
    ch.setFormatter(formatter)
    logger.addHandler(ch)

    # 磁盘文件轮转
    fh = RotatingFileHandler("batch_worker.log", maxBytes=5*1024*1024, backupCount=3, encoding="utf-8")
    fh.setLevel(logging.DEBUG)
    fh.setFormatter(formatter)
    logger.addHandler(fh)


# 2. 通用指数退避重试装饰器
def retry_with_backoff(
    retries: int = 3,
    initial_delay: float = 1.0,
    backoff_factor: float = 2.0,
    jitter: bool = True
) -> Callable:
    """
    通用网络操作指数退避重试装饰器。

    :param retries: 最大重试次数
    :param initial_delay: 首次重试等待基准秒数
    :param backoff_factor: 退避倍数
    :param jitter: 是否引入随机抖动避免同频率并发共振
    """
    def decorator(func: Callable) -> Callable:
        def wrapper(*args, **kwargs) -> Any:
            delay = initial_delay
            last_exception: Optional[Exception] = None

            for attempt in range(1, retries + 1):
                try:
                    return func(*args, **kwargs)
                except (ConnectionError, TimeoutError) as exc:
                    last_exception = exc
                    if attempt == retries:
                        logger.error(f"函数 [{func.__name__}] 达到最大重试上限 ({retries}次),执行熔断")
                        raise

                    sleep_time = delay + (random.uniform(0.1, 0.5) if jitter else 0.0)
                    logger.warning(
                        f"调用 [{func.__name__}] 发生网络波动: {exc},第 {attempt}/{retries} 次重试,等待 {sleep_time:.2f} 秒..."
                    )
                    time.sleep(sleep_time)
                    delay *= backoff_factor
                except Exception:
                    # 非网络瞬时波动(例如数据解析错误、权限不足),不盲目重试,直接抛出
                    logger.exception(f"调用 [{func.__name__}] 遇到不可重试的致命错误")
                    raise
            raise last_exception
        return wrapper
    return decorator


# 3. 模拟脆弱的外部网络请求
@retry_with_backoff(retries=3, initial_delay=1.0)
def fetch_api_record(record_id: int) -> dict:
    if record_id == 2:
        # 模拟瞬时网络超时
        raise TimeoutError("远程网关连接超时 (504 Gateway Timeout)")
    if record_id == 4:
        # 模拟返回非法数据
        raise ValueError("返回 Payload 损坏,缺少必要主键")
    return {"id": record_id, "status": "COMPLETED"}


# 4. 批任务核心处理流程(单项隔离模式)
def run_automation_job(record_ids: list) -> int:
    logger.info("====== 批处理任务流水线启动 ======")
    success_count = 0
    fail_count = 0

    try:
        for r_id in record_ids:
            logger.debug(f"正在处理记录: {r_id}")
            try:
                # 隔离单个记录的处理过程
                result = fetch_api_record(r_id)
                logger.info(f"记录 [{r_id}] 处理成功: {result['status']}")
                success_count += 1
            except ValueError as ve:
                fail_count += 1
                logger.error(f"记录 [{r_id}] 数据格式校验未通过,已跳过并记入死信队列: {ve}")
            except Exception:
                fail_count += 1
                # 记录详细 Traceback,但不中断整个循环
                logger.exception(f"记录 [{r_id}] 处理发生严重未捕获异常")

        logger.info(f"批处理完成。成功: {success_count} 项, 失败: {fail_count} 项")
        return 0 if fail_count == 0 else 2  # 0: 完全成功; 2: 部分失败

    except KeyboardInterrupt:
        logger.warning("收到操作人员终止信号 (Ctrl+C),正在紧急安全退出...")
        return 130
    finally:
        # 无论发生何种情况,必须确保释放资源
        logger.info("====== 正在执行清理工作:关闭连接池、释放文件锁 ======")


if __name__ == "__main__":
    records_to_process = [1, 2, 3, 4, 5]
    exit_code = run_automation_job(records_to_process)
    sys.exit(exit_code)
2026-11-01 02:20:10 [INFO] [PID:51204]: 记录 [1] 处理成功: COMPLETED
2026-11-01 02:20:10 [WARNING] [PID:51204]: 调用 [fetch_api_record] 发生网络波动: 远程网关连接超时 (504 Gateway Timeout),第 1/3 次重试,等待 1.34 秒...
2026-11-01 02:20:11 [WARNING] [PID:51204]: 调用 [fetch_api_record] 发生网络波动: 远程网关连接超时 (504 Gateway Timeout),第 2/3 次重试,等待 2.41 秒...
2026-11-01 02:20:14 [ERROR] [PID:51204]: 函数 [fetch_api_record] 达到最大重试上限 (3次),执行熔断
2026-11-01 02:20:14 [ERROR] [PID:51204]: 记录 [2] 处理发生严重未捕获异常
Traceback (most recent call last):
File "auto_job.py", line 82, in run_automation_job
result = fetch_api_record(r_id)
TimeoutError: 远程网关连接超时 (504 Gateway Timeout)
2026-11-01 02:20:14 [INFO] [PID:51204]: 记录 [3] 处理成功: COMPLETED
2026-11-01 02:20:14 [ERROR] [PID:51204]: 记录 [4] 数据格式校验未通过,已跳过并记入死信队列: 返回 Payload 损坏,缺少必要主键
2026-11-01 02:20:14 [INFO] [PID:51204]: 记录 [5] 处理成功: COMPLETED
2026-11-01 02:20:14 [INFO] [PID:51204]: 批处理完成。成功: 3 项, 失败: 2 项
2026-11-01 02:20:14 [INFO] [PID:51204]: ====== 正在执行清理工作:关闭连接池、释放文件锁 ======
通过这段输出可以清晰看到:记录 2 虽然触发了 3 次重试并最终超时熔断,但并没有导致整个批处理直接暴毙;后续的记录 3 与记录 5 依然被正常消费入库。这就是单项防护隔离在自动化场景下的巨大价值。
七、稳定性保障决策全景与自查清单
在实际工程中,不同性质的异常需要采取差异化的响应策略。不能一概重试,也不能一概退出。下方的决策全景图梳理了常见故障的应对分级逻辑:
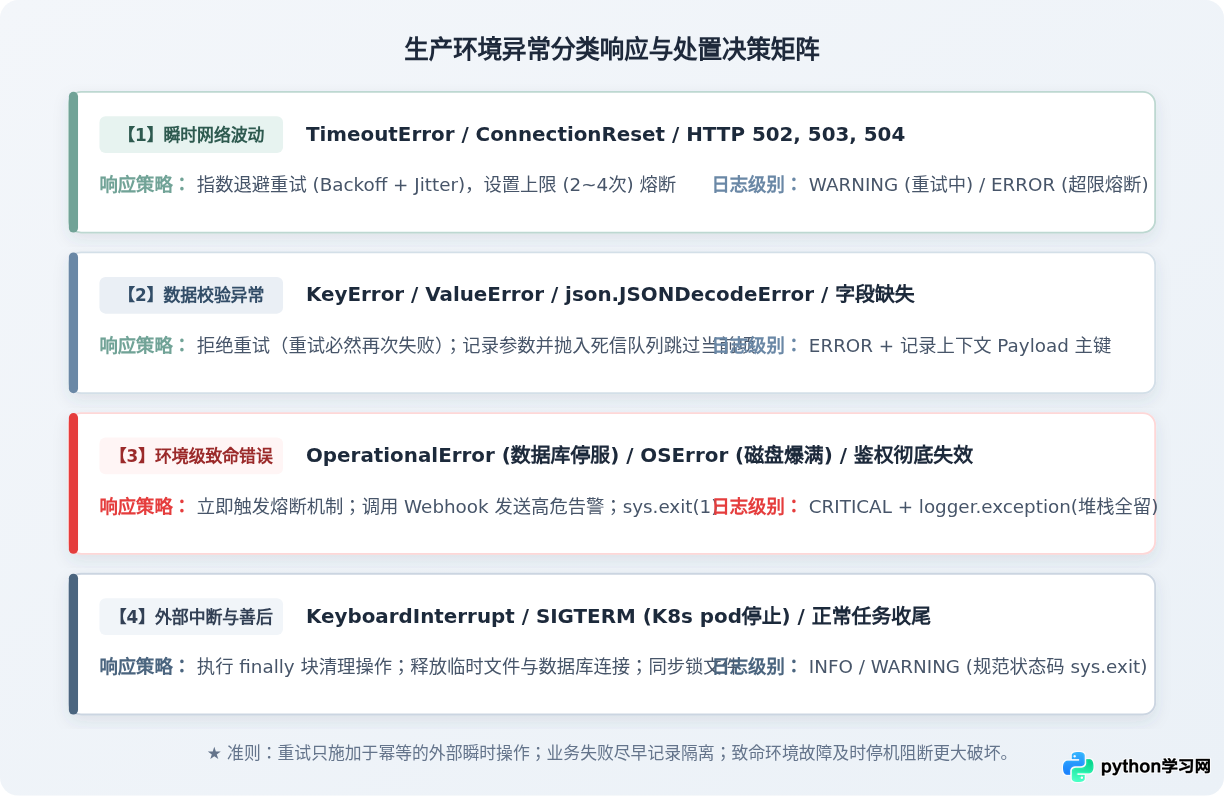
自动化脚本生产交付自查清单
| 自查检查点 | 标准要求 | 常见疏忽原因 | 评级 |
|---|---|---|---|
| 日志文件轮转 | 使用 RotatingFileHandler 限制大小与份数 |
使用普通的 logging.FileHandler,数月后单文件数十 GB 撑爆硬盘 |
必备 |
| 堆栈完整性 | 在 except 块中使用 logger.exception() |
只记录 logger.error(str(e)),排查时无法定位报错行号 |
必备 |
| 避免裸写 except | 指定具体异常类,兜底使用 except Exception: |
使用裸写 except: pass 导致 Ctrl+C 无法杀死脚本 |
致命禁忌 |
| 循环单元隔离 | 在批量处理的内部循环体内放置 try...except |
将 try 套在 for 循环外层,导致第 1 个错误就让剩下 999 条全部丢弃 |
必备 |
| 网络退避与抖动 | 重试间隔呈指数增长,并添加微量随机 Jitter | 固定延时死循环重试,加剧对端服务端压力并导致 IP 封禁 | 强烈推荐 |
| 返回规范退出码 | 成功返回 sys.exit(0),故障返回非零值 |
发生致命错误时默认以状态码 0 退出,Cron/Airflow 监控误报“任务成功” | 必备 |
提升 Python 自动化脚本稳定性的过程,实质上是把对外部环境的“侥幸假设”转变为代码层面的“主动防御”。通过配置科学的分级日志轮转、建立精细化的异常分流隔离与指数退避重试,你的自动化脚本将真正具备在无人值守环境下自愈与自证的能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















