


Python爬虫数据持久化:解析HTML/JSON并保存为CSV或Excel的代码
详解Python爬虫数据持久化全流程:通过BeautifulSoup解析HTML、解析结构化JSON数据,并使用csv内置模块与pandas导出为CSV和Excel文件的完整代码及避坑技巧。
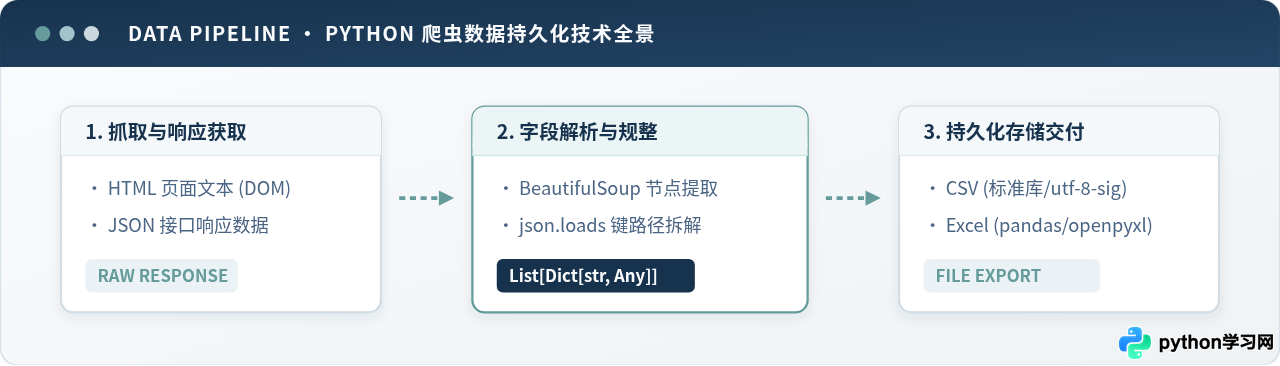
csv 模块与 pandas 库演示保存为 CSV 和 Excel 文件的标准写法,重点解决 Windows Excel 中文乱码、多余空行及长数字精度丢失等实际问题。
一、爬虫数据持久化链路与数据流转设计
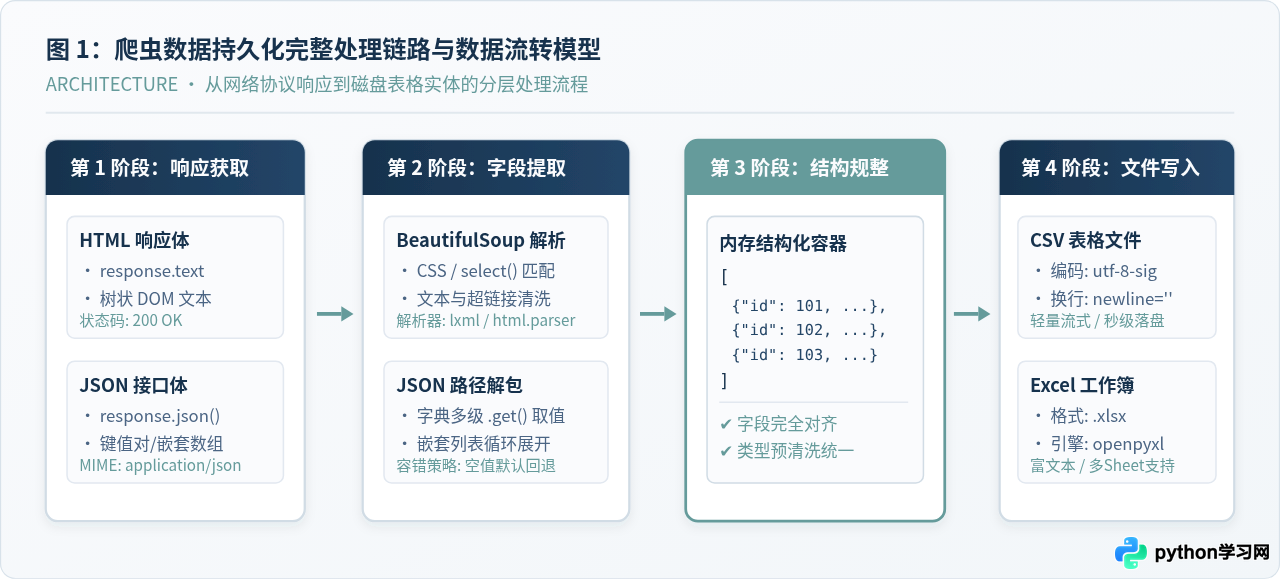
在编写数据持久化代码时,建立清晰的数据流转模型能够有效避免代码混乱。无论爬取的目标是 HTML 静态页面还是 Ajax 返回的 JSON 数据,整个处理流程通常划分为四个明确的阶段:响应获取 → 字段提取 → 内存结构规整 → 文件写入。
在数据流转过程中,推荐将内存中的中间形态统一规整为字典列表(即 List[Dict[str, Any]])。无论上游采用 BeautifulSoup 解析 DOM 树还是通过字典键路径解析 JSON,每一条数据记录都应该以相同的键名存入字典中。这样做的好处是使解析模块与存储模块完全解耦:后续无论是调用轻量级的内置 csv.DictWriter 逐行落盘,还是加载进 pandas.DataFrame 导出为 Excel 工作簿,均无需修改核心写入逻辑。
二、数据源解析:HTML与JSON的提取规范与代码
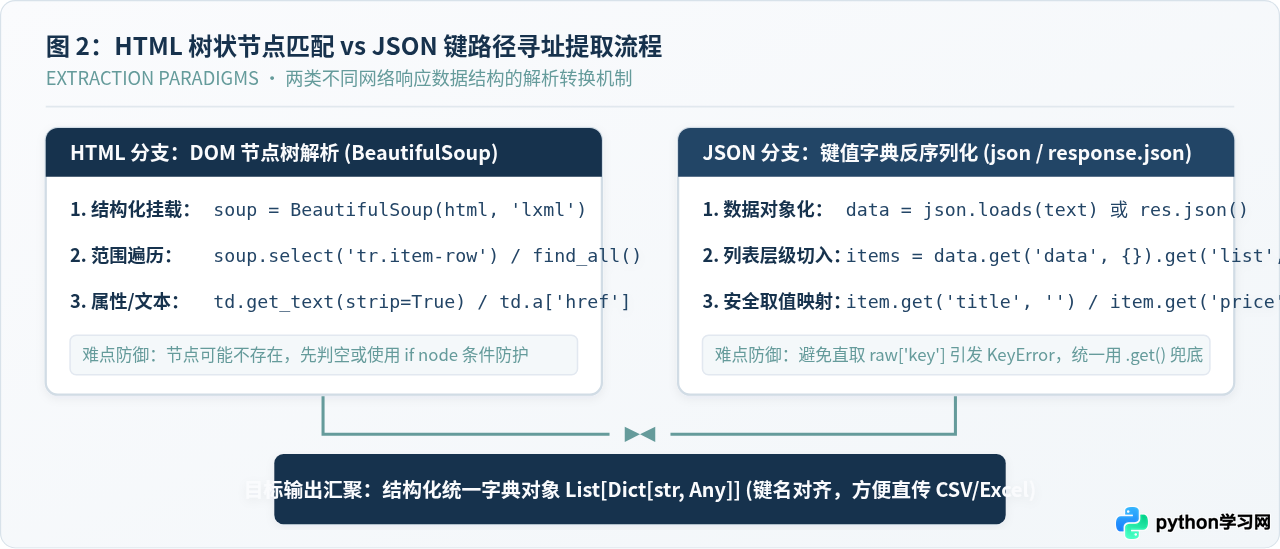
网络响应主要分为以标签层级嵌套为特征的 HTML 网页和以键值对结构化组织的 JSON 接口数据。以下分别介绍对应的字段解析与规整方法。
2.1 HTML 页面解析(基于 BeautifulSoup 提取列表数据)
对于包含结构化表格或列表的静态 HTML 页面,通常使用 BeautifulSoup(配合 lxml 解析器)进行节点检索。解析时的核心思路是先选定代表单行记录的公共父容器节点(例如 .product-card),再从容器内提取子节点文本与属性,并做去除空白字符与数据类型转换的防御性处理。
from bs4 import BeautifulSoup
from typing import List, Dict, Any

def parse_html_products(html_text: str) -> List[Dict[str, Any]]:
    """从HTML文本中提取商品数据,返回字段对齐的字典列表"""
    soup = BeautifulSoup(html_text, "lxml")
    results: List[Dict[str, Any]] = []

    # 定位所有包含商品条目的容器卡片
    cards = soup.select(".product-card")
    for card in cards:
        name_node = card.select_one(".product-title")
        price_node = card.select_one(".product-price")
        link_node = card.select_one("a.product-link")
        sales_node = card.select_one(".product-sales")

        item = {
            "product_id": card.get("data-id", "").strip(),
            "title": name_node.get_text(strip=True) if name_node else "",
            "price": float(price_node.get_text(strip=True).replace("¥", "")) if price_node else 0.0,
            "sales_count": int(sales_node.get_text(strip=True).replace("件", "")) if sales_node else 0,
            "detail_url": link_node.get("href", "").strip() if link_node else ""
        }
        results.append(item)

    return results

# 示例运行验证
mock_html_data = """
<div class="catalog">
  <div class="product-card" data-id="10091">
    <a class="product-link" href="https://example.com/p/10091">
      <span class="product-title">高性能便携显示器 4K 15.6寸</span>
    </a>
    <span class="product-price">¥1299.00</span>
    <span class="product-sales">3200件</span>
  </div>
  <div class="product-card" data-id="10092">
    <a class="product-link" href="https://example.com/p/10092">
      <span class="product-title">无线三模机械键盘 87键</span>
    </a>
    <span class="product-price">¥399.00</span>
    <span class="product-sales">8500件</span>
  </div>
</div>
"""
parsed_html_list = parse_html_products(mock_html_data)
print(f"HTML成功解析条目数: {len(parsed_html_list)}")
2.2 JSON 接口响应解析(处理层级嵌套与字典扁平化)
当数据来源于前后端分离网站的 API 时,返回的内容为 JSON 格式。使用 Python 标准库 json.loads() 或网络请求库的 response.json() 获取字典对象后,常需要应对嵌套字段(例如作者信息嵌套在 author 字典中)。采用 .get() 链式安全访问可以有效防止因个别记录缺失字段而触发 KeyError。
import json
from typing import List, Dict, Any

def parse_json_articles(raw_json: str) -> List[Dict[str, Any]]:
    """从JSON字符串中提取资讯列表并展平嵌套字典"""
    payload = json.loads(raw_json) if isinstance(raw_json, str) else raw_json
    data_block = payload.get("data", {})
    articles = data_block.get("article_list", [])

    normalized_records: List[Dict[str, Any]] = []
    for item in articles:
        author = item.get("author", {})
        metrics = item.get("metrics", {})

        record = {
            "article_id": str(item.get("id", "")),
            "title": item.get("title", "").strip(),
            "publish_time": item.get("published_at", ""),
            "author_name": author.get("nickname", "匿名用户"),
            "author_uid": str(author.get("uid", "")),
            "view_count": metrics.get("views", 0),
            "like_count": metrics.get("likes", 0)
        }
        normalized_records.append(record)

    return normalized_records

# 示例运行验证
mock_json_data = """
{
  "code": 200,
  "data": {
    "article_list": [
      {
        "id": "A9812401827419",
        "title": "深入剖析分布式爬虫架构设计",
        "published_at": "2026-10-25 14:30:00",
        "author": {"uid": 8012, "nickname": "CodeMaster"},
        "metrics": {"views": 15400, "likes": 620}
      },
      {
        "id": "A9812401827420",
        "title": "HTTP/2在现代网络采集中的应用实践",
        "published_at": "2026-10-26 09:15:00",
        "author": {"uid": 8015, "nickname": "DevExplorer"},
        "metrics": {"views": 9800, "likes": 340}
      }
    ]
  }
}
"""
parsed_json_list = parse_json_articles(mock_json_data)
print(f"JSON成功解析条目数: {len(parsed_json_list)}")
三、持久化方案一:写入 CSV 文件(标准库与 pandas)
CSV 是一种逗号分隔的纯文本表格格式,跨平台通用且占用存储空间小。在网络爬虫工程中,CSV 最突出的优势是支持追加写入(Append 模式),能在长时间爬取过程中边抓边存,即使因反爬中断,已有数据也不会丢失。
3.1 使用内置 csv.DictWriter(推荐,流式高性能)
Python 标准库的 csv.DictWriter 直接接受字典列表进行映射写入。使用标准库的优势是完全无外部依赖,在资源受限的环境中表现优异。
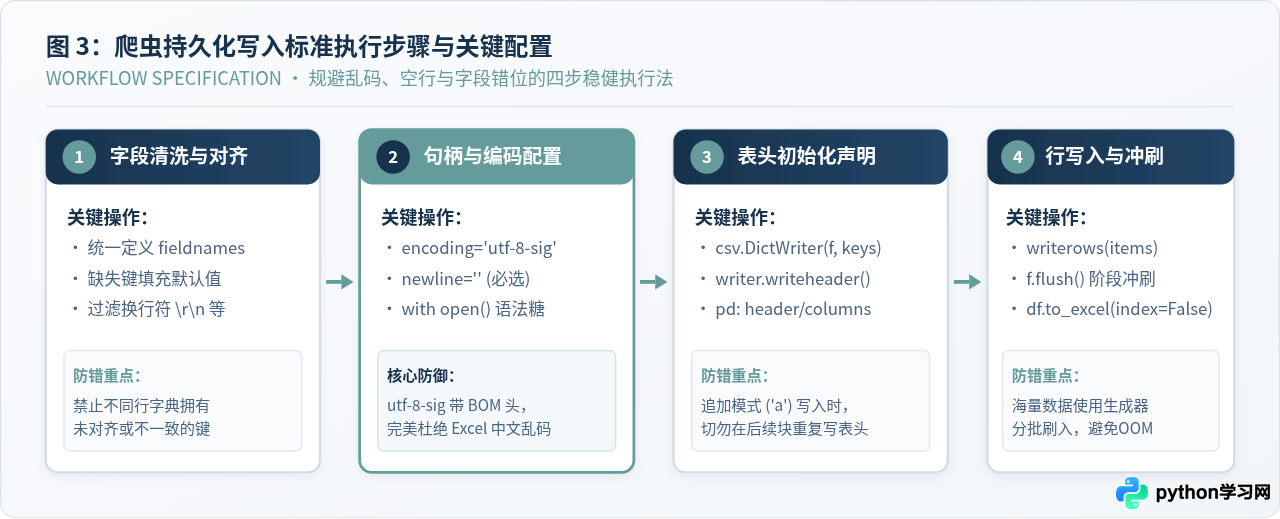
encoding='utf-8-sig':在文件头部写入 3 字节的 UTF-8 BOM 标识符(\xef\xbb\xbf)。Windows 系统下的 Excel 在双击打开 CSV 时,正是凭借该标识识别文件为 UTF-8 编码,否则会默认按 ANSI/GBK 解码导致中文全部变成乱码。2.
newline='':必须显式传入空字符串。Python 的 csv.writer 默认按 RFC 4180 标准在每行末尾生成 \r\n,若未设置 newline='',底层系统 I/O 会在 Windows 平台将 \n 再次转义为 \r\n,导致在 Office 中打开时每两行之间多出一行空白行。
import csv
from typing import List, Dict, Any

def save_to_csv_builtin(records: List[Dict[str, Any]], filepath: str) -> None:
    """使用标准库csv模块将字典数据写入CSV"""
    if not records:
        print("[提示] 记录列表为空,跳过持久化")
        return

    # 以第一条记录的键作为CSV表头
    headers = list(records[0].keys())

    # newline='' 防多余空行,utf-8-sig 防Windows Excel中文乱码
    with open(filepath, mode='w', encoding='utf-8-sig', newline='') as f:
        writer = csv.DictWriter(f, fieldnames=headers, extrasaction='ignore')

        # 写入表头
        writer.writeheader()
        # 写入所有数据行
        writer.writerows(records)

    print(f"[完成] CSV 文件已保存至: {filepath},写入 {len(records)} 行")

# 示例调用
save_to_csv_builtin(parsed_json_list, "output_articles.csv")
3.2 使用 pandas.DataFrame.to_csv()(批量导出)
如果在抓取之后需要对数据进行清洗、列重命名、过滤空值或排序,使用 pandas 库操作会更为直观。
import pandas as pd

def save_to_csv_pandas(records: List[Dict[str, Any]], filepath: str) -> None:
    """使用 pandas 导出为 CSV 文件"""
    df = pd.DataFrame(records)
    # index=False 避免将行序号作为第一列写入文件
    df.to_csv(filepath, index=False, encoding='utf-8-sig')
    print(f"[完成] pandas 成功导出 CSV: {filepath}")
四、持久化方案二:写入 Excel 文件(.xlsx)
当数据需要直接交付给业务部门、财务或数据分析师时,标准的 Excel .xlsx 工作簿体验更佳。Excel 支持多工作表(Sheet)隔离、自动列宽自适应以及数字格式设定。在 Python 中,通常结合 pandas 与底层 openpyxl 引擎来生成 Excel 文件。
4.1 单工作表与多工作表导出代码
通过 pd.ExcelWriter 上下文管理器,可以在一个 .xlsx 文件中创建多个不同的 Sheet,分别存放不同爬取源(如商品明细表与分类汇总表)的数据。
import pandas as pd
from typing import List, Dict, Any

def save_to_excel_single(records: List[Dict[str, Any]], filepath: str, sheet_name: str = "数据明细") -> None:
    """导出单工作表 Excel 文件"""
    df = pd.DataFrame(records)
    df.to_excel(filepath, sheet_name=sheet_name, index=False, engine='openpyxl')
    print(f"[完成] 单工作表 Excel 已保存: {filepath}")

def save_to_excel_multi_sheets(
    products_data: List[Dict[str, Any]],
    articles_data: List[Dict[str, Any]],
    filepath: str
) -> None:
    """在一个 Excel 文件中导出多工作表数据"""
    df_products = pd.DataFrame(products_data)
    df_articles = pd.DataFrame(articles_data)

    with pd.ExcelWriter(filepath, engine='openpyxl') as writer:
        df_products.to_excel(writer, sheet_name="商品数据", index=False)
        df_articles.to_excel(writer, sheet_name="资讯数据", index=False)

    print(f"[完成] 多工作表 Excel 已生成: {filepath}")

# 示例调用
save_to_excel_multi_sheets(parsed_html_list, parsed_json_list, "crawler_dataset.xlsx")
4.2 长数值字符串截断与科学计数法防范
在持久化长数字标识(如商品编号、订单号、身份证号、银行卡号)时,Excel 默认会将其解析为双精度浮点数。当数字长度超过 11 位时会被显示为科学计数法(例如 9.8124E+13),当超过 15 位时超出部分甚至会被直接置零,导致原始标识信息永久损坏。
防范方案:
- 在数据清洗阶段,必须显式将此类字段转换为 Python 字符串类型(
str(val)); - 写入 CSV 时,若目标主要是通过 Excel 打开查阅,可在纯数字前拼接制表符
f"\t{item_id}",强制 Excel 将其视作纯文本而不转为浮点数; - 写入 Excel(.xlsx)时,确保 DataFrame 中该列的
dtype为object或string。
五、核心避坑指南与格式选型决策
在实际生产环境中运行爬虫持久化脚本时,常见的问题主要集中在文件编码、换行规则、内存开销以及软件规格限制上。针对这些场景的排查要点如下:
-
Windows Excel 打开 CSV 乱码:
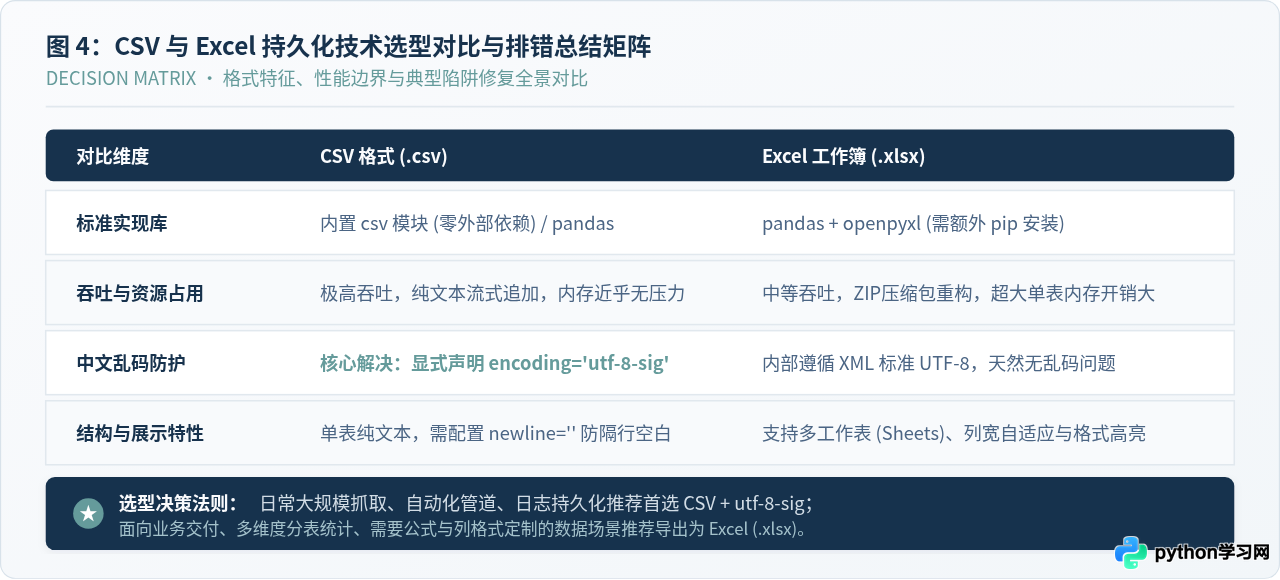
Excel 在简体中文 Windows 下打开 CSV 默认遵循系统 ANSI(GBK)编码。如果保存文件时使用标准的
utf-8,由于缺乏编码提示,Excel 会将其以 GBK 解码导致全部乱码。解决办法是保存时严格指定encoding='utf-8-sig'。 -
CSV 行与行之间出现多余空白行:
在 Windows 环境下打开文件若未传入
newline='',Python 内置写操作会自动将\n换行映射为\r\n,叠加csv.writer自身的换行符,最终输出为\r\r\n,从而产生空行。 -
海量数据写入导致内存溢出(OOM):
当单次采集数据量达数十万条时,切忌把所有数据全存入一个巨大的列表中再调用
df.to_csv()。推荐采用生成器(yield)配合csv.writer.writerows()分批次写入,并在每批次完成后调用f.flush()刷盘,使内存开销保持恒定。 - Excel 单表百万行上限限制: 单个 Excel 工作表的最大行数为 1,048,576 行。超过该体量时继续写入会直接报错中断。因此海量或无限流抓取任务必须选用 CSV 格式或切分存储。
💡 总结与选型决策
在 Python 爬虫数据持久化的整体链路中,保持“数据提取端字段对齐、存储写入端按需选型”是工程落地的最佳实践:
- 针对每日定时增量抓取、海量数据吞吐、流水线对接等高频与大数据场景,首选标准库
csv配合utf-8-sig与newline='',轻量且具备出色的崩溃容错能力; - 针对需要多分类汇总、交付非技术人员审阅、字段少于百万行的数据场景,选用
pandas + openpyxl导出.xlsx工作簿,以获得最佳的多表隔离与格式化阅读体验。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















