


Python机器学习模型部署:使用Flask将算法封装为API服务
本文系统讲解如何使用Python轻量级Web框架Flask将训练好的机器学习算法模型封装为标准RESTful API服务。涵盖预处理管线固化、服务全局初始化、POST路由设计、严密输入校验、本地联调测试及Gunicorn生产级部署考量。
将离线训练好的机器学习算法投入实际业务,核心解决路径是将算法模型持久化序列化,并通过 Web 框架将其封装为可通过标准网络协议访问的 RESTful API 接口。在 Python 技术生态中,Flask 凭借轻量、直观和无强制约束的设计,成为封装中小型算法模型、原型验证以及微服务推理节点的首选工具。本文从算法流水线固化、Flask 应用架构搭建、输入严格校验与异常处理,到本地联调验证与生产环境部署考量,完整梳理这一部署过程的操作规范与工程细节。
一、核心逻辑:训练阶段与推理阶段的解耦与连接
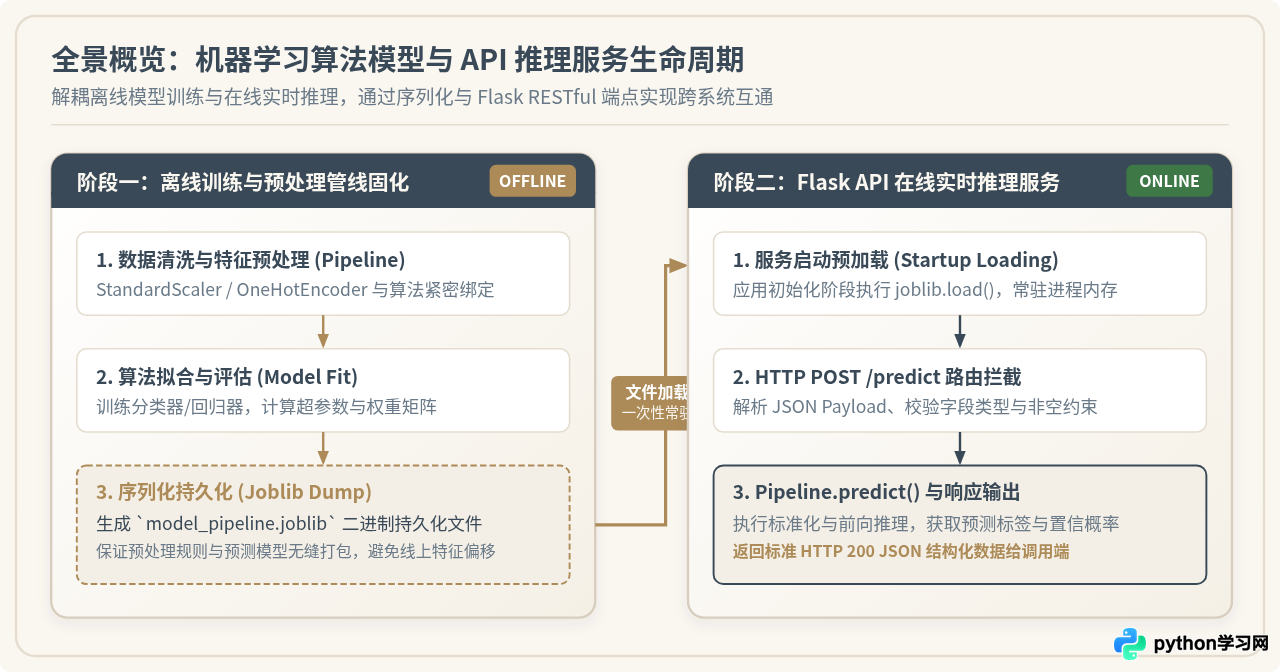
在算法研发的实验阶段,开发者通常在 Jupyter Notebook 或本地脚本中进行数据加载、清洗、特征提取、超参数搜索和模型拟合。而在部署阶段,服务的目标是在毫秒级时间内接收单个或批量特征输入,并稳定返回预测标签与置信概率。实现这一转变的关键在于离线训练与在线推理的完全解耦。
在工程实践中,必须将模型对象以及训练阶段确定的数据转换器(例如标准化 StandardScaler 或独热编码 OneHotEncoder)作为整体进行打包。如果只保存最终的分类器或回归器,在线上推理时使用未经对齐或未正确缩放的原始数据输入模型,就会发生严重的“训练-服务偏斜”(Training-Serving Skew),导致模型预测完全失效。
在 Python 序列化工具的选择上,虽然标准库提供了 pickle 模块,但对于包含大型 NumPy 数组和多层决策树的机器学习模型,优先推荐使用 joblib。joblib 针对大型数组数据在磁盘存储与反序列化时进行了深度优化,加载速度更快且内存占用更为平稳。
二、模型离线构建与流水线固化
以下示例以鸢尾花(Iris)分类任务为例,演示如何使用 Scikit-learn 的 Pipeline 将特征标准化与随机森林分类器组合成单个端到端对象,并使用 joblib 固化到磁盘文件 model_pipeline.joblib 中。该文件正是后续 Flask 服务启动时直接载入的唯一实体。
# -*- coding: utf-8 -*-
import os
import joblib
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.pipeline import Pipeline
from sklearn.metrics import accuracy_score

def train_and_export_model(export_path: str = "model_pipeline.joblib"):
    # 1. 载入标准示例数据集
    iris = load_iris()
    X, y = iris.data, iris.target
    feature_names = iris.feature_names
    target_names = [str(name) for name in iris.target_names]

    # 2. 划分训练集与验证集
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42, stratify=y
    )

    # 3. 构造预处理与分类估算器复合管线 (Pipeline)
    # 将 StandardScaler 与随机森林打包,确保在线推理时以同样的均值与方差缩放输入
    pipeline = Pipeline([
        ('scaler', StandardScaler()),
        ('classifier', RandomForestClassifier(n_estimators=50, random_state=42))
    ])

    # 4. 执行训练与评估
    pipeline.fit(X_train, y_train)
    y_pred = pipeline.predict(X_test)
    accuracy = accuracy_score(y_test, y_pred)
    print(f"[Info] 验证集准确率: {accuracy:.4f}")

    # 5. 持久化打包保存
    # 附带业务元数据,便于服务加载时检查契约
    export_payload = {
        "pipeline": pipeline,
        "feature_names": feature_names,
        "target_names": target_names,
        "feature_count": len(feature_names)
    }
    joblib.dump(export_payload, export_path)
    print(f"[Success] 模型流水线已成功固化保存至: {export_path}")

if __name__ == "__main__":
    train_and_export_model()
执行命令:python train_and_export.py
示例输出:
[Info] 验证集准确率: 0.9333
[Success] 模型流水线已成功固化保存至: model_pipeline.joblib
执行完成后,生成的 model_pipeline.joblib 包含了所有标准化均值、方差参数以及森林各决策树节点的切分逻辑,后续 Web 服务无需安装复杂数据处理依赖,即可直接调用其推理能力。
三、实施步骤:构建 Flask 推理服务应用
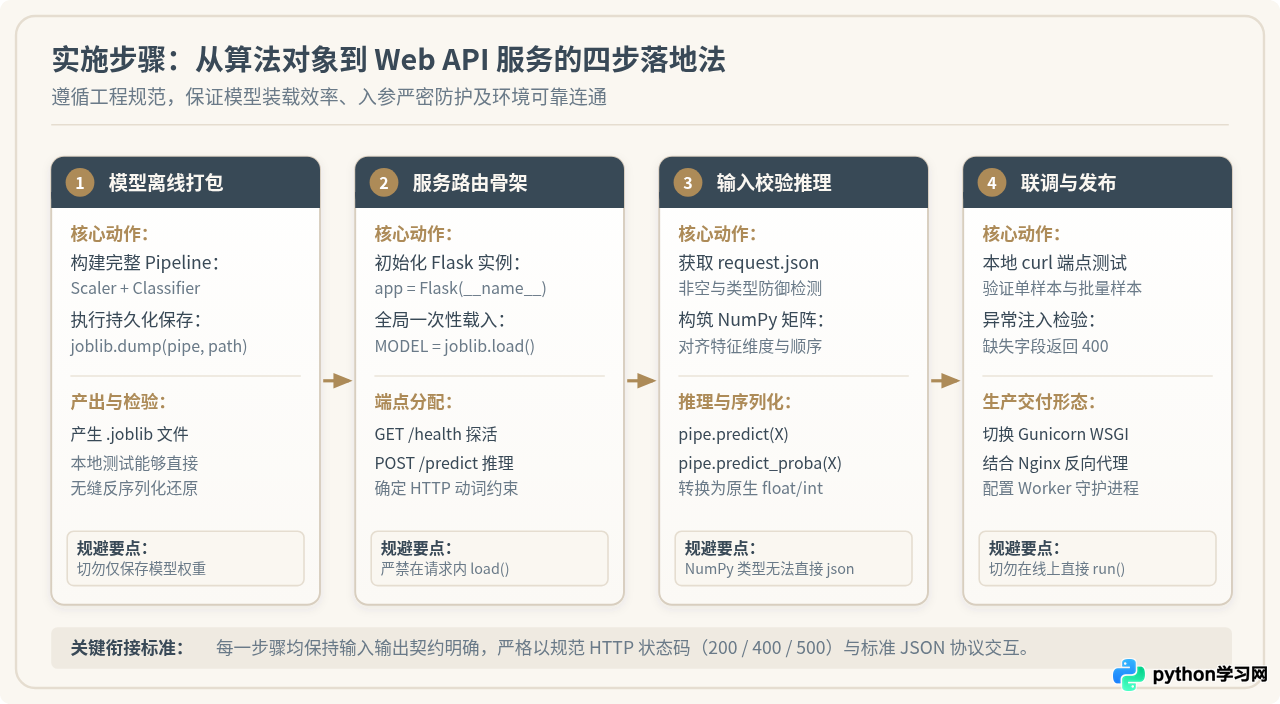
编写推理服务时,最核心的性能与架构法则是:在应用进程初始化阶段全局加载模型一次,将其常驻内存。严禁在每个请求处理函数内部执行 joblib.load(),否则频繁的磁盘 IO 和对象反序列化将导致接口吞吐量断崖式下跌,甚至在高并发时耗尽服务器内存。
1. 服务项目目录规划
保持工程结构精简透明,有助于团队协作与部署容器化:
model_service/
├── model_pipeline.joblib     # 训练产出的固化管线文件
├── train_and_export.py       # 离线训练重现脚本
├── app.py                    # Flask Web 核心服务逻辑
└── client_test.py            # 本地联调与冒烟测试脚本
2. 编写完整稳定的服务代码
在 app.py 中,需要实现以下两个标准端点:
GET /health:健康检查探针,用于容器健康检查(如 Kubernetes Liveness/Readiness 探针)或反向代理心跳检测,返回服务状态与加载的模型信息。POST /predict:核心推理接口,仅接收application/json格式数据,负责输入结构校验、矩阵转换、前向推理及结果序列化封装。
# -*- coding: utf-8 -*-
import os
import sys
import time
import joblib
import numpy as np
from flask import Flask, request, jsonify

app = Flask(__name__)

# ==========================================
# 1. 服务初始化:全局加载模型与特征元数据
# ==========================================
MODEL_PATH = os.environ.get("MODEL_PATH", "model_pipeline.joblib")

print(f"[Init] 正在从 {MODEL_PATH} 加载机器学习流水线...")
try:
    saved_bundle = joblib.load(MODEL_PATH)
    PIPELINE = saved_bundle["pipeline"]
    FEATURE_NAMES = saved_bundle["feature_names"]
    TARGET_NAMES = saved_bundle["target_names"]
    EXPECTED_FEATURE_COUNT = saved_bundle["feature_count"]
    print(f"[Init] 模型加载就绪。特征维度: {EXPECTED_FEATURE_COUNT}, 标签类别: {TARGET_NAMES}")
except Exception as e:
    print(f"[Fatal] 模型加载失败: {str(e)}", file=sys.stderr)
    sys.exit(1)

# ==========================================
# 2. 端点一:服务探活与健康检查接口
# ==========================================
@app.route("/health", methods=["GET"])
def health_check():
    return jsonify({
        "status": "healthy",
        "service": "ml-inference-flask",
        "model_loaded": True,
        "feature_count": EXPECTED_FEATURE_COUNT,
        "classes": TARGET_NAMES
    }), 200

# ==========================================
# 3. 端点二:核心预测路由与防御性校验
# ==========================================
@app.route("/predict", methods=["POST"])
def predict():
    start_time = time.time()

    # 门禁 1: 检查 Content-Type 与 JSON 解析有效性
    if not request.is_json:
        return jsonify({
            "status": "error",
            "message": "Header Content-Type 必须为 application/json",
            "code": 400
        }), 400

    payload = request.get_json(silent=True)
    if payload is None:
        return jsonify({
            "status": "error",
            "message": "请求体为空或包含非法 JSON 字符串",
            "code": 400
        }), 400

    # 门禁 2: 校验关键数据契约
    if "features" not in payload:
        return jsonify({
            "status": "error",
            "message": "缺少必需的顶层键 'features'",
            "code": 400
        }), 400

    raw_features = payload["features"]

    # 门禁 3: 支持单条样本 [x1, x2, x3, x4] 或多条批处理 [[...], [...]]
    try:
        data_matrix = np.array(raw_features, dtype=float)
    except (ValueError, TypeError):
        return jsonify({
            "status": "error",
            "message": "'features' 中存在无法转换为数值浮点型的非法元素",
            "code": 400
        }), 400

    # 矩阵维度自适应规范化
    if data_matrix.ndim == 1:
        data_matrix = data_matrix.reshape(1, -1)
    elif data_matrix.ndim != 2:
        return jsonify({
            "status": "error",
            "message": f"输入特征数组必须为一维或二维结构,当前维度阶数为: {data_matrix.ndim}",
            "code": 400
        }), 400

    # 门禁 4: 检查特征维度是否与训练集一致
    batch_size, feature_dim = data_matrix.shape
    if feature_dim != EXPECTED_FEATURE_COUNT:
        return jsonify({
            "status": "error",
            "message": f"特征数量不匹配: 期望 {EXPECTED_FEATURE_COUNT} 个数值特征,实际收到 {feature_dim} 个",
            "code": 400
        }), 400

    # 门禁 5: 检查是否存在 NaN 或 Inf 非法浮点数
    if np.isnan(data_matrix).any() or np.isinf(data_matrix).any():
        return jsonify({
            "status": "error",
            "message": "特征矩阵中包含非法值 (NaN 或 Inf),无法进行前向推理",
            "code": 400
        }), 400

    # 4. 执行模型推理与概率计算
    try:
        predictions = PIPELINE.predict(data_matrix)
        probabilities = PIPELINE.predict_proba(data_matrix)
    except Exception as err:
        return jsonify({
            "status": "error",
            "message": f"模型推理执行异常: {str(err)}",
            "code": 500
        }), 500

    # 5. 格式化组装响应结果
    results = []
    for idx in range(batch_size):
        pred_class_idx = int(predictions[idx])
        pred_label = TARGET_NAMES[pred_class_idx]
        class_probs = {TARGET_NAMES[i]: round(float(probabilities[idx][i]), 4) for i in range(len(TARGET_NAMES))}
        results.append({
            "class_index": pred_class_idx,
            "label": pred_label,
            "confidence": round(float(probabilities[idx][pred_class_idx]), 4),
            "probabilities": class_probs
        })

    latency_ms = round((time.time() - start_time) * 1000, 2)
    return jsonify({
        "status": "success",
        "sample_count": batch_size,
        "latency_ms": latency_ms,
        "data": results
    }), 200

if __name__ == "__main__":
    # 本地开发测试环境启动
    app.run(host="127.0.0.1", port=5000, debug=False)
四、请求验证、错误边界与异常处理
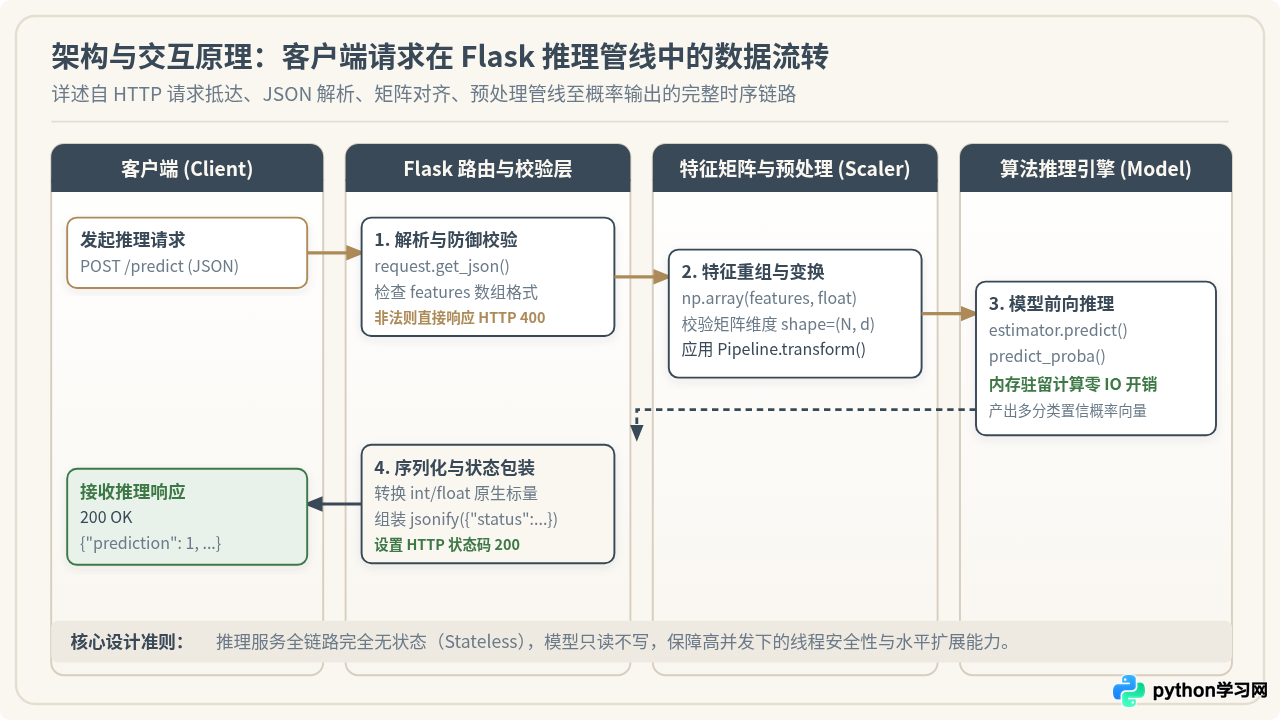
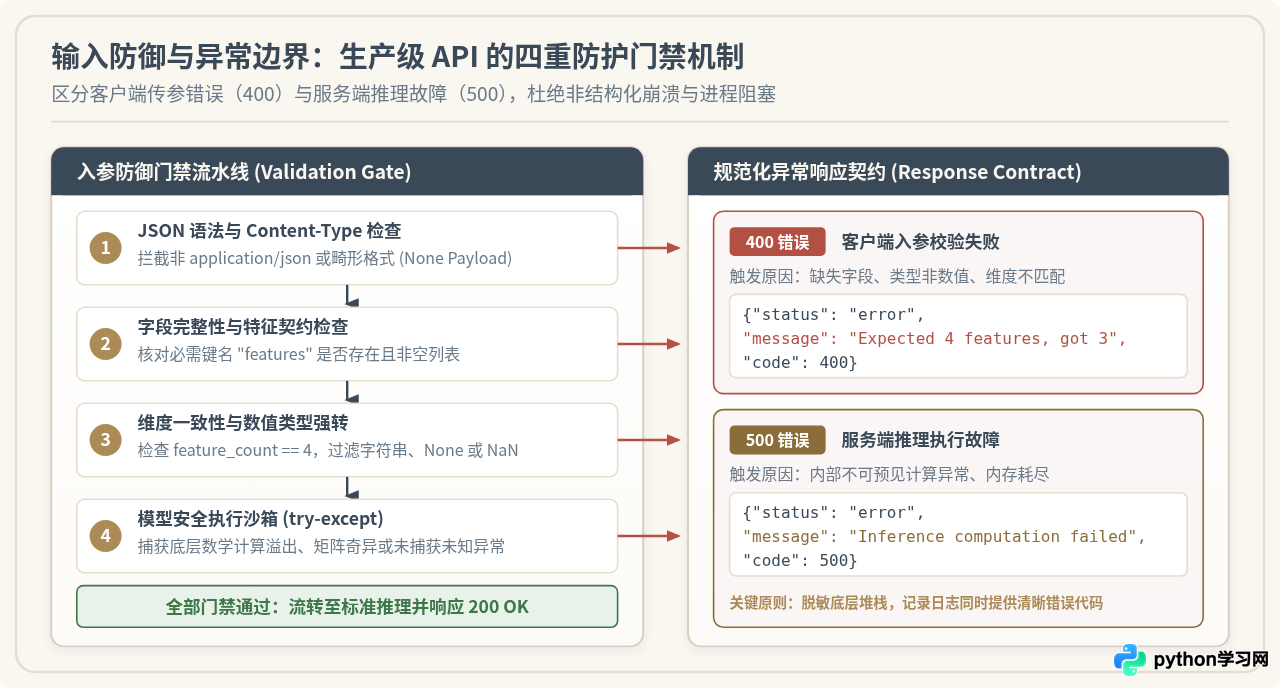
将算法暴露给外部调用时,最常遭遇的生产事故往往不是算法本身的拟合缺陷,而是输入格式异常引发的未处理崩溃。因此,严密的防御性编程是 API 服务的生命线。
1. 关键转折点解析与防御机制
| 异常场景 | 底层表现 | 防御策略与处理动作 | HTTP 状态码 |
|---|---|---|---|
| 畸形 JSON 请求体 | request.get_json() 解析抛出异常或返回 None |
使用 silent=True 防止直接抛出 500 页面,主动响应结构化错误信息 |
400 Bad Request |
| 输入特征维度缺失 | NumPy 维度不为 4,例如仅传递 3 个特征 | 比较 data_matrix.shape[1] 与预期特征数,在进入模型前精确拦截 |
400 Bad Request |
| 非法空值 (NaN / Inf) | Scikit-learn StandardScaler 内部抛出 ValueError 崩溃 |
使用 np.isnan() 与 np.isinf() 提前校验,阻断计算污染 |
400 Bad Request |
| NumPy 数据类型序列化错误 | TypeError: Object of type int64 is not JSON serializable |
将预测索引显式强转为原生 int,概率转换为原生 float |
200 OK / 规范防护 |
| 底层计算意外故障 | 底层 C/Fortran 依赖库数学运算崩溃 | 全局 try-except 兜底,脱敏内部堆栈,输出统一错误契约 |
500 Internal Error |
五、服务联调与功能验证
启动本地服务后,可以使用命令行工具 curl 或自动化脚本对服务进行多维度验证,确保正常样本预测正确,同时各种边界异常均能按预期返回正确的 HTTP 状态码。
1. 启动服务进程
执行命令:python app.py
示例输出:
[Init] 正在从 model_pipeline.joblib 加载机器学习流水线...
[Init] 模型加载就绪。特征维度: 4, 标签类别: ['setosa', 'versicolor', 'virginica']
 * Serving Flask app 'app'
 * Debug mode: off
 * Running on http://127.0.0.1:5000
2. 验证健康检查接口
执行命令:
curl -s -X GET http://127.0.0.1:5000/health示例返回结果:
{
  "classes": ["setosa", "versicolor", "virginica"],
  "feature_count": 4,
  "model_loaded": true,
  "service": "ml-inference-flask",
  "status": "healthy"
}
3. 验证单样本正常预测
执行命令:
curl -s -X POST http://127.0.0.1:5000/predict -H "Content-Type: application/json" -d '{"features": [5.1, 3.5, 1.4, 0.2]}'示例返回结果:
{
  "data": [
    {
      "class_index": 0,
      "confidence": 1.0,
      "label": "setosa",
      "probabilities": {
        "setosa": 1.0,
        "versicolor": 0.0,
        "virginica": 0.0
      }
    }
  ],
  "latency_ms": 1.84,
  "sample_count": 1,
  "status": "success"
}
4. 验证异常输入拦截(特征维度不足)
执行命令:
curl -s -X POST http://127.0.0.1:5000/predict -H "Content-Type: application/json" -d '{"features": [5.1, 3.5, 1.4]}'示例返回结果(HTTP 400):
{
  "code": 400,
  "message": "特征数量不匹配: 期望 4 个数值特征,实际收到 3 个",
  "status": "error"
}
六、生产环境考量与高可用演进
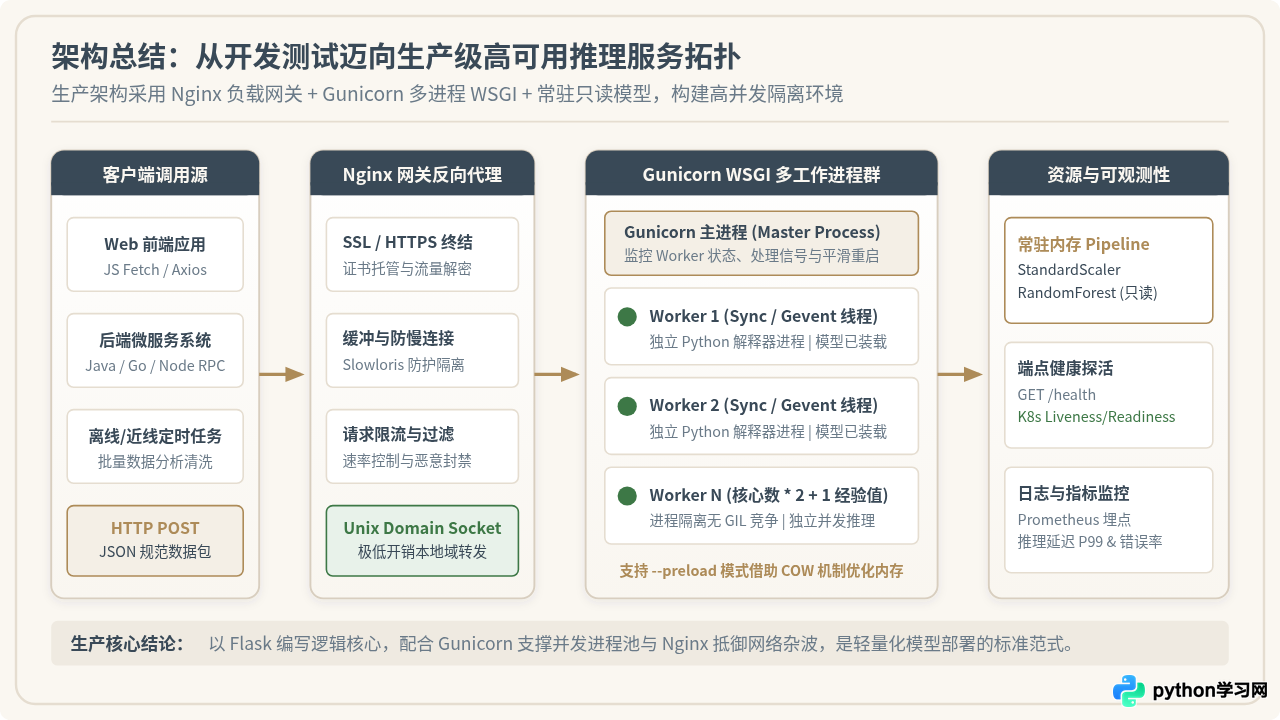
通过 app.run() 启动的 Flask 内部内置服务器基于 Werkzeug,其设计初衷仅用于本地代码调试与功能验证,存在单线程阻塞、缺乏连接缓冲保护等天然局限,绝对不能直接用于线上对外服务。若要在生产环境中保障高并发、低延迟与高可用,需要完成以下架构升级:
1. 引入生产级 WSGI 容器:Gunicorn
在 Linux 生产环境中,通常使用 Gunicorn(Green Unicorn)作为 WSGI HTTP 容器。Gunicorn 采用经典的 Pre-fork Worker 模型:主进程(Master)负责监听信号、管理工作进程生命周期;一组由 Master 预先衍生出的独立 Worker 进程并发处理实际网络请求。
每个 Worker 是独立的操作系统进程,拥有各自独立的 Python 虚拟机环境,从根本上绕过了 CPython 的全局解释器锁(GIL)对多核 CPU 并发计算的限制。启动命令示例:
# 在 4 核 CPU 节点上启动 9 个并发工作进程,绑定 Unix 套接字或本地端口
gunicorn -w 9 -b 127.0.0.1:8000 --timeout 60 app:app标准 Gunicorn 官方推荐公式为:workers = (2 * CPU_CORES) + 1。然而对于机器学习推理场景,必须重点评估单进程内存占用。如果单个复杂模型占用 1.5GB 内存,盲目开启 8 个 Worker 将消耗超过 12GB 物理内存,极易触发操作系统的 OOM Killer。若模型体积较大,可通过添加 --preload 参数使主进程先加载模型,再通过 Linux 的写时复制(Copy-On-Write)机制让子进程共享只读模型内存页,显著降低总内存开销。
2. 前置 Nginx 作为网关与反向代理
生产架构中应始终在 Gunicorn 前端部署 Nginx 反向代理:
- 隔离慢速客户端:Nginx 拥有极高的异步 IO 性能,在完整接收客户端上传的请求数据后才一次性转发给 Gunicorn,防止慢速网络连接长时间占死昂贵的 Python 推理进程。
- 安全与协议卸载:集中管理 SSL/TLS 证书加解密,处理跨域资源共享(CORS),以及基于 IP 的限流与恶意流量过滤。
- 多节点负载均衡:当单机算力达到瓶颈时,Nginx 可以无缝轮询多台后端算法实例机器,实现推理服务的无缝水平扩展。
七、总结
使用 Flask 将机器学习算法封装为 API 服务,本质是一次算法数学对象向工程网络服务的规范化转换。落地全流程的核心经验可归结为三点:
- 流水线全量持久化:严防训练与服务特征偏斜,将预处理转换器与算法估算器整体打包固化为单体文件。
- 服务单次全局加载与无状态化:应用启动时一次性加载模型常驻内存,推理过程严格保持无状态(Stateless),确保只读计算零锁竞争。
- 严密输入防御与容器分层:通过分层门禁将非法请求阻绝在模型之外,以规范的 HTTP 状态码回执调用方;在生产部署中坚决配合 Gunicorn 与 Nginx 实现性能与可靠性的最大化。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















