


Python不保存文件直接解析网页CSV数据的方法
详细讲解在Python中无需落盘或保存本地临时文件,直接在内存中解析远程网页CSV数据的实用方案,涵盖urllib原生库、Requests配合io.StringIO、大文件流式按行迭代及Pandas直连读取等多种场景与避坑技巧。
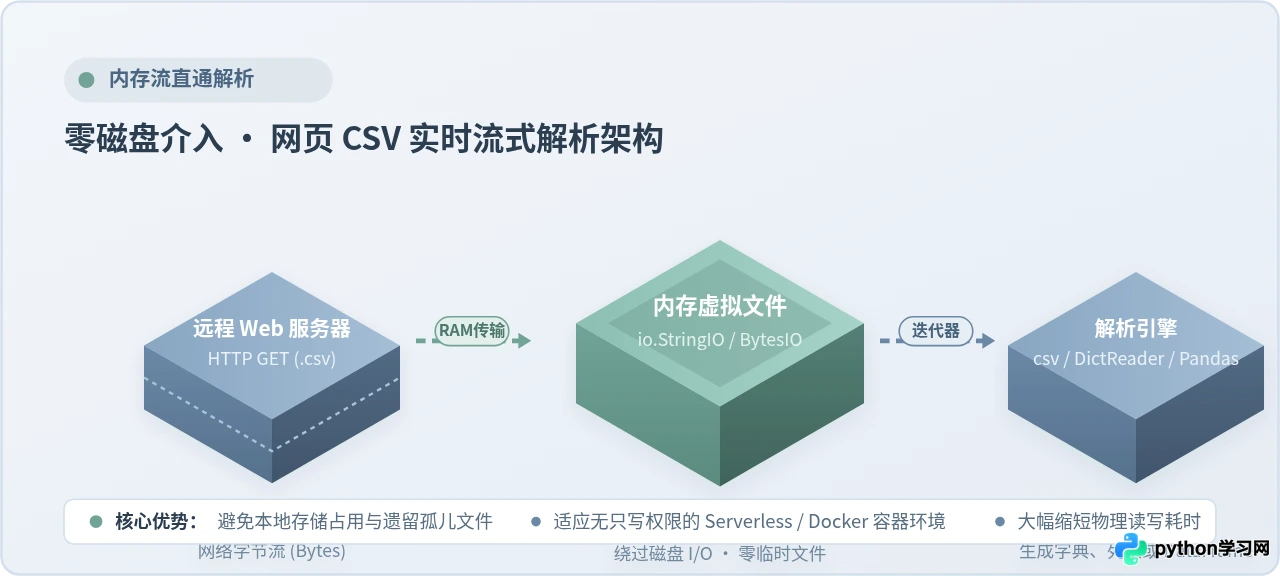
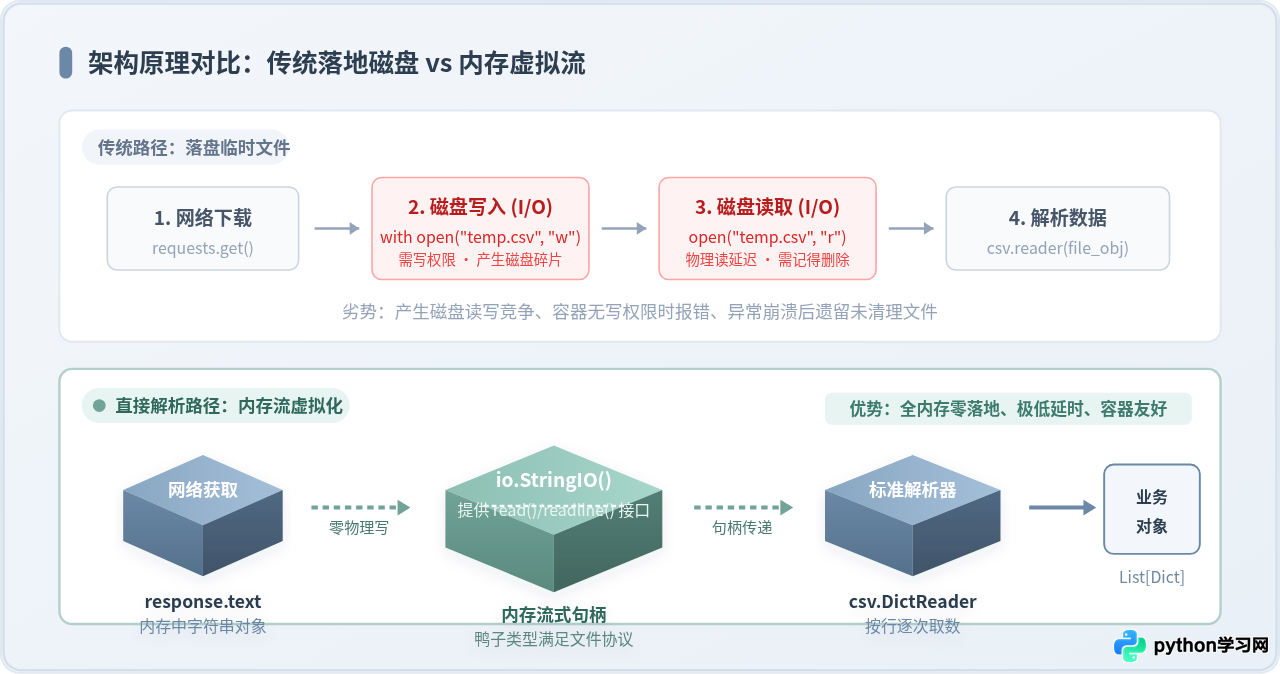
在日常自动化脚本编写、定时数据采集或云端 Serverless(如 AWS Lambda、函数计算)以及 Docker 容器环境中,我们经常需要处理托管在网络上的 CSV 数据源。常见的做法是先用下载库将文件保存到本地磁盘(如 temp.csv),然后再通过 open() 打开解析。这种做法不仅会产生多余的物理磁盘 I/O 开销与延迟,在只读文件系统或多并发任务下还容易遭遇写入权限不足、磁盘空间积压及临时文件清理失败等问题。实际上,Python 提供了强大的内存虚拟文件机制(如标准库中的 io.StringIO 与 io.BytesIO),配合 csv 模块或 pandas,完全可以在内存中一气呵成地完成“请求-解码-解析”全流程。本文将详细讲解这一方法的核心原理、标准库零依赖实现、主流 Requests 方案、超大文件流式按行迭代以及常见编码陷阱与避坑建议。
一、核心机制:为什么无需落盘即可解析?
很多开发者初学 Python 时容易形成一种定式思维,认为 csv.reader 或 csv.DictReader 接收的第一个参数必须是本地磁盘上的物理文件。但事实上,Python 广泛遵循“鸭子类型”(Duck Typing)设计哲学。
查看 Python 官方文档对 csv.reader(csvfile) 的参数要求,其定义为:csvfile 可以是任何支持迭代器协议并能按次返回字符串的对象,即拥有 __iter__() 迭代器或 readline() 方法的“类文件对象”(File-like Object)。真实的物理文件句柄只是该协议的一种实现。
Python 标准库 io 模块中的 io.StringIO 恰好就是这样一个类文件接口的内存文本流:
- 原始状态:网络 HTTP 请求返回的是纯粹的文本字符串(
str)或原始字节序列(bytes)。 - 流化包装:
io.StringIO(text_data)会在内存中开辟一段缓冲区,并向外暴露完全等同于open()的文件 API(例如支持文件指针游标seek()、逐行读取readline()等)。 - 直接消费:解析器
csv.reader直接对这个内存虚拟对象进行读取,整个过程中无任何磁盘触碰,数据生命周期与 Python 进程变量完全绑定,函数退出即自动由垃圾回收器(GC)释放。
二、标准库零依赖方案:urllib 与 io.StringIO 结合
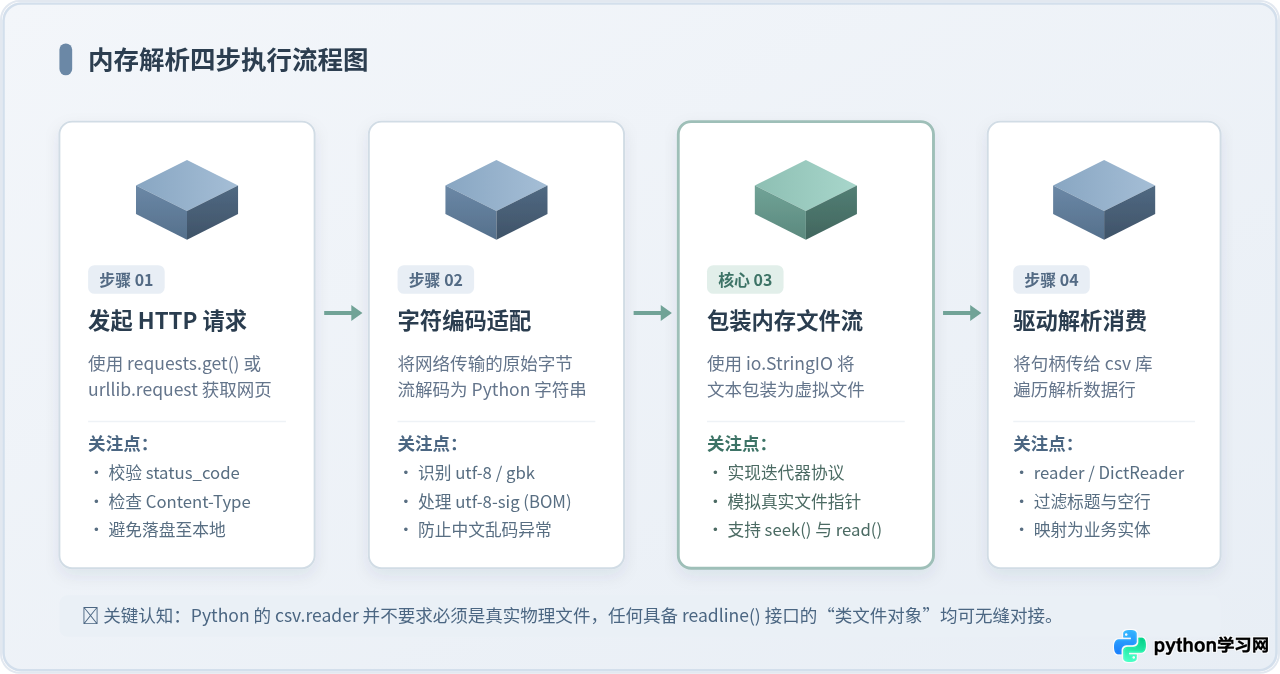
如果运行环境处于严格管控的生产服务器、极简基础镜像或不允许安装第三方 pip 包的内网设备中,我们可以直接利用 Python 自带的标准库(urllib.request + io.StringIO + csv)实现完全的零依赖解析。
其关键步骤包括:通过 urllib.request.urlopen() 建立网络连接并获取原始字节,使用适当的字符集解码为字符串,随后送入 io.StringIO 构建流对象,最后使用 csv.reader 或 csv.DictReader 解析。
1. 完整示例代码(原生标准库)
# -*- coding: utf-8 -*-
import urllib.request
import io
import csv

def fetch_and_parse_csv_stdlib(target_url: str):
    # 1. 构造请求头,模拟合法的客户端行为
    req = urllib.request.Request(
        url=target_url,
        headers={"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Python-urllib"}
    )

    # 2. 发起网络请求获取响应
    with urllib.request.urlopen(req, timeout=15) as response:
        if response.status != 200:
            raise RuntimeError(f"HTTP 请求异常,状态码: {response.status}")

        # 获取原始字节流并按 utf-8-sig 解码(可兼容带有 BOM 头的 CSV 文件)
        raw_bytes = response.read()
        text_content = raw_bytes.decode("utf-8-sig")

    # 3. 将内存字符串包装为类文件对象 (StringIO)
    csv_stream = io.StringIO(text_content)

    # 4. 直接传入 csv.DictReader 进行逐行字典映射解析
    reader = csv.DictReader(csv_stream)

    parsed_records = []
    for row in reader:
        # 每一行 row 均为 OrderedDict 或标准 dict,键为表头列名
        parsed_records.append(dict(row))

    return parsed_records

# 示例调用
if __name__ == "__main__":
    demo_url = "https://raw.githubusercontent.com/datasets/gdp/master/data/gdp.csv"
    try:
        data = fetch_and_parse_csv_stdlib(demo_url)
        print(f"成功解析记录条数: {len(data)}")
        print("前 2 条数据示例:", data[:2])
    except Exception as exc:
        print(f"解析过程中发生错误: {exc}")
如上所示,整个数据从抓取到转成 Python 字典列表,全程在内存中完成,无任何本地临时文件名、磁盘写入路径或 os.remove() 清理代码。
三、主流工程方案:利用 Requests 精确掌控编码
在常规业务项目中,requests 库凭借更优雅的 API、完善的连接池支持以及强大的会话(Session)管理,是绝大多数 Python 工程师的首选。
与标准库相比,requests.get() 会自动管理 HTTP 连接与解码,其 response.text 属性会在内存中直接提供解码后的字符串。但在解析中文网页 CSV 时,有一个极为普遍的“暗坑”:Windows 系统下的 Excel 导出 CSV 时,往往会在文件开头插入 3 个特殊字节(EF BB BF),即 BOM(Byte Order Mark)签名。
如果直接使用普通 utf-8 解码,第一列的字段名会自动带上不可见字符 (例如 Country Name),导致后续按字典键名查询时抛出 KeyError 异常。正确且通用的做法是指定编码为 utf-8-sig。
2. Requests 优雅解析实践
# -*- coding: utf-8 -*-
import requests
import io
import csv

def fetch_web_csv_with_requests(url: str):
    session = requests.Session()
    session.headers.update({
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    })

    response = session.get(url, timeout=20)
    response.raise_for_status() # 若遇到 404/500 等错误立即抛出对应 HTTPError

    # 优先处理 BOM 签名与编码兼容
    # 若响应未声明 charset 或声明有偏差,显式指定 utf-8-sig 可同时兼容标准 UTF-8 与带 BOM 的 UTF-8
    response.encoding = "utf-8-sig"

    # 将内存文本交给 StringIO
    memory_file = io.StringIO(response.text)

    # 使用 csv.reader 逐行解析列表
    reader = csv.reader(memory_file)
    headers = next(reader, None) # 提取首行表头

    rows = [row for row in reader if row] # 过滤掉末尾可能存在的空白行
    return headers, rows

if __name__ == "__main__":
    url = "https://example.com/daily_report.csv"
    headers, rows = fetch_web_csv_with_requests(url)
    print("表头:", headers)
    print(f"有效数据行数: {len(rows)}")
response.encoding 赋值为 "utf-8-sig" 后,再次访问 response.text 属性时,Requests 会在内部调用 Python 的 codecs 解码器,自动剥离开头的 BOM 标记()。这样得到的首列字段名就是完全干净的纯文本,有效规避了字典匹配失败的隐蔽 BUG。
四、海量数据场景:使用流式迭代避免内存爆破
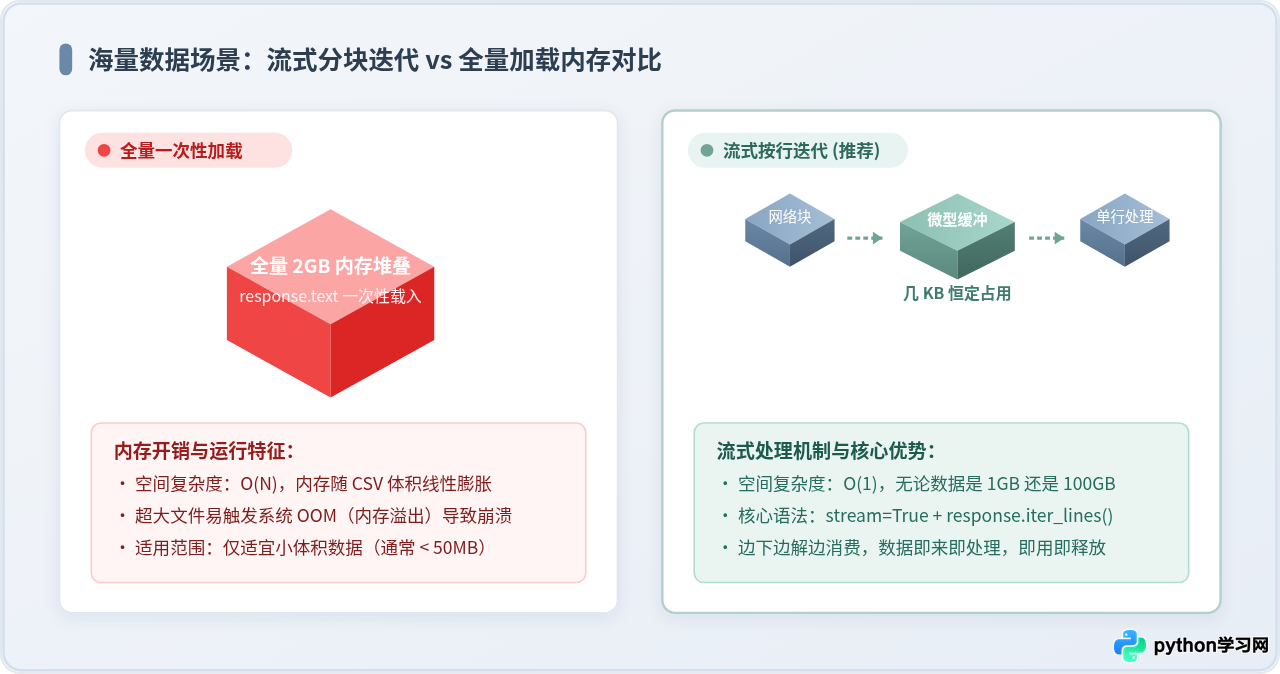
上述两种方法对于体积在数兆字节(MB)以内的常规 CSV 文件非常高效,但如果面对的是数十万乃至上千万行、体积达到 500MB 甚至数 GB 的大型报表或开放数据集,直接读取 response.text 会将整个文件一次性堆积到 RAM 中。再加上后续 csv.reader 解构生成的 Python 字符串与字典对象,内存占用可能会达到原始文件体积的 3 到 5 倍,极易触发服务器系统的 OOM Killer 强制终止进程。
针对此类超大数据源,Python 提供了“边下载、边解块、边迭代”的流式(Streaming)管道方案:
- 在调用
requests.get()时开启stream=True参数。此时客户端仅获取 HTTP 响应头,并不立即下载响应正文。 - 使用
response.iter_lines(decode_unicode=True)生成器,按网络分块逐步接收数据并在遇到换行符时逐行产生(yield)字符串。 - 配合生成器管道,将每行数据实时交给解析逻辑处理或直接流式写入数据库,使得整个 Python 进程的内存开销始终被锁定在几个 KB 的恒定常数级区间(O(1) 空间复杂度)。
3. 流式按行直接解析完整代码
# -*- coding: utf-8 -*-
import requests
import csv
from typing import Iterator, Dict

def stream_parse_remote_csv(csv_url: str) -> Iterator[Dict[str, str]]:
    # stream=True 确保不会一次性下载全部内容到内存中
    with requests.get(csv_url, stream=True, timeout=60) as res:
        res.raise_for_status()

        # 构造生成器:过滤空白行并进行编码清洗
        def line_stream_generator():
            for raw_line in res.iter_lines(decode_unicode=True, delimiter="\n"):
                if raw_line: # 过滤心跳保持包或连续换行
                    yield raw_line

        stream_gen = line_stream_generator()

        # 读取第一行作为表头(DictReader 接收任何可迭代的行对象)
        dict_reader = csv.DictReader(stream_gen)

        for record_index, row_dict in enumerate(dict_reader, start=1):
            yield row_dict

            # 可以在迭代中直接执行业务操作,例如过滤、入库或统计
            # 内存中随时仅驻留当前这一行的数据对象

# 消费端演示
if __name__ == "__main__":
    huge_csv_url = "https://example.com/large_telemetry_2026.csv"
    processed_count = 0

    # 即使数据源有 5GB,遍历循环也绝不会发生内存溢出
    for item in stream_parse_remote_csv(huge_csv_url):
        processed_count += 1
        # 模拟流式写入数据库或按条件筛选
        if processed_count % 10000 == 0:
            print(f"已流式处理 {processed_count} 条数据...")
五、数据科学场景:Pandas 的一步直连解析
如果你所编写的脚本本身就依托在数据分析与机器学习技术栈(如已安装 pandas、numpy),那么 Python 的数据科学库实际上提供了极其简便的直连语法。
pandas.read_csv() 的参数 filepath_or_buffer 能够直接识别标准的 URL 协议(http://、https://、ftp://)。在底层,Pandas 会自动借助 Python 的网络库发起 GET 请求,将返回的流数据送入高性能 C 语言解析引擎构建 DataFrame。
4. Pandas 直连与带鉴权调用
import pandas as pd
import requests
import io

# 方式 A:无鉴权公开链接,一行代码直接读取
public_url = "https://example.com/data/market_stats.csv"
df_direct = pd.read_csv(public_url, encoding="utf-8")
print(df_direct.head())

# 方式 B:包含复杂鉴权(如 OAuth Token、自定义 Headers)时的最佳实践
protected_url = "https://api.example.com/v1/export/secure_report.csv"
headers = {"Authorization": "Bearer eyJhbGciOiJIUzI1NiIsInR5..."}

res = requests.get(protected_url, headers=headers, timeout=30)
res.raise_for_status()

# 结合 io.StringIO,无缝接入 Pandas
df_authenticated = pd.read_csv(io.StringIO(res.text))
print(df_authenticated.info())
DataFrame 时会为数值列和对象列预分配密集的内存空间,通常一个 200MB 的纯文本 CSV 载入为 DataFrame 后会占用 600MB ~ 1GB 的物理内存。因此,如果任务只是简单的数据清洗、字段提取或转发,优先使用轻量级 csv 模块;只有在后续需要进行复杂多维统计、透视表分析或矩阵计算时,才推荐使用 Pandas。
六、四种实现方案横向对比与技术选型
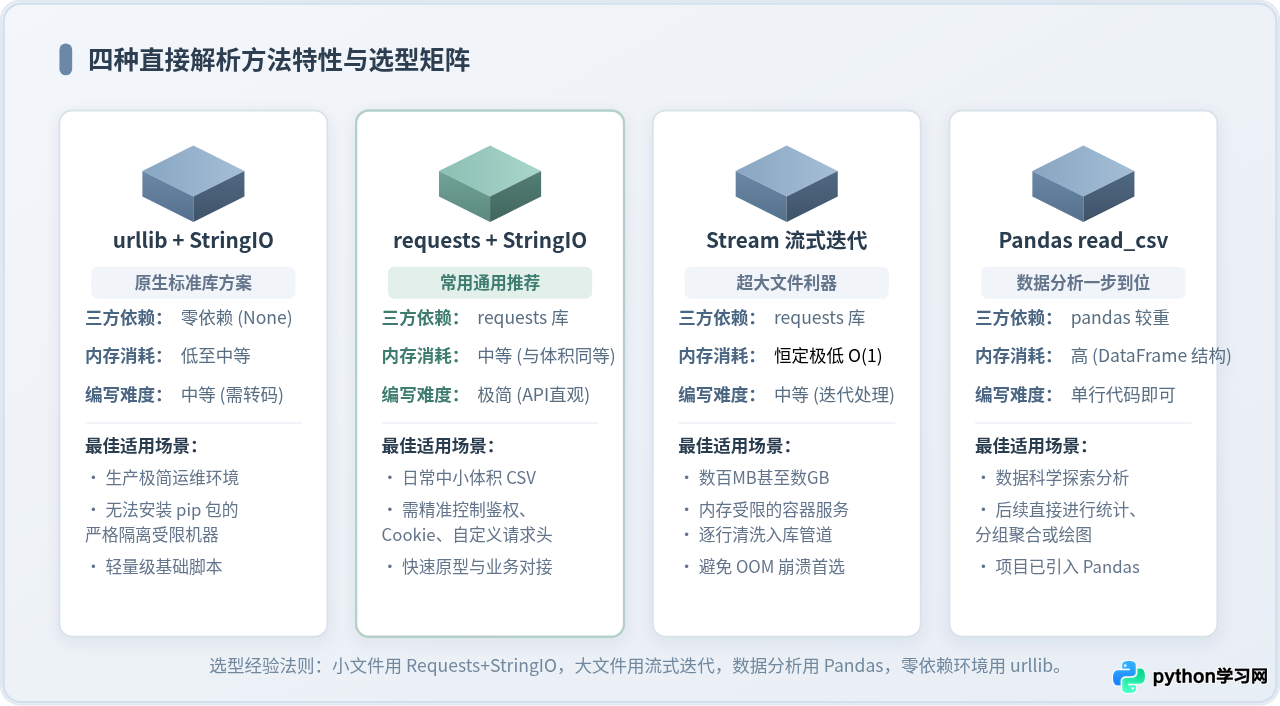
为了帮助读者在不同项目场景下快速决策,下表将本文介绍的四种“免落盘”解析方法进行了多维度对比:
| 方案名称 | 外部依赖 | 内存复杂度 | 代码简洁度 | 编码容错性 | 推荐使用场景 |
|---|---|---|---|---|---|
| urllib + io.StringIO | 完全无依赖 (内置) | O(N) (随体积) | 中等 (需手动转码) | 需手动调用 decode | 严格隔离机房、最小化基础镜像、无法使用 pip 的环境 |
| requests + io.StringIO | requests | O(N) (随体积) | 极高 (API 优雅) | 优异 (支持 utf-8-sig) | 大多数常规工程任务、中小体积 CSV、需要 Cookie/Header 鉴权 |
| requests(stream=True) | requests | O(1) (常数极低) | 中等 (生成器迭代) | 依赖 iter_lines 解码 | 数百 MB 至数 GB 超大文件、内存受限的容器节点、逐行入库 |
| pandas.read_csv(url) | pandas + numpy 等 | O(3N ~ 5N) | 单行直连 | 优异 (自动推断类型) | 数据科学探索分析、后续需要复杂的统计汇总与可视化运算 |
七、关键避坑点与生产注意事项
在不落地文件的内存直读实践中,网络与文本编码的变数往往比读取本地文件更多。以下梳理了四个最常见的生产踩坑点及对应的应对策略:
1. 响应状态码与非 CSV 内容陷阱
当请求的目标 URL 发生跳转、鉴权过期或触发了网站的防爬验证码机制时,服务器往往会返回 200 状态码,但返回的内容却是一段 HTML 错误页面(如 <html><body>403 Forbidden</body></html>)。如果此时未经判断直接传入 csv.reader,解析器不会抛出网络异常,而是将 HTML 标签当作合法的数据行进行解析,导致后续业务逻辑发生隐蔽的字段错乱。
应对方法:在将数据传入 StringIO 之前,务必检查响应头中的 Content-Type,或者先窥探前几个字符:
content_type = response.headers.get("Content-Type", "")
if "text/html" in content_type:
    raise ValueError(f"预期获取 CSV 数据,但服务器返回了 HTML 页面,内容前缀: {response.text[:100]}")
2. 分隔符(Delimiter)与方言(Dialect)差异
尽管后缀为 .csv,但许多欧洲地区或特定行业导出的表格实际上以分号(;)或制表符(\t,即 TSV)分隔,甚至包含带有换行符的字段(如用户评价正文)。
应对方法:可以使用 Python 标准库的 csv.Sniffer() 对前几千个字符进行自动探测,或在确认格式后显式指定 delimiter:
# 自动嗅探分隔符示例
sample_snippet = memory_file.read(2048)
memory_file.seek(0) # 务必重置内存流指针至开头

try:
    dialect = csv.Sniffer().sniff(sample_snippet)
    reader = csv.reader(memory_file, dialect)
except csv.Error:
    # 嗅探失败时回退至标准逗号分隔符
    memory_file.seek(0)
    reader = csv.reader(memory_file, delimiter=",")
3. SSL 证书校验与超时防护
某些内网自建系统或老旧机构网站的 HTTPS 证书可能已经过期,或者未配置完整的证书链。此外,由于不保存文件,整个解析过程受网络波动影响更敏感。
应对方法:严禁无超时请求!所有请求必须配置明确的 timeout=(connect_timeout, read_timeout),例如 timeout=(5, 30)。对于受信任的内部不可信证书环境,可通过配置 verify=False 并压制警告,但生产互联网环境应优先补充 CA 根证书。
八、总结
借助 Python 的类文件对象(File-like Object)协议与 io.StringIO / io.BytesIO 内存虚拟流,我们能够彻底摆脱“先下载保存到本地再打开”的繁琐流程。
对于常规数据处理任务,推荐采用 requests.get() 配合 response.encoding = "utf-8-sig" 与 io.StringIO 的经典组合,兼顾易用性与编码健壮性;面对数百兆以上的海量数据集,果断采用 stream=True 与 response.iter_lines() 进行常数级内存的流式消费;而在数据科学建模阶段,则可充分发挥 pandas.read_csv() 的一步直达能力。理解这些方法的底层流式本质,将帮助你在构建无盘化、高并发、云原生的数据管道时写出更健壮、更高效的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















