


学会Python能找什么工作:常见职业方向与岗位技能要求
深度解析学会Python能从事的常见职业方向与各岗位具体技能要求,涵盖Web后端、数据分析、自动化测试、爬虫采集及运维开发等主流领域,提供求职选择路径与工程化能力要求。
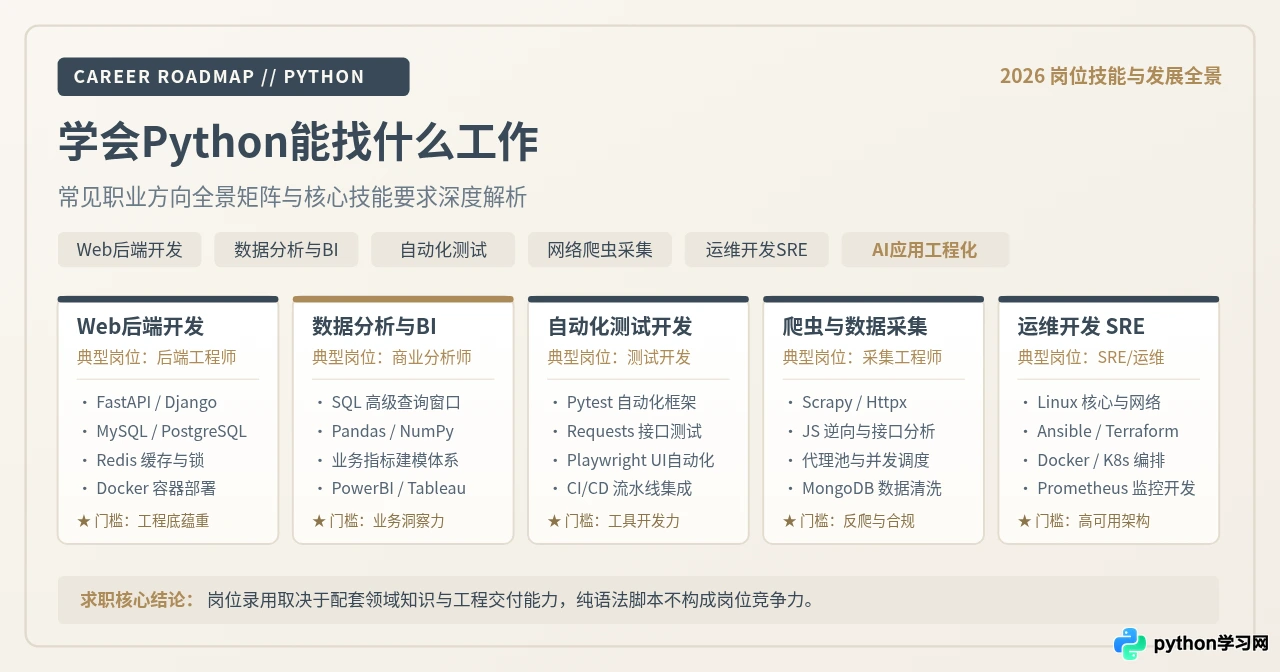
一、招聘市场对“Python”的真实定位与选择逻辑
初学者在求职时最常犯的一个认知错误,是将“Python”当成一项可以直接拿去应聘具体工作的独立职位。在真实的企业招聘中,除了少数科研机构或极其特殊的算法研发组之外,绝大多数公司并不存在笼统的“Python开发工程师”。企业实际发布的是“Web开发工程师(Python技术栈)”、“数据分析师(熟练使用Python/SQL)”、“自动化测试工程师”或“SRE运维平台开发”。
这就意味着,掌握Python的控制语句、函数定义和面向对象语法,仅仅是跨过了通用编程的初始门槛。真正决定简历能否通过初筛并顺利通过面试的,是围绕Python建立起来的“领域配套技能”。例如:同样是写Python代码,Web后端岗位考核的是SQL索引优化、Redis分布式缓存与异步API吞吐;而数据分析岗位考核的则是多表关联统计、业务指标拆解与商业决策报告。
因此,在开始系统投入精力学习之前,必须先根据个人的思维优势、专业背景以及当地人才市场的真实需求,完成职业方向的定位与筛选。
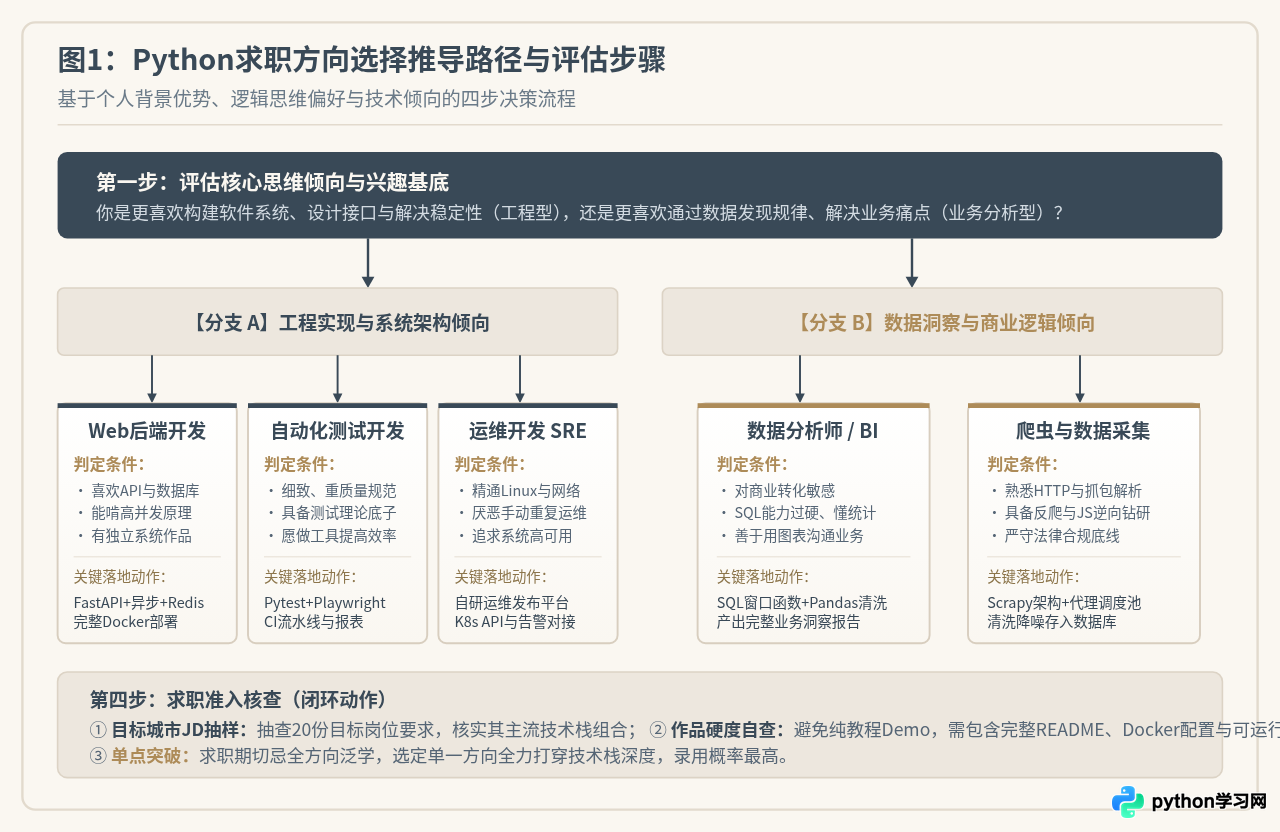
通过图1的四步决策推导流程,我们可以将学习者的初始背景与适合的岗位清晰对应:
- 如果你的核心优势在于逻辑构建与系统工程:应当优先考虑Web后端开发、自动化测试开发,或者运维开发。这些岗位更关注代码的模块化设计、系统的高并发处理能力以及持续集成与自动化流水线。
- 如果你的核心优势在于业务理解与数据敏感度:数据分析师与商业智能(BI)方向是切入点。在这个方向上,深刻理解业务逻辑、能用SQL和Pandas从海量数据中提炼出驱动商业增长的结论,其重要性远高于编写复杂的算法结构。
- 如果对底层协议与自动化脚本有钻研兴趣:爬虫与数据采集是一个实用切入点,但必须高度重视反爬技术升级与法律合规红线。
二、常见职业方向一:Python Web后端开发工程师
Python在Web服务端开发领域有着广泛的应用。由于开发效率高、生态组件成熟,大量中小型互联网产品、企业级后台管理系统(ERP/CRM/SaaS)、高并发微服务API,以及近年爆发的AI大模型应用服务层,均深度依赖Python后端栈。
【典型工作场景】
设计与实现业务系统的RESTful API或GraphQL接口;对接PostgreSQL/MySQL关系型数据库并进行ORM映射;通过Redis实现高频数据缓存与接口防刷;搭建异步任务队列(如Celery)处理耗时耗资源的后台作业;编写自动化单元测试并完成Docker容器化打包部署。
必备核心技能要求清单
- Python高级核心语法:深入掌握面向对象设计(OOP)、闭包与装饰器、生成器与上下文管理器,熟练理解GIL(全局解释器锁)的工作原理,并深入掌握
asyncio异步协程编程模型。 - 现代Web框架:主流推荐掌握FastAPI(凭借类型提示和基于Starlette/Pydantic的高性能异步能力,已成为现代API开发首选)或Django(适合功能庞大、包含完善Admin后台的企业级全栈系统)。
- 数据库与缓存:精通MySQL或PostgreSQL设计规范,掌握B+树索引优化、SQL执行计划(EXPLAIN)分析、事务隔离级别;熟练使用Redis实现缓存、分布式锁以及限流算法;掌握SQLAlchemy或Tortoise-ORM。
- 网络与接口工程:熟悉HTTP/HTTPS通信协议原理,掌握RESTful API设计规范、JWT(JSON Web Token)身份认证与权限鉴权机制、WebSocket长连接交互。
- 容器与部署工具:熟练编写Dockerfile,掌握基于Gunicorn/Uvicorn与Nginx的反向代理与进程管理,能够使用Git协作并完成基本的自动化构建。
三、常见职业方向二:数据分析师与商业智能(BI)工程师
数据分析是Python在非纯软件研发企业中需求量最大的领域之一。无论是电商、快消、泛金融,还是传统制造业,企业都需要通过数据监控业务运行健康度、定位转化瓶颈并制定营销策略。
【典型工作场景】
从企业数据仓库中提取核心业务流水;使用Pandas进行缺失值填充、脏数据过滤与多维透视聚合;构建用户流失预警模型或营销归因分析模型;设计并在FineBI、PowerBI或Tableau中搭建可视化实时监控看板;输出包含明确业务优化建议的分析复盘报告。
必备核心技能要求清单
- SQL(极其核心的基本盘):在数据分析岗位中,SQL的重要性往往甚至高于Python本身。必须精通复杂多表关联(LEFT/INNER/FULL JOIN)、子查询,尤其是窗口函数(
ROW_NUMBER()、RANK()、SUM() OVER(...))以及时间序列滑动计算。 - Python科学计算与分析库:精通Pandas(Series/DataFrame的高阶索引、分组聚合
groupby、透视表pivot_table、合并merge)、NumPy(多维数组向量化运算)。 - 数据探索与可视化:熟练运用Matplotlib、Seaborn或Plotly快速绘制箱线图、散点矩阵、热力图,识别异常值与数据分布特征。
- 统计学与实验设计:掌握描述性统计、假设检验(T检验、卡方检验)、置信区间、相关性分析,理解A/B测试的样本量计算(Power Analysis)与显著性评估方法。
- 商业理解与沟通表达:能够将业务部门抽象的痛点(如“用户留存下降”)转化为具体的数据指标体系,并在分析结束后向业务负责人清晰汇报。
四、常见职业方向三:自动化测试与测试开发工程师
随着软件工程迭代速度的加快与敏捷开发的普及,单纯依赖人工点击界面的手工功能测试(俗称“点点点测试”)岗位正在快速萎缩,而兼具测试质量思维与代码编写能力的“自动化测试工程师”和“测试开发工程师(SDET)”需求持续旺盛。
【典型工作场景】
编写接口自动化回归测试脚本并纳入代码提交流水线;利用Playwright/Selenium实现Web端与移动端核心业务主流程的端到端UI自动化;针对核心交易链路进行并发压力测试(Locust/JMeter);甚至利用Python开发内部专用的测试效能平台与Mock数据桩服务。
必备核心技能要求清单
- 软件测试理论基础:熟练掌握等价类划分、边界值分析、因果图、判定表等经典用例设计方法,具备敏锐的缺陷发现意识与测试链路规划能力。
- 自动化测试核心框架:深度掌握Pytest框架(包括但不限于
fixture前置后置依赖管理、parametrize参数化驱动、插件机制),配合Allure生成高质量的可视化测试报告。 - 接口与UI自动化工具链:精通使用Requests/Httpx进行HTTP接口断言与数据关联;熟练使用Playwright(比传统Selenium更轻量、运行更稳定、原生支持异步与网络拦截)进行前端UI测试;移动端自动化则需熟悉Appium。
- CI/CD持续集成流水线:掌握将测试套件整合进GitLab CI、Jenkins或GitHub Actions的方法,实现代码合并即自动触发全量回归测试并产出结果通知。
- 测试平台开发基础(针对测试开发):具备使用FastAPI/Flask快速开发轻量级测试配置管理后台、用例执行调度中心或Mock服务平台的能力。
五、常见职业方向四:网络爬虫与数据采集工程师
海量公开数据的获取是信息聚合、价格监控、舆情追踪以及当前大模型训练数据集构建的重要基石。Python以其强大的网络处理生态,在这个领域长期处于主导地位。
【典型工作场景】
采集行业垂直网站公开资讯与商品价格;抓取社交媒体公开舆情数据进行情绪分析;维护大规模分布式采集节点与IP代理池;分析并破解目标站点的反爬虫加密参数(签名、Token、混淆JS)。
必备核心技能要求清单
- 网络协议与数据分析抓包:精通HTTP/HTTPS协议细节、请求头指纹机制,熟练使用Chrome DevTools、Fiddler或Charles深入分析Ajax异步请求链与WebSocket长连接。
- 主流抓取与解析技术:熟练运用Scrapy框架(Spider、Middleware、Pipeline架构体系)、Requests/Httpx,熟练使用XPath、CSS选择器及BeautifulSoup提取结构化信息。
- 反爬对抗与逆向工程基础:掌握常见反爬策略的应对方案(User-Agent池、Cookie会话管理、动态IP代理池搭建与自动剔除失效节点);掌握基础的JavaScript逆向调试能力(断点分析、调用栈追踪、常见加密算法如MD5/AES/RSA识别);掌握基于Playwright/Selenium的无头浏览器拟真抓取与指纹混淆。
- 数据清洗与分布式调度:熟练运用MongoDB(存储半结构化数据)、MySQL或Redis实现爬虫任务队列分布式分发调度(如Scrapy-Redis)。
六、常见职业方向五:运维开发(DevOps / SRE)
在现代云原生架构下,传统依赖手工敲命令的运维方式早已无法满足成百上千台集群节点的协同管理需求。运维开发工程师(Site Reliability Engineer)利用Python将日常运维操作软件化、平台化。
【典型工作场景】
编写自动化集群巡检与配置分发脚本;开发企业内部CMDB(配置管理数据库)、多云资产调度系统与自动化持续发布平台;对接Prometheus与Grafana实现服务指标实时监控与故障自愈触发。
必备核心技能要求清单
- Linux底层与网络系统:深入掌握Linux操作系统原理、常用系统排查工具(top, iostat, netstat/ss, tcpdump)、Shell脚本编写,理解TCP/IP协议族与DNS解析链路。
- 基础设施自动化工具:掌握Ansible自动编排、Terraform基础设施即代码(IaC)工具的使用与Python API集成。
- 容器与云原生编排:深入理解Docker容器底层原理(Namespace, Cgroups),熟练掌握Kubernetes(K8s)日常运维,能够调用K8s Python Client进行集群资源动态管理。
- 运维管理平台研发:掌握使用FastAPI或Django开发资产配置系统(CMDB)、权限审计平台与发布流水线面板。
- 监控告警与故障排查:熟练对接Prometheus采集指标、编写自定义Exporter、配置Alertmanager告警联动与自动化恢复动作。
七、补充说明:人工智能(AI)与算法方向的真实定位
许多初学者因为“Python是AI首选语言”而开始学习,但必须对当前的就业市场保持清醒客观的认知:
- 算法研究与大模型预训练:这类岗位通常对学术背景要求极高(普遍要求重点高校硕士或博士学历,且有高水平学术论文或顶尖竞赛奖项)。初学者如果仅通过自学基础语法和几个开源库,几乎无法通过简历筛选。
- AI应用工程化与落地开发(切入点):这是当前普通开发者最适合切入的黄金赛道。随着大语言模型(LLM)API的普及,企业急需能够将大模型能力落实在实际业务中的工程师。具体包括:使用Python搭建企业知识库RAG(检索增强生成)系统、结合LangChain或LlamaIndex编排复杂业务Agent(智能体)、使用向量数据库(Chroma/Milvus/Qdrant)进行语义搜索,并利用FastAPI封装成高可用服务交付给前端。这一方向更看重工程落地能力,门槛远低于底层算法训练。
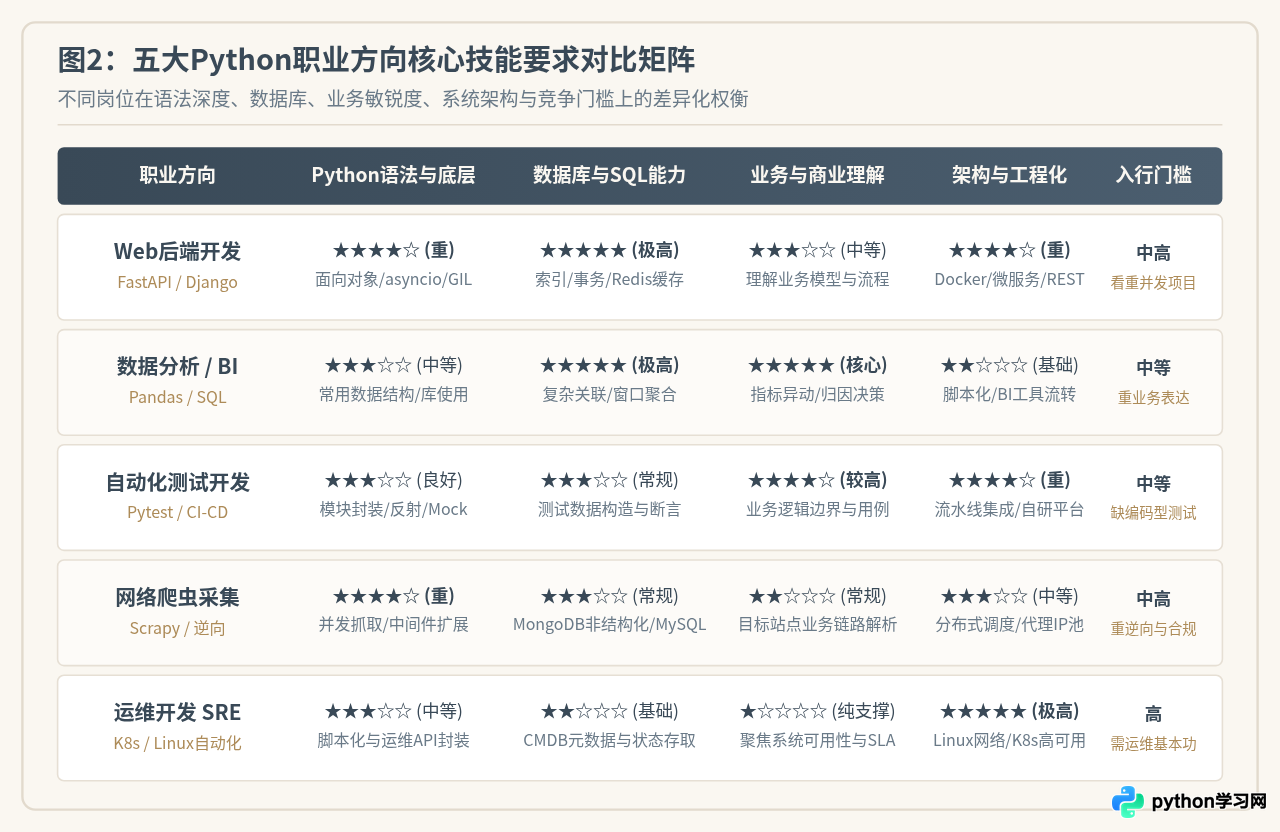
八、企业级Python工程化能力要求(超越单纯代码)
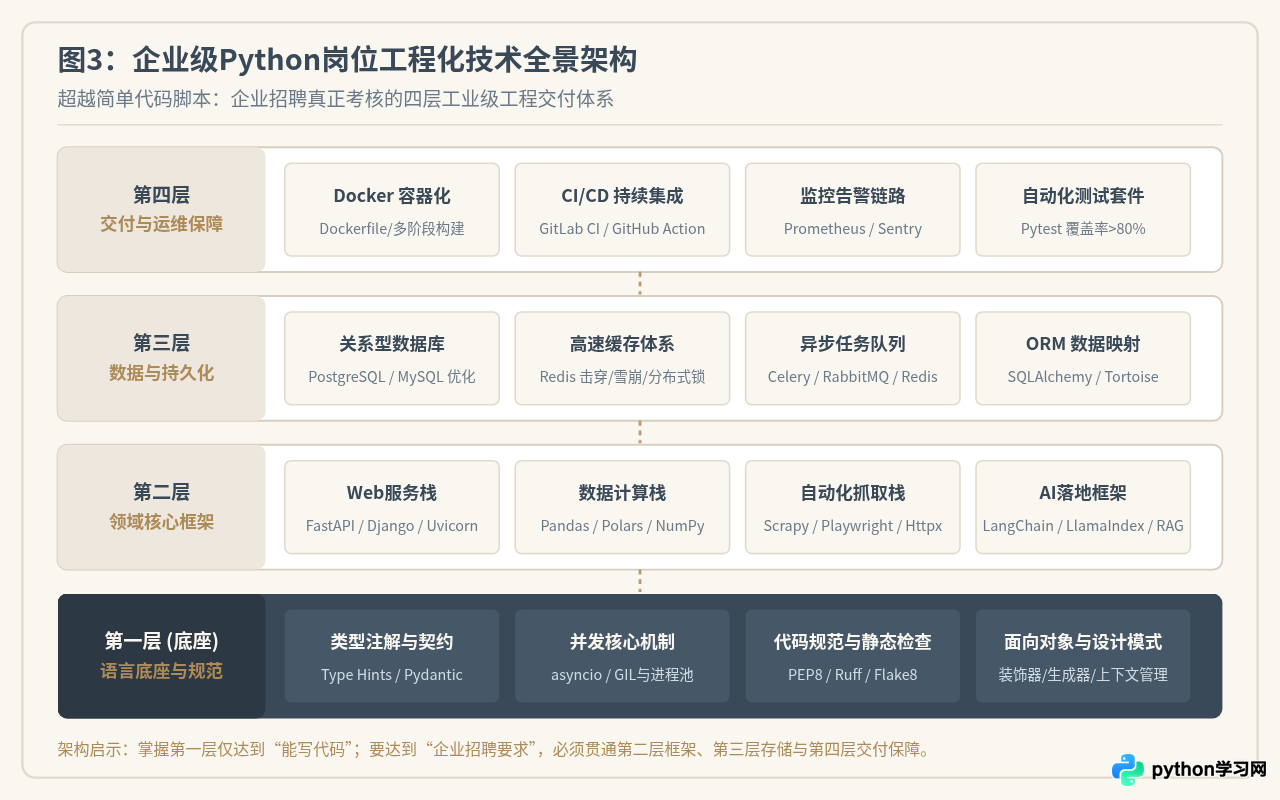
无论你选择上述哪一个方向,在招聘负责人眼中,衡量一名应聘者是“业余爱好者”还是“专业工程师”的标尺,始终是工业级工程化素养。很多初学者写出的代码只能在自己的电脑上勉强运行,一旦部署到生产环境,就面临缺乏类型校验、没有测试覆盖、配置混乱和无法定位错误的窘境。
下图展示了企业级岗位所要求的四层技术全景架构。掌握这四层体系,是让你的作品脱颖而出的核心保障:
在日常编写代码与准备项目作品时,应特别注意落实以下工程化规范:
- 全面的类型注解(Type Hints):在函数参数和返回值中全面使用类型标注,结合Pydantic进行入参自动校验,极大提升工程可读性与健壮性。
- 严格的代码风格与静态检查:遵循PEP8规范,在项目中引入Ruff或Black进行格式化,杜绝低级语法与风格缺陷。
- 完善的单元测试套件:为核心业务逻辑编写Pytest单元测试用例,覆盖率至少达到70%以上,并使用Mock隔离外部依赖。
- 标准化容器交付:为项目编写生产级
Dockerfile和docker-compose.yml,确保在任何服务器上都能通过一条命令拉起完整服务。
九、从技能习得到成功拿到Offer的四阶闭环路径
求职是一场以结果为导向的交付过程。很多学习者花费数月甚至整年时间重复学习基础语法,却迟迟不敢投递简历。高效的求职方法应当遵循分阶段目标明确的闭环推进策略:
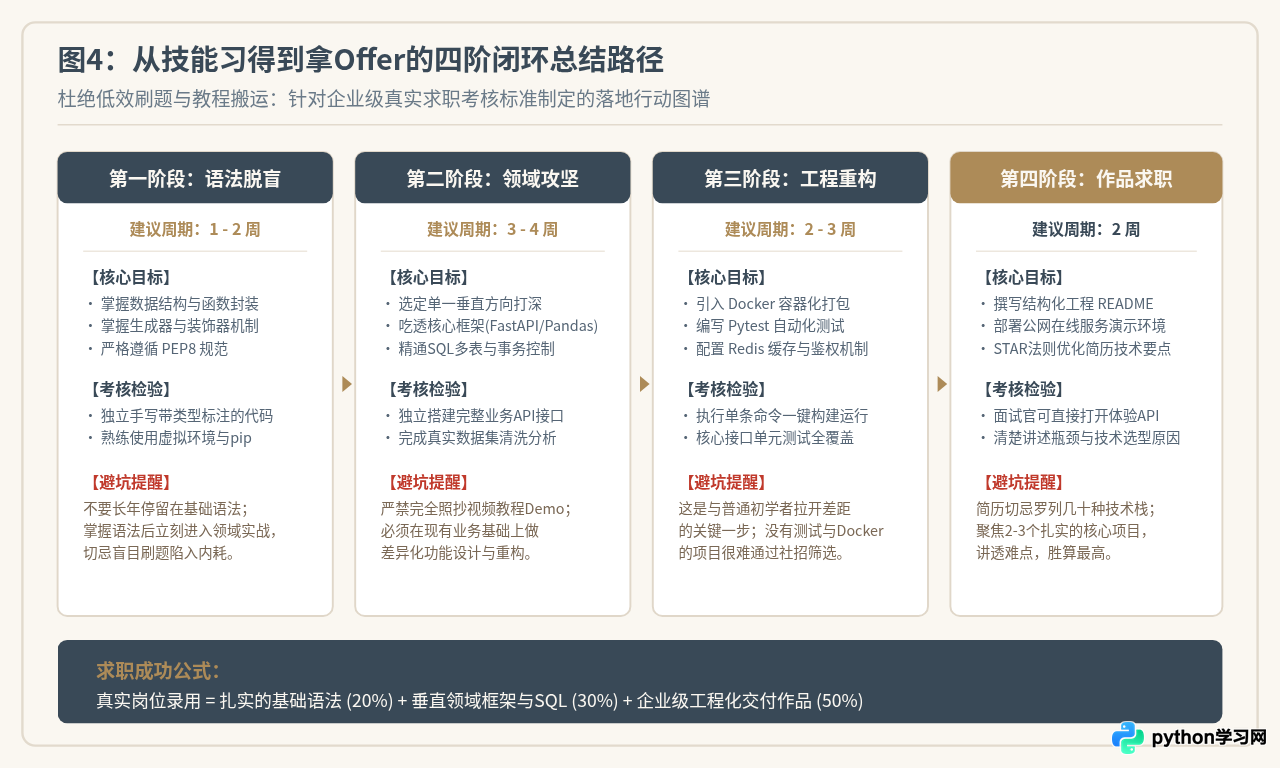
结合图4的总结路径,建议求职者在冲刺期做好以下准备:
- 第一阶段(语法脱盲):控制在1-2周内快速通关基本数据类型、循环与函数,切勿在此阶段停留过久,尽早进入实际框架实操。
- 第二阶段(垂直攻坚):锁定单一具体方向(例如FastAPI Web后端或Pandas数据分析),集中火力吃透核心API与底层原理,完成基础业务模块开发。
- 第三阶段(工程重构):将单纯的代码脚本重构为符合企业规范的工业级项目,补齐Docker容器配置、Pytest测试套件与Redis缓存优化。
- 第四阶段(作品交付与求职):为项目撰写结构清晰的README(包含架构图、接口文档链接、快速启动步骤与性能优化对比),将服务部署在云服务器上提供公网可访问的Demo,并用数据量化的STAR法则撰写简历技术点。
十、常见问题与求职答疑
Q1:如果不是计算机相关专业,转行学Python找工作还有机会吗?
有充分的机会,但策略必须选对。对于非计算机专业背景的求职者,数据分析师/商业智能(BI)以及自动化测试开发是成功率最高的两个方向。数据分析非常看重行业业务背景(如财务、统计、供应链或快消品运营背景),你过去的专业知识能转化为商业洞察优势;而测试开发则因为市场对具备代码能力的测试人员需求较大,竞争烈度相对后端开发要缓和得多。
Q2:找工作时,应该把Python所有方向都学一点,还是专精一个方向?
必须坚定地专精单一垂直方向。很多新手简历上既写了Django后端,又写了Pandas分析,还写了Scrapy爬虫和机器学习,但每一项都只停留在“调用API跑通教程”的皮毛水平。企业招聘需要的是能够立刻进入特定业务线解决具体问题的熟练人员,杂而不精的简历在第一轮筛选中往往最先被淘汰。集中80%的精力把一个方向的技术栈深度做透,才是最高效的求职策略。
Q3:求职作品集应该放在哪里?如何向面试官展示?
最佳的交付载体是GitHub / Gitee 仓库 + 公网在线体验地址。在简历中附上清晰的开源仓库链接,并在仓库首页提供架构拓扑图、技术选型说明以及Swagger/Postman接口文档。如果条件允许,花费少量成本租用云服务器将项目通过Docker容器运行起来,面试官在手机或电脑浏览器中直接点开就能体验真实响应,这比在简历上写“熟练掌握”具有高出数倍的信服力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















