


想转行数据分析或Web开发,Python学习侧重点有何不同?
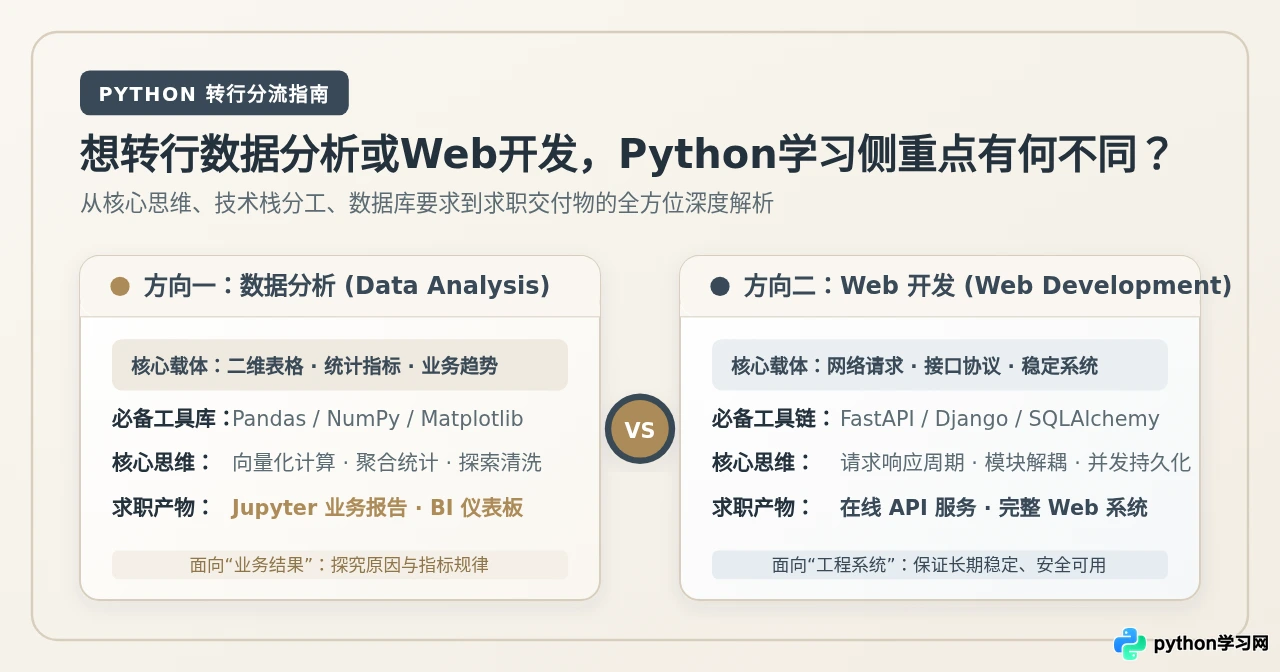
深度对比转行数据分析与Web开发的Python学习侧重点,涵盖公共语法基础的分流边界、核心技能栈、数据清洗与后端API实战代码范式、数据库要求及作品集准备策略。
一、公共基础的边界与能力分流点
初学者常误以为“数据分析的 Python”和“Web 开发的 Python”是两种完全不同的语言。在学习初期,两者共享同一套核心语法底座。无论走哪条路线,都必须掌握以下共同内容:
- 基础数据类型与容器:整数、浮点数、字符串、布尔值,以及列表(List)、字典(Dict)、集合(Set)与元组(Tuple)的操作方法;
- 程序逻辑控制:
if-elif-else条件判断,for与while循环,列表推导式; - 函数与模块化:形参与实参、默认参数、返回值、局部变量与全局作用域、
import第三方包机制; - 文件与异常保护:使用
with open()安全读写本地文件,使用try-except捕获标准异常。
掌握以上内容大约需要 2 到 4 周时间。一旦脱离这个基础阶段,两者的学习重心将发生本质分化。数据分析不再关注代码如何持续作为守护进程运行,而是把重点转移到内存中的向量化数据处理;Web 开发则迅速离开单次执行脚本,全面转向网络协议、请求生命周期与多模块协作设计。
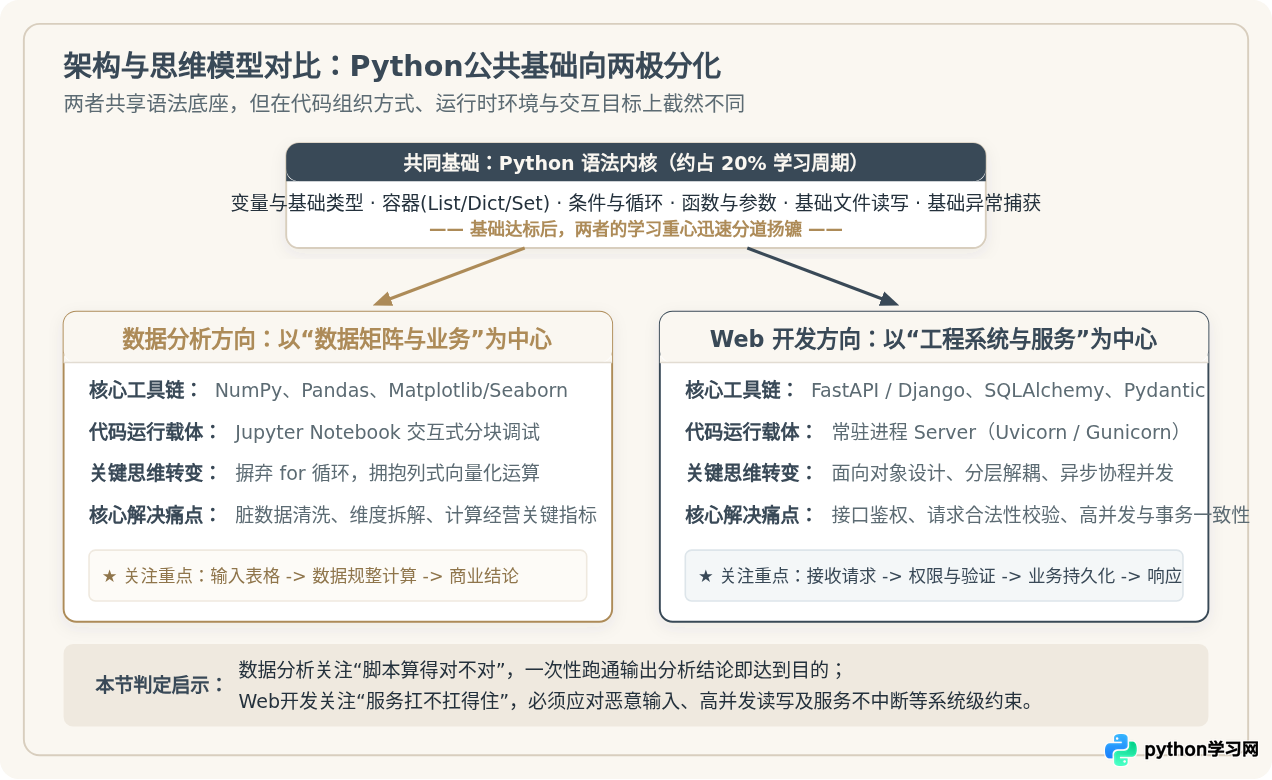
分流的关键判断标志体现在两者的日常编码习惯中:
- 代码运行载体:数据分析工程师 80% 的日常工作运行在 Jupyter Notebook 或 IPython 中,通过一个个独立单元格(Cell)实时查看中间输出;Web 开发工程师则使用 VS Code 或 PyCharm,编写完整的包目录结构,通过本地命令行启动常驻服务(如 Uvicorn)并使用接口调试工具(如 Postman、cURL)进行验证。
- 算法思维要求:数据分析关注数学统计、矩阵转置、概率分布与指标逻辑;Web 开发关注面向对象设计模式、模块解耦、异步协程(async/await)以及数据安全性。
二、数据分析方向的学习侧重点与实战处理流
转行数据分析的同学,Python 学习的绝对重心是 Pandas 与 NumPy,配合 Matplotlib / Seaborn 完成可视化呈现。真实商业环境中很少有一尘不染的规范数据,转行者必须掌握完整的“数据清洗与指标重塑”工作流。
1. 核心思维:向量化与避免循环
在纯 Python 中,处理列表常用 for 循环逐项处理;但在 Pandas 中,逐行遍历(如 iterrows)会导致性能急剧下降。数据分析必须建立“整列计算”的向量化思维:
df['net_sales'] = df['gross_sales'] - df['discount'],让底层由 C 编写的 NumPy 引擎并行计算,严禁编写 for i in range(len(df))。
2. 真实场景数据清洗与聚合实战示例
以下示例模拟了一段典型的电商多渠道订单数据清洗与聚合任务。任务目标是:读取原始明细、修复缺失值与日期类型、计算退款率与有效客单价,并按推广渠道输出经营指标摘要。
import pandas as pd
import numpy as np

# 1. 模拟原始多渠道交易数据(包含空值、异常格式)
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005, 1006],
    "channel": ["搜索投放", "信息流", "搜索投放", "私域社群", "信息流", "私域社群"],
    "order_time": ["2026-03-01 10:15", "2026-03-01 11:00", "2026-03-02 09:30",
                    "2026-03-02 14:20", "2026-03-03 16:45", "2026-03-03 18:10"],
    "amount": [299.0, np.nan, 150.0, 480.0, 320.0, 99.0],
    "is_refunded": [0, 0, 1, 0, 0, 1]
}

df = pd.DataFrame(raw_data)

# 2. 数据清洗与格式统一
# 处理缺失金额:用该渠道中位数填补(此处为示例,先用全局中位数)
df["amount"] = df["amount"].fillna(df["amount"].median())

# 转换时间戳为日期格式,便于时间维度分析
df["order_date"] = pd.to_datetime(df["order_time"]).dt.date

# 3. 多维指标聚合计算 (groupby + agg)
channel_summary = df.groupby("channel").agg(
    total_orders=("order_id", "count"),
    total_revenue=("amount", "sum"),
    avg_order_value=("amount", "mean"),
    refund_count=("is_refunded", "sum")
).reset_index()

# 4. 派生关键业务指标:退款率与实际毛营收
channel_summary["refund_rate"] = (
    channel_summary["refund_count"] / channel_summary["total_orders"]
).round(4)

channel_summary["net_revenue"] = (
    channel_summary["total_revenue"] * (1 - channel_summary["refund_rate"])
).round(2)

print("=== 各渠道经营分析摘要表 ===")
print(channel_summary[["channel", "total_orders", "avg_order_value", "refund_rate", "net_revenue"]])
$ python3 data_pipeline_demo.py
=== 各渠道经营分析摘要表 ===
    channel  total_orders  avg_order_value  refund_rate  net_revenue
0    信息流             2            309.5          0.0        619.0
1  搜索投放             2            224.5          0.5        224.5
2  私域社群             2            289.5          0.5        289.5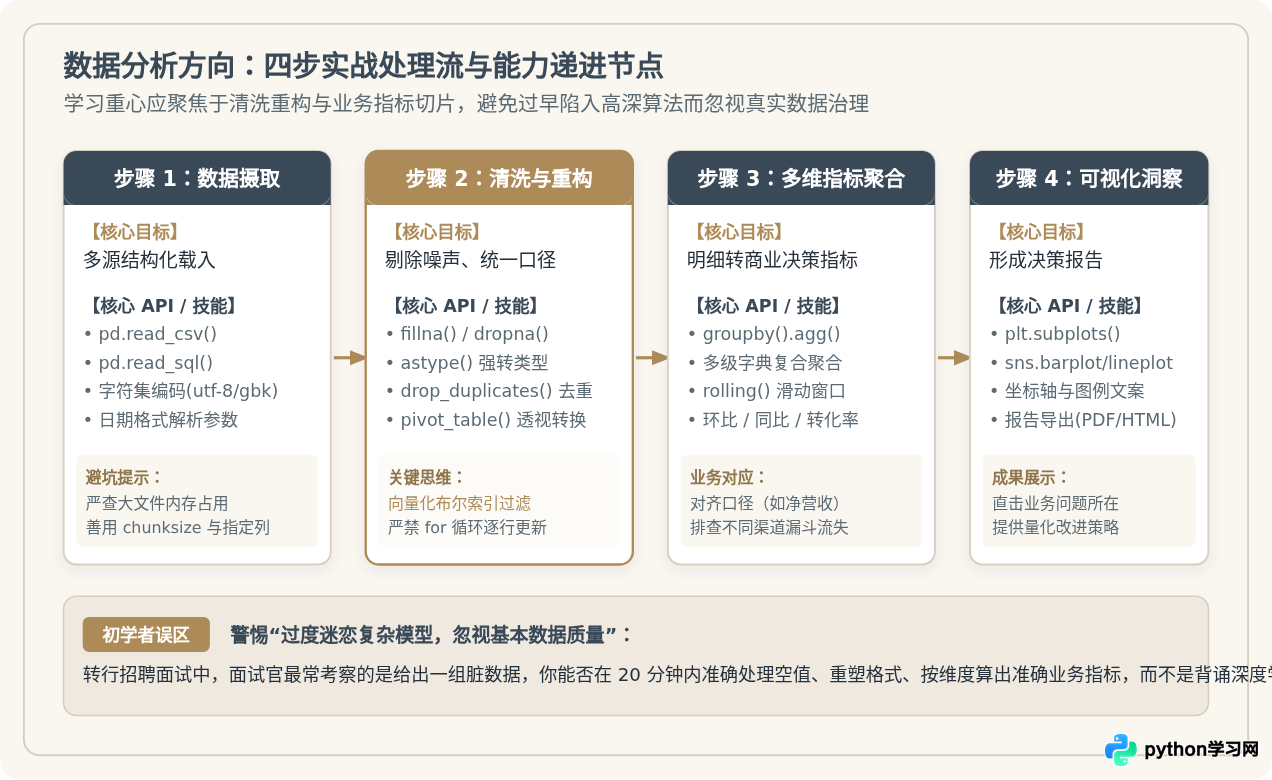
从上述处理流中可以看出,数据分析学习的核心瓶颈不在于算法推导,而在于对 groupby、pivot_table、merge、fillna 等操作的灵活组合。在求职面试中,雇主更关注你是否能迅速清洗一份含有脏数据的 CSV,并准确计算出业务所需的留存率、复购率与渠道 ROI。
三、Web 开发方向的学习侧重点与系统化构建
转行 Web 开发的同学,学习重点是构建一个高可用、安全、持续对外提供服务的网络工程。核心技术栈通常围绕现代化框架(如 FastAPI 或企业级 Django)、对象关系映射(SQLAlchemy 或 Django ORM)、数据验证(Pydantic)及异步并发编程。
1. 核心思维:请求生命周期与状态解耦
与数据分析脚本“按顺序执行到底”不同,Web 应用是一个常驻死循环服务。它随时可能收到来自世界各地不同用户的并发 HTTP 请求:
- 无状态性(Stateless):服务本身不存储会话数据,用户身份通过 Header 中的 JWT Token 鉴权,使系统可以横向扩展;
- 严格校验防崩边界:不能假设客户端传入的数据是合法的。恶意的负数金额、SQL 注入字符串、缺失字段必须在路由层就被 Pydantic 拦截,绝不能将异常抛到后端崩溃;
- 数据库事务原子性:在扣减库存和生成订单时,必须处于同一个数据库事务内,确保要么全部成功,要么全部回滚。
2. 现代化后端 API 实战代码示例
以下示例展示了一个基于 FastAPI + Pydantic 的订单创建接口。包含了输入校验、业务规则判定、HTTP 状态码规范与结构化错误响应:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional
from datetime import datetime

app = FastAPI(title="订单服务系统", version="1.0.0")

# 1. 定义数据输入校验模式 (Pydantic Schema)
class OrderCreateRequest(BaseModel):
    item_id: int = Field(gt=0, description="商品ID必须大于0")
    quantity: int = Field(gt=0, le=100, description="购买数量介于 1 到 100 之间")
    promo_code: Optional[str] = Field(None, max_length=10, description="优惠码")

# 2. 定义数据输出响应模式
class OrderResponse(BaseModel):
    order_id: int
    item_id: int
    quantity: int
    total_price: float
    created_at: datetime
    status: str

# 模拟内存数据库与商品库存表
INVENTORY_DB = {101: {"price": 99.0, "stock": 10}, 102: {"price": 199.0, "stock": 0}}
ORDER_COUNTER = 5000

# 3. 编写业务路由控制器
@app.post("/api/orders", response_model=OrderResponse, status_code=status.HTTP_201_CREATED)
async def create_order(payload: OrderCreateRequest):
    global ORDER_COUNTER

    # 业务校验:商品是否存在
    item = INVENTORY_DB.get(payload.item_id)
    if not item:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail=f"商品 ID {payload.item_id} 不存在"
        )

    # 业务校验:库存是否充足
    if item["stock"] < payload.quantity:
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail=f"商品库存不足,当前剩余 {item['stock']}"
        )

    # 扣减库存并生成订单
    item["stock"] -= payload.quantity
    ORDER_COUNTER += 1
    total = item["price"] * payload.quantity

    return OrderResponse(
        order_id=ORDER_COUNTER,
        item_id=payload.item_id,
        quantity=payload.quantity,
        total_price=total,
        created_at=datetime.now(),
        status="PAID"
    )
# 启动本地开发服务:
$ uvicorn api_server_demo:app --host 127.0.0.1 --port 8000
INFO:     Started server process [85912]
INFO:     Application startup complete. Uvicorn running on http://127.0.0.1:8000

# 模拟客户端发送下单请求:
$ curl -X POST "http://127.0.0.1:8000/api/orders"        -H "Content-Type: application/json"        -d '{"item_id": 101, "quantity": 2}'

# HTTP 响应结果:
{"order_id":5001,"item_id":101,"quantity":2,"total_price":198.0,"created_at":"2026-03-31T14:10:00.123456","status":"PAID"}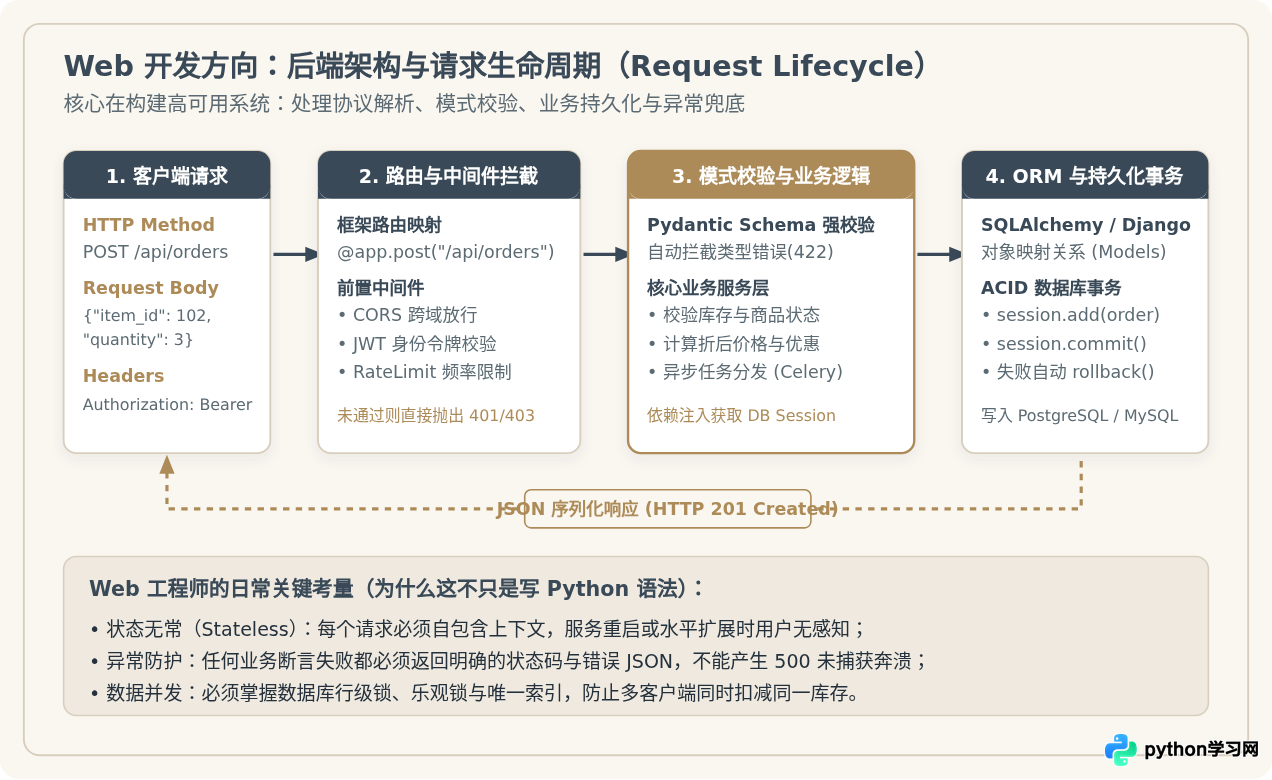
Web 开发学习的深水区在于:如何管理数据库连接池、如何编写 Alembic 迁移脚本、如何使用 Redis 处理接口缓存、如何编写自动化测试用例(pytest)保证重构时不破坏已有逻辑。
四、数据库与工程交付物的决定性差异
无论数据分析还是 Web 开发,数据库都是绕不开的核心基石。但初学者往往忽视了:两个方向对数据库的考察完全是两个维度。
| 对比维度 | 数据分析方向 (Data Analysis) | Web 开发方向 (Web Development) |
|---|---|---|
| SQL 使用重点 | 重“读”:多表多层 JOIN、窗口函数(ROW_NUMBER, DENSE_RANK)、复杂的 GROUP BY 聚合指标分析。 | 重“结构与一致性”:表关系设计(1对多、多对多)、外键、主键唯一索引优化、事务(ACID)、锁机制。 |
| 数据操作工具 | 原生 SQL 客户端(DBeaver、Navicat)或 pd.read_sql 批量读入内存。 |
对象关系映射(ORM,如 SQLAlchemy、Django ORM),通过面向对象语法映射数据库表。 |
| 代码组织形态 | 按项目划分的 Jupyter Notebook,或独立的定时调度清洗脚本。 | 分层工程架构(Routes、Schemas、CRUD、Services、Models),遵循 Git 版本管理与分支规范。 |
| 求职简历交付物 | 深度业务分析研报(PDF/HTML)、数据看板(Tableau/FineBI)、带有清洗逻辑的 Notebook 作品集。 | 部署在公网服务器上可调用的 RESTful API 接口、在线 Swagger 接口文档、GitHub 开源仓库与单元测试。 |
.ipynb 笔记,面试官会认为你缺乏最基本的系统开发与工程部署常识。
五、转行决策矩阵与阶段规划建议
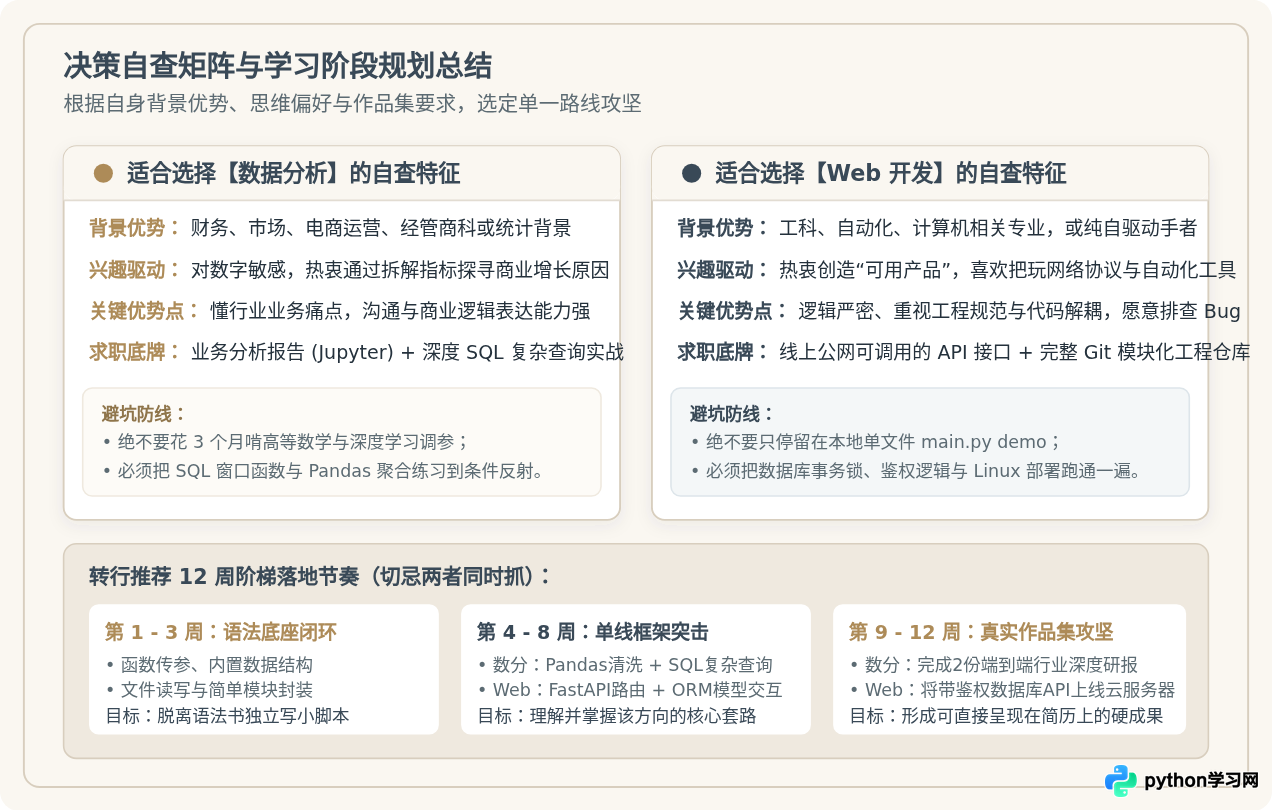
转行不是看哪个概念“更热门”,而是看你过去的专业积累能为哪条路线提供杠杆:
- 适合选择数据分析:如果你此前从事财务、市场营销、电商运营、供应链或经管类专业,你最大的护城河是对业务常识的敏感度。技术是辅助你提炼商业价值的放大器,Python 与 SQL 能让你快速替代低效的 Excel 手工作业,直击业务决策核心。
- 适合选择 Web 开发:如果你理工科逻辑清晰,喜欢动手拼装自动化脚本、对底层网络通信(HTTP/WebSocket)、服务器部署、用户鉴权与完整产品实现有探索欲,Web 开发能提供即时可见的“造物成就感”。
高效转行的 12 周执行原则
- 前 3 周统一打牢底座:专注 Python 内置容器、控制流、函数传参及基本文件 IO,不急于选方向。每天动手写至少 50 行基础代码,克服对命令行的陌生感。
- 第 4 到 8 周绝不“两头抓”:明确方向后,坚决只学专属核心库。数据分析专攻 Pandas + SQL,练习 50 道复杂 SQL 题;Web 开发专攻 FastAPI + SQLAlchemy,掌握 CRUD 与数据验证。
- 最后 4 周只为“交付物”负责:抛开零碎的课后作业,数据分析必须完成 2 篇针对具体行业的完整数据分析报告;Web 开发必须买一台入门轻量云服务器,把编写的 API 服务连同数据库真实部署上线,并在简历中附带在线测试地址与 GitHub 链接。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















