


Python预测模型准确率低?特征工程与参数调优技巧
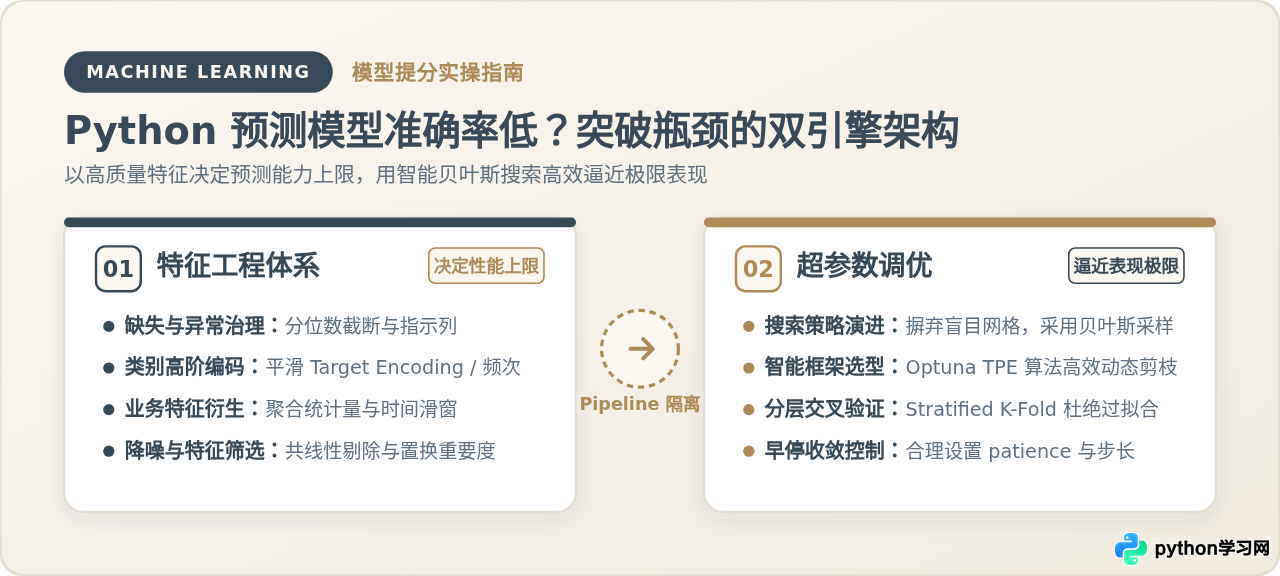
深入解析Python预测模型准确率低的核心原因,提供涵盖缺失异常治理、高阶类别编码、特征衍生与去噪筛选的特征工程体系,以及基于Optuna与交叉验证的贝叶斯超参数调优实操技巧。
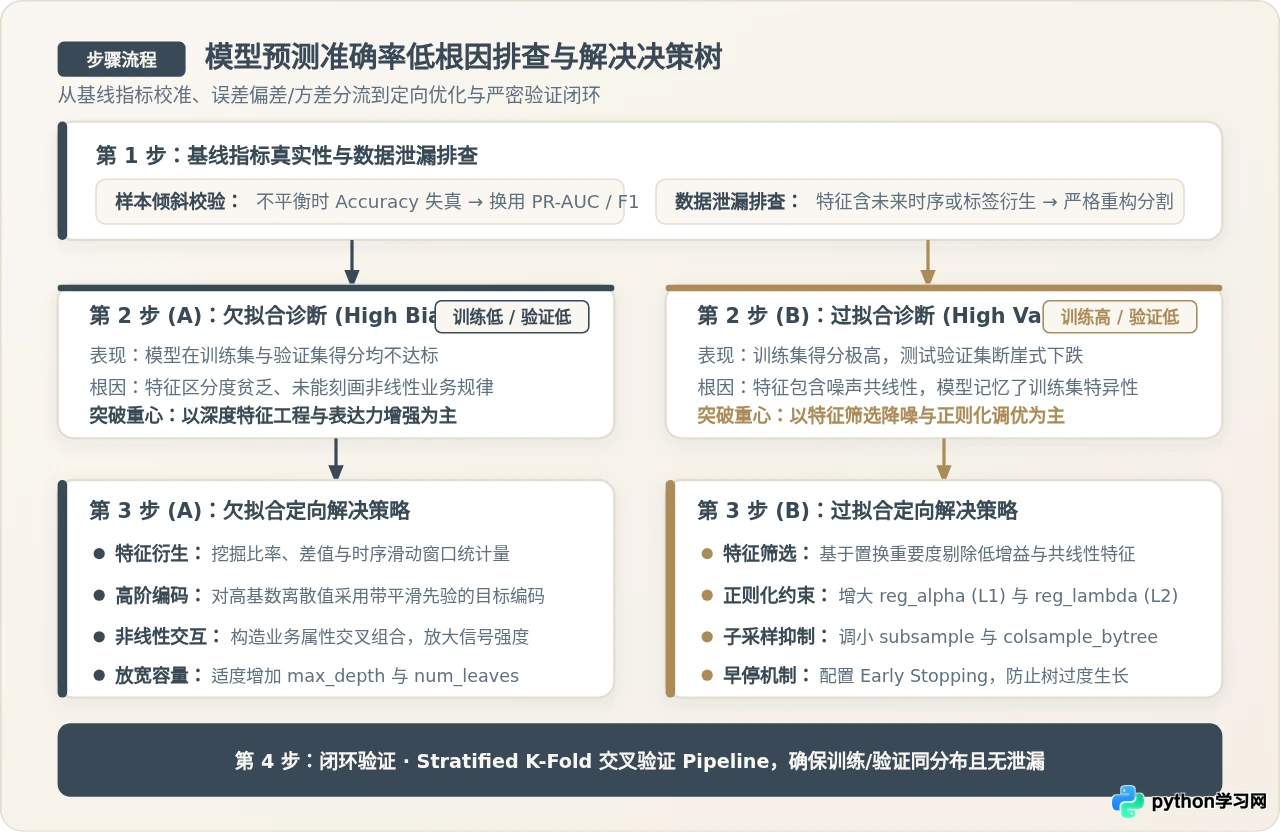
一、准确率低在哪里?三步建立诊断基准
当测试集准确率未达预期时,切忌在没有定量分析的情况下直接“盲调”代码。首先需要明确模型到底在哪个环节出现了性能损耗。完整的排查逻辑包含以下三个核心步骤:
1. 区分“欠拟合”与“过拟合”:查看训练集与验证集的得分差距
模型在不同数据集上的得分表现,能最直接揭示问题的本质属性:
- 欠拟合(高偏差 High Bias):训练集得分偏低(如准确率仅 65%),验证集得分同样偏低(如 63%)。这说明模型连训练数据中的规律都没有学全。此时换用复杂调参毫无意义,主要症结在于输入特征的区分度贫乏,或者特征与预测目标之间缺乏足够的数学关联。
- 过拟合(高方差 High Variance):训练集得分极高(如 98%),而验证集得分发生断崖式下跌(如 68%)。这说明模型强行记住了训练样本的特异性与噪声,丧失了泛化能力。此时的突破方向是特征降噪去冗、增强正则化惩罚、以及调小模型容量。
2. 警惕“指标失真”:样本不平衡下的准确率陷阱
在分类预测任务中,如果直接使用 accuracy_score(准确率)作为核心指标,经常会出现严重的误导。以反欺诈或设备故障预测为例:正负样本比例常达到 99:1。如果模型将所有样本全部分类为“正常(负样本)”,表面上的准确率高达 99%,但真正需要拦截的欺诈样本召回率(Recall)实则为 0。
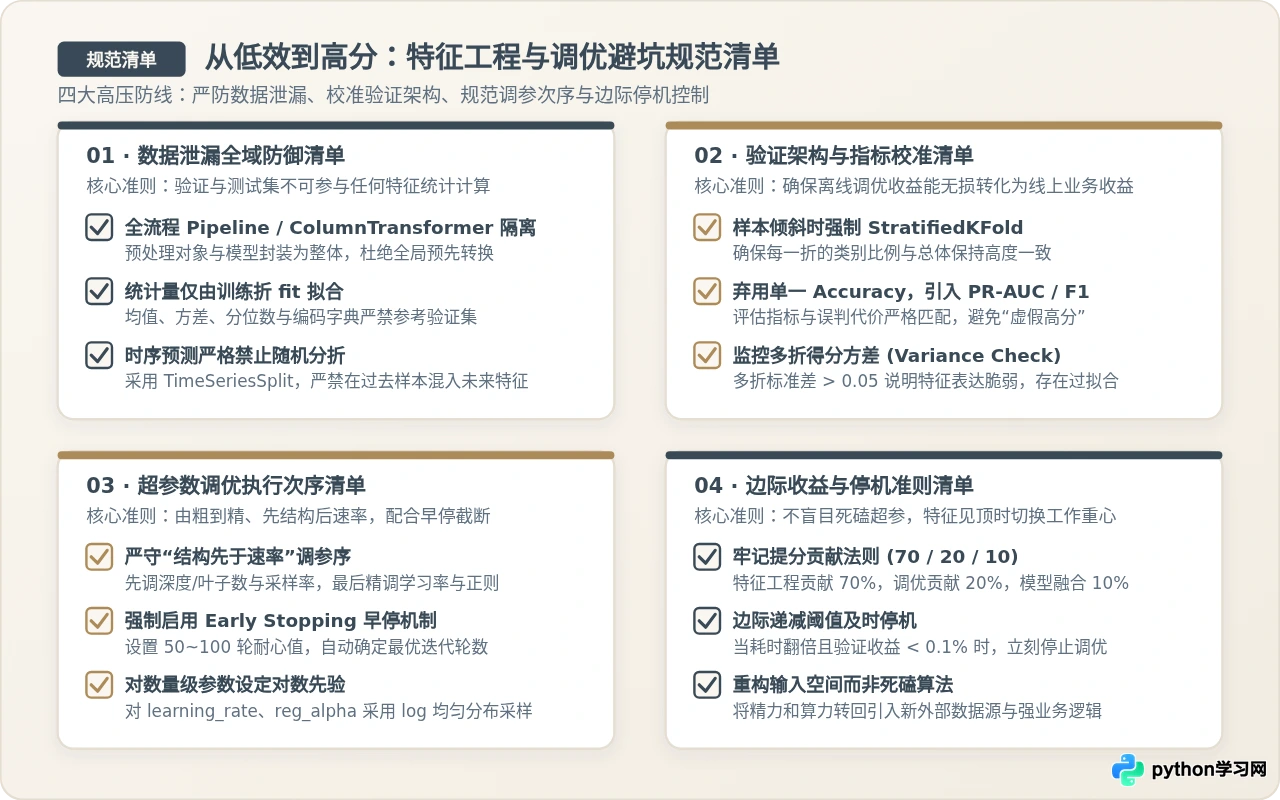
在样本比例倾斜超过 8:2 的场景下,必须将评估指标切换为 PR-AUC(精确率-召回率曲线下面积)、ROC-AUC 或 Macro/Weighted F1-score。只有当评估尺子准确反映了业务损失时,后续的调优才有实质价值。
3. 排除隐形杀手:数据泄漏(Data Leakage)的全面排查
有时候模型在本地交叉验证中得分虚高,但一上线或换到新测试集上准确率就骤降,这大概率是触碰了数据泄漏。典型泄漏场景有两种:
- 目标泄漏(Target Leakage):特征中混入了本该在预测时点之后才发生的信息。例如预测“用户是否会流失”,特征里却包含了“用户注销账号后的退款流水”,模型会学到这种虚假捷径。
-
预处理阶段全局转换泄漏:在划分
train_test_split或交叉验证切折之前,直接对全量数据调用了fit_transform()。此时验证集甚至测试集的均值、方差、分位数或目标均值已被输入给模型,造成评估指标虚假偏高。
二、决定表现上限:高阶特征工程提分技法
当基线诊断确认了误差来源后,最能带来实质提分效果的工作就是特征工程。高质量的特征工程不是漫无目的的数据清洗,而是有组织的信息重构与提炼。
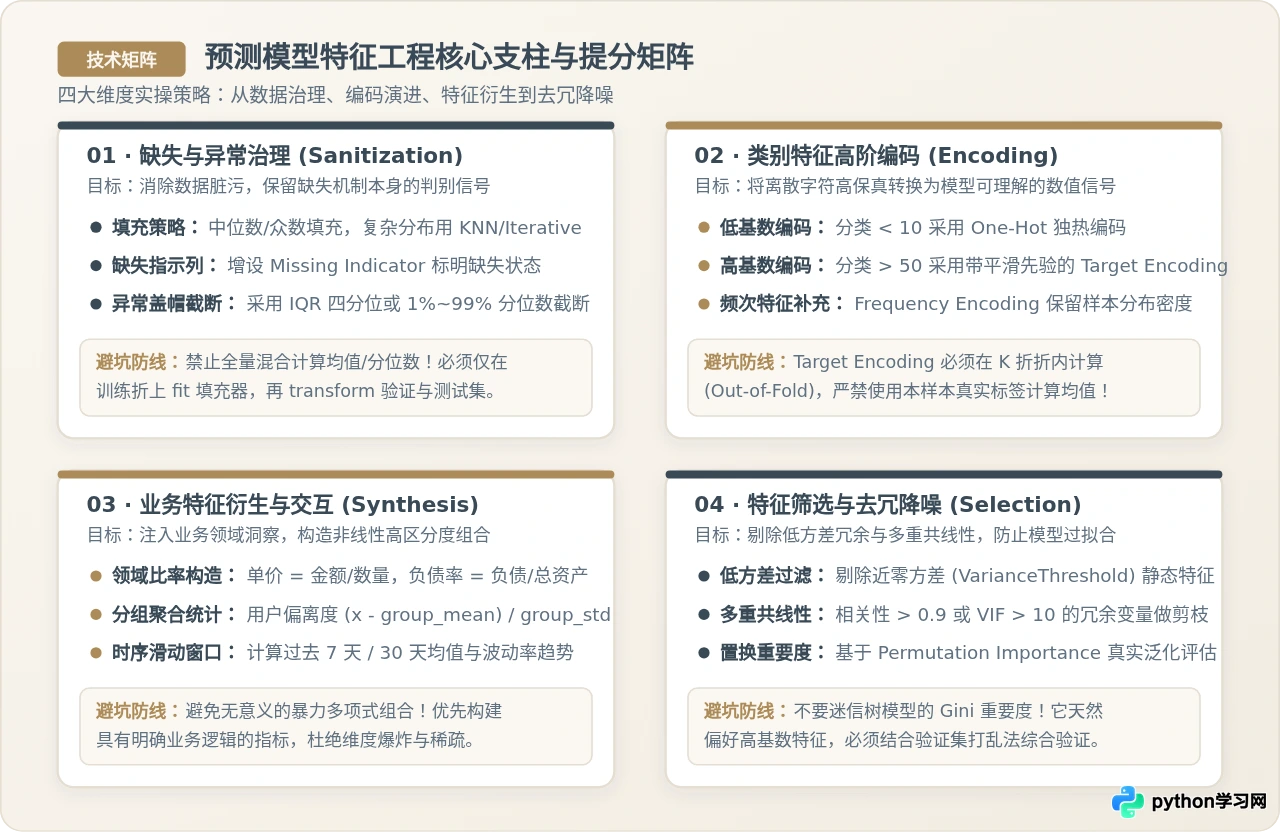
1. 缺失值与异常值的精细化治理
常见的做法是用均值或众数把 NaN 填满,但这往往掩盖了关键信息。在实际工业数据中,“数据为什么缺失”本身就是极具价值的分类信号。例如在信贷审批中,未填写“备用联系人收入”的用户往往违约概率显著更高。
-
双轨填充 + 缺失指示器:对于数值特征,在填充中位数(以抵抗极端异常值干扰)的同时,使用
MissingIndicator生成一列布尔特征is_missing_feature,将缺失信息显式呈现给模型。 - 盖帽法(Winsorization)治理离群点:对长尾分布特征不宜直接剔除样本,而应依据训练集的 IQR(四分位距)或 1% 与 99% 分位数进行边界截断(Clip),防止个别离群极值破坏线性权重或树节点的划分标准。
2. 类别特征的高阶编码技巧
类别特征的处理直接影响输入矩阵的维度与稠密度:
-
低基数类别(类别数 < 10):推荐使用
OneHotEncoder(handle_unknown='ignore'),结构清晰且不会破坏线性可分性。 - 高基数类别(类别数 > 50,如商品SKU、省市区、行业代码):严禁直接 One-Hot,否则会生成成千上万列稀疏特征,带来严重的维度灾难。此时应当采用目标编码(Target Encoding),即用每个类别对应的目标值均值来替代类别标签。
如果直接用全量数据计算类别均值,样本量极小的类别(如只出现一次且违约)会被赋予 1.0 的极端目标值,导致极度过拟合。工业级实现必须引入平滑先验权重(Smoothed Target Encoding),并且必须通过 Out-of-Fold(折内隔离)方式进行映射计算,绝不能让当前样本标签参与自身均值的计算。
3. 业务强相关的特征衍生与时序滑窗
单特征的预测能力往往有限,而基于业务常识的组合衍生能够直接构造出非线性强区分度指标:
-
业务比率与差值衍生:例如在风控中使用
负债比率 = 总负债 / 年收入;在电商转化预测中使用加购转化率 = 下单次数 / 浏览次数、平均客单价 = 累计消费 / 订单总量。 -
GroupBy 分组聚合偏差:计算个体与其所属群体的相对偏离程度。例如某个用户的消费金额减去同城市同年龄段用户的平均消费金额:
user_deviation = amount - group_mean(amount)。 - 时序行为滑动窗口(Rolling Stats):对用户历史行为提取最近 7 天、30 天的滑动均值、最大值和标准差,捕捉行为突变趋势(如突然异常高频转账)。
4. 特征去噪与筛选:剔除冗余与多重共线性
并不是特征越多模型效果就越好。输入过多与目标无关的弱特征或高相关特征,会增加模型的学习难度,降低泛化能力:
-
方差过滤:使用
VarianceThreshold剔除方差极低(如 99% 以上样本取值完全相同)的准常量特征。 - 多重共线性消除:当两列数值特征的 Pearson 相关系数大于 0.9 时,树模型可能会随机分裂其中一列,稀释特征重要度;线性模型则会导致权重剧烈震荡。此时应依据与预测目标的相关性强弱,保留其中一列即可。
-
置换重要度(Permutation Importance):树模型自带的
feature_importances_基于不纯度减少量(Gini/Gain),天然对高基数连续变量有偏好偏差。在独立的验证集上运行permutation_importance,通过随机打乱某一列的值来观察模型得分下降幅度,才是衡量特征真实泛化贡献的可靠方式。
5. 实操代码:构建防泄漏的特征工程 Pipeline
下面的 Python 代码演示了如何使用 Scikit-Learn 的 ColumnTransformer 与 Pipeline,将缺失值填充、缺失指示、数值标准化与类别编码无缝组合,确保整个特征转换过程严格隔离在训练折内:
import numpy as np
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer, MissingIndicator
from sklearn.preprocessing import StandardScaler, OneHotEncoder, TargetEncoder
from sklearn.feature_selection import VarianceThreshold
from sklearn.model_selection import StratifiedKFold, cross_val_score
import lightgbm as lgb

# 1. 明确区分不同特征类型列表
numeric_cols = ["age", "income", "loan_amount", "debt_ratio"]
low_cardinality_cols = ["gender", "education_level"]
high_cardinality_cols = ["city_code", "industry_type"]

# 2. 数值流水线:中位数填充 + 自动附加缺失指示列 + 标准化缩放
num_pipeline = Pipeline(steps=[
    ("imputer", SimpleImputer(strategy="median", add_indicator=True)),
    ("variance_selector", VarianceThreshold(threshold=0.01)),
    ("scaler", StandardScaler())
])

# 3. 低基数类别流水线:众数填充 + 独热编码
low_cat_pipeline = Pipeline(steps=[
    ("imputer", SimpleImputer(strategy="most_frequent")),
    ("onehot", OneHotEncoder(handle_unknown="ignore", sparse_output=False))
])

# 4. 高基数类别流水线:平滑目标编码 (TargetEncoder 自带平滑防泄漏机制)
high_cat_pipeline = Pipeline(steps=[
    ("imputer", SimpleImputer(strategy="constant", fill_value="UNKNOWN")),
    ("target_encoder", TargetEncoder(smooth="auto", cv=5))
])

# 5. 组装全局预处理 ColumnTransformer
preprocessor = ColumnTransformer(
    transformers=[
        ("num", num_pipeline, numeric_cols),
        ("low_cat", low_cat_pipeline, low_cardinality_cols),
        ("high_cat", high_cat_pipeline, high_cardinality_cols)
    ],
    remainder="drop"
)

# 6. 绑定评估模型,构筑端到端防泄漏 Pipeline
model_pipeline = Pipeline(steps=[
    ("preprocessor", preprocessor),
    ("classifier", lgb.LGBMClassifier(random_state=42, verbose=-1))
])

# 注意:交叉验证时必须直接评估整个 model_pipeline,以确保数据转换全部发生在每折内部!
cv_strategy = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
三、逼近表现极限:从盲目搜索到贝叶斯参数调优
当特征工程构建完毕、模型的输入信号达到高纯度后,下一步便是通过超参数调优挖掘算法在当前数据集下的最大潜力。
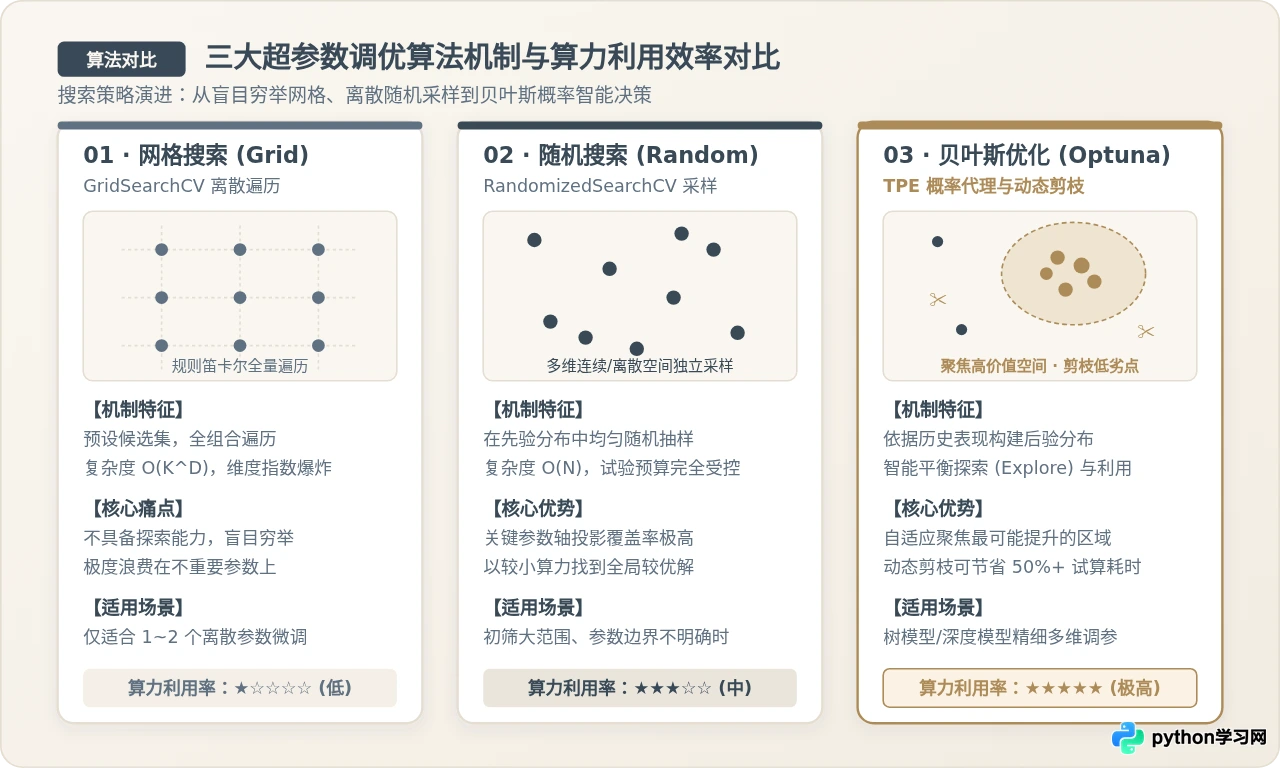
1. 为什么网格搜索(GridSearchCV)通常是算力黑洞
很多初学者习惯使用 GridSearchCV,将参数列表排成网格逐一尝试。但网格搜索存在致命的“维度灾难”:
- 假设对 LightGBM 的 5 个核心参数各选 4 个取值进行组合,总测试点数达到 \(4^5 = 1024\) 组。按 5 折交叉验证计算,需要完整训练模型 5120 次。
-
更关键的是,不同超参数对预测结果的影响权重是极不对称的(例如
learning_rate的敏感度远高于min_child_samples)。网格搜索把宝贵的计算资源均匀浪费在次要参数的冗余笛卡尔积上,极不划算。
2. 随机搜索(RandomizedSearchCV)的实用边界
相比网格搜索,RandomizedSearchCV 允许在参数的连续分布或离散空间中随机采样(如限定 n_iter=50)。Bergstra 等学者的经典实验证明,在相同的计算开销下,随机搜索在高维空间中击中关键超参数优选值的概率远高于网格穷举。在项目刚启动、参数取值量级尚不清晰时,随机搜索是极为高效的快速试探工具。
3. 贝叶斯优化(Optuna TPE):用先验知识指导下一次试验
当前工业界与 Kaggle 竞赛中最主流的调参方案是基于 TPE(Tree-structured Parzen Estimator)的贝叶斯优化(代表工具为 Python 的 Optuna)。
贝叶斯优化的核心逻辑在于:它不会孤立地看待每次试验,而是利用之前所有 Trial 的评分结果,在内部拟合一个高潜力参数分布概率模型。下一次采样的超参数组合会重点聚焦在高期望提升的区域,同时兼顾对未知区域的适度探索(Exploration & Exploitation)。
此外,Optuna 具备动态剪枝机制(Pruning):例如利用 MedianPruner,在某次试验迭代到一半(如第 20 轮弱学习器)时,若其验证指标已明显低于历史同阶段表现的中位数,算法会立即中断本次无意义试验,节省 50% 以上的训练时间。
4. 调参过程中的防过拟合铁律
超参数调优本质上也是一种针对验证集的“搜索拟合”。如果调参方法不当,极易产生“验证集表现不断提高,但测试集指标原地踏步甚至下跌”的伪提升现象。必须恪守以下四条铁律:
-
调参优先级次序:先调控制单棵树复杂度的结构参数(
max_depth,num_leaves,min_child_samples),再调样本与特征采样比(subsample,colsample_bytree),最后精调学习率(learning_rate)与正则项(reg_alpha,reg_lambda)。 -
强制配合 Early Stopping:将基学习器迭代次数(
n_estimators)设置得足够大(如 2000),同时将学习率固定在较小值(如 0.03~0.05),通过early_stopping_rounds=50让验证集自动锁定最佳轮数,避免固定步数导致过拟合或欠拟合。 -
参数分布类型设定:学习率、L1/L2 正则项等跨越多个数量级的参数,采样时必须使用对数均匀分布(如
trial.suggest_float("learning_rate", 1e-3, 0.2, log=True)),确保各数量级获得均匀的探索机会。 - 保留完全隔离的 Hold-Out 验收集:调参全过程只允许使用训练集与 K-Fold 验证集,调优结束后用从未参与搜索的纯净 Hold-out 测试集进行最终效果验收。
5. 实操代码:基于 Optuna + LightGBM 的工业级调优模版
以下代码给出了在实践中即插即用的 Optuna 自动调优工程模版,集成了分层交叉验证、动态参数空间定义与剪枝回调:
import optuna
import lightgbm as lgb
import numpy as np
from sklearn.model_selection import StratifiedKFold
from sklearn.metrics import roc_auc_score

def objective(trial, X, y):
    # 1. 定义超参数动态搜索空间
    params = {
        "objective": "binary",
        "metric": "auc",
        "boosting_type": "gbdt",
        "verbosity": -1,
        "random_state": 42,
        # 结构参数
        "num_leaves": trial.suggest_int("num_leaves", 15, 127),
        "max_depth": trial.suggest_int("max_depth", 3, 10),
        "min_child_samples": trial.suggest_int("min_child_samples", 10, 100),
        # 采样率 (防止过拟合)
        "subsample": trial.suggest_float("subsample", 0.6, 1.0),
        "colsample_bytree": trial.suggest_float("colsample_bytree", 0.5, 1.0),
        # 学习率与正则项 (对数分布)
        "learning_rate": trial.suggest_float("learning_rate", 0.01, 0.15, log=True),
        "reg_alpha": trial.suggest_float("reg_alpha", 1e-3, 10.0, log=True),
        "reg_lambda": trial.suggest_float("reg_lambda", 1e-3, 10.0, log=True)
    }

    # 2. 5 折分层交叉验证
    skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
    val_scores = []

    for fold, (train_idx, val_idx) in enumerate(skf.split(X, y)):
        X_tr, y_tr = X.iloc[train_idx], y.iloc[train_idx]
        X_va, y_va = X.iloc[val_idx], y.iloc[val_idx]

        dtrain = lgb.Dataset(X_tr, label=y_tr)
        dval = lgb.Dataset(X_va, label=y_va, reference=dtrain)

        # 启用早停机制与模型训练
        model = lgb.train(
            params,
            dtrain,
            num_boost_round=1500,
            valid_sets=[dval],
            callbacks=[
                lgb.early_stopping(stopping_rounds=50, verbose=False)
            ]
        )

        preds = model.predict(X_va, num_iteration=model.best_iteration)
        val_scores.append(roc_auc_score(y_va, preds))

        # Optuna 折间剪枝反馈
        trial.report(np.mean(val_scores), step=fold)
        if trial.should_prune():
            raise optuna.TrialPruned()

    return float(np.mean(val_scores))

# 3. 实例化 Study 并运行优化
# optuna.logging.set_verbosity(optuna.logging.WARNING)
# study = optuna.create_study(direction="maximize", pruner=optuna.pruners.MedianPruner())
# study.optimize(lambda t: objective(t, X_train, y_train), n_trials=60, timeout=1800)
# print("最优参数组合:", study.best_params)
# print("最高验证集 AUC:", study.best_value)
四、工程化落地与避坑规范
掌握了特征工程与参数调优的核心技巧后,想要在实际项目中持续、稳定地收获提分收益,还需要建立严密的工程化规范。
1. 全生命周期 Pipeline 封装实战
在很多低分或复现失败的项目中,代码往往散落为一个个手动的脚本步骤:先生成若干衍生列,再手动处理缺失,最后导入模型。这种离散式编程极易因执行顺序错乱而引发数据穿透。
必须养成从清洗到预测全程使用 Pipeline 封装的习惯。在 Pipeline 中,每一个 Transformer 类的 fit() 方法都只能且必须接收训练折的特征与标签,而 transform() 方法则纯粹应用固定参数。只有这样,模型在线上部署推理单条或批量新数据时,才能保证其行为逻辑与训练阶段严格一致。
2. 调参的边际收益法则:何时该停下调参
在机器学习项目中,资源的分配必须遵循边际收益递减法则。经验数据表明,在一个工业级预测建模工程中:
| 技术环节 | 典型提分贡献度 | 边际收益衰减速度 | 推荐时间投入比例 |
|---|---|---|---|
| 特征工程体系 | 约 60% ~ 70% | 较慢(随着业务理解加深持续产生高增益) | 60% |
| 超参数系统调优 | 约 20% ~ 25% | 极快(前 30~50 次 Trial 产生 80% 提升) | 25% |
| 模型融合 / Stacking | 约 10% ~ 15% | 中等(需维护多模型复杂度) | 15% |
当使用 Optuna 运行了 50~80 轮试验后,如果算力消耗时间成倍增加,而验证集的核心指标提升幅度已低于 0.1% ~ 0.2%,必须果断叫停超参数搜索。此时算法对当前特征空间的拟合能力已逼近理论极限,继续死磕只会陷入微小的随机波动或局部过拟合。正确的策略是立即回到数据源头,挖掘新外部数据、构造更高阶的业务交叉特征或重构样本标签定义。
解决 Python 预测模型准确率低的问题,从来不是靠盲目试错或一味堆砌深度模型。真正高效的提升路径始终遵循三部曲:首先校准验证指标、用学习曲线明确欠拟合与过拟合边界;其次通过缺失指示治理、平滑目标编码、业务比率衍生和置换重要度筛选构建高质量特征矩阵,打破模型预测上限;最后借助贝叶斯概率采样与早停机制,在受控的算力预算内逼近最佳超参数配置。以严谨的 Pipeline 隔离流程,才能确保模型在线下验证的高分无损转化为线上生产系统的真实商业价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















