


Python list.remove()报错ValueError:怎么安全删除指定值的元素
深入解析 Python list.remove() 抛出 ValueError 的底层机制,对比 LBYL 与 EAFP 两种单元素安全删除策略,并提供批量删除重复元素时的切片赋值方法,彻底规避遍历中的索引位移陷阱。
核心结论速览:在 Python 中,当调用 list.remove(x) 且目标值 x 不在列表中时,解释器不会返回 None 或静默忽略,而是直接抛出 ValueError: list.remove(x): x not in list。安全删除单个元素时,推荐使用 EAFP 模式(try...except ValueError) 或 LBYL 模式(if x in list);若需要安全删除所有重复的目标值,切勿在正向 for 循环中直接调用 remove(),而应采用 列表推导式切片赋值(list[:] = [item for item in list if item != x])。
一、为什么 list.remove() 会抛出 ValueError?
Python 的内置列表类型 list 是基于连续内存引用的动态数组。当开发者调用 my_list.remove(value) 时,底层 C 语言实现(list_remove)会执行自左向右的线性遍历,逐一比对元素是否满足 item == value。
这个方法有两个核心行为特征需要特别注意:
- 只删除第一个匹配项:一旦在列表中找到第一个相等的元素,底层便会立即将其移除,并将后续所有元素向前平移一个槽位,随后直接结束调用,不会继续处理列表中剩余的同值元素。
- 无容错机制:如果遍历直至列表末尾仍未匹配到目标值,Python 会依据“显式优于隐式(Errors should never pass silently)”的设计哲学,主动抛出
ValueError异常,而不是返回布尔值。
# 触发 ValueError 的典型场景示例
fruits = ['apple', 'banana', 'orange']

# 试图删除一个不存在的水果
fruits.remove('grape')Traceback (most recent call last):
File "demo.py", line 4, in <module>
fruits.remove('grape')
ValueError: list.remove(x): x not in list
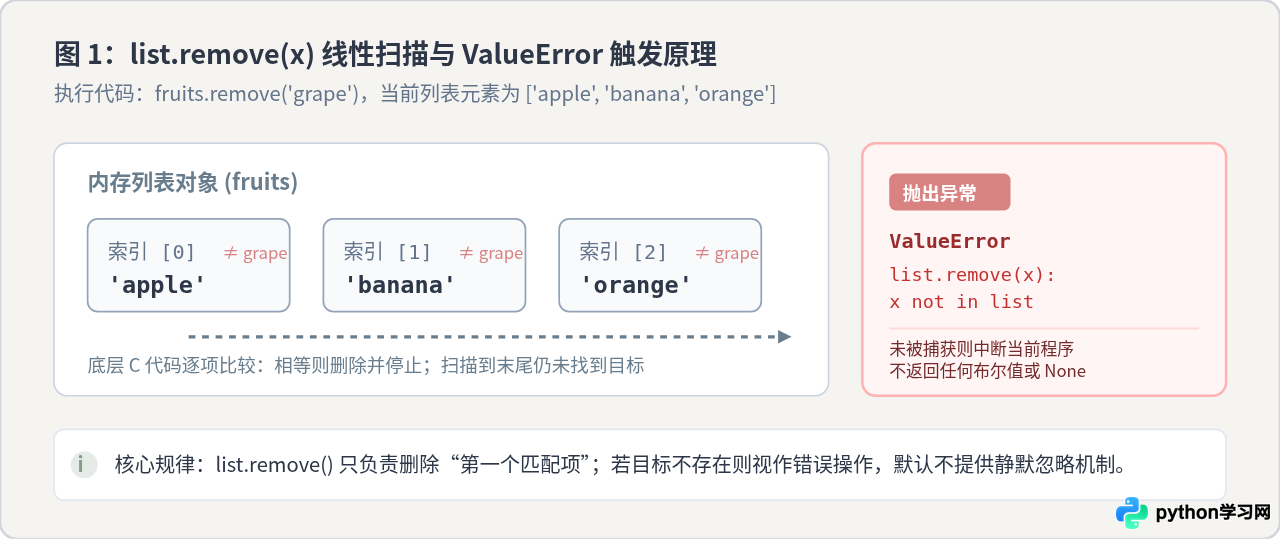
从底层复杂度来看,单次 remove() 操作不仅需要 $O(n)$ 时间来寻找目标,还需要 $O(n)$ 时间在内存中移动数组尾部的数据。如果不加防护地直接调用,任何一次缺失都会导致整个程序的控制流被意外打断。
二、安全删除单个指定元素的两种策略:LBYL 与 EAFP
在面对可能缺失的单个元素时,Python 社区存在两种标准的编程哲学:LBYL(事前检查,Look Before You Leap) 与 EAFP(事后宽恕,Easier to Ask for Forgiveness than Permission)。两者均能有效阻止 ValueError,但在执行路径与性能开销上存在本质差异。
策略 1:LBYL 事前检查(if x in list)
这种做法符合直觉,先利用 in 关键字验证目标值是否存在,确认存在后再执行删除:
# LBYL 检查方案
target = 'grape'
fruits = ['apple', 'banana', 'orange']

if target in fruits:
    fruits.remove(target)
else:
    # 可根据业务需要补充日志或兜底逻辑
    pass

print("当前列表状态:", fruits)当前列表状态: ['apple', 'banana', 'orange']
代价分析:该方案虽然逻辑直观,但在目标元素确实存在时存在双重遍历开销。target in fruits 会首先从头至尾遍历一次列表以确认存在性(耗时 $O(n)$);接下来的 fruits.remove(target) 又必须重新从头扫描列表找到该元素的位置并执行内存平移(耗时 $O(n)$)。在长列表或频繁调用的场景下,这种冗余扫描会拖慢程序效率。
策略 2:EAFP 事后容错(try...except ValueError)
EAFP 模式是更为地道的 Python 风格。它直接假定元素大概率存在并直接调用 remove(),通过捕获 ValueError 来安全收敛未命中的情况:
# EAFP 容错方案
target = 'grape'
fruits = ['apple', 'banana', 'orange']

try:
    fruits.remove(target)
except ValueError:
    # 目标不存在时静默跳过或记录日志
    pass

print("当前列表状态:", fruits)当前列表状态: ['apple', 'banana', 'orange']
代价分析:当元素确实存在于列表中时,EAFP 仅执行一次线性扫描即可完成删除,完全没有事前检查的冗余损耗。在现代 Python(Python 3.11+)采用“零成本异常(Zero-Cost Exceptions)”架构后,未触发异常的 try 块几乎没有任何额外开销。只有在元素频繁缺失且真正触发异常时,才会产生构建异常回溯信息的微小耗时。
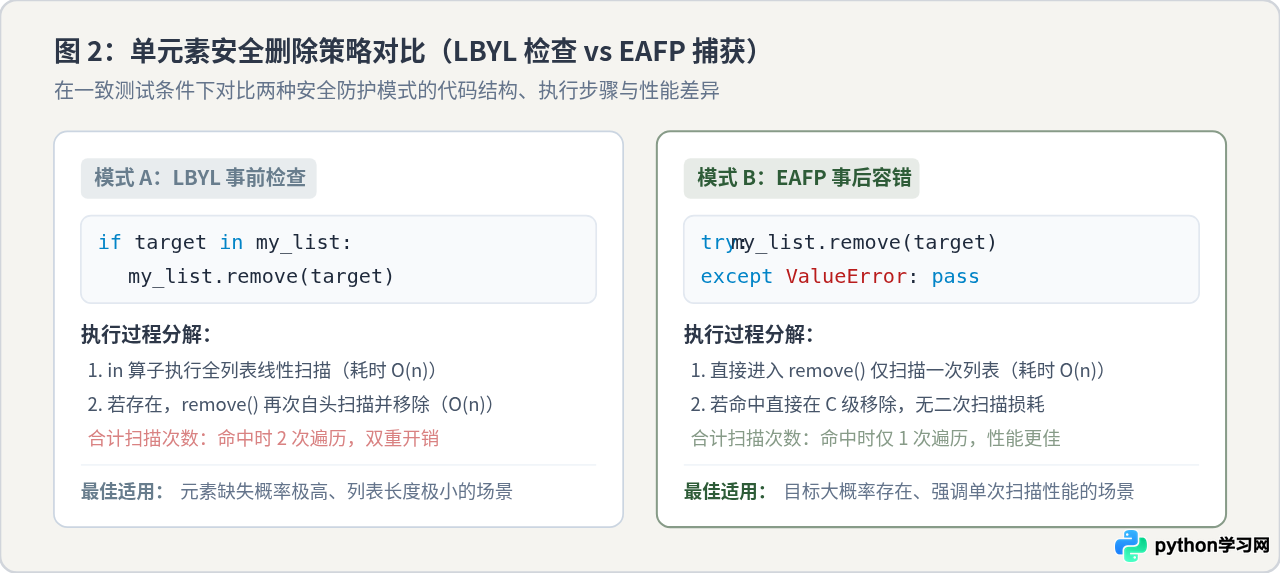
| 对比维度 | LBYL 模式(if in) |
EAFP 模式(try-except) |
|---|---|---|
| 元素存在时的扫描次数 | 2 次全表扫描(in + remove) |
1 次直接扫描(仅 remove) |
| 代码表达意图 | 显式防御,流程保守 | 快速尝试,优雅收敛边界 |
| 推荐业务场景 | 目标元素大概率缺失、列表很短小 | 目标元素大概率存在、重视单次执行性能 |
三、致命陷阱:为什么不能在 for 循环中边遍历边 remove()?
当需要删除列表中所有等于某值的元素时,很多初学者会写出类似下面的循环代码:
# 极其危险的错误写法:遍历中直接 remove
numbers = [10, 20, 20, 30]

for num in numbers:
    if num == 20:
        numbers.remove(num)

print("处理后的结果:", numbers)处理后的结果: [10, 20, 30]
令人惊讶的是,代码并未抛出报错,但结果中赫然残留了一个本该被清除的 20!这就是经典的“列表迭代索引跳步(Index Shift)陷阱”。
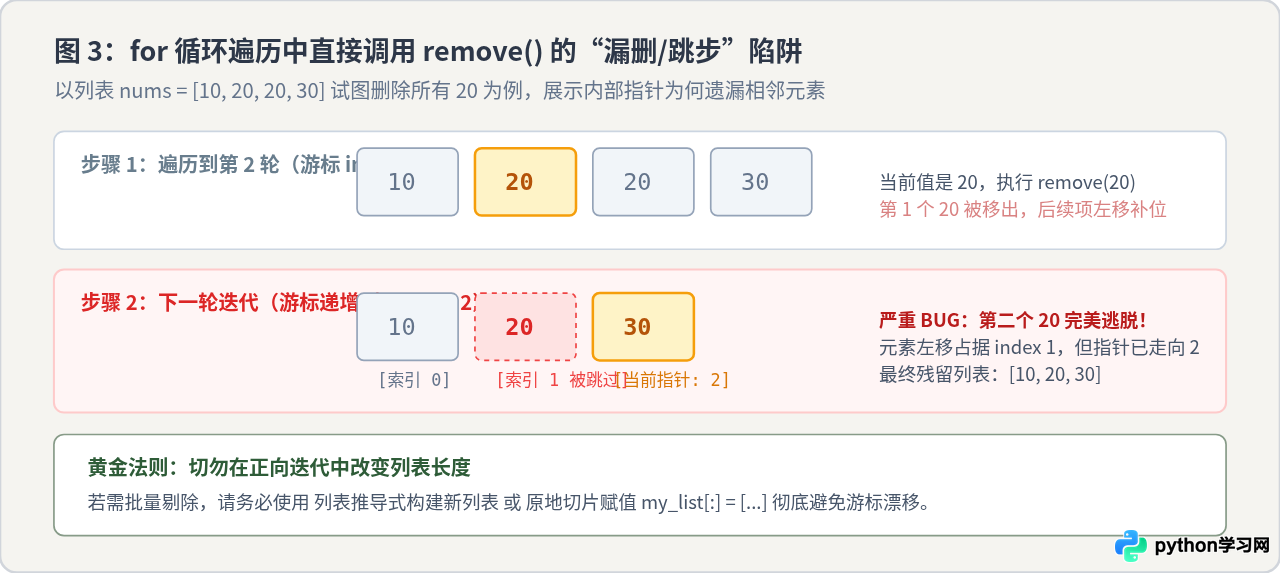
出现漏删的内在因果关系如下:
- Python 的
for循环在底层维护一个自增整数游标(index = 0, 1, 2...)。 - 第一轮循环
index = 0,读取到10,不满足删除条件;游标递增到1。 - 第二轮循环
index = 1,读取到第一个20,调用remove(20)。第一个20被从列表中抽出,后面的所有元素整体向左平移一位。此时,第二个20自动滑动到了index = 1的位置,而30滑动到了index = 2。 - 第三轮循环开始,游标自然递增到
index = 2。由于第二个20当前恰好退到了index = 1,它被迭代器直接跳过了!迭代器读取到了index = 2上的30。
四、批量删除所有匹配元素的标准正确方案
针对需要彻底清除所有同值元素的场景,有以下三种经过工程验证的方案:
方案 1:列表推导式生成新列表(最常用)
通过正向过滤条件保留所有不等于目标值的元素,这是 Python 中性能最高、最清晰且最符合惯例的做法:
# 列表推导式(产生新列表对象)
numbers = [10, 20, 20, 30]
target = 20

# 仅保留不等于 target 的元素
filtered_numbers = [item for item in numbers if item != target]

print("原列表:", numbers)
print("过滤后新列表:", filtered_numbers)原列表: [10, 20, 20, 30]
过滤后新列表: [10, 30]
方案 2:原地切片赋值 list[:] = [...](保持对象引用)
当列表被当作实参传入函数内部,或者有多个全局变量指向同一个列表对象时,直接为变量重新赋值(如 numbers = [...])只会改变当前变量名绑定的引用,其他引用方看到的仍是未修改的旧对象。此时必须使用切片赋值进行原地覆盖:
def purge_target_in_place(lst, target_val):
    # 使用 lst[:] 实现原地址内存块覆写,外部引用的列表内容同步更新
    lst[:] = [item for item in lst if item != target_val]

# 外部数据
shared_list = [10, 20, 20, 30]
alias_list = shared_list  # 共享同一份内存引用

purge_target_in_place(shared_list, 20)

print("shared_list:", shared_list)
print("alias_list: ", alias_list)
print("内存地址是否相同:", id(shared_list) == id(alias_list))shared_list: [10, 30]
alias_list: [10, 30]
内存地址是否相同: True
方案 3:while target in list: list.remove(target) 的适用与边界
有部分代码会使用 while 循环结合 in 来不断删除元素,直到全部清空:
# while in 循环删除(仅适用于小型列表)
numbers = [10, 20, 20, 30]
target = 20

while target in numbers:
    numbers.remove(target)

print("处理后列表:", numbers)while in 会完整扫描一次列表($O(n)$),随后的 remove 又会扫描一次并移动内存($O(n)$)。总体时间复杂度会退化为 $O(k \cdot n)$。如果数据量达到数万级别且包含大量重复项,耗时将急剧上升;因此仅建议在调试脚本或极小列表(几个元素)时临时使用。
五、场景决策与工程选型指南
为了帮助读者在日常开发中准确选取最合适的技术路线,下图给出了完整的决策逻辑树:
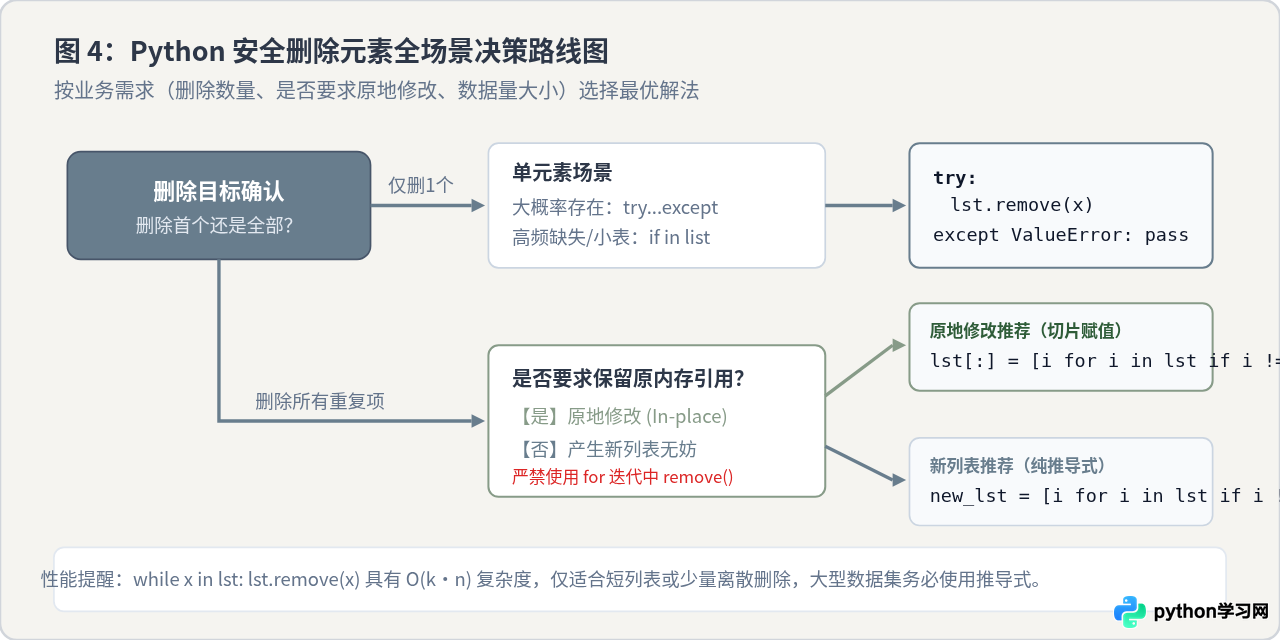
总结起来,处理 list.remove() 及相关值删除任务时,请遵循以下三条黄金准则:
- 删除单个且元素通常存在:优先采用
try: my_list.remove(x) except ValueError: pass,单次扫描,速度最快。 - 删除单个且可能频繁缺失:采用
if x in my_list: my_list.remove(x),逻辑直白,控制流开销确定。 - 批量删除所有匹配项:统一采用推导式。无需保留原引用时用
[x for x in lst if x != val];必须保留原引用时用lst[:] = [x for x in lst if x != val]。彻底杜绝在for循环中直接调用remove()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















