


Python中什么时候该用元组?字典键与数据保护场景
深入解析Python中元组的核心适用场景,重点探讨元组作为字典键的底层哈希机制,以及在多模块协作中构建只读数据保护屏障的具体实践与注意事项。
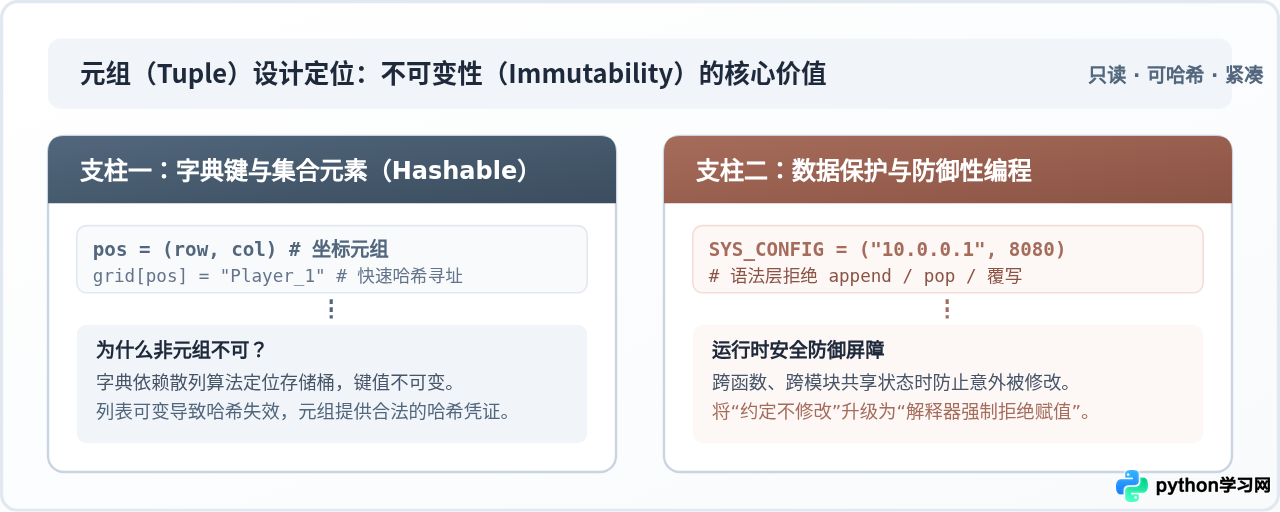
在 Python 编程中,如果你只把元组(tuple)当作“不能修改的列表(list)”,就很容易忽略它在语言设计中的真实定位。元组的核心价值并非单纯为了少写几对中括号,而在于它的不可变性(Immutability)所带来的两项决定性能力:满足字典键与集合元素的可哈希(Hashable)契约,以及在多模块协作与复杂系统中构建不可篡改的数据保护屏障。本文将通过具体的数据结构机理与实用代码,彻底讲清什么时候必须用元组,以及如何利用它规避潜在的系统隐患。
从一个直观现象切入:列表不能做字典键的原因
初学 Python 时,很多人都会尝试用二维网格坐标作为字典的键,来快速记录棋盘、游戏地图或多维特征。当我们习惯性地用列表来表示坐标时,解释器会立即抛出异常:
# 尝试将包含坐标的列表作为字典的键
player_pos = [10, 25]
game_map = {}
game_map[player_pos] = "Hero"
报错明确指出列表是“不可哈希(unhashable)”的。然而,如果仅仅把方括号改成圆括号,写成 player_pos = (10, 25),代码便能毫无阻碍地正常运行:
# 将坐标改为元组
player_pos = (10, 25)
game_map = {}
game_map[player_pos] = "Hero"

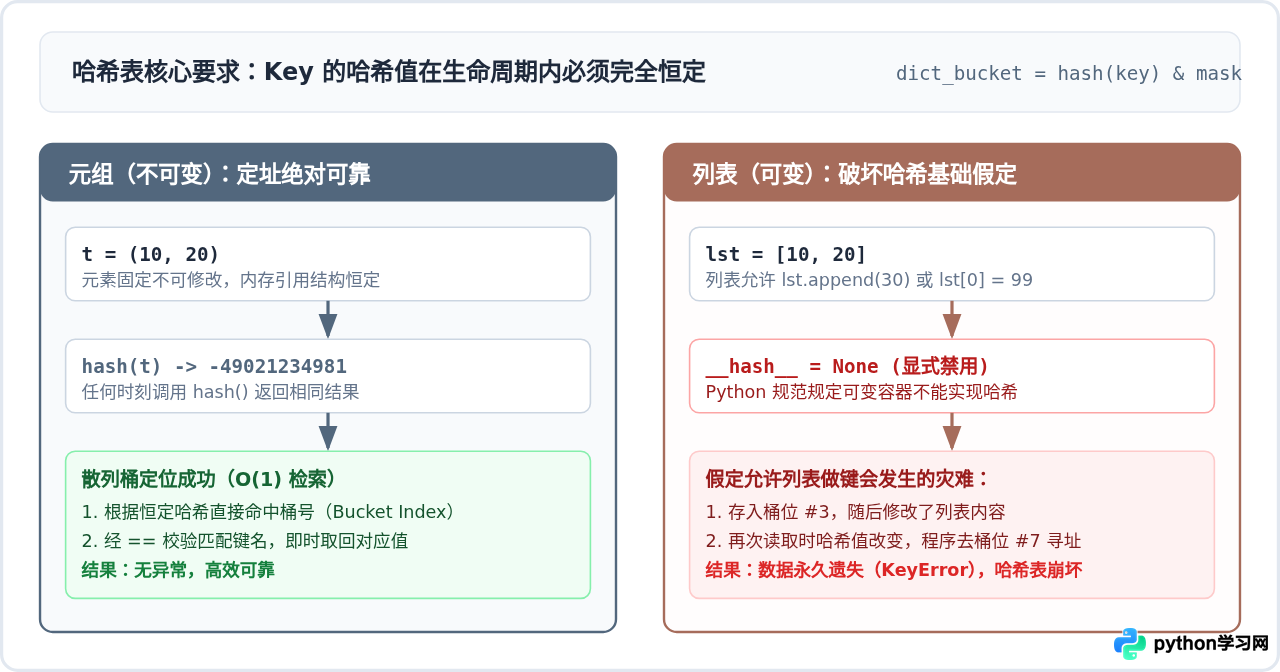
print(game_map[(10, 25)]) # 正常获取结果这个现象背后隐藏着 Python 核心数据结构的底层规则:Python 字典是通过哈希表(Hash Table)实现的,任何作为键的对象,其生命周期内的哈希值必须恒定不变,且必须能够进行相等性比较。
场景一:作为字典键的典型工程实践
理解了哈希协议之后,我们来看看在实际开发中,哪些业务场景应当优先使用元组作为字典键。
1. 二维网格与空间坐标索引
在图形渲染、棋盘游戏、GIS 地理信息处理中,我们常常需要按坐标快速检索网格对象。使用元组作为复合键,不仅表达直观,而且比拼接字符串更干净、性能更高:
# 棋盘网格状态缓存
chessboard = {}

# 存储落子位置 (行, 列)
chessboard[(0, 0)] = "车"
chessboard[(0, 1)] = "马"
chessboard[(3, 4)] = "炮"

def get_piece(row, col):
    # 直接用元组查询,时间复杂度 O(1)
    return chessboard.get((row, col), "空位")

print("位置 (3, 4) 的棋子:", get_piece(3, 4))
print("位置 (1, 1) 的棋子:", get_piece(1, 1))位置 (1, 1) 的棋子: 空位
2. 多维度联合主键与复合缓存
在很多服务端业务中,单靠一个 ID 无法唯一确定一个实体,往往需要依赖联合主键。例如“租户ID + 用户ID”或者“接口名称 + 参数MD5”。如果用字符串拼接(如 f"{tenant_id}:{user_id}"),每次查找都伴随着字符串格式化和哈希重新计算;而直接使用元组 (tenant_id, user_id) 则自然形成了天然的复合索引:
# 多租户系统中的用户权限缓存
permission_cache = {}

# 联合主键:(租户编号, 用户编号)
key_alice = ("tenant_101", 9527)
key_bob = ("tenant_102", 9527)

permission_cache[key_alice] = ["read", "write"]
permission_cache[key_bob] = ["read"]

# 即使同一用户编号在不同租户下,也能精确区分
print("Alice 权限:", permission_cache.get(("tenant_101", 9527)))
print("Bob 权限:", permission_cache.get(("tenant_102", 9527)))Bob 权限: ['read']
场景二:数据保护与防御性编程
除了满足字典键的技术要求,元组在软件工程中更深远的价值在于提供“只读”契约,防止意外的副作用(Side Effects)。
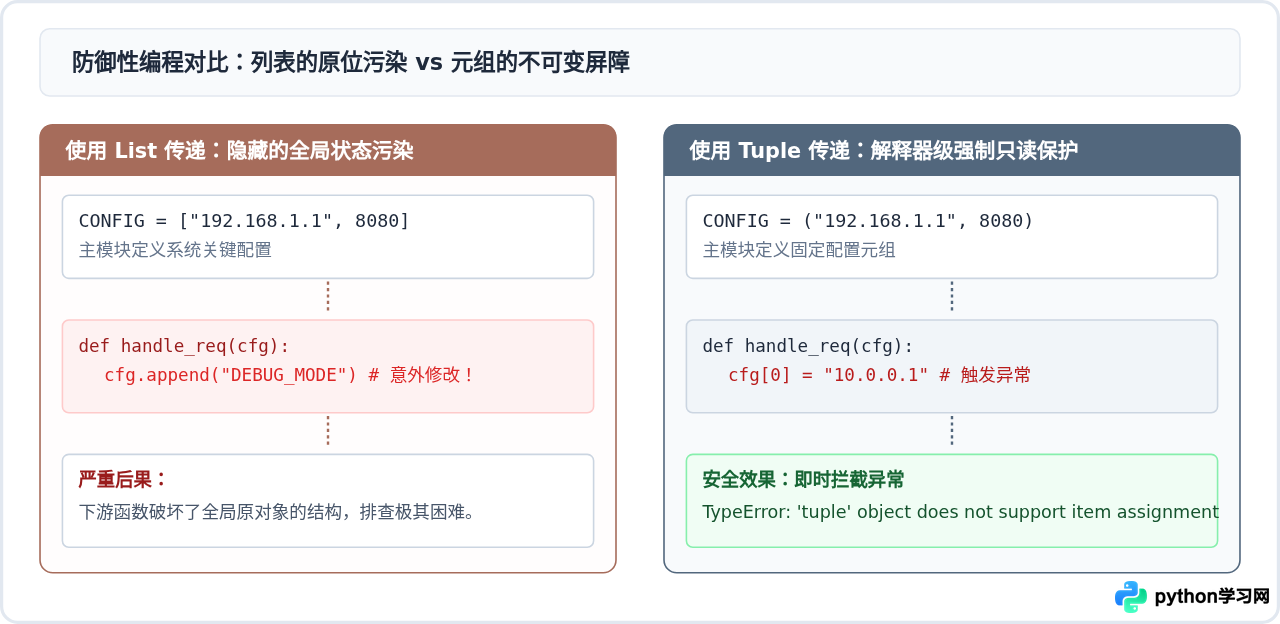
在大型项目或多人协同开发中,函数之间传递列表是极具风险的。因为 Python 中的列表是引用传递,任何下游函数无意间执行了 list.append()、list.pop() 或 list[i] = val,都会直接污染上游调用者甚至全局的状态。
1. 系统常量与全局配置规范
定义全局常量时,使用元组能清晰地向所有维护者表达“此数据不可更改”的意图:
# 允许访问的 HTTP 方法清单
ALLOWED_HTTP_METHODS = ("GET", "POST", "PUT", "DELETE")

# 数据库默认主备集群节点
CLUSTER_NODES = (
    ("192.168.1.10", 5432),
    ("192.168.1.11", 5432),
)

# 任何尝试修改的行为都会在开发阶段立即暴露
try:
    ALLOWED_HTTP_METHODS[0] = "PATCH"
except TypeError as err:
print("错误提示:", err)2. 函数返回值保护与解包语义
当一个函数需要返回多个互相关联的结果时,返回元组是 Python 的标准惯例(例如 return code, message, data)。这样做的好处在于:
- 解包直观:调用者可以方便地进行位置解包
c, m, d = fetch_data()。 - 防止原位破坏:调用者接收到的是一个轻量且不可变的整体快照,避免中间处理逻辑无意篡改返回记录。
重要避坑点:元组的“浅不可变性”(Shallow Immutability)
在使用元组进行数据保护或作为字典键时,必须高度警惕一个常见的认知盲区:元组的“不可变”指的是元组本身存储的“引用地址不可变”,而非其内部引用的对象内容不可变。
如果一个元组内部包含了可变对象(例如列表、字典),那么这个对象依然可以被修改;更严重的是,该元组会因此瞬间丧失可哈希性,导致字典键方案崩溃。
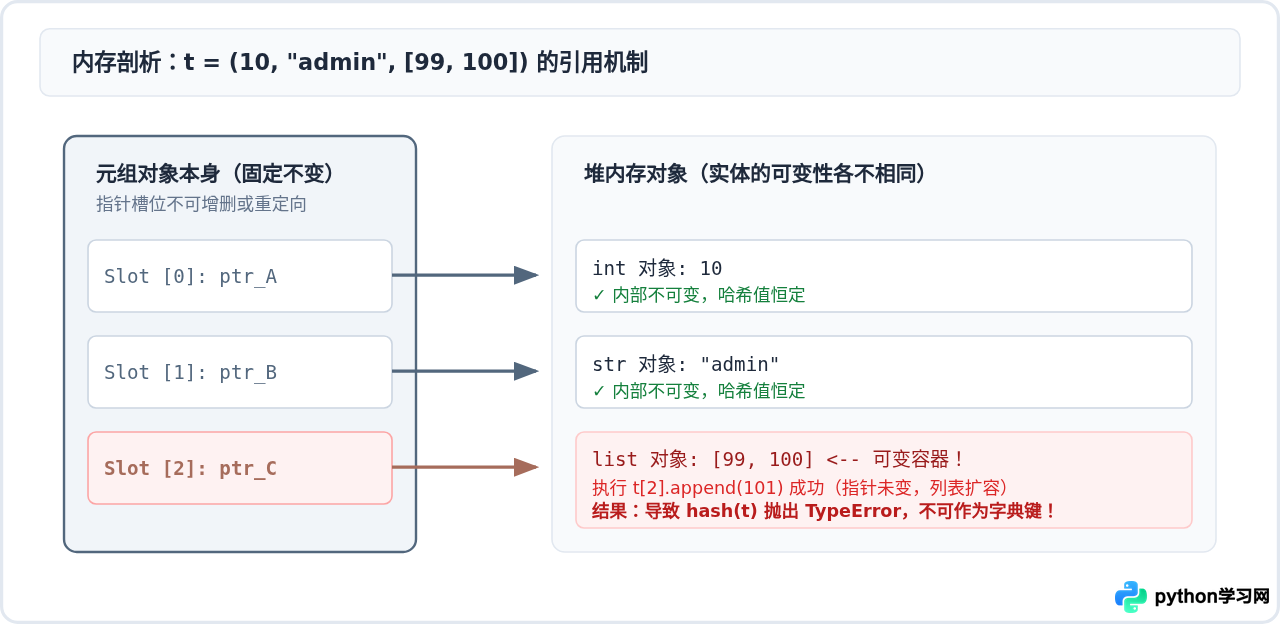
让我们用代码验证这个隐蔽的陷阱:
# 包含列表的元组
mixed_tuple = ("user_101", [1, 2])

# 尝试直接赋值修改槽位,会被阻止
try:
    mixed_tuple[0] = "user_102"
except TypeError:
    print("槽位重定向被阻止")

# 但是修改内部列表的内容完全被允许!
mixed_tuple[1].append(3)
print("修改后的元组内容:", mixed_tuple)

# 尝试计算哈希值
try:
    print("哈希计算:", hash(mixed_tuple))
except TypeError as err:
print("哈希失败:", err)修改后的元组内容: ('user_101', [1, 2, 3])
哈希失败: unhashable type: 'list'
int、float、str、bytes、bool 或由上述类型构成的嵌套元组)。如果需要存储集合类数据,请使用不可变的 frozenset 代替常规 set 或 list。
决策模型:什么时候该选元组?
为了帮助你在实际写代码时迅速做出清晰判断,我们可以通过下面这条推导路径完成技术选型:
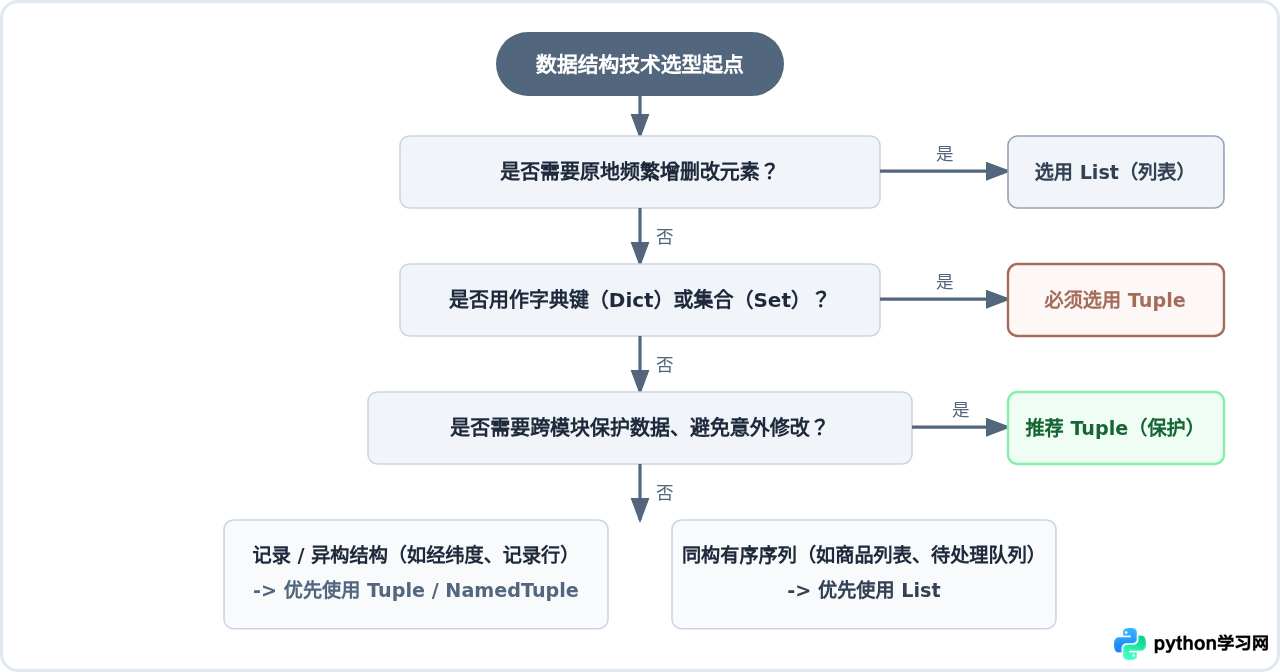
除此之外,元组在内存占用与创建开销上也具备优势。因为元组是静态定长的,Python 不需要为其额外预留动态追加(Over-allocation)所需的缓冲区内存,其结构体更加紧凑,垃圾回收负担也更低。在需要加载数百万条静态记录的内存密集型程序中,使用元组能节省可观的堆内存开销。
核心对比速查表
| 考量维度 | 元组 (Tuple) | 列表 (List) | 适用建议与规则 |
|---|---|---|---|
| 字典键支持 | 完美支持(要求元素均不可变) | 完全不支持(抛出 TypeError) | 需要网格坐标、联合索引时唯一正解。 |
| 数据修改机制 | 只读,槽位引用不可覆写或增删 | 动态可变,支持 append、pop、切片赋值 |
防止模块间状态篡改用元组;动态收集数据用列表。 |
| 数据语义契约 | 强调“结构体 / 一条完整的静态记录” | 强调“同种类型的动态集合序列” | 例如 ("Alice", 28, "Engineer") 比列表更具记录语义。 |
| 内存与分配效率 | 定长内存分配,结构紧凑,无冗余缓冲 | 带有扩容预留缓冲,内存开销稍大 | 巨量静态只读数据(如百万级只读坐标集)选元组更省内存。 |
总结与建议
在 Python 中,元组绝不仅仅是“弱化版的列表”,它承担着明确的设计分工:
- 作为字典复合键与集合元素:这是由底层散列算法决定的硬性需求。只要你需要多字段联合索引或离散坐标寻址,元组就是标准而高效的解决方案。
- 作为防御性编程的防护墙:在配置常量、多模块协作接口、多返回值场景中,使用元组表达的是不可篡改的严谨语义,能杜绝隐蔽的全局状态污染。
- 保持内部纯粹不可变:时刻记住“浅不可变”的规则,切忌在作为字典键的元组内部塞入列表等可变对象,确保数据完整性从表及里、始终如一。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















