


Python批量复制指定类型文件的代码示例
详细讲解如何使用 Python 批量复制指定类型(如 PDF、PNG、CSV 等)文件。涵盖 pathlib 与 shutil.copy2 的核心操作步骤、单层与多层递归复制、平铺与层级保留策略对比、元数据保留细节及生产级代码封装。
在日常文件管理、数据备份或自动化流程中,常需要从指定文件夹中筛选特定后缀(如 .pdf、.jpg、.csv)的文件并批量转移到新目录。在 Python 中,完成这一任务最简洁且稳健的方式是结合使用内置的 pathlib 与 shutil 模块:通过 pathlib.Path 完成跨平台的路径定位与后缀筛选,利用 shutil.copy2 在复制文件内容的同时完整保留修改时间等元数据。
一、基础场景:单层目录特定文件快速复制
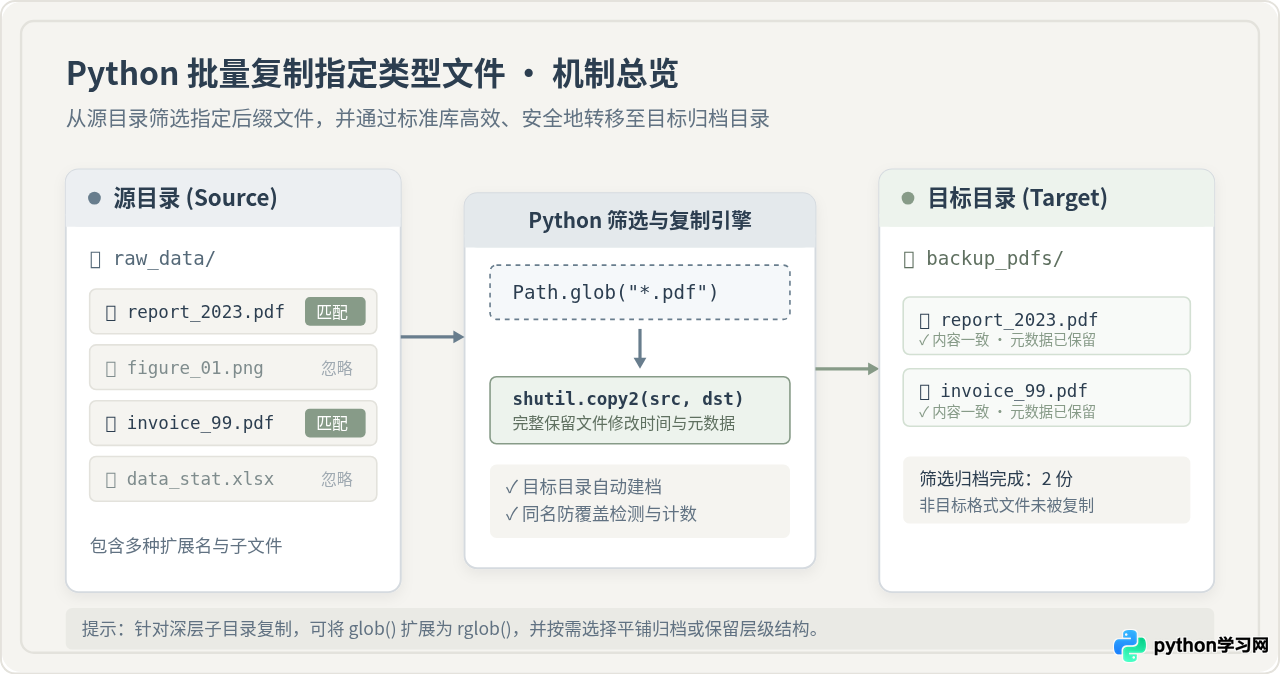
当源文件夹结构平坦、无需下钻多层子目录时,只需直接调用 Path.glob() 匹配目标扩展名,并配合 shutil.copy2() 执行搬运。这是最简单也是最高频的使用场景。
1. 完整代码示例
from pathlib import Path
import shutil

# 1. 定义源目录与目标目录路径
source_dir = Path("./raw_data")
target_dir = Path("./backup_pdfs")

# 2. 预先创建目标目录,避免抛出 FileNotFoundError
target_dir.mkdir(parents=True, exist_ok=True)

# 3. 指定要复制的文件扩展名通配符
file_pattern = "*.pdf"
success_count = 0

# 4. 遍历源目录下匹配的文件并执行复制
for file_path in source_dir.glob(file_pattern):
    # 确保当前路径是真实文件,排除同名文件夹
    if file_path.is_file():
        target_file_path = target_dir / file_path.name
        shutil.copy2(file_path, target_file_path)
        success_count += 1
        print(f"已复制: {file_path.name}")

print(f"任务结束:共成功复制 {success_count} 个文件到 {target_dir}")
已复制: annual_report_2022.pdf
已复制: financial_statement_q3.pdf
已复制: user_agreement_v2.pdf
任务结束:共成功复制 3 个文件到 backup_pdfs
2. 核心操作步骤拆解
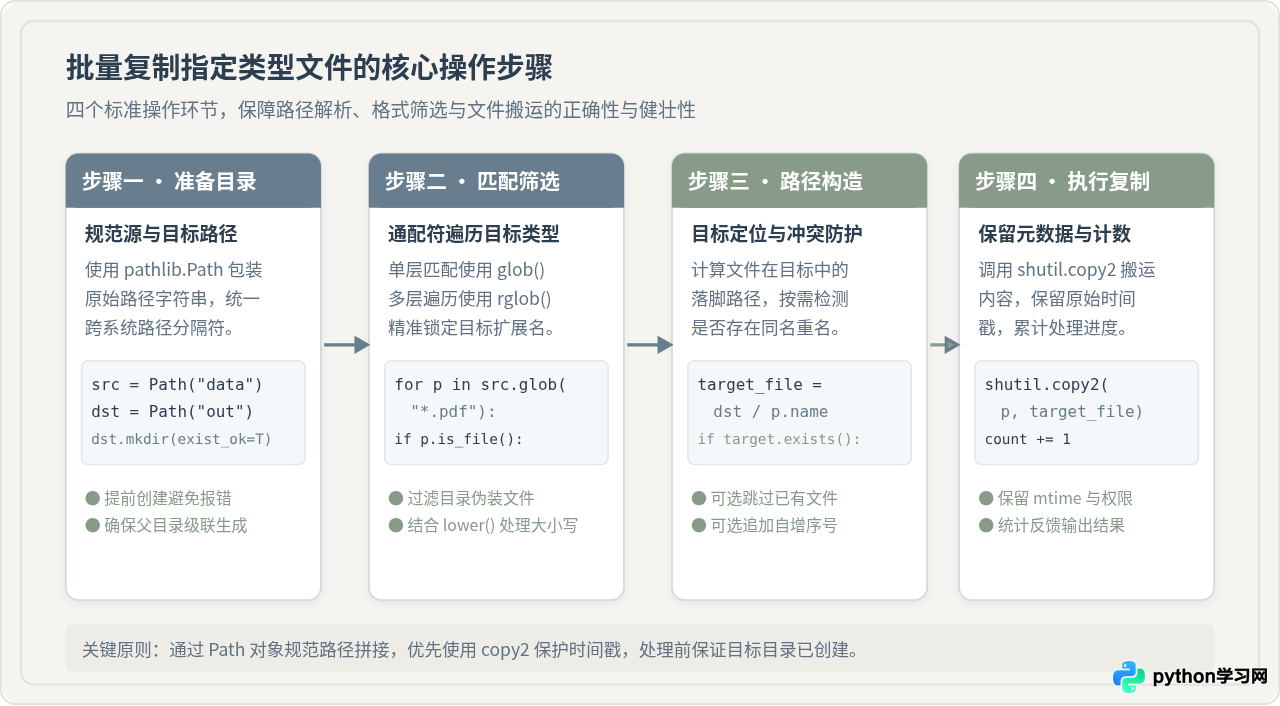
上述基础流程虽然代码量少,但包含了四个关键控制点,确保了脚本在各种操作系统上都能安全稳定运行:
- 目录就绪检查:
target_dir.mkdir(parents=True, exist_ok=True)保证了目标路径即使层级很深也能自动递归创建,且当目录已存在时不会抛出异常。 - 通配符匹配:
Path.glob("*.pdf")能够自动过滤非目标格式,无需开发者手动通过字符串分割或切片提取后缀。 - 路径安全性保障:
file_path.is_file()拦截了可能恰好以.pdf命名的恶意或误建子文件夹。 - 元数据保护:选用
shutil.copy2而非shutil.copy,最大程度保留文件原有的修改时间戳与权限信息。
二、进阶场景:递归遍历多级嵌套子目录
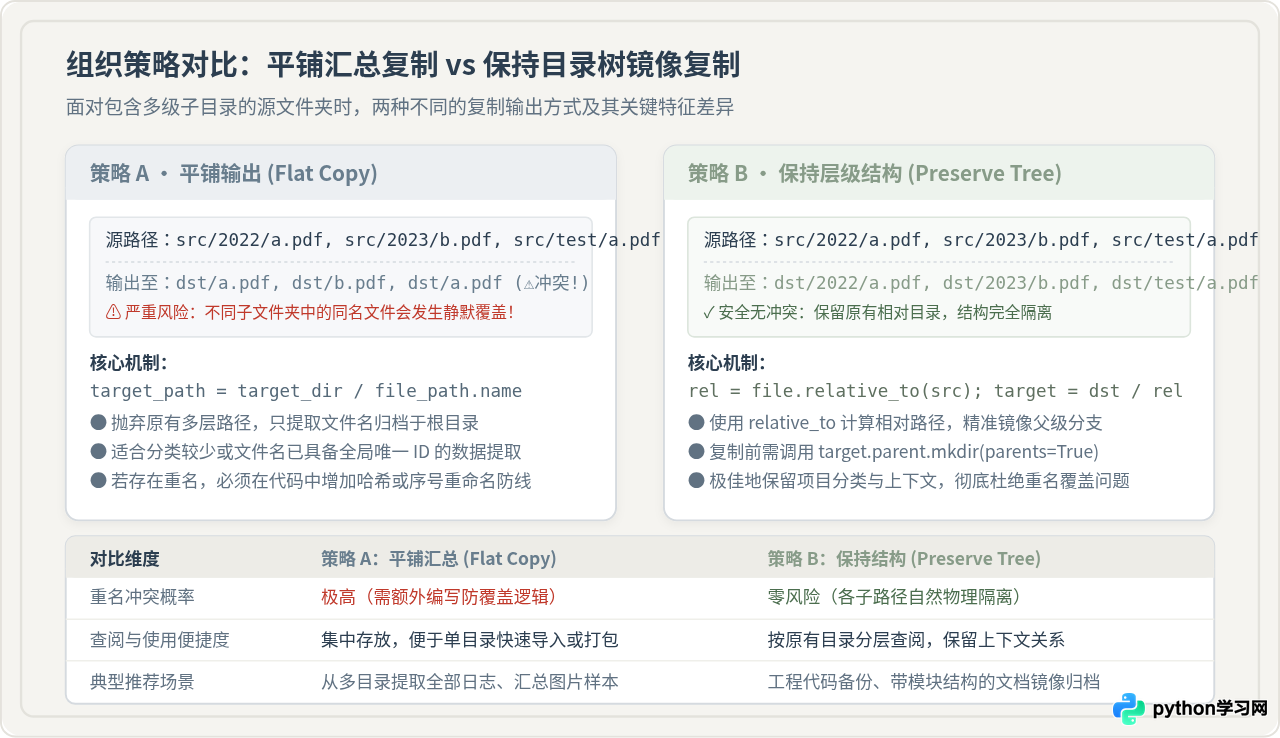
实际生产环境中,待处理的文件往往分散在各年份、月份或部门的多层嵌套子文件夹内。针对包含复杂层级的情况,pathlib 提供了递归匹配方法 rglob()。但在复制输出时,必须根据业务需求在“平铺汇总归档”与“保持原有层级结构”之间做出明确选择。
1. 策略 A:平铺输出到单个目标目录 (Flat Copy)
平铺策略将所有深层子文件夹内的目标文件全部汇总并放置在单一目标文件夹中。这种做法利于集中查阅,但在多级目录下容易遇到同名文件互相覆盖的严重隐患。
from pathlib import Path
import shutil

source_dir = Path("./multi_level_docs")
target_dir = Path("./flat_output")
target_dir.mkdir(parents=True, exist_ok=True)

# 递归匹配所有层级的 docx 文件
for file_path in source_dir.rglob("*.docx"):
    if file_path.is_file():
        target_path = target_dir / file_path.name

        # 同名防覆盖处理:若已存在同名文件,添加自增编号
        counter = 1
        while target_path.exists():
            target_path = target_dir / f"{file_path.stem}_{counter}{file_path.suffix}"
            counter += 1

        shutil.copy2(file_path, target_path)
2. 策略 B:保持原始相对层级结构 (Preserve Tree)
保持层级结构会在目标目录下镜像创建与源目录完全一致的子文件夹分支。这种做法不仅保留了文件的分类归属信息,更从物理结构上天然消除了同名冲突。
from pathlib import Path
import shutil

source_dir = Path("./multi_level_docs")
target_dir = Path("./mirror_backup")

for file_path in source_dir.rglob("*.docx"):
    if file_path.is_file():
        # 计算当前文件相对于源根目录的相对路径
        relative_path = file_path.relative_to(source_dir)
        target_path = target_dir / relative_path

        # 必须先创建该文件所在的各级父目录
        target_path.parent.mkdir(parents=True, exist_ok=True)
        shutil.copy2(file_path, target_path)
三、复制方法的选择与关键差异:copy vs copy2
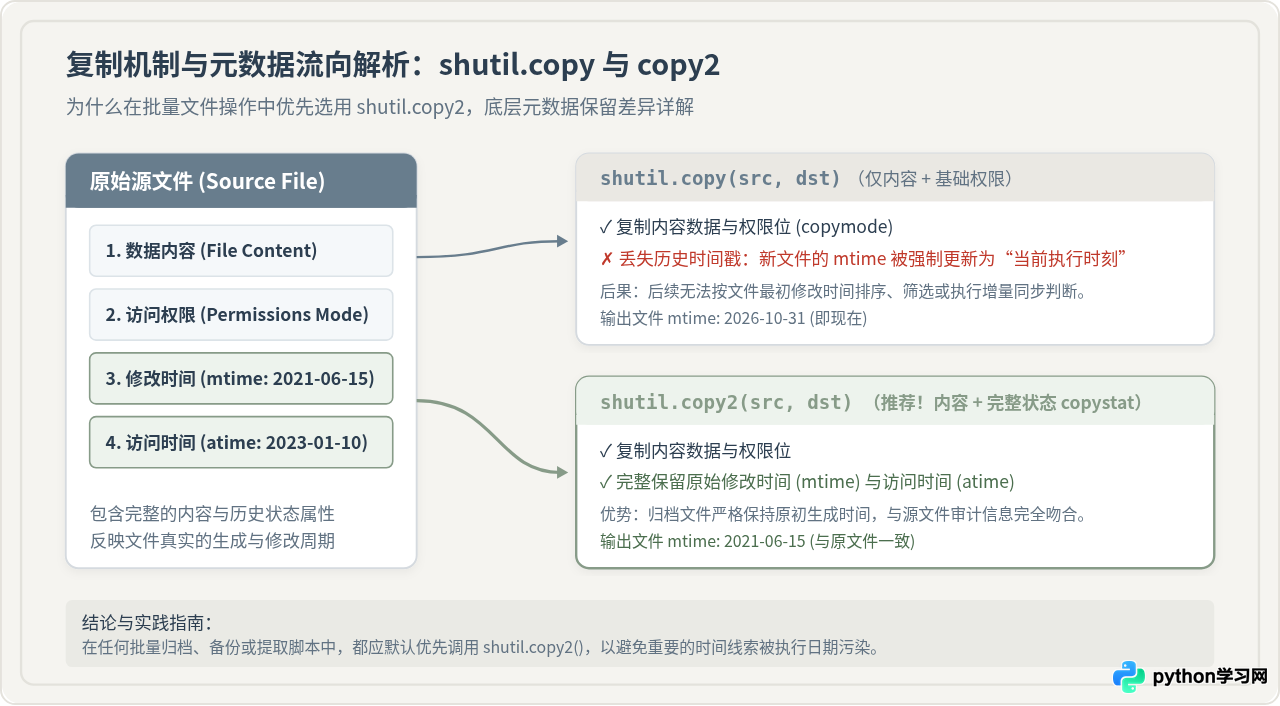
Python 的 shutil 模块提供了多个文件拷贝函数。初学者经常混淆 shutil.copy() 与 shutil.copy2(),两者在复制文件内容上完全一致,但在元数据(Metadata)保留机制上存在显著差异。
shutil.copy(src, dst):底层依次执行内容拷贝和权限标记同步(copymode)。文件内容和可执行权限得到保留,但文件的最后访问时间 (atime) 和最后修改时间 (mtime) 不会保留。在目标路径生成的新文件,其修改时间会被重置为执行复制操作的系统当前时间。shutil.copy2(src, dst):在完成内容与权限拷贝后,进一步调用系统级的copystat()。它会尽可能完整地复制文件的修改时间、访问时间、文件状态标志以及扩展属性(在支持该特性的操作系统上)。新文件的修改时间与原文件完全一致。
在批量处理归档文件或准备机器学习训练集时,这一差异至关重要。如果后续的数据分析流水线或增量备份系统依赖于文件的“原始生成/修改日期”来进行时间窗口过滤,误用 shutil.copy() 会导致所有历史文件的时间戳全部变为“今天”,从而破坏原有数据的时间维度完整性。因此,在批量复制任务中,推荐无条件优先使用 shutil.copy2()。
四、生产级实用脚本封装:支持多类型与冲突控制
为了在实际工作或工程项目中灵活复用,我们可以将上述逻辑封装为一个健壮的 Python 函数。该函数支持传入多个文件扩展名、自适应大小写敏感度、支持是否递归以及三种冲突处理策略(覆盖、跳过、自动重命名)。
from pathlib import Path
import shutil
from typing import Sequence

def batch_copy_files(
    source_path: str | Path,
    target_path: str | Path,
    extensions: Sequence[str],
    recursive: bool = True,
    preserve_structure: bool = False,
    conflict_action: str = "rename"  # 可选: 'rename', 'skip', 'overwrite'
) -> dict:
    """批量复制指定扩展名文件的通用封装函数。"""
    src = Path(source_path).resolve()
    dst = Path(target_path).resolve()

    if not src.exists() or not src.is_dir():
        raise ValueError(f"源目录无效或不存在: {src}")

    # 规范化扩展名格式(统一小写并确保以点开头)
    valid_exts = {ext.lower() if ext.startswith('.') else f'.{ext.lower()}' for ext in extensions}

    # 遍历源目录生成器
    file_iterator = src.rglob("*") if recursive else src.glob("*")

    stats = {"copied": 0, "skipped": 0, "errors": 0}

    for item in file_iterator:
        # 跳过目录以及目标目录本身(防止目标目录建在源目录下时引发无限嵌套)
        if not item.is_file() or dst in item.parents:
            continue

        # 检查扩展名(不区分大小写)
        if item.suffix.lower() not in valid_exts:
            continue

        try:
            # 计算目标落脚路径
            if preserve_structure:
                relative_file = item.relative_to(src)
                dest_file = dst / relative_file
            else:
                dest_file = dst / item.name

            dest_file.parent.mkdir(parents=True, exist_ok=True)

            # 冲突处理
            if dest_file.exists():
                if conflict_action == "skip":
                    stats["skipped"] += 1
                    continue
                elif conflict_action == "rename":
                    idx = 1
                    while dest_file.exists():
                        dest_file = dest_file.with_stem(f"{item.stem}_{idx}")
                        idx += 1
                elif conflict_action == "overwrite":
                    pass

            shutil.copy2(item, dest_file)
            stats["copied"] += 1

        except Exception as err:
            stats["errors"] += 1
            print(f"处理失败 [{item.name}]: {err}")

    return stats

# ----------------- 使用示例 -----------------
if __name__ == "__main__":
    result = batch_copy_files(
        source_path="./raw_dataset",
        target_path="./cleaned_dataset",
        extensions=[".png", ".jpg", ".jpeg"],
        recursive=True,
        preserve_structure=True,
        conflict_action="rename"
    )
    print("执行统计结果:", result)
执行统计结果: {'copied': 148, 'skipped': 0, 'errors': 0}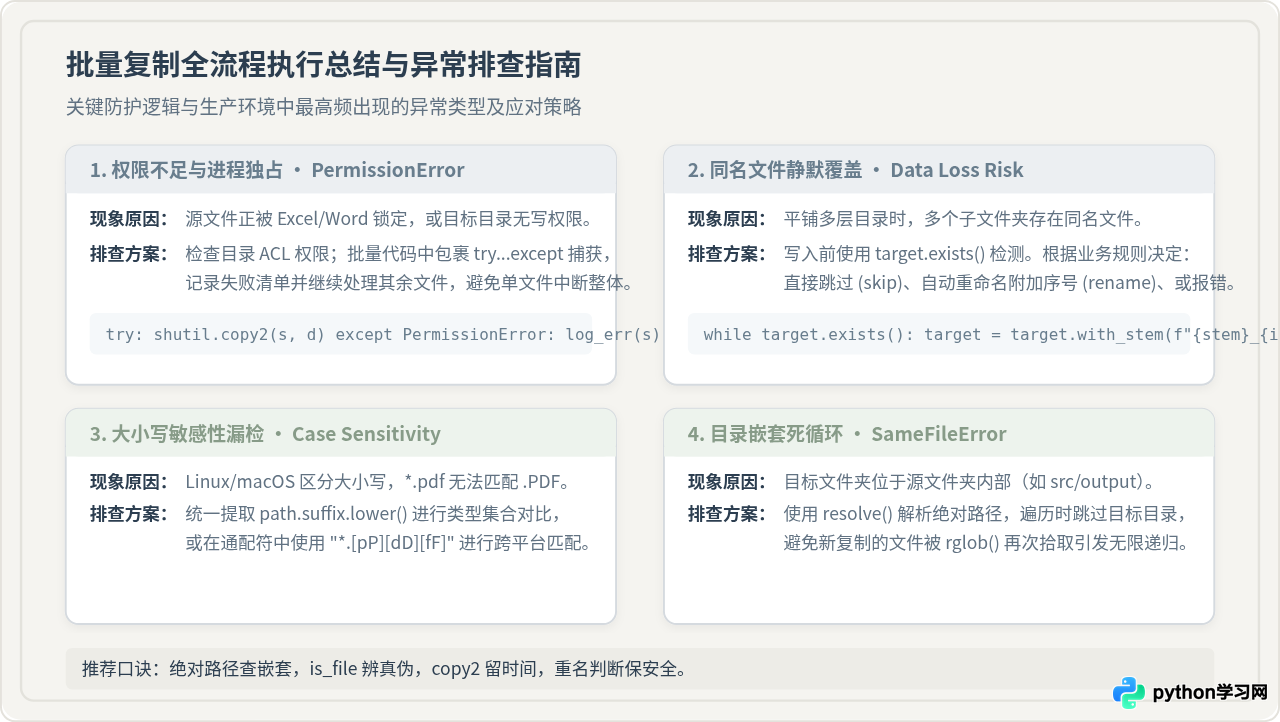
五、常见问题与关键避坑指南
在编写与运行批量文件复制程序时,以下几个边缘情况和平台特性极易引发程序异常或数据异常,需要特别注意:
1. 跨平台大小写敏感性 (Case Sensitivity)
Windows 系统的 NTFS 文件系统默认对文件名大小写不敏感,而 Linux 系统的 ext4 则严格区分大小写。如果在 Linux 环境下仅使用 glob("*.jpg"),以大写 .JPG 结尾的照片文件将被完全遗漏。最佳实践是在代码中通过 path.suffix.lower() 统一转为小写后再进行比对。
2. 避免目标目录置于源目录内部引发死循环
当执行递归复制(rglob)时,如果将目标输出路径直接放置在源文件夹内(例如源路径为 /data/files,而目标路径为 /data/files/backup),程序在扫描过程中会不断扫描到自己刚刚生成的文件,导致死循环并耗尽存储空间。代码中应在循环起始处通过 dst in item.parents 进行防御性跳过。
3. 进程独占与只读权限处理
如果源文件正被其他桌面程序(如 Office 软件或数据库管理工具)独占锁定,或者目标路径所在磁盘分区属于只读挂载,系统将抛出 PermissionError。在工业级批量搬运代码中,务必对单次 shutil.copy2 引入 try...except 异常捕获块,确保单个故障文件不会中断后续数百个正常文件的处理。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















