


Python自动化脚本常用模块有哪些?从标准库到第三方库选型指南
系统梳理Python自动化脚本的核心模块体系,覆盖文件处理、网络请求、系统运维与数据解析四大高频场景,提供标准库与第三方库的深度对比、决策推导流程与工程化落地实践指南。
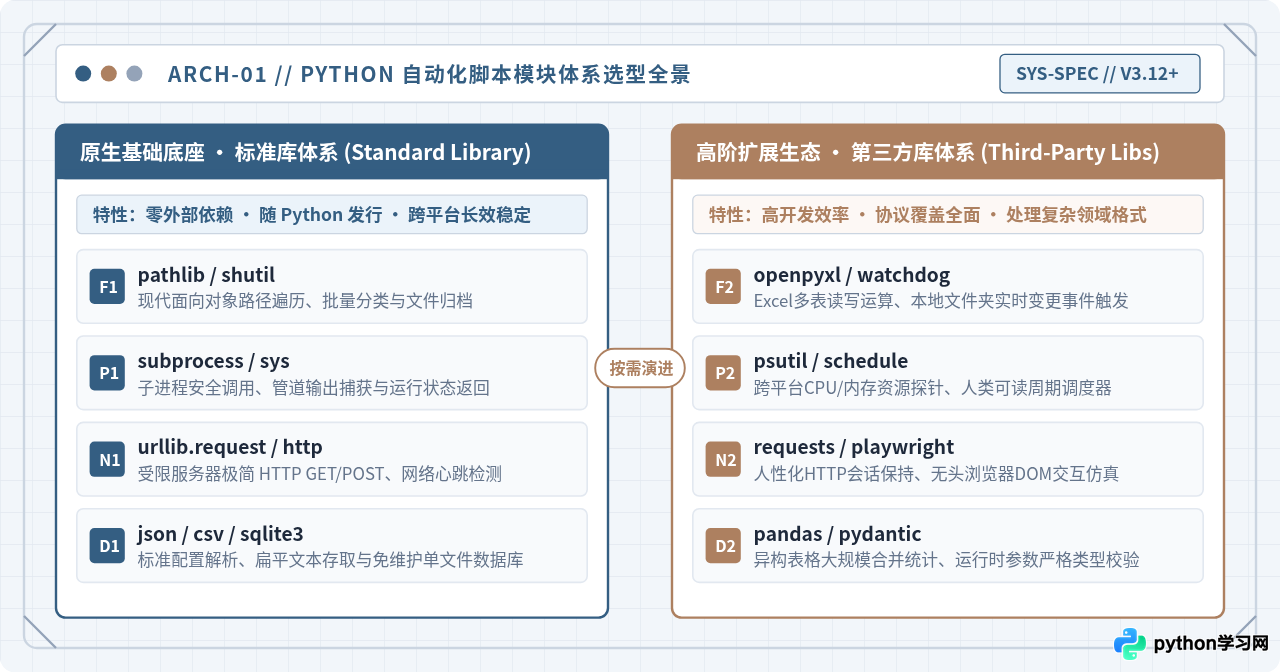
一、文件与路径自动化:从路径遍历到内容处理
文件归档、日志清理与批量格式转换是自动化脚本中最普遍的需求。很多开发者在处理路径时仍习惯沿用传统的 os.path 字符串拼接,但在现代 Python 中,这种方式已被更安全、跨平台的面向对象方案替代。
1. 标准库基准:pathlib 与 shutil
pathlib 是处理文件系统路径的现代标准,它将路径封装为 Path 对象,直接杜绝了不同操作系统(Windows 反斜杠与 Linux 正斜杠)的路径分隔符兼容问题。结合 shutil 模块,可以轻松完成文件复制、解包与目录整树归档。
from pathlib import Path
import shutil

def archive_logs(source_dir: str, target_dir: str, extension: str = ".log") -> int:
    # 1. 构造面向对象路径并确保目标归档目录存在
    src = Path(source_dir)
    dst = Path(target_dir)
    dst.mkdir(parents=True, exist_ok=True)

    moved_count = 0
    # 2. 递归检索匹配文件并实施原子化移动
    for file_path in src.rglob(f"*{extension}"):
        if file_path.is_file():
            target_path = dst / file_path.name
            shutil.move(str(file_path), str(target_path))
            moved_count += 1

    return moved_count

# 示例调用
count = archive_logs("./app_runtime", "./backup_logs")
print(f"归档完成,共转移 {count} 个日志文件")
2. 第三方扩展库:openpyxl 与 watchdog
标准库能够高效处理纯文本、.csv 和标准压缩包,但无法直接操作二进制办公文档。如果自动化任务要求生成带有单元格格式、公式或多 Sheet 页的 .xlsx 报表,首选第三方库为 openpyxl。
此外,若自动化脚本需要“事件驱动”(例如一旦有新文件落入指定目录,立即自动触发后续处理链路),单纯依靠轮询 pathlib.Path.iterdir() 会造成无谓的 CPU 空转。此时引入 watchdog 库能够绑定操作系统的底层文件系统事件(如 Linux inotify、macOS FSEvents),实现毫秒级事件通知。
如果仅仅是生成或提取几行 Excel 数据,使用 openpyxl 或标准库的 csv 即可,切勿仅仅为了几行数据而引入庞大的 pandas 及其底层的 numpy C扩展,否则会显著增加容器构建体积与部署耗时。
二、网络请求与接口交互:从轻量抓取到全真仿真
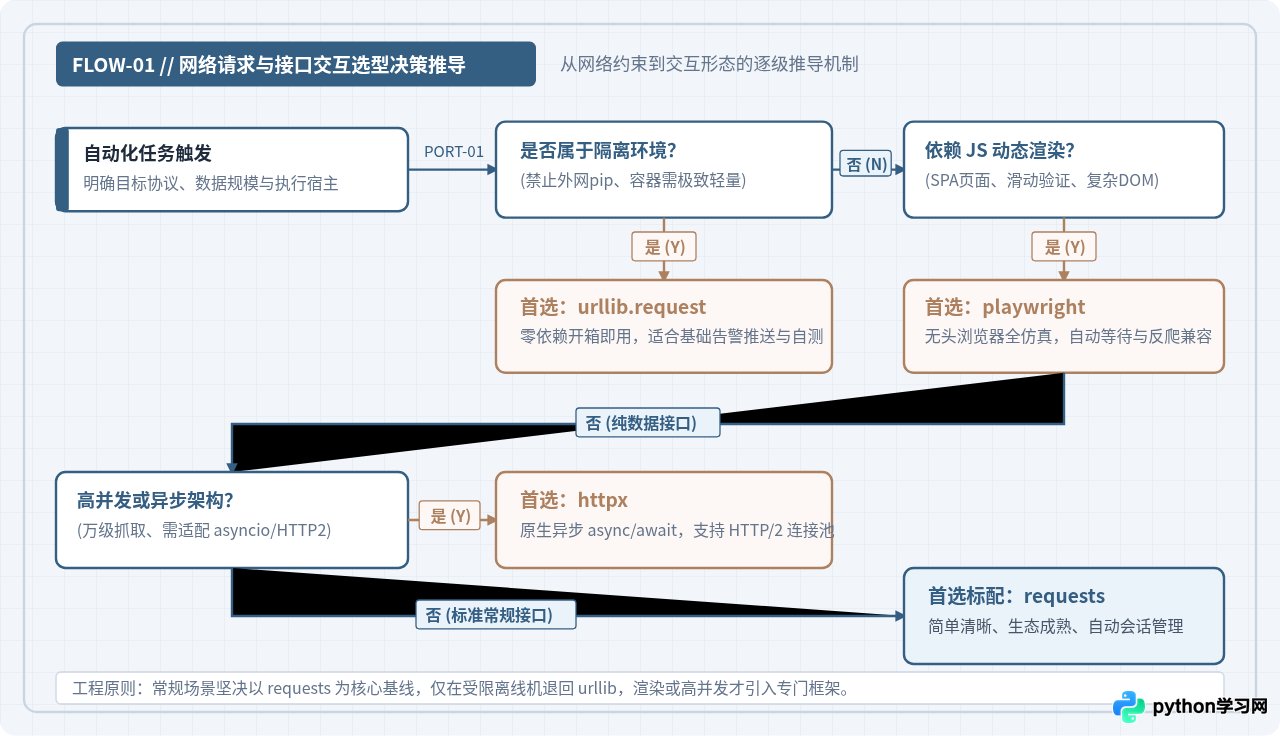
自动化脚本经常需要向监控告警群推送 Webhook 消息、调用第三方业务 API,或是抓取网页数据。根据网络环境与目标站点的反爬/渲染复杂度,选型分水岭极为明确。
1. 选型推导核心依据
- 内网/离线或极简推送:优先使用
urllib.request。虽然写法稍显冗长(需手动编码 URL 并构造 Request 对象),但其最大价值在于零外部依赖,能在任何纯净的服务器或精简基础镜像中直接运行。 - 标准 RESTful API 交互:首选
requests。它是 Python 自动化脚本事实上的黄金标准,API 表达自然,原生支持Session连接池复用、SSL 证书验证与 JSON 自动序列化。 - 高并发或异步 IO 架构:若单次脚本需要并发抓取数万个接口,或者正在基于
asyncio编写常驻服务,httpx是现代替代方案,兼具同步与异步接口,且支持 HTTP/2。 - 动态渲染与前端防爬:当目标站点是完全由 Vue/React 构建的 SPA 单页应用,或者包含滑动验证码与复杂事件监听时,常规 HTTP 客户端获取到的只有空白骨架。此时应果断选用
playwright,利用真正的无头浏览器执行 DOM 交互。
2. 生产级 requests 健壮调用范例
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

def create_robust_session(retries: int = 3, backoff: float = 0.5) -> requests.Session:
    session = requests.Session()
    # 针对特定状态码配置指数退避重试机制
    retry_strategy = Retry(
        total=retries,
        backoff_factor=backoff,
        status_forcelist=[429, 500, 502, 503, 504],
        allowed_methods=["GET", "POST"]
    )
    adapter = HTTPAdapter(max_retries=retry_strategy)
    session.mount("https://", adapter)
    session.mount("http://", adapter)
    return session

# 实际调用示例:必须显式指定 timeout,避免脚本被挂起死锁
session = create_robust_session()
try:
    response = session.post(
        "https://api.example.com/v1/notify",
        json={"status": "success", "job": "daily_backup"},
        timeout=(3.0, 10.0)  # (连接超时, 读取超时)
    )
    response.raise_for_status()
    print("消息推送成功:", response.json())
except requests.RequestException as err:
    print(f"网络交互异常: {err}")
三、系统管理与任务调度:底层进程隔离与健康巡检
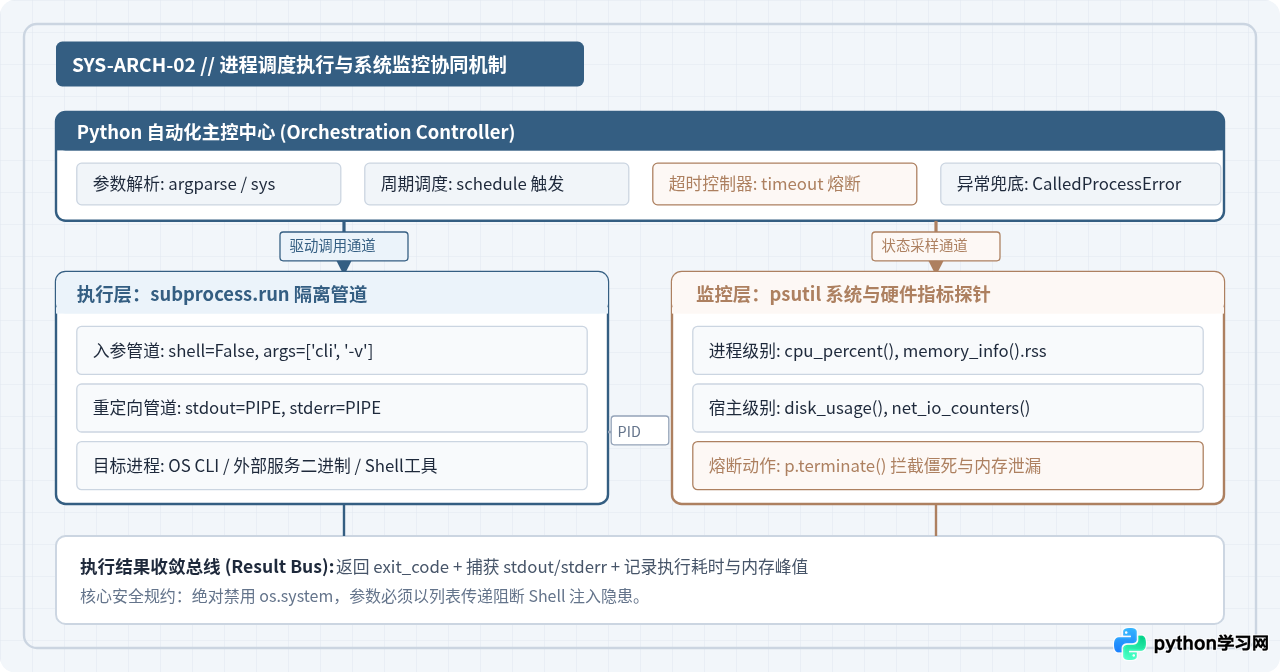
自动化脚本不仅需要在 Python 内部运算,常常还需要调用操作系统的原生 CLI 工具(如 git、docker、ffmpeg 或系统管理命令),并对宿主机的 CPU、内存资源进行监控与保护。
1. 为什么坚决淘汰 os.system,全面转向 subprocess?
许多初学者喜欢使用 os.system("command " + arg),这在生产环境中是极其危险的反模式:它容易引发 Shell 注入漏洞,无法安全捕获标准输出,且在不同操作系统下的退出码含义各不相同。
标准库推荐的现代方式是使用 subprocess.run,并通过列表传参隔离解析:
import subprocess

def execute_cli_tool(command_args: list[str], timeout_sec: int = 30) -> str:
    # 安全调用:shell=False 阻断注入,capture_output 统一重定向输出
    try:
        result = subprocess.run(
            command_args,
            shell=False,
            check=True,
            capture_output=True,
            text=True,
            timeout=timeout_sec
        )
        return result.stdout.strip()
    except subprocess.CalledProcessError as e:
        # 捕获非零返回码并输出错误详情
        print(f"命令执行失败 [Code {e.returncode}]: {e.stderr.strip()}")
        raise
    except subprocess.TimeoutExpired:
        print(f"命令执行超时 (超过 {timeout_sec} 秒)")
        raise

# 示例调用
output = execute_cli_tool(["git", "status", "--short"])
print("Git 状态输出:
", output)
2. 系统级探针与定时库:psutil 与 schedule
当自动化脚本作为长期后台任务执行时,需要防范内存泄漏或宿主机资源耗尽。此时标准库的能力相对有限,需要引入 psutil 跨平台获取 CPU 使用率、物理内存余量和磁盘空间,并能在特定子进程异常死锁时根据 PID 主动熔断。
而在任务触发层面,如果不想在宿主机中配置复杂的 crontab 或 Windows 任务计划程序,可以使用拟人化语法的 schedule 库完成脚本内的定时调度:
import schedule
import time

def job():
    print("正在执行定时同步任务...")

# 拟人化定时规则声明
schedule.every(10).minutes.do(job)
schedule.every().day.at("02:30").do(job)

# 循环维持驱动
while True:
    schedule.run_pending()
    time.sleep(1)
四、数据解析与配置管理:结构化持久化之道
自动化脚本在执行过程中,必然伴随配置读取、状态暂存和去重记录。
- 配置文件解析:对于通用配置,优先使用标准库内置的
json(适合接口格式配置)或configparser(适合.ini格式)。若项目规范统一采用.yaml,则需引入PyYAML;若配置项众多且要求在启动阶段强制校验数据类型与默认值,pydantic是当下的标准做法。 - 轻量级状态持久化:许多人在做爬虫抓取去重或增量同步时,第一反应是安装 Redis 或 MySQL。但对于单机自动化脚本而言,标准库内置的
sqlite3才是最优雅的解法——无需部署任何后台服务,单文件即可支撑百万级记录的快速索引与去重查询。
五、实战工程化选型:编写自动化脚本的五步落地指南
选型不是孤立地背诵库名称,而是一个将业务约束与技术成本进行匹配的过程。在真正着手编写脚本前,建议严格按照以下五步流水线推进:
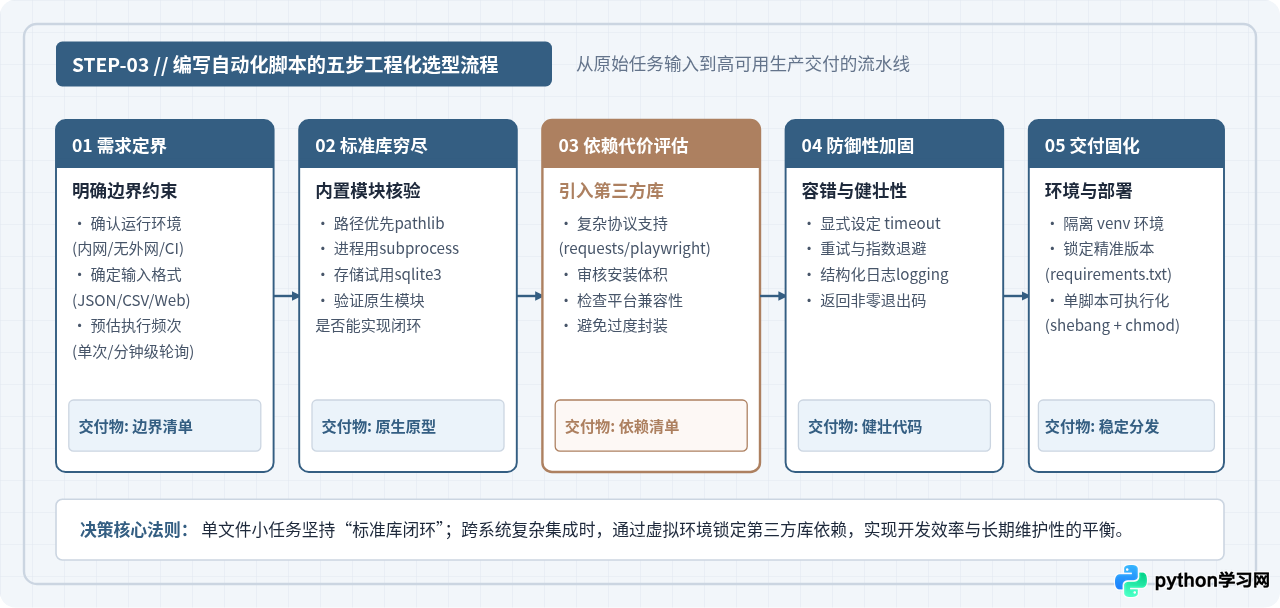
- 第一步:需求定界(明确边界与约束)
梳理输入源(本地文件、网络接口、系统命令)、输出物以及目标主机的网络状况。如果脚本将被部署到完全无法访问公网 pip 源的机房内网,选型阶段就必须将方案严格收敛至 Python 标准库内。 - 第二步:穷尽标准库(验证内置解决方案)
先判断pathlib、shutil、subprocess、json、sqlite3是否足以闭环。若内置功能仅需多写十行代码即可稳健实现,优先采用标准库方案。 - 第三步:评估第三方库引入代价
当标准库无法高效解决(如需要解析复杂 Excel、操作无头浏览器或保持复杂认证会话)时,引入第三方库。引入前需核实三点:该库是否仍在积极维护、是否引入庞大的 C/C++ 编译依赖、跨平台(Windows/Linux/macOS)安装是否顺畅。 - 第四步:构建防御性机制(健壮性设计)
自动化脚本往往在无人值守的后台运行,任何一次未捕获的异常或死锁都会导致整个流程中断。关键要求包括:- 所有网络请求与子进程调用必须显式设定超时时长(timeout);
- 合理使用标准库
logging记录结构化日志,切勿在生产环境全篇使用print; - 脚本异常终止时,必须退出非零状态码(
sys.exit(1)),以便宿主机监控或上层调度系统感知失败。
- 第五步:环境隔离与交付固化
只要引入了任何第三方依赖,都必须使用venv创建独立的虚拟环境,并通过requirements.txt精准锁定版本号(如requests==2.31.0),杜绝因上游库版本突变导致脚本在生产环境中崩溃。
六、高频场景模块选型速查矩阵
为了在实际开发中快速定位所需模块,下表将常用业务场景、标准库方案、进阶第三方库及决策分水岭进行了横向对照:
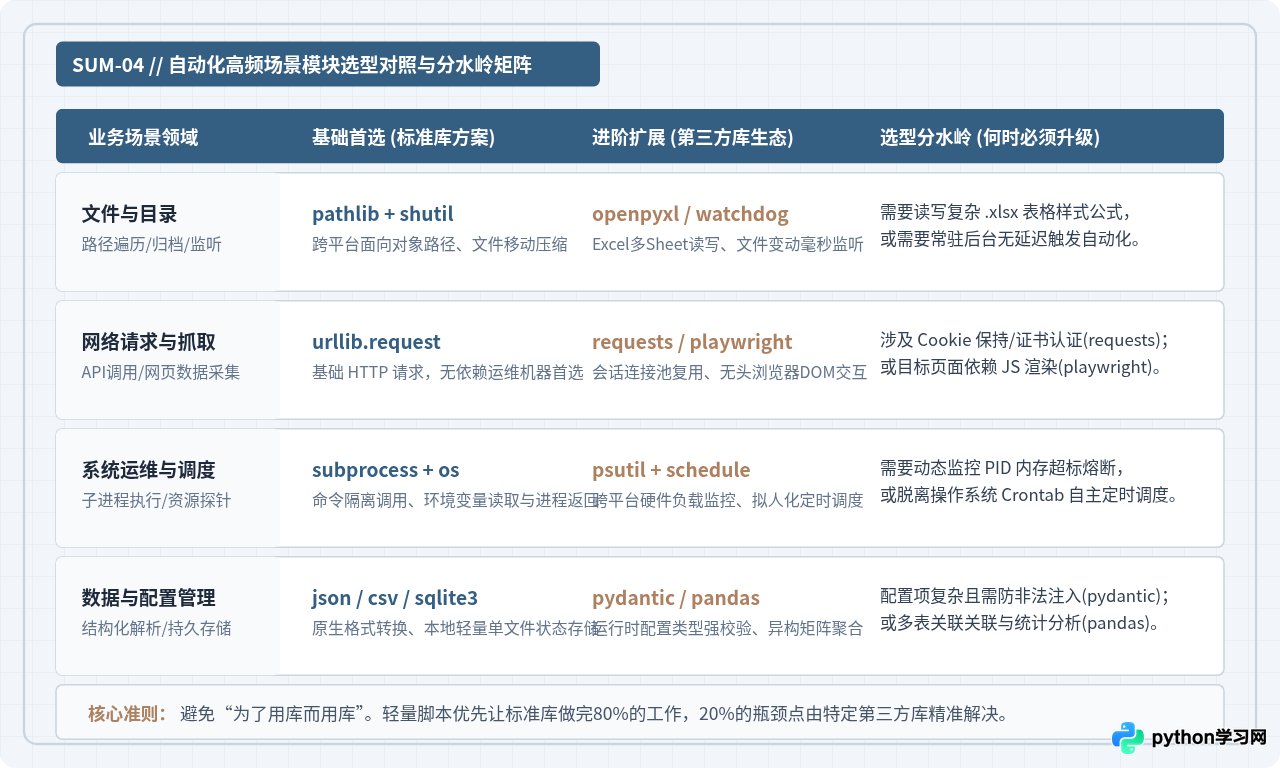
| 业务场景领域 | 标准库首选方案 | 进阶第三方库生态 | 选型分水岭(何时必须升级第三方库) |
|---|---|---|---|
| 文件与路径自动化 | pathlib、shutil |
openpyxl、watchdog |
需读写带有格式公式的 .xlsx 表格,或需对本地目录变动进行毫秒级监听触发。 |
| 网络请求与接口交互 | urllib.request |
requests、httpx、playwright |
涉及会话保持、复杂证书认证(requests);或目标站点完全依赖 JS 渲染(playwright)。 |
| 系统进程与运维管理 | subprocess、os |
psutil、schedule |
需跨平台监控硬件负载、杀僵死进程,或希望脱离系统 Crontab 实现代码级定时调度。 |
| 数据解析与配置存储 | json、csv、sqlite3 |
pydantic、pandas |
配置参数复杂需强制类型检查与防注入,或涉及大规模异构多表关联与聚合清洗。 |
七、总结
Python 在自动化领域的强大生命力,一方面源自其“电池内置”(Batteries Included)的标准库哲学,另一方面源自庞大而专业的第三方开源生态。在实际工程落地中,成熟的开发者从不盲目崇拜“轻量”或“全能”,而是始终以业务场景与交付稳定性为锚点:
用标准库构建坚实轻量、开箱即用的自动化骨架;用第三方库精准攻克格式解析、动态渲染与系统监控的痛点瓶颈。遵循这一思路构建的自动化脚本,不仅编写迅速,而且在长期运行中具备极佳的自愈能力与可维护性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















