


Python爬虫反爬策略:怎么设置请求头与控制频率避免封禁
详细讲解Python爬虫在请求头设置与访问频率控制两大维度的防封禁策略,提供成套请求头指纹对齐、高斯随机延迟、令牌桶限流与自适应指数退避的完整可运行代码。
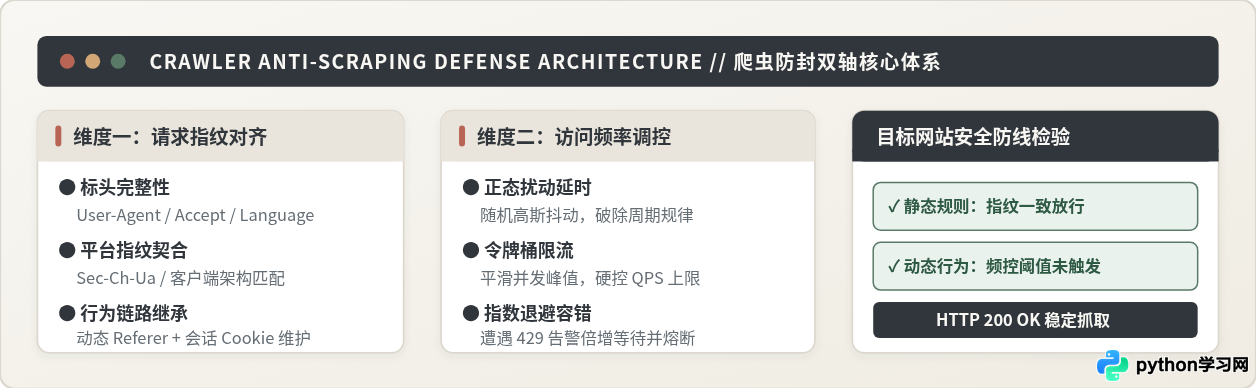
403 Forbidden,或在连续抓取数十页后遭遇 429 Too Many Requests 并遭到 IP 封禁。导致封禁的两大核心根源在于静态身份特征暴露(标头缺失或暴露爬虫库特征)与动态流量特征异常(机械高频或等距发包触发 WAF 统计阈值)。解决该问题的核心路径十分明确:一是规范化配置成套且内在逻辑自洽的请求头指纹,二是结合高斯正态抖动、令牌桶限速与自适应指数退避,将请求节奏控制在安全合规的合理区间。
一、为什么默认爬虫会被封禁:特征识别机制解析
现代网站与 Web 应用防火墙(WAF,例如 Cloudflare、AWS WAF、阿里云盾等)对访问客户端的审查,从来不是基于单一维度,而是从“你是谁”(静态指纹)和“你在怎么做”(动态行为)两个切面协同判定的。
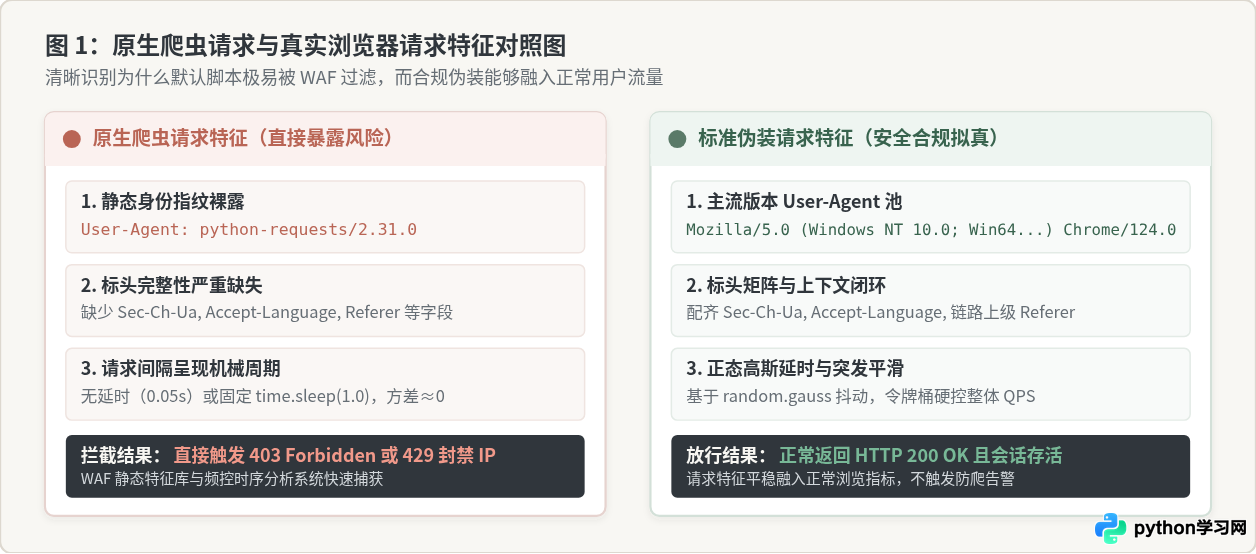
1. 静态身份特征的直接暴露
当使用 Python 原生库(如 urllib)或主流第三方库(如 requests、httpx)直接发起 HTTP GET 请求时,这些网络库会在协议层带上极其鲜明的默认标头。以 Python 中最普及的 requests 为例,其默认发送的请求头中包含:
User-Agent: python-requests/2.31.0
Accept-Encoding: gzip, deflate
Accept: */*
Connection: keep-alive
对于任何开启了基础反爬规则的网站而言,仅凭 python-requests 这个字符串,服务端就可以通过单条正则表达式以零成本直接拦截并返回 403 Forbidden。此外,更严密的 WAF 还会比对请求头的完整性矩阵:现代 Chrome 或 Safari 浏览器在发起页面跳转请求时,会默认附带包括 Accept-Language、Sec-Ch-Ua(客户端提示标头组)、Sec-Fetch-Dest、Sec-Fetch-Mode 等一系列规范化字段,完全缺失这些标头的请求会被直接标记为“高危自动化脚本”。
2. 动态访问行为的统计学破绽
许多初学者在意识到 User-Agent 泄露后,随手在代码中写上一句 headers = {"User-Agent": "Mozilla/5.0..."},但随后在循环抓取中要么不加任何延时,要么写死 time.sleep(1)。这种做法在服务端的时序分析器面前同样不堪一击:
- 绝对等差时序特征:人类在浏览网页、翻页或阅读内容时,每次点击的时间差必然存在离散度;而固定的
time.sleep(1.0)会使请求在时间轴上的间隔呈现方差几乎为零的完美周期性,极易被离散傅里叶变换或滑窗统计识别。 - 非人类并发峰值:并发线程或异步协程瞬间打出数十次请求,直接突破正常用户的 QPS(每秒请求数)物理极限,迅速触发反爬网关的频控黑名单。
二、规范化设置请求头:从伪装 User-Agent 到完整浏览器指纹
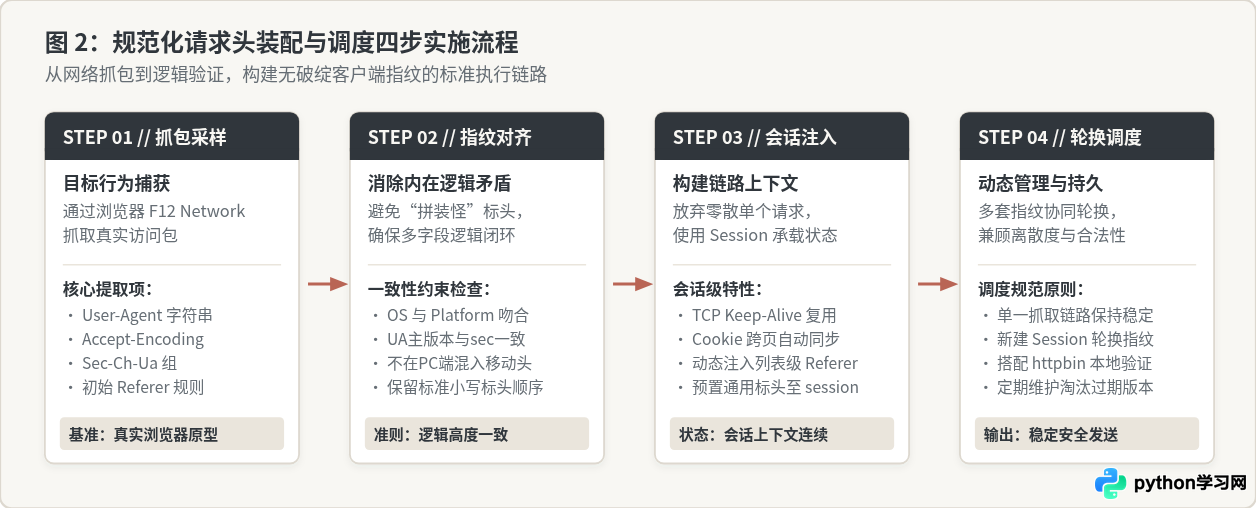
要让服务端将爬虫请求认定为正常浏览器,不能只替换单个 User-Agent 字段,而需要构建一套内在逻辑一致、上下文闭环的请求头环境。
1. 必须具备的核心请求头矩阵
在模拟真实桌面浏览器(以主流 Chrome 为例)时,一个健壮的请求头应当完整包含以下五组字段:
User-Agent:声明客户端系统架构与浏览器版本。必须采用市场上真实活跃的版本号,切忌自行杜撰。Accept:声明客户端期望接收的内容类型。例如请求 HTML 页面时应传入text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8。Accept-Language:声明客户端语言偏好,如中文环境下的zh-CN,zh;q=0.9,en;q=0.8。缺乏语言头的请求往往是机械爬虫的显著共性。Accept-Encoding:声明支持的压缩算法,常用gzip, deflate, br, zstd。开启后不仅符合浏览器行为,还能减少服务器传输带宽。Sec-Ch-Ua 系列标头:现代 Chromium 内核特有的客户端提示(Client Hints),包含sec-ch-ua、sec-ch-ua-mobile和sec-ch-ua-platform。Referer:告知服务器当前请求来源于哪个上级页面。在爬取多级目录、列表翻页或详情页时,传入合理的同站上一页 URL,能有效解除服务端“无来源跨站请求”的防盗链与防爬拦截。
User-Agent 中声明操作系统为 Macintosh; Intel Mac OS X 10_15_7,却在 Sec-Ch-Ua-Platform 中设置了 "Windows";或者在桌面端 UA 下带上了移动端专属的视口头。此类逻辑冲突会被现代智能 WAF 判定为高置信度伪装攻击,直接触发封禁。
2. 使用 requests.Session() 维系会话与 Cookie
在 Python 中,永远优先使用 requests.Session() 而不是反复调用 requests.get()。Session 实例不仅能够自动维持底层 TCP 握手与连接复用(Keep-Alive),避免频繁建立 TCP 连接带来的资源浪费与指纹重置,还会自动接收并跨请求传递服务端下发的 Set-Cookie,使爬虫在抓取链路中保持合法的身份状态。
3. 请求头池与会话装配实战代码
下面的代码演示了如何组织一套内在一致的真实请求头池,并封装成一个带有动态 Referer 跟踪与 Session 绑定的请求构造器:
# -*- coding: utf-8 -*-
import random
import requests

# 预置三套在 OS 与内核层面严格对齐的真实浏览器标头模板
BROWSER_FINGERPRINTS = [
    {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en-US;q=0.8,en;q=0.7",
        "Accept-Encoding": "gzip, deflate, br",
        "Sec-Ch-Ua": '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"',
        "Sec-Ch-Ua-Mobile": "?0",
        "Sec-Ch-Ua-Platform": '"Windows"',
        "Sec-Fetch-Dest": "document",
        "Sec-Fetch-Mode": "navigate",
        "Sec-Fetch-Site": "same-origin",
        "Sec-Fetch-User": "?1",
        "Upgrade-Insecure-Requests": "1",
    },
    {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/123.0.0.0 Safari/537.36",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
        "Accept-Encoding": "gzip, deflate, br",
        "Sec-Ch-Ua": '"Google Chrome";v="123", "Not:A-Brand";v="8", "Chromium";v="123"',
        "Sec-Ch-Ua-Mobile": "?0",
        "Sec-Ch-Ua-Platform": '"macOS"',
        "Sec-Fetch-Dest": "document",
        "Sec-Fetch-Mode": "navigate",
        "Sec-Fetch-Site": "none",
        "Sec-Fetch-User": "?1",
        "Upgrade-Insecure-Requests": "1",
    },
]

def create_custom_session(referer_url=None):
    """初始化一个携带合规指纹与链路上下文的 requests.Session"""
    session = requests.Session()
    # 为当前会话随机抽取一套高度对齐的真实标头
    fingerprint = random.choice(BROWSER_FINGERPRINTS).copy()

    if referer_url:
        fingerprint["Referer"] = referer_url
        fingerprint["Sec-Fetch-Site"] = "same-origin"

    session.headers.update(fingerprint)
    return session
三、精准控制访问频率:从简单随机延时到自适应退避机制
即便请求头伪装得天衣无缝,如果请求频率超过服务端的安全基线,IP 同样会在瞬间被加入黑名单。优秀的频率控制需要同时兼顾时间离散度、全局并发吞吐控制与异常反馈自适应性。
1. 正态高斯分布延时(Gaussian Jitter)
很多爬虫采用 random.uniform(1, 3) 产生均匀分布的随机数。但在统计学上,均匀分布在直方图上是一条平顶直线,这与人类翻阅网页的行为特征并不相符。真实用户的阅读时间通常符合以均值(μ)为中心、带有一小部分快速点击与少量长时间停顿的高斯正态分布。在 Python 中可借助 random.gauss(mu, sigma) 实现,同时设置截断上下限以防产生负值:
import time
import random

def human_delay(mean=1.8, std_dev=0.4, min_delay=0.8, max_delay=4.0):
    """基于高斯分布的拟人随机停顿"""
    delay = random.gauss(mean, std_dev)
    # 将延时严格约束在合理的安全阈值内
    clamped_delay = max(min_delay, min(delay, max_delay))
    time.sleep(clamped_delay)
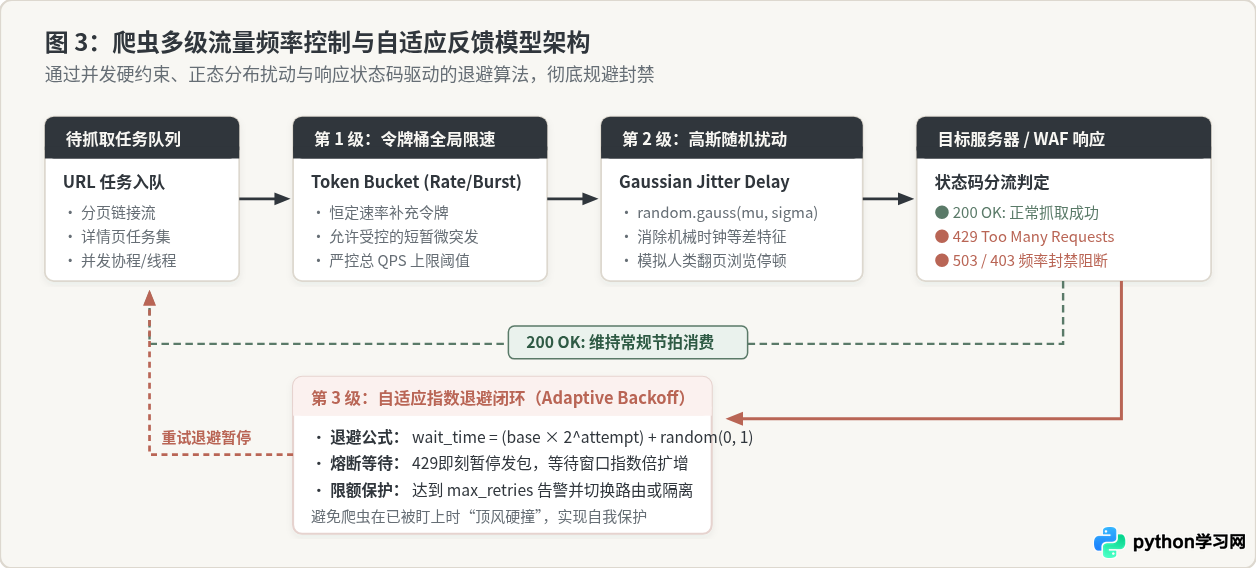
2. 令牌桶限流算法(Token Bucket Rate Limiting)
当爬虫采用多线程或异步请求时,每个独立的 Worker 无法准确感知整体的抓取速度。此时必须在进程层面引入令牌桶限流器。令牌桶以恒定的速率向桶中注入令牌,请求发出前必须先取得令牌;当桶满时令牌溢出,这既有效限制了整体的最大 QPS,又容许了在合理范围内的短暂轻度突发。
3. 自适应指数退避与抖动重试(Exponential Backoff with Full Jitter)
当目标服务器负载过大或察觉到访问较为密集时,常会返回 429 Too Many Requests 或 503 Service Unavailable。很多初级爬虫遇到此类状态码时会立即抛出异常并紧接着盲目重试,这种“撞墙式”访问会直接触发目标站点的 IP 永久封锁。
科学的做法是触发自适应指数退避:每次重试将等待时间按 2^attempt 成倍翻倍,并在等待时间上叠加一个随机抖动(Jitter),公式为:
T_wait = base_delay × (2 ^ attempt) + random_jitter
指数退避能够给受压的目标服务器或风控限流窗口足够的冷却恢复时间,大幅提升长时间爬虫作业的存活率。
四、综合实战:构建高可用的防封禁爬虫调度器
现在我们将上述请求头指纹对齐、会话上下文复用、令牌桶平滑限流以及遇到 429 时的指数退避重试完整整合成一个结构严谨、可直接运行的客户端类 SafeCrawlerClient。
# -*- coding: utf-8 -*-
import time
import random
import threading
import requests

class TokenBucket:
    """线程安全的令牌桶限流器,用于控制全局每秒最大请求数 (QPS)"""
    def __init__(self, rate=1.5, capacity=3.0):
        self.rate = rate          # 每秒补充的令牌数
        self.capacity = capacity  # 桶的最大容量(允许的最大突发数)
        self.tokens = capacity
        self.last_time = time.monotonic()
        self.lock = threading.Lock()

    def acquire(self):
        with self.lock:
            now = time.monotonic()
            elapsed = now - self.last_time
            self.last_time = now
            # 按照流逝时间补充令牌
            self.tokens = min(self.capacity, self.tokens + elapsed * self.rate)

            if self.tokens >= 1.0:
                self.tokens -= 1.0
                return

            # 令牌不足时计算需强制休眠的等待时间
            needed = 1.0 - self.tokens
            wait_time = needed / self.rate
            self.tokens = 0.0

        time.sleep(wait_time)


class SafeCrawlerClient:
    """集成了请求头指纹对齐、动态 Referer、令牌桶控速与自适应退避的爬虫客户端"""
    def __init__(self, max_qps=1.5, max_retries=3):
        self.limiter = TokenBucket(rate=max_qps, capacity=3.0)
        self.max_retries = max_retries
        self.session = requests.Session()
        self.current_referer = None
        self._init_session_fingerprint()

    def _init_session_fingerprint(self):
        """初始化严格合规的真实桌面端 Chrome 指纹"""
        self.session.headers.clear()
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
            "Accept-Language": "zh-CN,zh;q=0.9,en-US;q=0.8,en;q=0.7",
            "Accept-Encoding": "gzip, deflate, br",
            "Sec-Ch-Ua": '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"',
            "Sec-Ch-Ua-Mobile": "?0",
            "Sec-Ch-Ua-Platform": '"Windows"',
            "Sec-Fetch-Dest": "document",
            "Sec-Fetch-Mode": "navigate",
            "Sec-Fetch-Site": "none",
            "Sec-Fetch-User": "?1",
            "Upgrade-Insecure-Requests": "1"
        })

    def fetch(self, url, timeout=10):
        """执行单次安全受控的 HTTP GET 获取"""
        attempt = 0
        base_backoff = 2.0  # 退避基础等待秒数

        while attempt <= self.max_retries:
            # 1. 令牌桶限流保障全局节奏
            self.limiter.acquire()

            # 2. 注入模拟人类阅读的正态分布扰动延时 (均值1.2秒, 标准差0.3秒)
            jitter = max(0.5, random.gauss(1.2, 0.3))
            time.sleep(jitter)

            # 3. 动态更新上下文 Referer
            if self.current_referer:
                self.session.headers["Referer"] = self.current_referer
                self.session.headers["Sec-Fetch-Site"] = "same-origin"

            try:
                response = self.session.get(url, timeout=timeout)

                # 状态码 200:访问成功,记录当前 URL 作为下一跳 Referer
                if response.status_code == 200:
                    self.current_referer = url
                    return response

                # 状态码 429 或 503:触发自适应指数退避熔断
                elif response.status_code in (429, 503):
                    attempt += 1
                    backoff_delay = (base_backoff * (2 ** (attempt - 1))) + random.uniform(0.5, 1.5)
                    print(f"[限频警告] 遇到 HTTP {response.status_code},启动第 {attempt} 次指数退避,休眠 {backoff_delay:.2f} 秒...")
                    time.sleep(backoff_delay)
                    continue

                # 状态码 403:可能出现强指纹风控拦截
                elif response.status_code == 403:
                    print("[拦截警报] 遭遇 403 Forbidden,终止直接重试,需检查请求头指纹或代理 IP。")
                    return response

                else:
                    print(f"[非预期状态码] HTTP {response.status_code}")
                    return response

            except requests.RequestException as e:
                attempt += 1
                wait_time = base_backoff * attempt
                print(f"[网络异常] {e},将在 {wait_time} 秒后重试...")
                time.sleep(wait_time)

        raise RuntimeError(f"连续 {self.max_retries} 次尝试均未能成功获取页面: {url}")

    def close(self):
        self.session.close()


# 运行调用示例
if __name__ == "__main__":
    crawler = SafeCrawlerClient(max_qps=1.0)
    test_urls = [
        "https://httpbin.org/headers",
        "https://httpbin.org/get?page=1",
        "https://httpbin.org/get?page=2"
    ]
    try:
        for target in test_urls:
            print(f"正在请求: {target}")
            resp = crawler.fetch(target)
            print(f">> 响应状态: {resp.status_code}, 字节数: {len(resp.content)}")
    finally:
crawler.close()Referer 会自动递增承接上一跳地址。在面对偶发性的网络波动或 429 告警时,调度器会自动进入指数退避,而不是盲目密集冲击目标站点,从而保障了爬虫任务的长期稳定性。
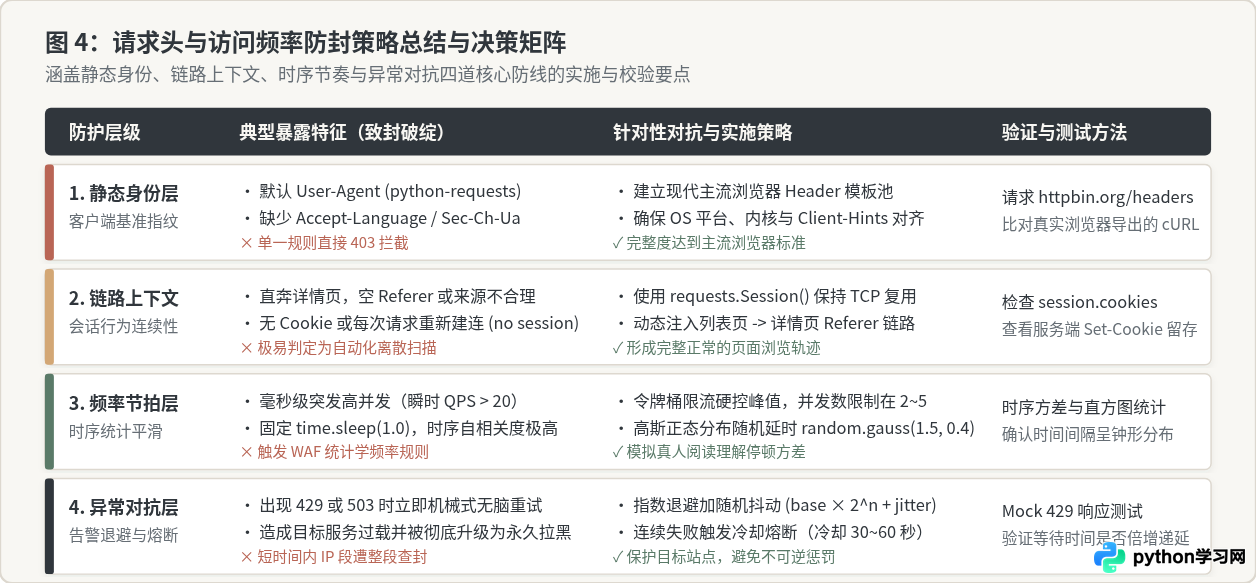
五、反爬防护策略速查与决策矩阵
为了便于在实际开发与故障排查时快速定位问题,下表将请求头配置与访问频率控制的四大关键防御层级、典型暴露特征、应对方案及核验方式进行系统化总结:
常见问题与关键边界提醒
- 必须使用 httpbin 或抓包工具自检请求头:编写完成爬虫后,切忌直接在目标站上盲跑测试。应先将目标指向
https://httpbin.org/headers或本地代理,打印输出自身发送的所有 Headers,逐项核对是否仍残留python-requests或字段拼写不一致。 - 尊重目标站的 robots.txt 与服务器负载:控制访问频率不仅是为了防封禁,更是保障数据采集具备技术合规性与网络道德的基础。任何爬虫都应避免占用目标服务器过大算力与带宽。
- 单 IP 物理承载极限:请注意,即便设置了完美的请求头和合理的随机延迟,单凭一个 IP 在单日内抓取数十万次同样是不合逻辑的。当单日抓取量级达到数万级以上时,应当在上述频率控制与请求头规范的基础上,进一步接入优质代理 IP 池进行流量离散分散。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















