


Python数据结构经典考题:列表与字典操作实战
深入解析Python中列表与字典的高频考题与实战操作,全面涵盖保持顺序去重、列表遍历删除的索引滑动陷阱、字典合并与频次累加、多字段复合排序以及哈希算法优化。
一、底层内存模型与操作特性基准
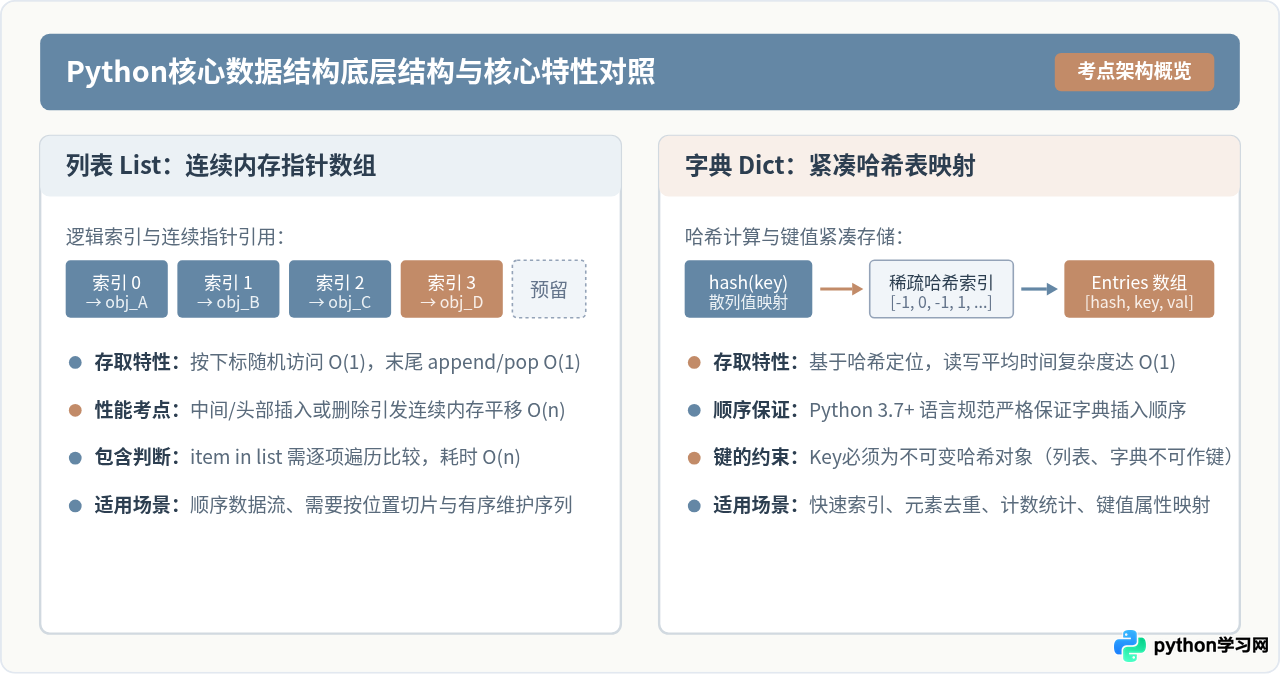
列表与字典在底层设计上的根本差异,决定了它们在不同操作场景下的性能表现。Python中的列表本质是一个动态的连续内存指针数组(PyListObject)。当通过下标访问列表元素时,计算机会根据起始地址和元素偏移量直接定位内存单元,因此按下标索引的时间复杂度为 O(1)。但是在列表中间或头部插入、删除元素时,其后方所有元素的内存指针必须整体向前或向后搬移,导致平均时间复杂度退化为 O(n)。
与列表不同,字典是基于哈希表实现的键值对集合(CPython 3.6+ 采用紧凑哈希表结构)。向字典写入或检索一个键时,解释器先计算键的哈希值(hash(key)),经过散列映射到稀疏哈希索引表,再关联到连续存储的紧凑条目数组。这一机制使得字典的键检索、插入和删除平均时间复杂度稳定在 O(1)。这种速度优势以额外的哈希开销和内存冗余为代价,并且要求键必须是不可变的哈希对象。
二、经典考题一:列表有序去重(保留原始顺序)
考题要求:给定一个包含重复元素的列表,例如 [3, 1, 2, 3, 2, 4],要求去除所有重复出现的元素,同时必须保留每个元素第一次出现时的相对先后顺序,即输出结果应为 [3, 1, 2, 4]。
常见误区:不少初学者会直接使用 list(set(seq))。虽然 set 能在 O(n) 时间内完成去重,但集合本身是无序哈希结构,转换为列表后原始元素的相对位置会被完全打乱,无法满足保留顺序的要求。
标准解法:利用字典键的插入顺序保证
从 Python 3.7 开始,语言官方规范正式确立了字典保留键插入顺序的语言特性。因此,最简洁且执行效率最高的标准做法是调用 dict.fromkeys():
def deduplicate_keep_order(seq):
    return list(dict.fromkeys(seq))

# 示例验证
raw_data = [3, 1, 2, 3, 2, 4, 1, 5]
result = deduplicate_keep_order(raw_data)
# 示例输出: [3, 1, 2, 4, 5]
dict.fromkeys() 在底层由 C 语言原生实现,遍历输入序列并以键的方式写入新字典。由于字典键具有唯一性,重复元素会被自然忽略,同时保留键的初次插入次序,最终通过 list() 提取出有序的去重列表。该方法的时间复杂度为 O(n),空间复杂度为 O(n)。
补充解法:辅助集合与列表推导式
在需要针对元素特定属性进行筛选,或者需要向下兼容低版本运行环境时,可以使用辅助集合记录已遍历元素:
def deduplicate_with_seen(seq):
    seen = set()
    return [x for x in seq if not (x in seen or seen.add(x))]

# 示例输出同样为: [3, 1, 2, 4, 5]dict.fromkeys() 或 set() 会抛出 TypeError: unhashable type 异常。此时应定义转换函数(例如提取唯一 ID 字段或使用 json.dumps / tuple 转换)作为去重判断的标识。
三、经典考题二:原地遍历删除的“跳项”陷阱与正解
考题要求:在不创建外部新列表对象的前提下(保持原有列表在内存中的引用地址不变),原地清除列表中所有满足特定条件的元素,例如移除列表中所有值为 2 的元素。
高频陷阱:直接在正向 for 循环中执行 lst.remove() 或 del。观察以下错误示例代码及其运行表现:
# 错误示例代码
nums = [1, 2, 2, 3, 4]
for item in nums:
    if item == 2:
        nums.remove(item)

# 打印实际结果:[1, 2, 3, 4]  -> 第二个 2 竟然没有被删除!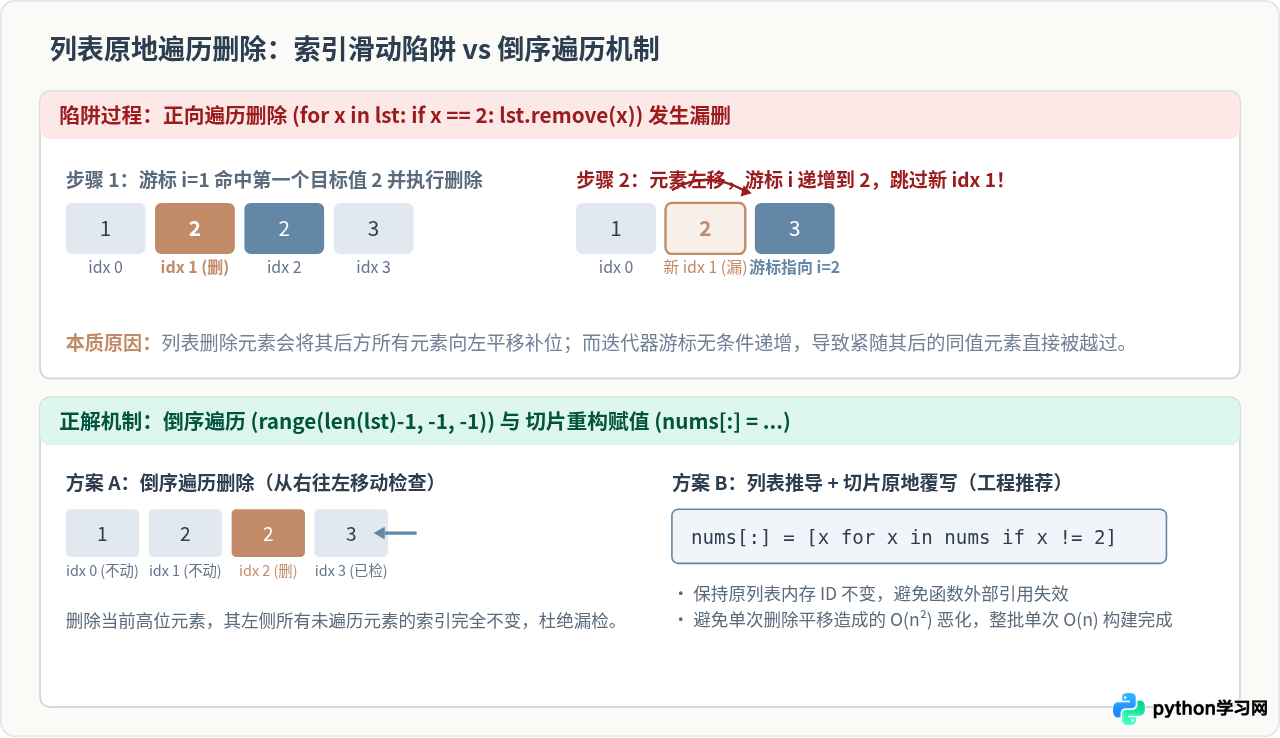
深度原理解析:Python 的 for 循环在遍历列表时,内部维护了一个自增的整数游标(从索引 0 开始逐一向后移动)。当游标到达索引 1 时,发现了第一个 2 并将其移除。列表底层为了填补空缺,将索引 2 处的第二个 2 以及后续元素整体向左平移一个位置,此时第二个 2 移动到了索引 1。然而在下一轮循环中,迭代游标无条件递增到了 2(指向了元素 3),刚好跳过了刚刚滑移到索引 1 的目标元素,从而导致漏删。
正解方案一:切片原地覆写(工程首选推荐)
通过列表推导式生成符合条件的新列表,再利用全切片语法 nums[:] = ... 将结果整体赋值回原列表内存槽位:
nums = [1, 2, 2, 3, 4, 2, 5]
# 切片赋值保持原对象 ID 不变
nums[:] = [x for x in nums if x != 2]

# 示例输出 nums: [1, 3, 4, 5]
使用切片赋值的优势在于:它不仅彻底避免了逐次调用 remove() 导致的大量连续内存位移(单次 remove 是 O(n),在循环中反复调用会恶化为 O(n²)),而且严格保持了原有列表对象的指针引用,外部传入该列表的函数上下文也能同步感知修改。
正解方案二:逆序索引遍历删除
如果限制必须使用 del 逐项进行物理销毁,必须采用倒序遍历:
nums = [1, 2, 2, 3, 4, 2, 5]
for i in range(len(nums) - 1, -1, -1):
    if nums[i] == 2:
        del nums[i]

# 示例输出 nums: [1, 3, 4, 5]
从末尾向头部移动时,删除高位索引的元素只会引发其右侧已处理区域的微调,左侧尚未检查的所有低位元素索引完全不受影响,因而能够百分之百保证遍历的完整性。
四、经典考题三:字典合并与键冲突更新策略
考题要求:将两个包含部分重叠键的字典合并为一个完整字典。分别处理“后值覆盖前值”的常规合并,以及“同名键数值累加”的分组统计场景。
常规合并:后值覆盖策略
在现代 Python 开发中,有三种标准语法可以实现常规字典合并:
- 联合运算符(Python 3.9+):
merged = dict1 | dict2,语法语义最清晰,返回一个合并后的新字典,dict2中的值覆盖dict1中的同名键。 - 字典解包表达式:
merged = {**dict1, **dict2},跨版本兼容性强,性能与运算符合并相当。 - 原地更新方法:
dict1.update(dict2),直接修改dict1本身,无额外返回新字典。
进阶考题:同名键数值累加合并
在日志统计或词频统计场景中,考官常常要求同名键的值进行数值相加,而非简单粗暴地覆盖。此时标准库中的 collections.Counter 是最为优雅高效的解决方案:
from collections import Counter

dict_a = {"apple": 5, "banana": 3, "orange": 2}
dict_b = {"apple": 2, "banana": 4, "grape": 6}

# 使用 Counter 进行频次累加
counter_merged = dict(Counter(dict_a) + Counter(dict_b))

# 示例输出: {'apple': 7, 'banana': 7, 'orange': 2, 'grape': 6}
如果要求不导入外部库、纯原生实现,则应结合字典遍历与 dict.get() 完成聚合:
def merge_with_sum(d1, d2):
    result = d1.copy()
    for k, v in d2.items():
        result[k] = result.get(k, 0) + v
    return result
五、经典考题四:字典多字段与复合规则排序
考题要求:给定一组存储在字典中的学生成绩数据,字典的键为学生姓名(字符串),值为考试分数(整数)。要求对数据进行排序:首要规则是按考试成绩从高到低(降序)排列;次要规则是当成绩相同时,按学生姓名首字母升序(自然字典序)排列。
解题路径:字典本身作为映射结构不能直接原地排序,所谓的“字典排序”是指对其键值对视图 items() 进行排序,提取排序后的元组序列,或者在 Python 3.7+ 下将其重构为有序新字典。
scores = {
    "Alice": 85,
    "Bob": 92,
    "Charlie": 85,
    "David": 78,
    "Eve": 92
}

# 复合条件排序:成绩降序 (-item[1]),姓名升序 (item[0])
sorted_list = sorted(scores.items(), key=lambda item: (-item[1], item[0]))

# 转换为保持顺序的有序新字典
sorted_dict = dict(sorted_list)

# 打印示例验证:
# Bob(92) 与 Eve(92) 成绩相同,Bob 字典序在前;
# Alice(85) 与 Charlie(85) 成绩相同,Alice 字典序在前。
# 示例输出:
# {'Bob': 92, 'Eve': 92, 'Alice': 85, 'Charlie': 85, 'David': 78}(k1_a, k1_b) 与 (k2_a, k2_b) 时,先比对第一项,若第一项不分胜负,再比对第二项。数值前加负号 -item[1] 巧妙地将内置的升序比较逆转为降序效果,同时允许第二项 item[0] 保持默认的文本升序,避免了编写冗长复杂的自定义比较器。
六、经典考题五:利用字典哈希将二次方复杂度优化为线性复杂度
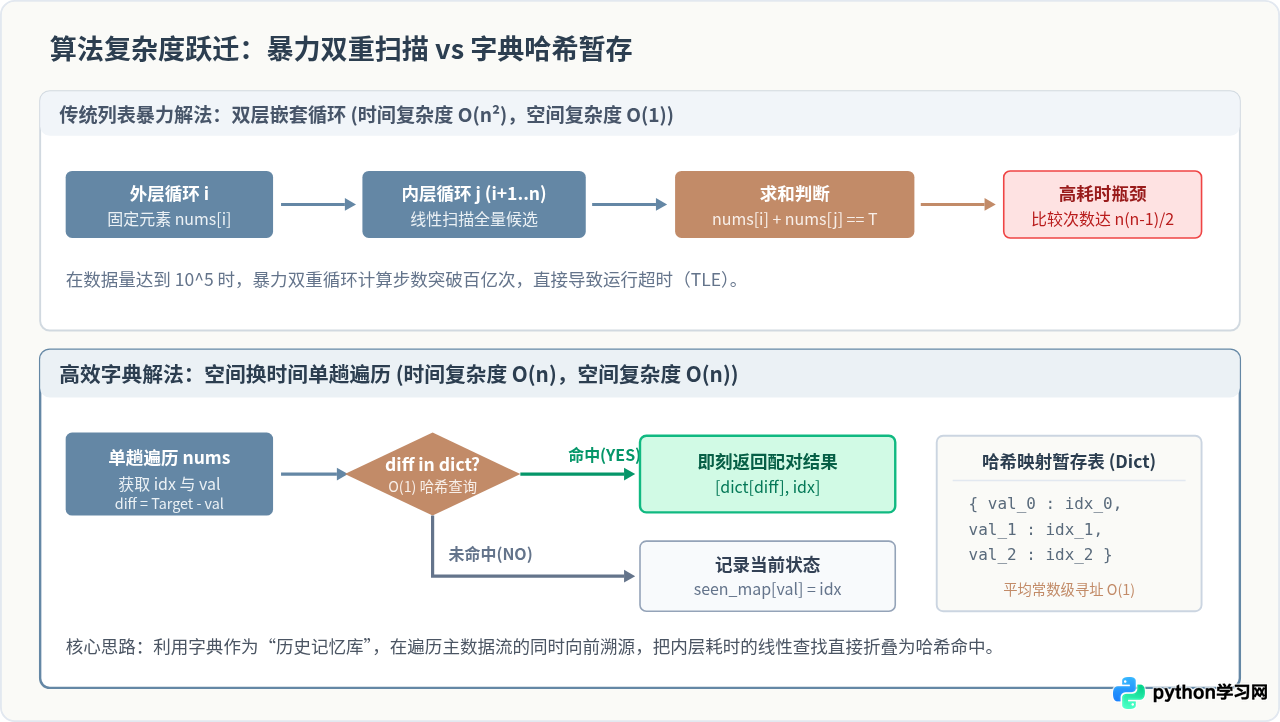
考题背景:以经典算法题“两数之和(Two Sum)”为代表:给定一个整数列表 nums 和一个目标总和 target,需要在列表中找出两个不同位置的数字,使其和等于目标值,并返回它们的下标。
暴力解法的性能瓶颈:使用双层嵌套循环,外层固定 nums[i],内层从 i+1 到末尾逐项扫描 nums[j] 并比对和值。该解法的时间复杂度是 O(n²)。当列表规模达到 100,000 时,运算量达到数十亿次,程序会直接遭遇运行超时。
标准解法:空间换时间单趟哈希映射
利用字典作为“历史记忆查找表”,把内层耗时的线性扫描转换为字典的常数级 O(1) 哈希查找:
def two_sum(nums, target):
    # 建立哈希映射:数值 -> 对应列表下标
    seen_map = {}

    for idx, num in enumerate(nums):
        complement = target - num
        # 在常数时间 O(1) 内检索差值是否存在于已遍历字典中
        if complement in seen_map:
            return [seen_map[complement], idx]
        # 未命中则记录当前数值与其下标,供后续数字查询
        seen_map[num] = idx

    return []

# 示例验证
numbers = [2, 7, 11, 15]
target_val = 9
print(two_sum(numbers, target_val))
# 示例输出: [0, 1]
整个过程只需要遍历一次列表,单次遍历内字典查询与插入均为 O(1),整体时间复杂度降至严格的 O(n),空间复杂度为 O(n)。这一解法展示了利用字典哈希特性优化数据处理性能的核心思想。
七、知识体系总结与复杂度速查手册
掌握列表与字典的高阶实战技能,核心在于建立精准的“时空复杂度敏感度”。在日常开发与算法考核中,应根据具体的读写频次合理选用数据结构:对于需要频繁在序列中间进行插入或删除的场景,应考虑使用双端队列 collections.deque 替代传统列表;对于高频成员判定(x in container),应优先构建集合或字典;在列表遍历删除时,务必使用切片覆写或倒序遍历以规避索引滑动漏洞。
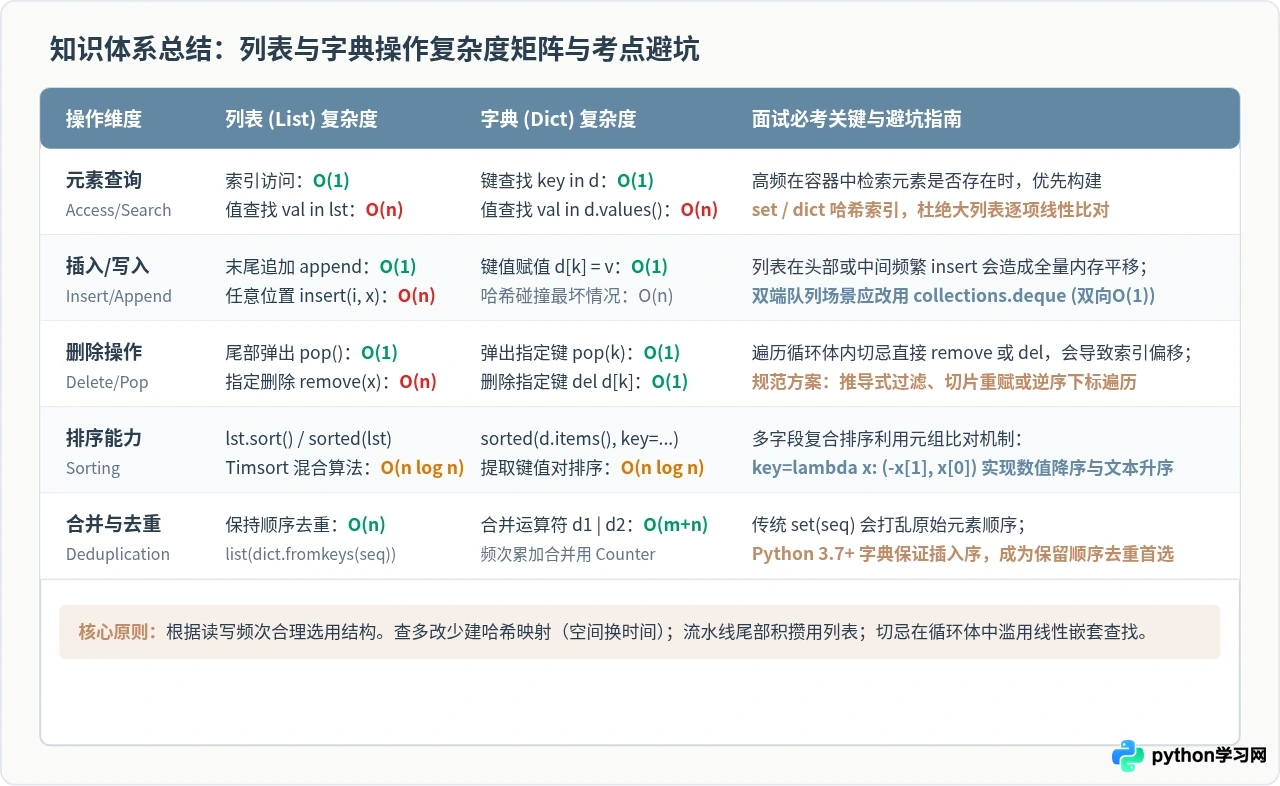
list(dict.fromkeys(seq)),利用官方规范的插入序特性。2. 遍历删除元素:切忌直接正向
remove,首选 nums[:] = [x for x in nums if condition] 保持原列表引用。3. 复合排序规则:
sorted() 的 key 采用元组 lambda x: (-x[1], x[0]) 组合降序与升序。4. 高耗时嵌套优化:通过字典暂存已遍历状态,将
O(n²) 嵌套扫描压缩为单趟 O(n) 哈希检索。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















