


Python官方教程中文版怎么用:文档结构与阅读指南
全面解析 Python 官方中文文档的体系结构与高效查阅方法,拆解教程、标准库参考、语言参考手册与进阶专题的分工边界,提供实用的检索步骤、规范解读与阶段化阅读路线。
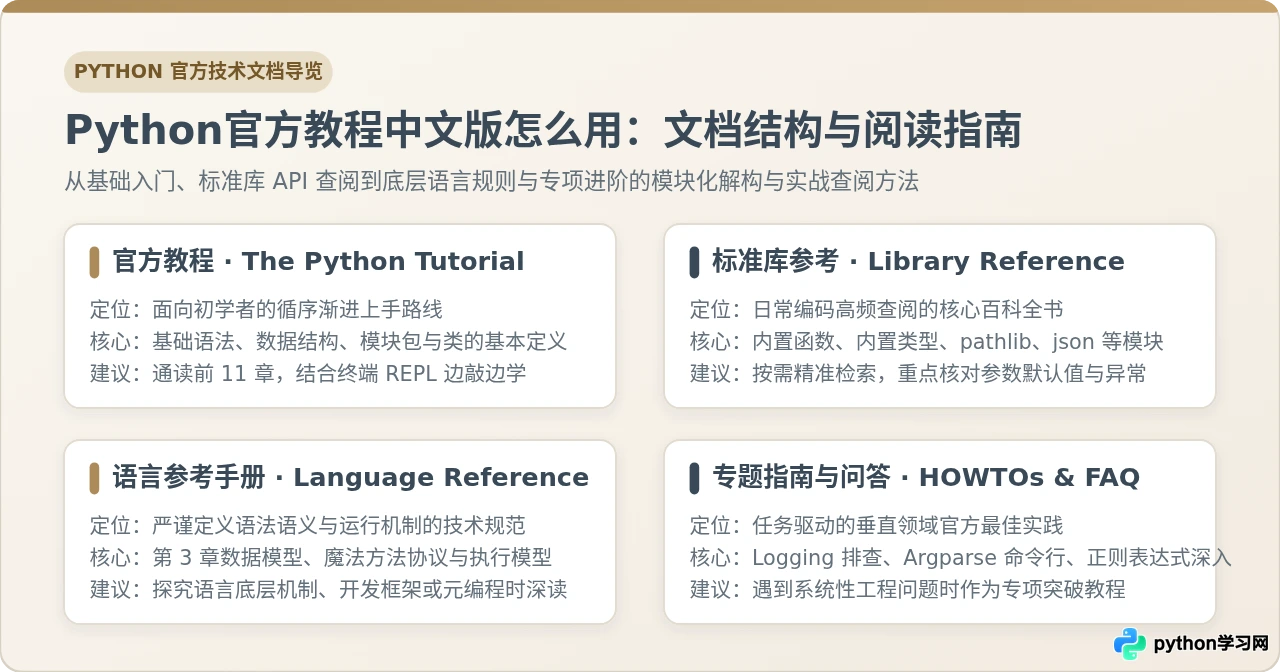
一、认识官方中文文档的四大核心支柱
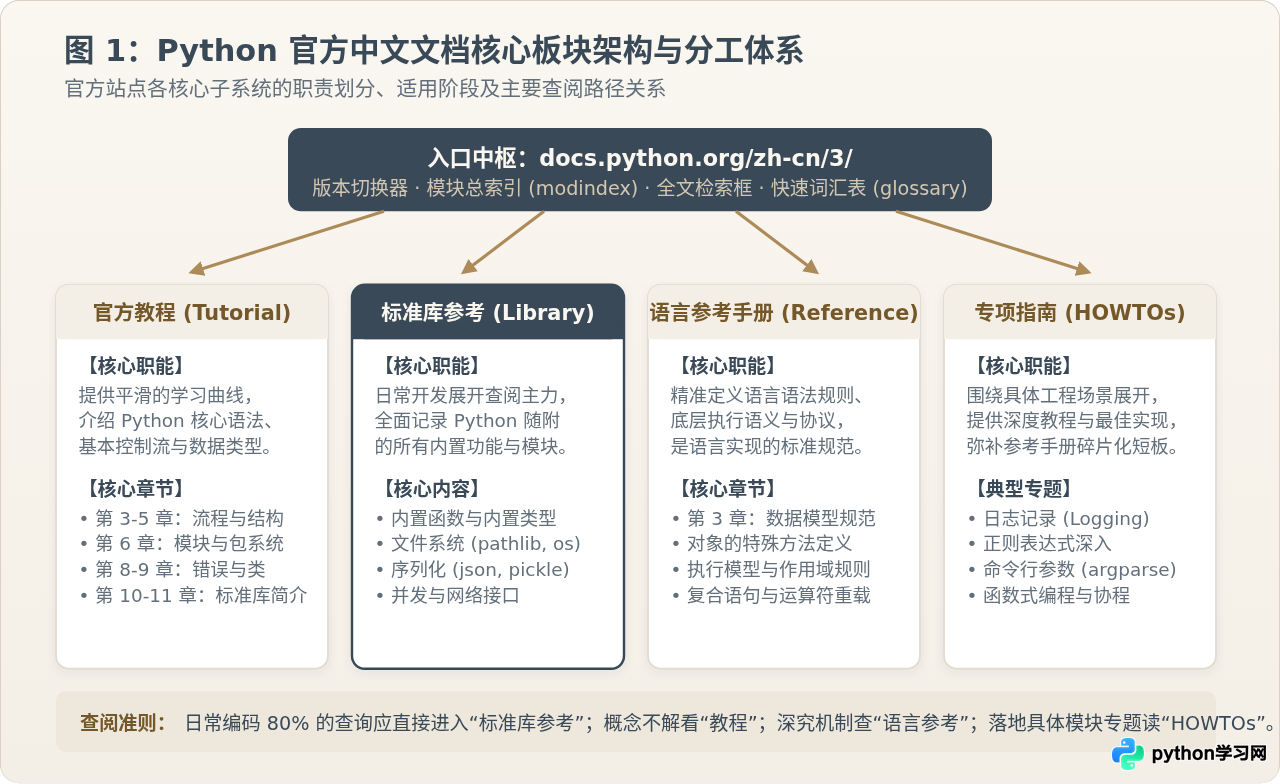
访问 Python 官方中文文档主站(docs.python.org/zh-cn/3/)时,首页罗列了大量章节链接。初次接触的读者往往容易无所适从。要理清整个站点,首先需要理解官方文档的四大核心板块及其分工:
1. 官方教程(The Python Tutorial)
官方教程通常对应目录下的“Python 教程”或 URL 路径中的 tutorial/。它的定位是渐进式入门指南。作者 Guido van Rossum 编写这本教程的初衷,是让具备基础编程概念的人快速掌握 Python 独有的语法风格与交互习惯。教程从最基本的计算器用法、控制流、常用数据结构,一路讲到模块、类和标准库简介。
它的特点是文字平实、代码简短,重在启发开发者建立正确的语言心智模型,并不追求穷尽所有参数或复杂边界。因此,这里适合通读,但不适合作为开发时的穷尽式 API 字典。
2. 标准库参考(The Python Standard Library)
标准库参考(URL 路径中的 library/)是日常开发中查阅频次最高的部分,占据了绝大多数工程师 80% 以上的查阅时间。Python 倡导“电池自带(Batteries Included)”理念,内置函数、内置类型(如字典、列表、集合)以及标准库附带的各类工具模块(如 pathlib、json、re、sys、os、datetime)都在这一板块中得到穷尽式的详细阐述。
在标准库参考中,每个函数都附有明确的调用签名、入参类型要求、默认值、抛出异常以及跨版本变更记录。无论实现什么具体功能,只要涉及标准库组件的调用细节,这里都是权威来源。
3. 语言参考手册(The Python Language Reference)
语言参考手册(URL 路径中的 reference/)是一份形式化的语言规范。它不关心具体怎么读写文件或发送网络请求,而是严格定义 Python 这门语言本身的词法分析、语法树规则、数据模型(Data Model)和执行模型。
许多进阶开发者推崇的“Python 核心底层机制”,例如 __init__、__enter__、__call__ 等特殊魔术方法如何被解释器调度,属性查找的 MRO 顺序如何运作,生成器与协程的挂起恢复机制,其最严谨的依据全部在语言参考手册的第 3 章“数据模型”中。日常写业务逻辑时无需每日查阅,但在设计框架、封装底层接口或排查疑难机制时,这里是终极答案。
4. 专题指南与常见问题(Python HOWTOs & FAQ)
标准库参考由于追求全面,往往采用“字典式”列举,缺乏连贯的系统性示例。为了解决这一落差,官方推出了“Python 常用指引(HOWTOs)”。每个 HOWTO 聚焦一个明确的工程场景,例如“正则表达式 HOWTO”、“日志记录(Logging)指引”、“使用 argparse 编写命令行”等,从基础概念一直讲解到企业级最佳实践。
二、日常查阅官方文档的 4 步标准流
遇到开发疑问或需要调用未曾接触过的库函数时,按照规范的操作流查阅官方文档,能够快速定位准确信息并杜绝版本兼容性隐患。推荐遵循以下四个步骤:
步骤 1:判定问题类型,锁定文档入口
在打开浏览器搜索之前,先在心中界定当前疑问属于哪一类:
- 概念或基本语法模糊(例如列表推导式的执行顺序):直接进入官方教程(Tutorial)对应章节。
- 具体函数怎么传参、有什么返回值(例如
pathlib.Path.rglob的使用细节):直接进入标准库参考(Library Reference)。 - 底层机制与协议行为存疑(例如自定义上下文管理器需要实现哪些魔术方法):直接查阅语言参考手册(Reference)第 3 章。
- 特定工程任务需要系统实现方案(例如如何优雅地组织多文件日志输出):查阅 HOWTOs 专题指南。
步骤 2:核对目标 Python 版本与中文语言标识
Python 在持续演进,不同小版本之间的新增特性与弃用行为存在差异。查阅文档时,第一件事是确认当前阅读的版本与代码运行环境一致:
# 终端执行命令确认本地 Python 版本
python3 --version
# 输出示例: Python 3.12.3
官方文档页面的左上方提供了下拉版本选择器。URL 结构通常遵循规范模式:
https://docs.python.org/zh-cn/3.12/library/pathlib.html
                       ▲     ▲
                     语言代码 版本号
如果当前开发使用的是 Python 3.10,就不要在 3.13 的文档页面中查阅特性,否则可能使用了高版本才引入的参数而导致生产环境报错。
步骤 3:善用两大官方导航利器:模块索引与词汇表
遇到具体的模块名时,无需在左侧长长的目录树中逐层展开,页面顶部的“模块索引”(Global Module Index,URL 锚点为 py-modindex.html)按英文字母 A-Z 罗列了所有内置模块。直接在页面内按下 Ctrl + F(Mac 下 Cmd + F)输入模块名称即可直达目标文档。
如果遇到晦涩的术语(如 duck-typing 鸭子类型、iterable 可迭代对象、generator 生成器、EAFP 与 LBYL 等),页面顶部的“词汇表”(Glossary)提供了官方最精准的中文概念定义,避免被二手资料模糊误导。
步骤 4:研读文档条目范式并在交互终端验证
官方文档的 API 说明遵循统一的排版规范。以下以常见的 sorted() 函数为例说明其阅读要点:
sorted(iterable, /, *, key=None, reverse=False)
Return a new sorted list from the items in iterable.- 正斜杠
/之前:表示左侧参数必须为位置参数(Positional-only),不能使用关键字传参(如sorted(iterable=my_list)会报错)。 - 星号
*之后:表示右侧参数必须以关键字形式传入(Keyword-only),如key和reverse。 - 等号后的值:表示该参数为可选参数,并注明了缺省默认值。
在理解签名后,打开本地终端的交互式环境(REPL)进行单行验证,确认返回值符合预期:
>>> fruits = ['banana', 'apple', 'cherry']
>>> sorted_fruits = sorted(fruits, key=len, reverse=True)
>>> print(sorted_fruits)
['banana', 'cherry', 'apple']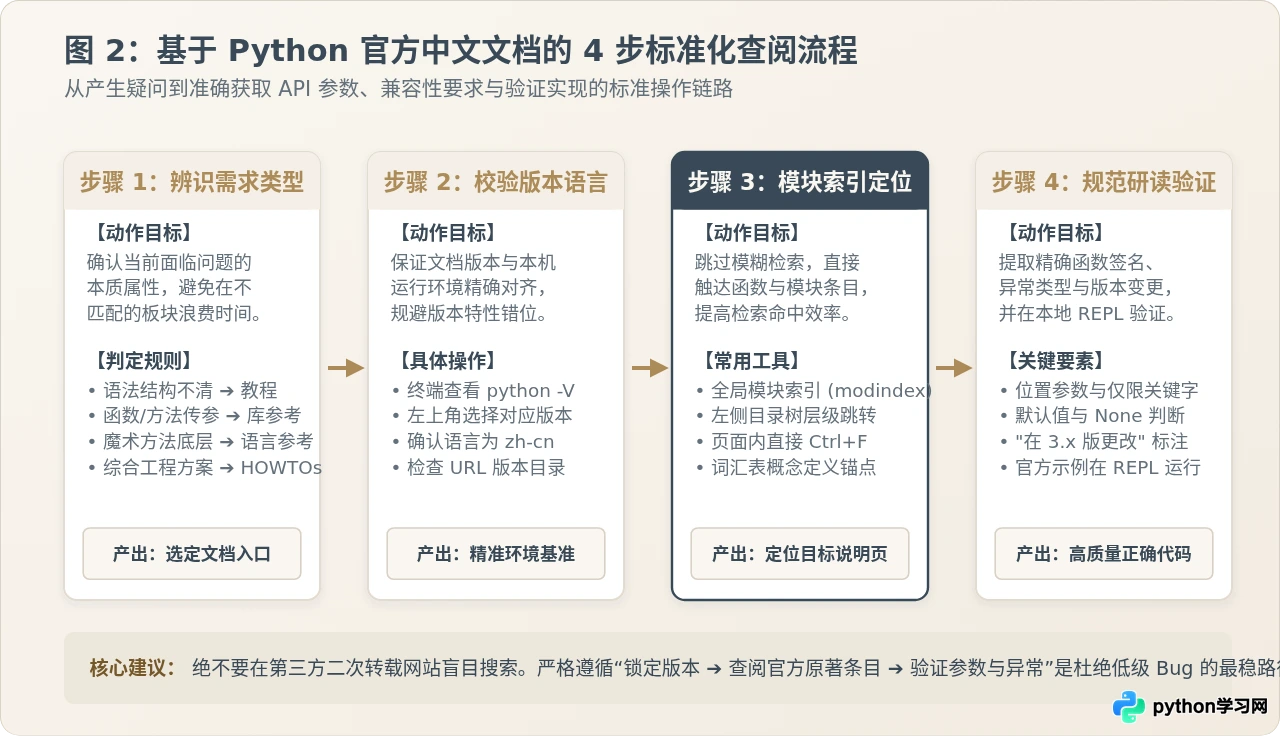
三、核心板块适用边界与矩阵对比
不少读者在自学过程中之所以产生挫败感,是因为选错了阅读对象。例如初学者试图直接把“标准库参考”当成教材从第 1 页读到第 1000 页,结果被纷繁复杂的参数说明劝退;或者在排查元编程问题时,反复翻阅基础教程却始终找不到魔术方法的原型定义。
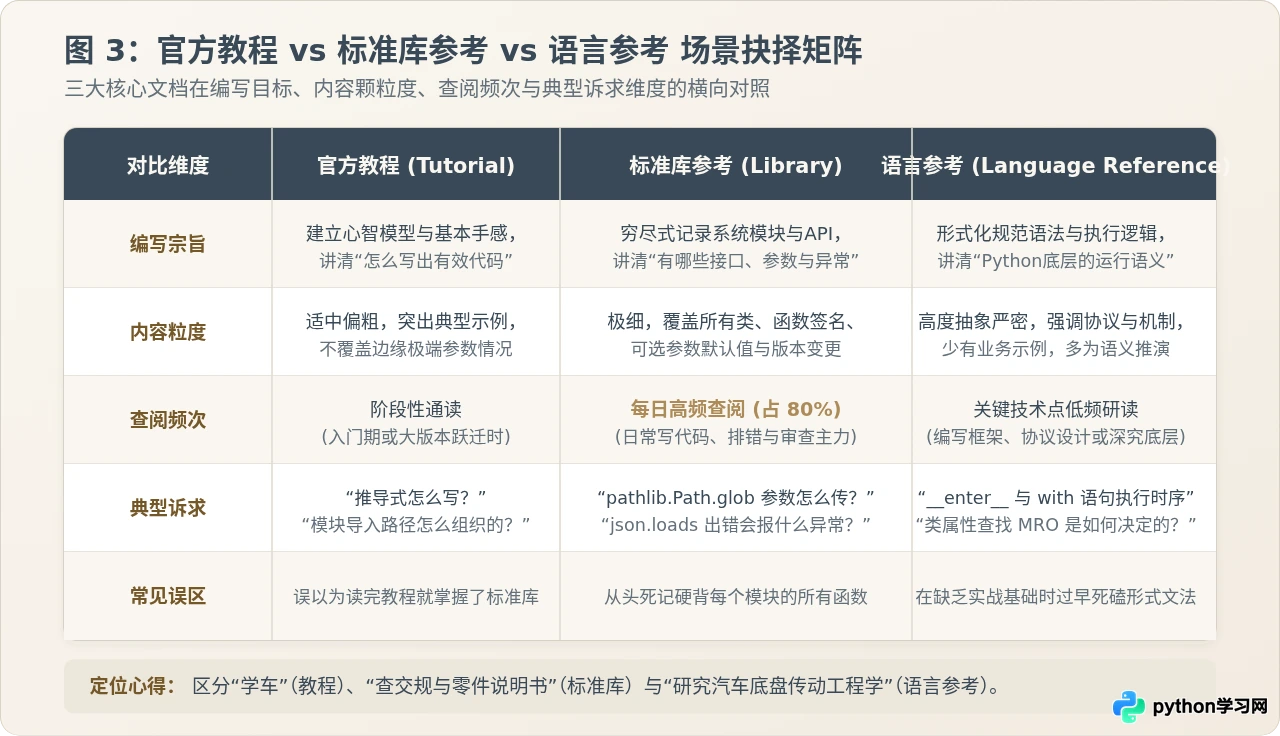
清晰界定三大核心文档的适用边界,是提升阅读效率的关键基石:
| 对比维度 | 官方教程 (Tutorial) | 标准库参考 (Library Reference) | 语言参考手册 (Language Reference) |
|---|---|---|---|
| 编写宗旨 | 引导上手,建立语言思维方式 | 记录所有可用类、函数、常量与参数细节 | 形式化严谨定义语言语法树与执行模型 |
| 目标读者 | 初学者、从其他语言转来的开发者 | 全阶段工程师日常编写业务逻辑时查阅 | 中高级进阶者、框架作者、底层实现者 |
| 内容颗粒度 | 适中,突出通用模式与入门示例 | 极细,包含参数、返回值、异常及变更版本 | 严密抽象,强调机制逻辑与协议规则 |
| 阅读方式 | 章节连续通读 | 按需随机索引跳转 | 专题式重点研读(如第 3 章数据模型) |
| 典型查询示例 | 字典的基本遍历方式怎么写 | json.loads() 遇到无效字符报什么错 |
async with 语句底层的协议调用顺序 |
四、读懂官方文档条目的关键细节与避坑指南
在查阅标准库与语言文档的过程中,官方文档埋藏了许多高价值的上下文信息。读懂这些细节,能帮助开发者提前避开潜在的兼容性陷阱和逻辑缺陷。
1. 重点留意“在 3.x 版中更改”与弃用标注
在 API 说明正文下方,经常能看到醒目的小字标注,例如:
在 3.9 版更改: 增加了对于字典合并运算符 | 和 |= 的支持。
在 3.12 版中弃用,将在 3.14 版中移除: datetime.datetime.utcnow() 应改用 datetime.datetime.now(datetime.timezone.utc)。
如果维护的项目需要兼容较早的 Python 版本(如服务器部署环境仍为 Python 3.8),看到此类更改提示时,就必须格外注意:使用了该改动涉及的新特性,低版本解释器运行时将直接抛出 SyntaxError 或 AttributeError。
2. 区分“原地修改(In-Place)”与“返回新对象”
初学者极易混淆列表排序与通用排序的区别。官方文档通过精确的返回值描述做出了界定:
list.sort(*, key=None, reverse=False)的说明中明确指出:“此方法就地排序列表……它返回None以提醒调用者它修改了容器”。若写出result = my_list.sort(),result将变为None。- 而内置函数
sorted(iterable, ...)则标明:“返回一个新的已排序列表”,原始列表保持不变。
仔细阅读文档对返回值的描述,能直接消除这类隐蔽的状态修改 Bug。
3. 中英文双语切换的实用技巧
Python 官方中文文档由全球志愿者团队协同翻译,整体质量极高。但在部分最新版本的新增模块或高度专业化的底层章节中,可能存在翻译尚未完全同步,或者某些专业技术术语(如 bound method、closure、coroutine)在中文语境下含义不如英文原文直观的情况。
遇到理解不顺畅的长句时,无需重新在搜索引擎中查找英文。只需在页面左上角的语言下拉菜单中直接切换为 “English”,或者直接在浏览器地址栏中将 /zh-cn/ 改为 /en/,浏览器就会立即刷新到当前页面的英文对应位置。对比对照阅读,能迅速厘清术语的本意。
4. 善用 [source] 链接直接阅读标准库源码
在标准库文档很多类和模块标题的右侧,常有一个小巧的 [source] 链接。点击该链接可以直接跳转至官方托管在 GitHub 上的 CPython 源码对应文件。
Python 标准库中有相当大比例的模块(如 dataclasses、collections、functools)是用纯 Python 编写的。当你想确认某个类内部到底维护了哪些属性、或者装饰器内部的包装逻辑时,直接看几行标准库源码往往比查阅第三方二次解读更为透彻明了。
五、从初学到进阶的阶段化阅读路线
官方文档内容庞大,试图一口气全部掌握是不切实际的。建立分阶段的阅读节奏,能够让文档持续发挥导师般的辅助价值:
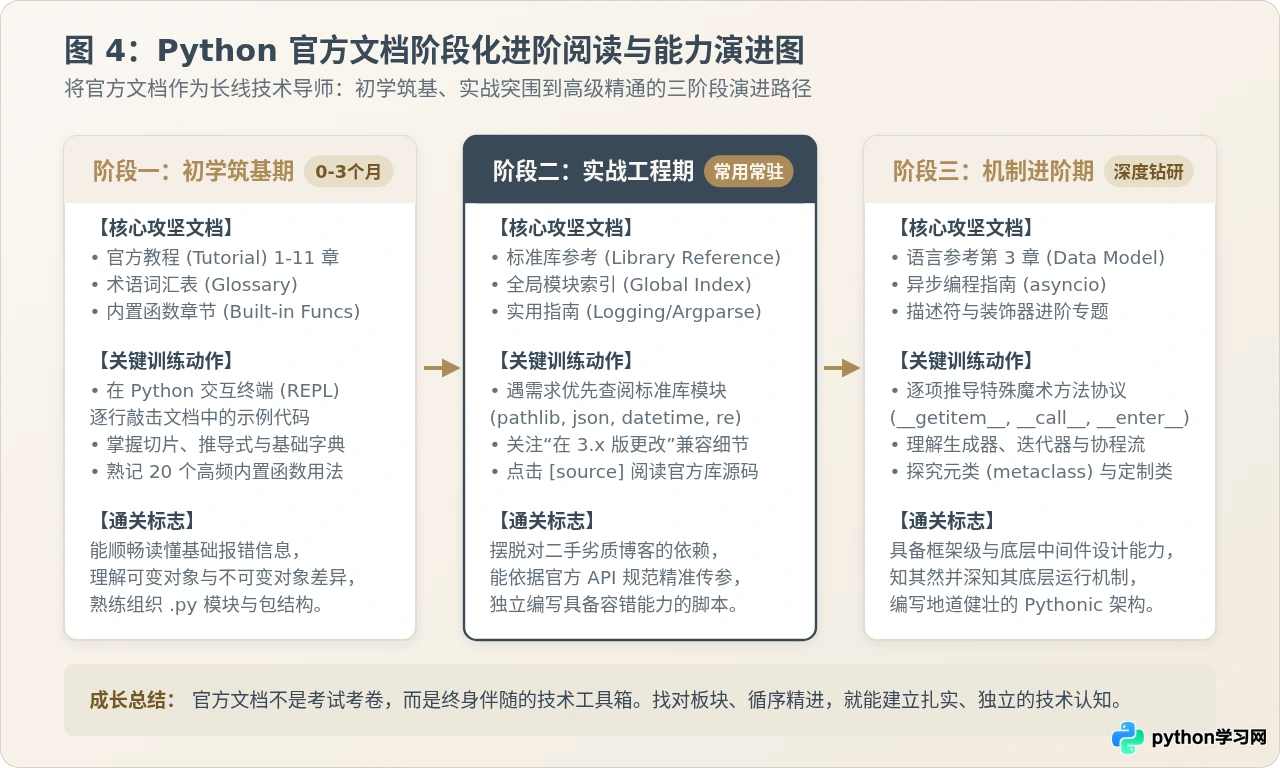
1. 初学筑基期(0-3 个月):以官方教程为锚点
处于编程入门阶段时,首要目标是建立语感与基础语法直觉:
- 精读官方教程的前 11 章,尤其掌握控制流(if、for、while)、核心容器类型(列表、元组、字典、集合)的操作机制。
- 遇到看不懂的报错关键字,打开词汇表(Glossary)查阅定义,严禁死记硬背。
- 浏览内置函数列表,熟悉常见的 20 个工具函数(如
range()、enumerate()、zip()、isinstance()、len())。
2. 实战工程期:以标准库参考为常驻工作台
开始编写具体项目或脚本时,阅读重心全面转向标准库参考:
- 不再盲目在外部网络寻找零散代码片段,优先在标准库中寻找原生解决方案(如现代路径操作使用
pathlib,数据传输使用json,结构化数据使用dataclasses)。 - 养成调用前扫一眼函数签名的习惯,确认参数位置、可选参数默认值以及返回值类型。
- 查阅对应模块的 HOWTOs 专题,掌握日志(logging)或命令行解析(argparse)的标准工程化配置范式。
3. 机制进阶期:深挖语言参考第 3 章与协议规范
希望编写高质量框架、理解高级设计模式或排查复杂性能瓶颈时:
- 精读语言参考手册第 3 章“数据模型(Data Model)”,逐个拆解
__getitem__、__iter__、__enter__、__exit__、__call__等特殊方法的底层协议。 - 研读官方关于描述符(Descriptor HOWTO)与异步编程(asyncio 机制)的专题文章,彻底透析属性查找机制与事件循环运作原理。
核心阅读法则总结
使用 Python 官方中文文档的诀窍,可以概括为十二个字:“分清板块、对齐版本、看准签名、验证实践”。把教程当教材、把标准库当字典、把语言参考当法典、把专题指南当手册。养成紧扣官方一手文档的习惯,不仅能大幅提升编码的正确性与健壮性,也是每一位开发者迈向专业化技术的必经之路。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















