


Python新手怎么高效刷完基础100题?重点难点突破指南
针对Python新手在刷基础100题时遇到的卡壳、看答案就会自己写就忘等问题,系统梳理四阶推进路径、单题攻坚三步闭环法,并针对嵌套循环、容器拷贝陷阱、递归抽象等重点难点提供深度剖析与规范示例。
一、题库重构:从线性硬刷到四阶分层推进
市面上流传的“Python基础100题”(涵盖经典的Python 100 Days练习、菜鸟教程100例及经典算法入门题)通常是按数字线性排布的。如果从第1题顺序刷到第100题,往往会在前20题感到大量重复(如多次练习基本加减乘除与字符串拼接),而在突然遇到杨辉三角、汉诺塔或矩阵转置时猝不及防,产生严重的挫败感。
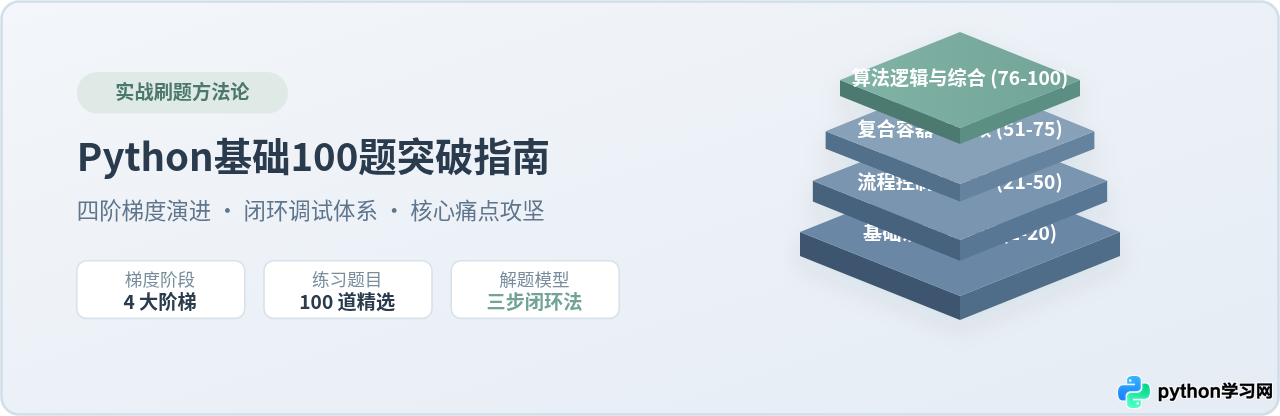
高效刷题的第一步是打破数字顺序,将百题拆解为四个能力梯度。每个梯度明确其核心攻坚目标,完成一个阶梯再进入下一个:
第一阶:基础语法与输入输出规范(约第 1 - 20 题)
重点掌握 int、float、str 转换,input() 数据拆解与 f-string 格式化输出。目标是熟练写出无语法错误的基本脚本,解决 I/O 交互与简单运算。
第二阶:分支判断与循环控制(约第 21 - 50 题)
攻克 if-elif-else 多分支、for ... range() 边界变换、while 循环条件收敛以及 break/continue 逻辑剪枝。核心标志是能够独立完成九九乘法表、水仙花数和素数判定。
第三阶:复合容器与模块化函数(约第 51 - 75 题)
深入列表切片、字典键值映射统计、集合交并差集运算,理解函数作用域、可变参数 *args, **kwargs 及引用传递机制。核心标志是能够规避浅拷贝共享引用的隐蔽 Bug。
第四阶:算法思维与综合逻辑(约第 76 - 100 题)
突破递归函数的终止条件(Base Case)设计、简单排序(冒泡/选择)、回文对称判定及文件异常处理。目标是不依赖模板独立拆解中等复杂度的工程逻辑题。
二、单题攻坚:三步闭环推进法与排错机制
很多新手刷题效率低下的根源在于做题习惯错误:读完题目觉得没头绪,停留3分钟就迫不及待看答案;看完觉得“原来这么简单”,照抄一遍就算完成。这种方式仅仅训练了“辨识能力”,没有建立从题目到代码的神经连接。
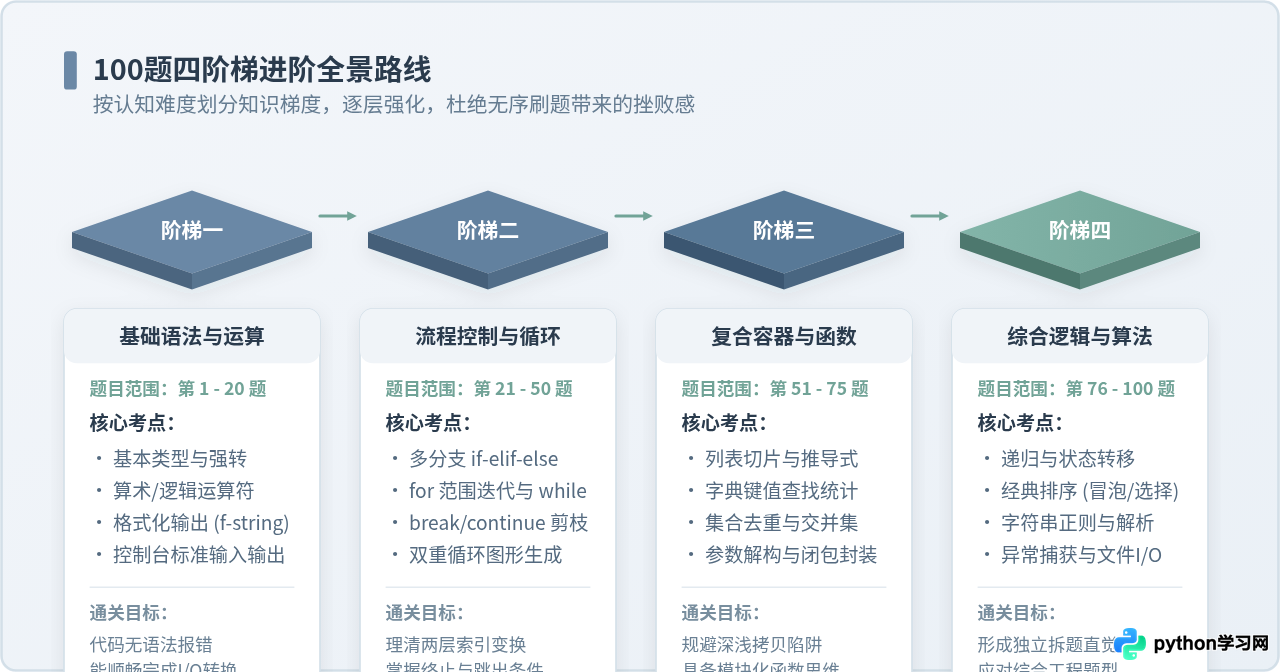
要形成真正的解题能力,每一道题都必须严格走完“输入拆解—草稿推演—编码重构”三步推进闭环:
第 1 步:审题与数据流建模
先不打开代码编辑器,在草稿纸或记事本上写下三行字:
- 输入规格:是单个整数?逗号分隔的字符串?还是多行列表?
- 期望输出:是直接打印到控制台?返回布尔值?还是生成一个排好序的字典?
- 边界假设:输入为空、输入为0或负数、输入包含重复字符时该如何应对?
第 2 步:小样本纸面推演与伪代码
当一道题涉及循环或状态变化时(例如“猴子吃桃”或“斐波那契”),绝不要直接在大脑中进行抽象推理。用具体的微型用例(如 n = 3 或 n = 4)在纸上一步一步手工模拟:
# 伪代码草稿示例:统计字符串中各字符出现频次
初始化一个空字典 counts
遍历字符串中的每个字符 char:
    如果 char 不在 counts 中:
        counts[char] = 1
    否则:
        counts[char] += 1
返回 counts
当草稿步骤在纸面上推演顺畅后,再开始敲键盘,此时语法仅仅是思想的翻译工具,代码自然水到渠成。
第 3 步:独立编码与二次重构(Pythonic 化)
写出能够跑通第一个版本后,不要立即跳转到下一题。回顾代码并思考:是否有冗余的循环?变量命名是否清晰?能否用更地道(Pythonic)的方式重构?例如将四行常规 for 循环改写为列表推导式,或用内置函数替代手动累加。
三、重点难点突破一:多重循环与二维坐标遍历
在基础100题的第20到50题之间,大量题目集中在双重循环:九九乘法表、杨辉三角、水仙花数、菱形字符图案打印、矩阵转置等。新手常在此处遭遇“内外层变量混乱”和“越界偏差(Off-by-one Error)”。
难点解构:明确内外层循环的角色分工
对于二维图形或矩阵遍历,最稳妥的思维锚点是:外层循环控制行号(纵向推进),内层循环控制列号或单行元素(横向打印)。以经典的九九乘法表为例,第 i 行只需要打印 i 个算式:
# 九九乘法表示例:清晰区分行(i)与列(j)
for i in range(1, 10):           # 外层循环控制行:1到9
    for j in range(1, i + 1):       # 内层循环控制列:1到i
        print(f"{j}*{i}={i * j:<2}", end=" ")
print() # 单行结束后换行再看进阶题杨辉三角前 N 行生成,其难点在于首尾都是1,中间元素由上一行的相邻两数相加而成。通过直观的双重索引拆解,逻辑非常规整:
def generate_pascal_triangle(num_rows: int):
    if num_rows <= 0:
        return []

    triangle = []
    for i in range(num_rows):
        # 首尾填充1,中间初始化为0
        row = [1] * (i + 1)
        for j in range(1, i):
            # 当前位置等于上一行的左上方与正上方之和
            row[j] = triangle[i - 1][j - 1] + triangle[i - 1][j]
        triangle.append(row)
    return triangle

# 示例调用输出
result = generate_pascal_triangle(5)
for r in result:
    print(r)
# 示例输出:
# [1]
# [1, 1]
# [1, 2, 1]
# [1, 3, 3, 1]
# [1, 4, 6, 4, 1]range(start, end) 是“左闭右开”区间。如果需要包含第 n 个数,终点必须写 n + 1。此外,严禁在遍历一个列表的同时调用 remove() 或 pop() 改变该列表的长度,否则会导致迭代索引漂移漏掉元素。
四、重点难点突破二:复合容器与深浅拷贝陷阱
进入第51到75题后,题目开始频繁涉及列表嵌套(二维表格)、字典嵌套统计与多维数据交换。此时新手最常遇到的“诡异现象”是:明明只修改了一个位置的值,结果整列或者所有子列表都跟着变了。
深挖根源:为什么 [[0] * 3] * 3 是致命错误?
在 Python 中,变量名本质是指向内存对象的引用指针。乘号操作符 * 3 作用于包含对象的列表时,执行的是浅层引用复制,而不是重新分配内存空间创建新对象:
# 错误写法:3个外层元素共享同一个内层列表地址
bad_matrix = [[0] * 3] * 3
bad_matrix[0][0] = 1
print(bad_matrix)
# 预期输出:[[1, 0, 0], [0, 0, 0], [0, 0, 0]]
# 实际输出:[[1, 0, 0], [1, 0, 0], [1, 0, 0]] —— 全部被污染!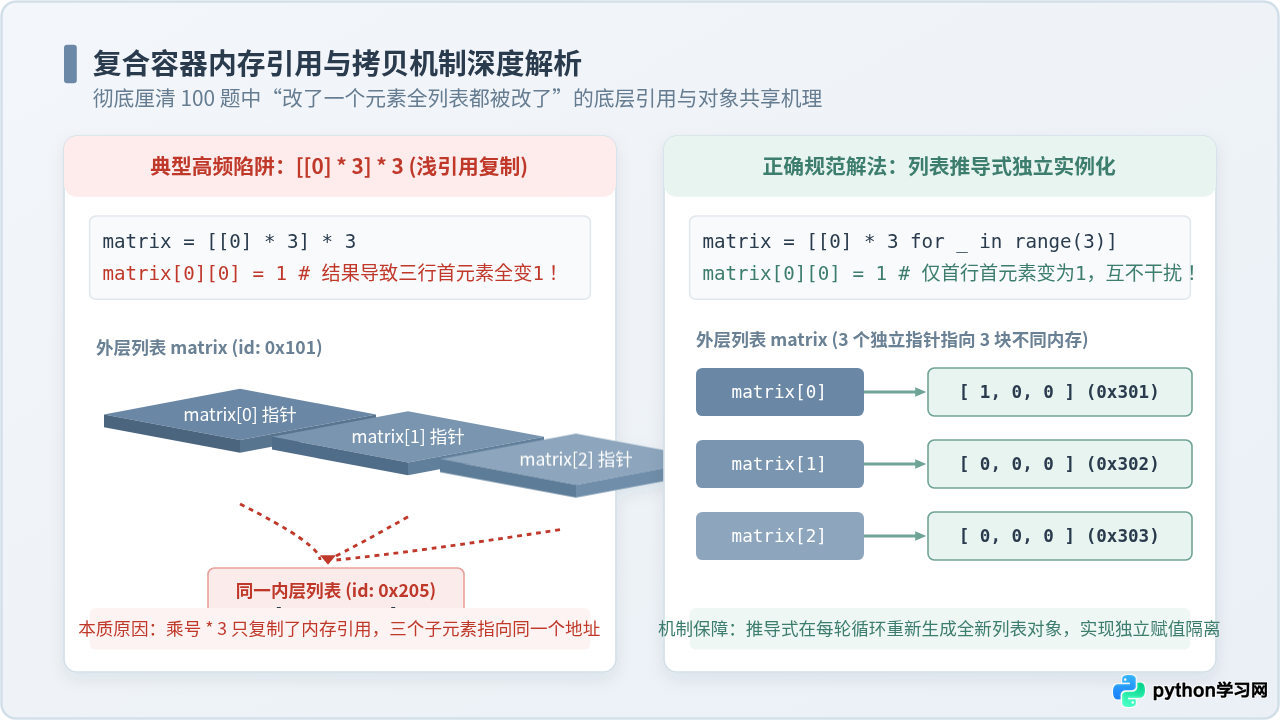
规范写法:通过列表推导式实现独立实例化
如上图所示,列表推导式在每轮循环时都会触发一次全新内层列表的实例化,分配独立的内存地址空间:
# 正确规范写法:每次循环生成全新内层对象
correct_matrix = [[0] * 3 for _ in range(3)]
correct_matrix[0][0] = 1
print(correct_matrix)
# 输出:[[1, 0, 0], [0, 0, 0], [0, 0, 0]] —— 互不干扰,完全正确
在处理更复杂的多层嵌套字典复制时,普通切片 lst[:] 或 dict.copy() 同样只能拷贝外层,必须使用标准库 import copy; copy.deepcopy(obj) 才能实现深层完全克隆。
五、重点难点突破三:递归回溯与高阶抽象逻辑
百题最后的25题包含多道递归题:阶乘累乘、斐波那契数列、汉诺塔移动、全排列生成等。很多初学者对递归产生心理畏惧,感觉代码虽然只有三四行,但“大脑栈空间不够用,绕不出来”。
化繁为简:递归思考的两大支柱
理解递归不需要在大脑中追踪数十层调用栈,只需要牢牢抓住两个要素:
- 基准条件(Base Case / 退出哨兵):最简单的边界情况是什么?何时停止递归直接返回结果?如果遗漏这一条件,程序必定报错
RecursionError: maximum recursion depth exceeded。 - 单步递推关系(Reduction Step):假设子问题已经被解决,当前层如何利用子问题的结果返回上一层?
以经典的斐波那契数列为例,对比朴素递归与优化思路:
# 朴素递归:直观但存在重复子问题计算,时间复杂度 O(2^n)
def fib_naive(n: int) -> int:
    if n <= 0:
        return 0
    if n == 1:
        return 1
    return fib_naive(n - 1) + fib_naive(n - 2)

# 工业级优化:使用记忆化缓存 (Memoization) 压缩为 O(n)
from functools import lru_cache

@lru_cache(maxsize=None)
def fib_optimized(n: int) -> int:
    if n <= 0:
        return 0
    if n == 1:
        return 1
    return fib_optimized(n - 1) + fib_optimized(n - 2)

print("Fib(10) =", fib_optimized(10)) # 输出:55再看经典的汉诺塔问题(将 n 个圆盘从 A 借助 B 移动到 C),初看极其复杂,但如果用抽象的宏观视角拆解,只有三步:
- 第 1 步:先将上方的
n - 1个盘子从A借用C移到B; - 第 2 步:将底部的最大盘直接从
A移到C; - 第 3 步:最后将
B上的n - 1个盘子借用A移到C。
def hanoi(n: int, src: str, helper: str, dest: str):
    if n == 1:
        print(f"将盘片 1 从 {src} 移动到 {dest}")
        return
    # 步骤1:将 n-1 移到辅助柱
    hanoi(n - 1, src, dest, helper)
    # 步骤2:将最大盘移到目标柱
    print(f"将盘片 {n} 从 {src} 移动到 {dest}")
    # 步骤3:将 n-1 从辅助柱移到目标柱
    hanoi(n - 1, helper, src, dest)

# 移动 3 个盘片的示例验证
hanoi(3, 'A', 'B', 'C')
六、百题复盘:四维检视矩阵与能力跃迁
刷完100道题目本身不是终点,真正的价值在于形成肌肉记忆与独立排错的直觉。每刷完一个阶梯(约25题),建议对照下方的“四维检视矩阵”进行复盘:
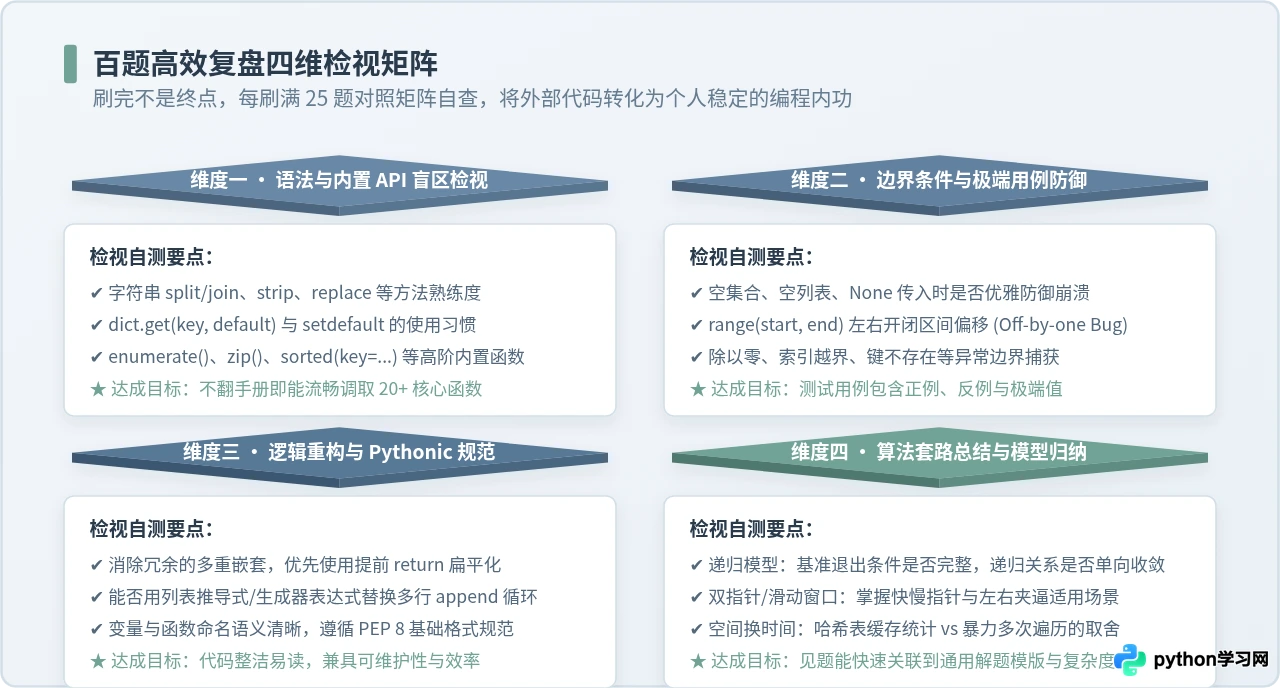
建立个人易错题卡片库
不要把做过的所有代码乱七八糟地存放在一个文件夹里。建议建立一个简明的 notes.md 或错题脚本,专门记录属于以下三类的题目:
| 错题分类 | 典型表现 | 纠偏策略与自查清单 |
|---|---|---|
| 语法盲区类 | 记不清 split()、join() 的参数顺序,或字典遍历时误直接用 for k, v in d: |
抄写标准 API 语法卡片,在交互式 Python 控制台手敲验证3次 |
| 边界越界类 | range 差了1位导致丢数据,或空列表求最大值抛出 ValueError |
将测试用例标准化:必测空输入、单个元素、最大极值三个维度 |
| 引用副作用类 | 多维列表改动联动,或函数默认参数使用了可变类型 def fn(a=[]) |
牢记“可变对象作为默认参数是全局共享的”,统一改用 a=None并在函数内部实例化 |
盲打复测:检验真实掌握度的黄金标准
在完成全部100题后,随机抽取其中难度较高的10道题(例如杨辉三角、水仙花数、字典词频多权重排序、汉诺塔、全排列生成)。合上所有参考资料和历史代码,在空白编辑器中重新敲出完整解答。如果能够在20分钟内跑通测试用例,说明对 Python 核心逻辑与语法的掌握已经彻底扎实,完全具备了迈向 Web 开发、数据分析或进阶 LeetCode 刷题的坚实基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















