


Python字符串常用函数汇总:split、join与replace实战
深入解析Python字符串三大核心处理函数split、join与replace的用法、底层原理、参数边界与高频实战场景,帮助读者系统掌握文本拆分、重组与清洗技巧。
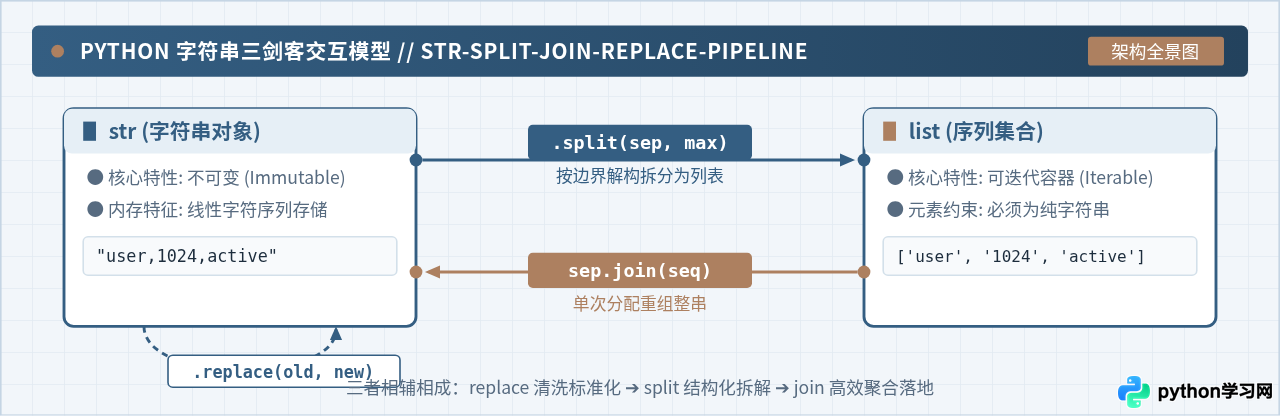
split()、join() 与 replace() 这三个原生字符串方法构成了最核心的数据处理闭环:split() 负责解构切分,join() 负责高效拼装,replace() 负责定点置换。掌握它们深层的运行机制、边界条件与性能特征,是写出优雅且高性能代码的必经之路。
一、str.split() 深度剖析:从空格陷阱到精确截断
split() 方法用于沿着指定边界将字符串切分为一个子字符串列表。其函数签名如下:
str.split(sep=None, maxsplit=-1)
表面上看该函数非常简单,但官方文档中对 sep 参数的隐式行为定义,往往是初学者踩坑的根源。
1.1 sep=None 与 sep=' ' 的核心差异
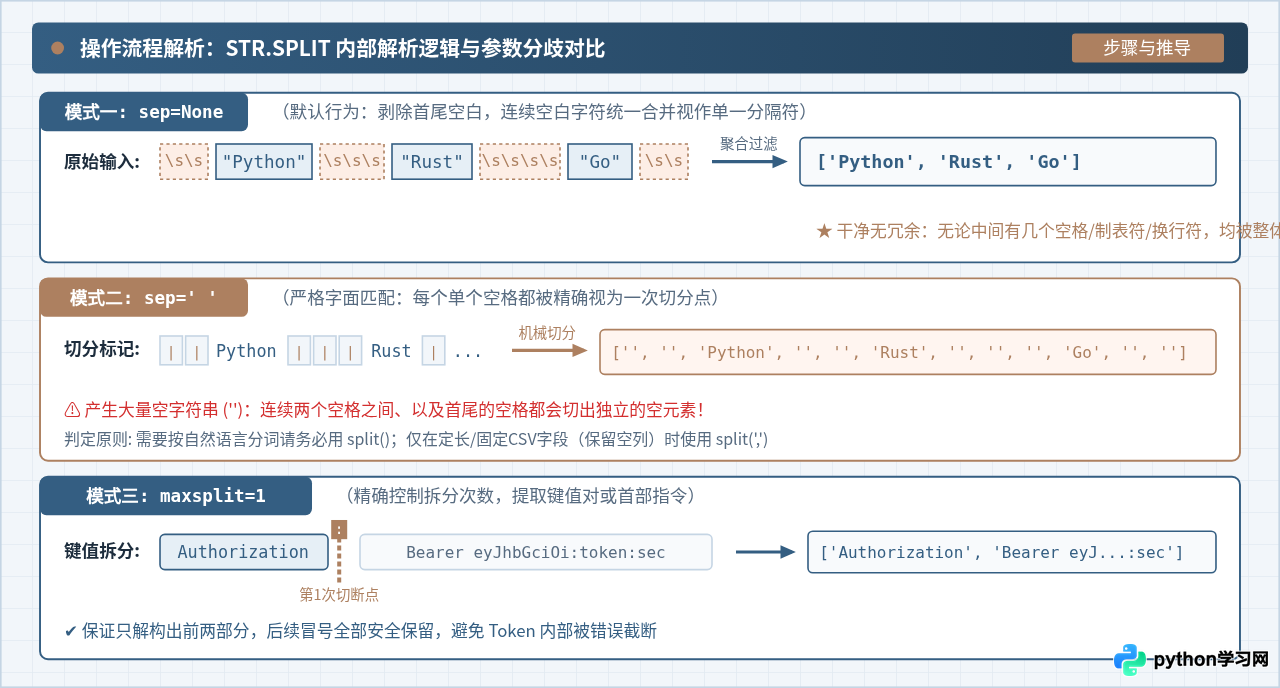
当不给 sep 传参(即默认值 None)时,Python 会启动“空白聚合算法”:它会自动剥除字符串首尾的所有空白符(包括普通空格、 制表符、
换行符),并将中间任意长度的连续空白符视为一个整体分隔符。
相反,一旦显式传入 sep=' '(单个普通空格),Python 就会严格执行机械切分:每个单独的空格都被看作一个分隔界限。两个连续的空格之间由于不存在字符,必然会切出一个空字符串 ''。
# 演示 sep=None 与 sep=' ' 的切分差异
raw_text = "   Python    Rust   Go
"

# 1. 默认无参切分(推荐处理自然语言或空白不规整文本)
clean_tokens = raw_text.split()
print("sep=None 切分结果:", clean_tokens)

# 2. 显式指定单空格切分(容易出现大量空字符串)
strict_tokens = raw_text.split(' ')
print("sep=' ' 切分结果:", strict_tokens)split(' '),必须直接调用 split();只有在标准 CSV 或固定制表符等严格依赖空列占位的场景下,才显式传入分隔符如 split(',')。
1.2 利用 maxsplit 控制拆分深度
在很多场景下,我们只需要切出前缀或特定头部,例如解析 HTTP 请求头 Authorization: Bearer xyz:123:abc。如果直接按冒号切分,Token 内部可能包含的 Base64 编码或冒号也会被破坏。此时传入 maxsplit=1,就能保证只在首个冒号处切断一次。
# 场景:解析配置行与请求头,只切断前部键名
header_line = "Authorization: Bearer token_key:secret:987654"

# 仅切断 1 次,返回包含 2 个元素的列表
key, value = header_line.split(':', maxsplit=1)
print("Key   :", key.strip())
print("Value :", value.strip())

# 如果需要从右侧开始截断(例如截取文件扩展名或尾部时间戳),使用 rsplit
file_path = "archive.2026.backup.tar.gz"
name, ext = file_path.rsplit('.', maxsplit=1)
print("文件名主干:", name)
print("扩展名 :", ext)二、str.join() 高效重组:序列拼接与底层机制
join() 用于将一个可迭代对象(如列表、元组、生成器)中的多个字符串,通过指定的分隔符连接为一个崭新的长字符串。其调用形式是:
delimiter.join(iterable)2.1 倒置语法的逻辑背景
许多初学编程的开发者会习惯性认为应该是 list.join(delimiter)。Python 之所以将其设计为字符串对象的方法(delimiter.join(iterable)),是因为 iterable 可以是任何支持迭代的数据结构——列表、元组、集合、生成器表达式乃至字典键。将 join 挂在字符串上,避免了在所有容器类中重复实现拼接逻辑,体现了 Python 经典的鸭子类型风格。
2.2 为什么必须杜绝在循环中用 '+' 拼接?
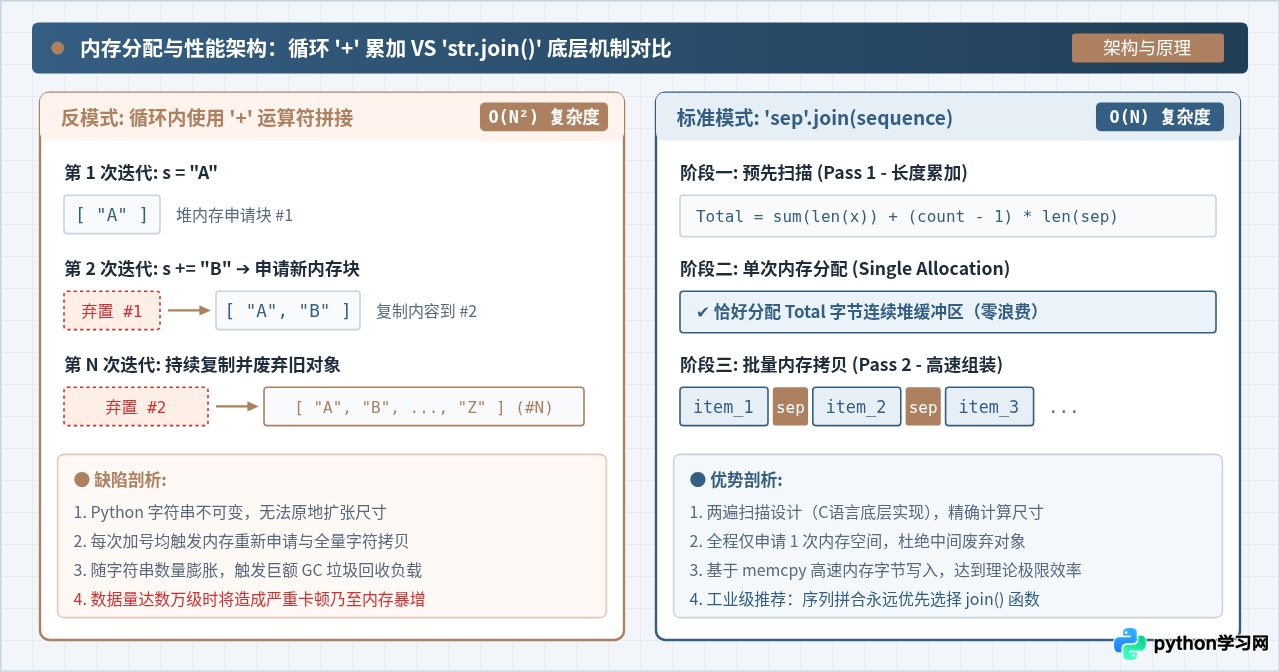
Python 中的字符串是不可变对象 (Immutable)。一旦创建,其在内存中的内容便无法扩张。如果在 for 循环中不断执行 result += item,每次加法操作都会在堆中重新申请一块新的内存空间,并将旧数据和新数据全部复制进去,旧的内存块则被废弃等待垃圾回收。对于 $N$ 个字符串的累加,其耗时呈 $O(N^2)$ 级爆炸式上升。
而 join() 在 C 语言底层实现上采用了高效的两遍扫描策略(Two-pass Algorithm):第一遍先计算出所有元素总长度与所需分隔符的尺寸之和;第二遍单次申请足额缓冲区,随后使用底层 memcpy 直接拷贝内存。其时间复杂度为完美的 $O(N)$ 线性时间。
2.3 元素类型强约束与避坑
join() 严格要求序列中的每一个元素都必须是 str 类型。如果混入了数字或布尔值,解释器会立即抛出 TypeError: sequence item X: expected str instance, int found。
# 1. 基础用法:重构标准路径与 CSV
parts = ["usr", "local", "bin", "python3"]
linux_path = "/" + "/".join(parts)
print("构建路径:", linux_path)

# 2. 包含非字符串元素的序列处理:配合 map() 或生成器
id_list = [101, 202, 303, 404, 505]
# 错误写法:",".join(id_list) ➔ 抛出 TypeError
safe_csv = ",".join(map(str, id_list))
print("数字序列安全拼接:", safe_csv)

# 3. 紧凑无缝连接:使用空字符串 "" 作为分隔符
chars = ['P', 'y', 't', 'h', 'o', 'n']
word = "".join(chars)
print("紧凑重组:", word)三、str.replace() 精准替换:不可变性与清洗边界
replace() 是 Python 中最常用的子串替换工具。其函数签名如下:
str.replace(old, new[, count])
它返回一个新字符串,其中所有的(或前 count 个)目标子串 old 均被替换为 new。
3.1 务必谨记“重新赋值”
因为字符串不可变,调用 text.replace("a", "b") 不可能直接更改原变量 text 的内部内容。新手常犯的错误就是仅调用 text.replace(...) 却不接收返回值。正确的做法是重新赋值:text = text.replace(...)。
3.2 count 参数的妙用
参数 count 用于限定最大替换次数。这在脱敏、部分屏蔽或仅替换前置标识时极其方便。
# 1. 基础替换与链式调用
messy_date = "2026/10/31"
clean_date = messy_date.replace('/', '-')
print("日期格式标准化:", clean_date)

# 链式替换多个不同字符
dirty_html = "<div><p>Python&Rust</p></div>"
plain_text = dirty_html.replace('<div>', '').replace('</div>', '').replace('<p>', '').replace('</p>', '')
print("标签剥除:", plain_text)

# 2. count 参数限制:仅替换指定次数
phone = "138-1234-5678"
# 仅替换第 1 个连接符
partial_masked = phone.replace('-', '#', 1)
print("部分替换 (count=1):", partial_masked)str.replace() 专用于固定字面量 (Exact Substring) 的全量或限量匹配,其底层以 C 语言内存搜索实现,运行速度远快于正则表达式。如果需要进行模式匹配(如模糊数字、忽略大小写、通配符提取),则应升级引入 re.sub()。
四、综合实战:构建生产级文本清洗管道
在实际数据处理任务中,孤立使用某个函数往往难以解决异构混杂的数据问题。将 replace、split 与 join 组合起来,可以构建出一套清晰、低内存开销的高性能清洗流水线。
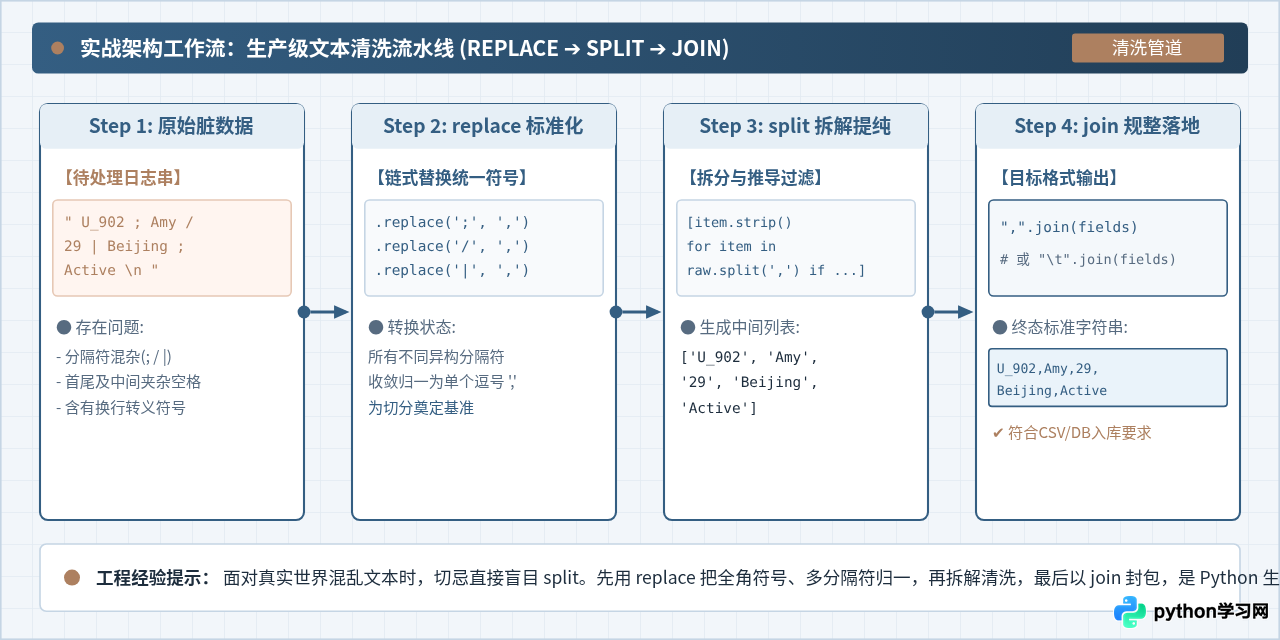
4.1 实战案例:异构用户登记信息清洗入库
假设我们从某外部老旧系统导出一批用户数据,数据格式极不规整:分隔符有逗号、斜杠、分号混杂,字段首尾含有多余空白,甚至含有无用的系统前缀。我们编写一个工业级清洗函数,将其标准化为符合标准 CSV 格式的单行记录。
完整实战脚本 // 05-pipeline-demo.pydef sanitize_record(raw_line: str) -> str:
"""
清洗异构用户数据记录:
1. replace 阶段:统一各类分隔符与去除多余转义符
2. split 阶段:按统一定界符拆分,利用列表推导式去噪剔除空白
3. 校验与格式转换:格式化特定字段
4. join 阶段:使用统一英文逗号重新封包
"""
if not raw_line or not isinstance(raw_line, str):
return ""
# 步骤 1: 链式 replace 标准化定界符(将 ; 和 / 统一替换为逗号)
normalized = raw_line.replace(';', ',').replace('/', ',').replace('|', ',')
# 去除常见的两端换行与系统前缀标识
normalized = normalized.replace("RAW_LOG:", "").strip()
# 步骤 2: 按统一逗号切分,并使用 strip() 清洗各字段内外多余空白
tokens = [item.strip() for item in normalized.split(',') if item.strip()]
# 步骤 3: 字段级别规整(例如对邮箱转小写,对状态大写)
if len(tokens) >= 4:
tokens[1] = tokens[1].capitalize() # 姓名首字母大写
tokens[3] = tokens[3].lower() # 邮箱统一小写
# 步骤 4: 使用标准逗号重构成标准 CSV 记录
return ",".join(tokens)
# 测试异构样本数据
dirty_records = [
"RAW_LOG: U1082 ; alice / 26 ; alice.dev@EXAMPLE.COM ; active \n",
" U1083 / bob | 31 ; BOB_WORK@CORP.NET / verified ",
"U1084 ; charlie ; 22 ; CHARLIE_QI@TEST.ORG ; pending"
]
print("=== 开始执行文本清洗管道 ===")
cleaned_results = [sanitize_record(row) for row in dirty_records]
for row in cleaned_results:
print(row)五、函数选型决策树与高频避坑清单
为了在日常编码与重构中能够快速做出技术选型决策,以下梳理了完整的决策树与避坑指南。
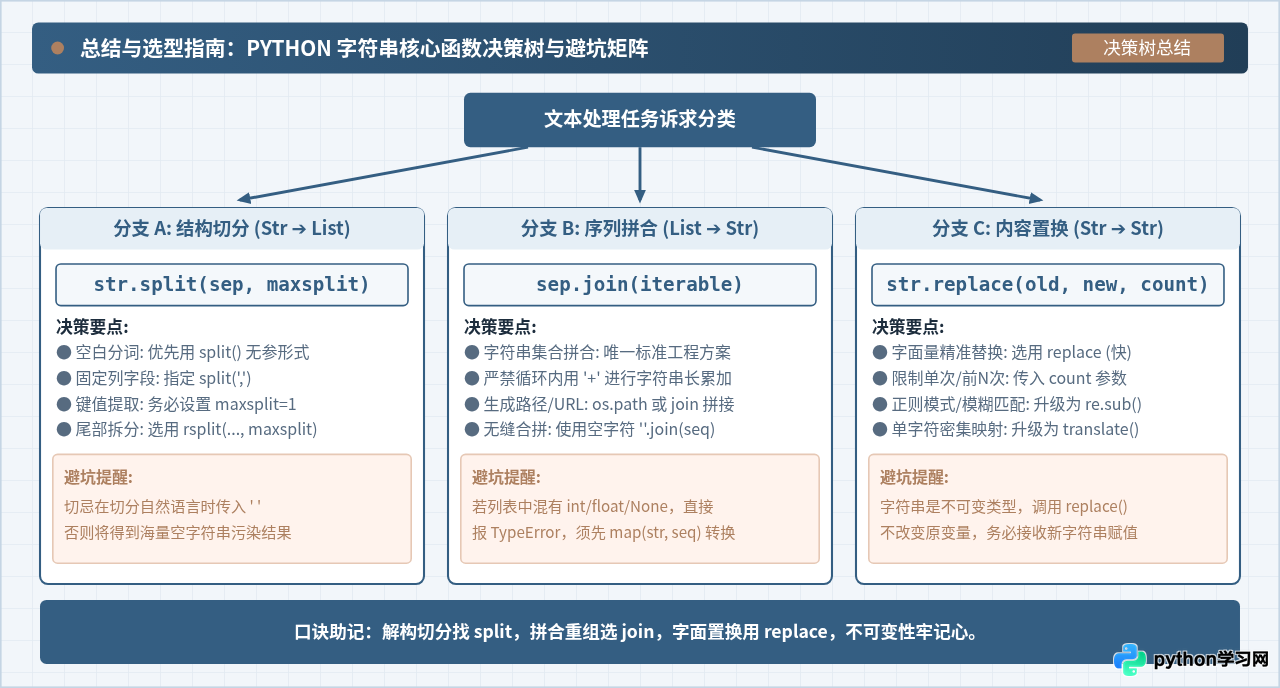
5.1 核心特性与技术边界速查表
| 函数名称 | 典型调用方式 | 入参约束 | 返回类型 | 核心优势与适用场景 | 高频踩坑点 |
|---|---|---|---|---|---|
| str.split | text.split(sep, max) |
sep 必须为字符串或 None |
list[str] |
自然语言拆解、固定格式按列切分、键值拆分 | 切分自然语言时显式传 ' ' 导致产生多余空串 |
| str.join | sep.join(seq) |
seq 中的元素必须全为 str |
str |
大规模字符串拼合、路径组装、输出格式化 | 列表中混入 int/None 抛 TypeError |
| str.replace | text.replace(old, new, cnt) |
old 与 new 必须为字符串 |
str |
字面量精确替换、标点符号归一、敏感词屏蔽 | 忽视字符串不可变性,忘记将返回值赋给变量 |
5.2 生产开发 5 项黄金法则
- 空白清洗首选无参
split():永远不要用text.split(' ')来分割自然语言或用户输入,默认参数会自动过滤首尾空白并合并连续多余空格。 - 长文本拼装严禁使用
+=:在循环体内累加字符串是严重的反模式,务必先用list.append()收集所有片段,在循环结束后统一调用"".join(list)。 - 牢记字符串不可变机制:
replace()不会在原字符串上生效,必须接收其返回值s = s.replace(...)。 - 数值列表拼接前必做转换:使用
join()连接数字列表时,养成搭配map(str, iterable)的习惯,避免运行时报错。 - 字面替换与正则区分边界:已知确切替换内容时,优先使用
str.replace()享受 C 语言级别的速度;仅在涉及复杂规则与未知匹配时,才启用re.sub()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















