


Python标准库排序辅助:heapq堆排序与operator模块用法
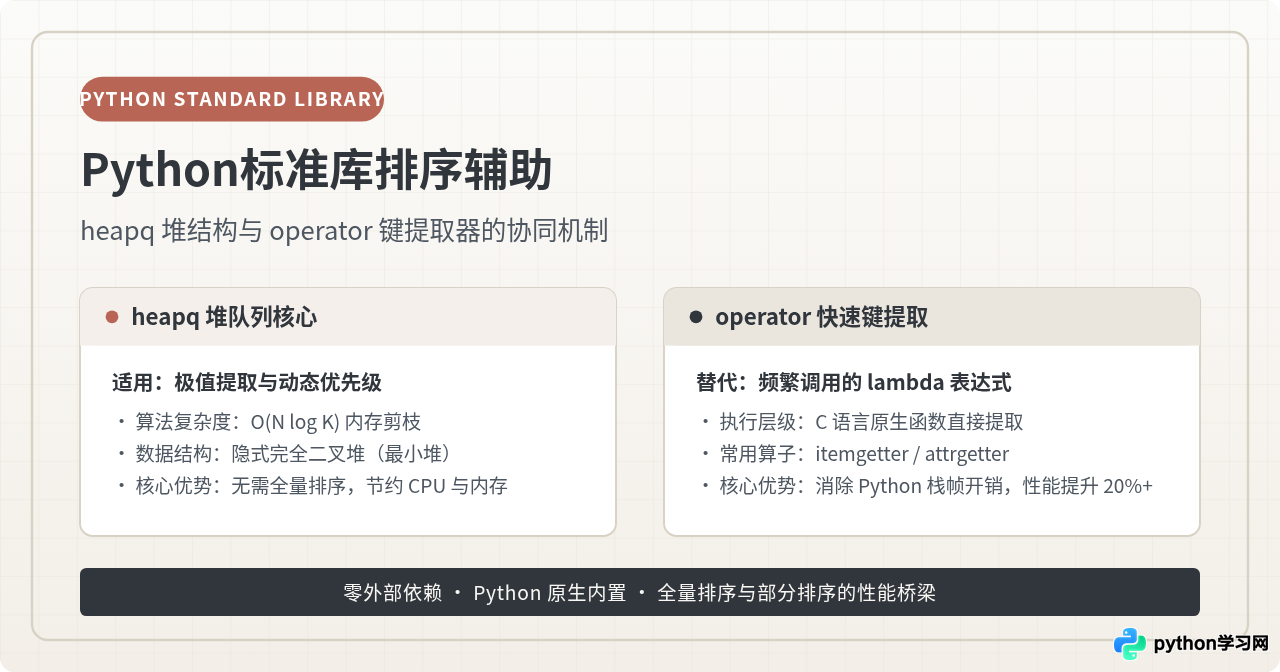
深入解析 Python 标准库排序辅助工具:全面讲解 heapq 堆队列算法与 operator 模块的键提取机制,对比分析全量排序与流式 Top-K 过滤的性能边界,提供高并发环境下的实战选型指南。
sorted() 配合 lambda 往往伴随着不必要的计算浪费与函数栈帧开销。Python 标准库自带的 heapq 模块通过二叉堆算法将 Top-K 极值过滤的时间复杂度从 \(O(N \log N)\) 降至 \(O(N \log K)\),而 operator 模块则以 C 语言原生底层调用彻底绕过 Python 字节码解释层,让排序键提取速度提升 20% 到 40%。两者的协同构成了标准库中处理高性能排序与极值获取的轻量利器。
一、全量排序与堆排序的计算边界
日常开发中最常用的 list.sort() 和 sorted() 依托于高度优化的 Timsort 算法。该算法属于自适应归并与插入混合排序,在全序列有序化场景下表现极佳,平均与最坏时间复杂度均为 \(O(N \log N)\)。
然而,业务场景往往并不要求全量有序。例如在一百万条日志中筛选耗时最长的 10 个请求,或者从电商交易流中持续提取信用评分最高的 50 名用户。如果直接使用 sorted(logs, reverse=True)[:10],系统必须先对整整一百万条记录完成完整的树状归并排序,这不仅多计算了 999,990 个无意义的相对顺序,还必须在内存中开辟完整的镜像列表空间。
heapq 模块正是为了打破这一性能瓶颈而设计的。它提供了基于列表的隐式二叉堆(Binary Heap)实现。由于仅维持局部偏序关系(即父节点始终小于或等于子节点),在解决极值筛选时,内存中只需要驻留大小为 \(K\) 的堆结构。每当新数据流入,仅需 \(O(\log K)\) 即可决定是否淘汰堆顶,总体耗时骤降为 \(O(N \log K)\)。当 \(K \ll N\) 时,性能差距可达数倍至数十倍。
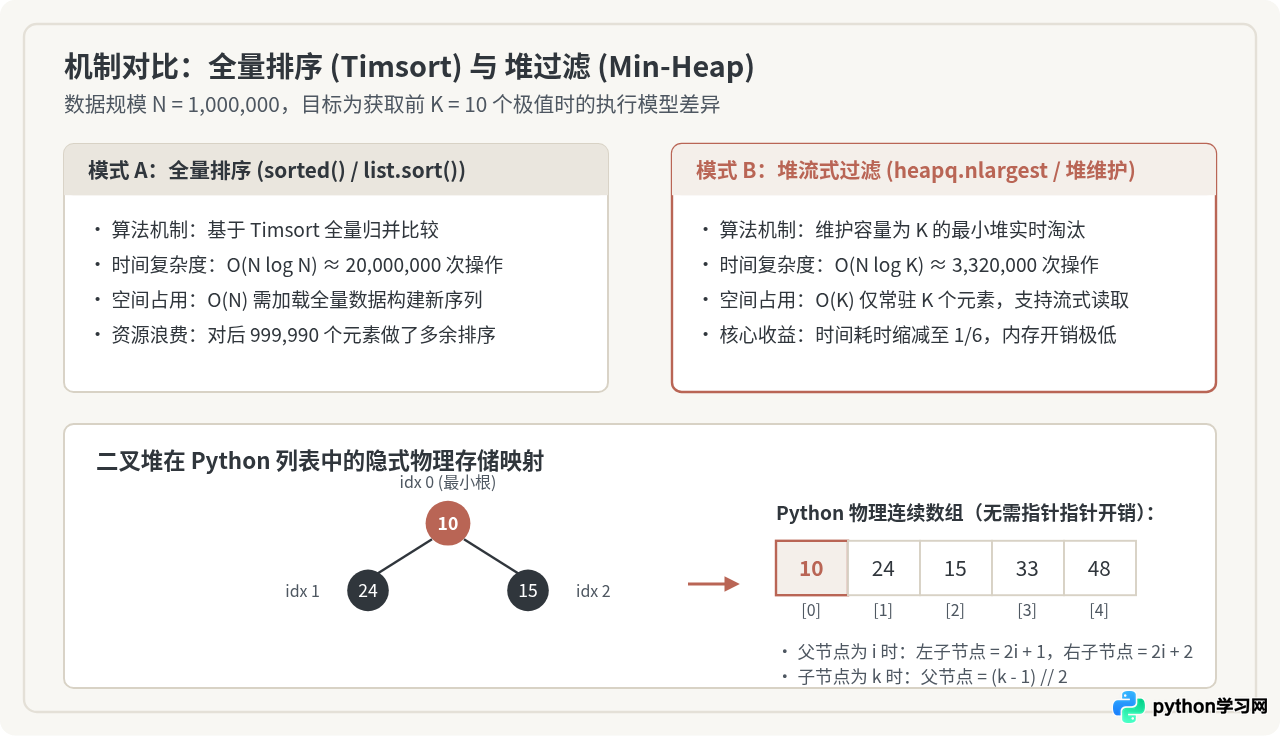
在内存实现上,heapq 并没有封装复杂的指针节点类,而是直接复用 Python 原生列表(list)。这种隐式二叉堆具有如下严谨的数学规律:
- 堆顶位置:
heap[0]永远是整个堆中的全局最小值。 - 子节点定位:对于任意下标为
i的节点,其左子节点下标为2 * i + 1,右子节点下标为2 * i + 2。 - 父节点反查:对于任意下标为
k(k > 0)的节点,其父节点下标严格满足(k - 1) // 2。
这种直接映射在连续内存上的结构消除了额外的对象包装与指针寻址,具备极其出色的 CPU 缓存局部性(Cache Locality)。
二、heapq 核心 API 详解与典型工作流
掌握 heapq 的关键在于明确其操作是以维持堆不变量(Heap Invariant)为前提的。一个普通的乱序列表不能直接执行弹出操作,必须先经历堆化转换。
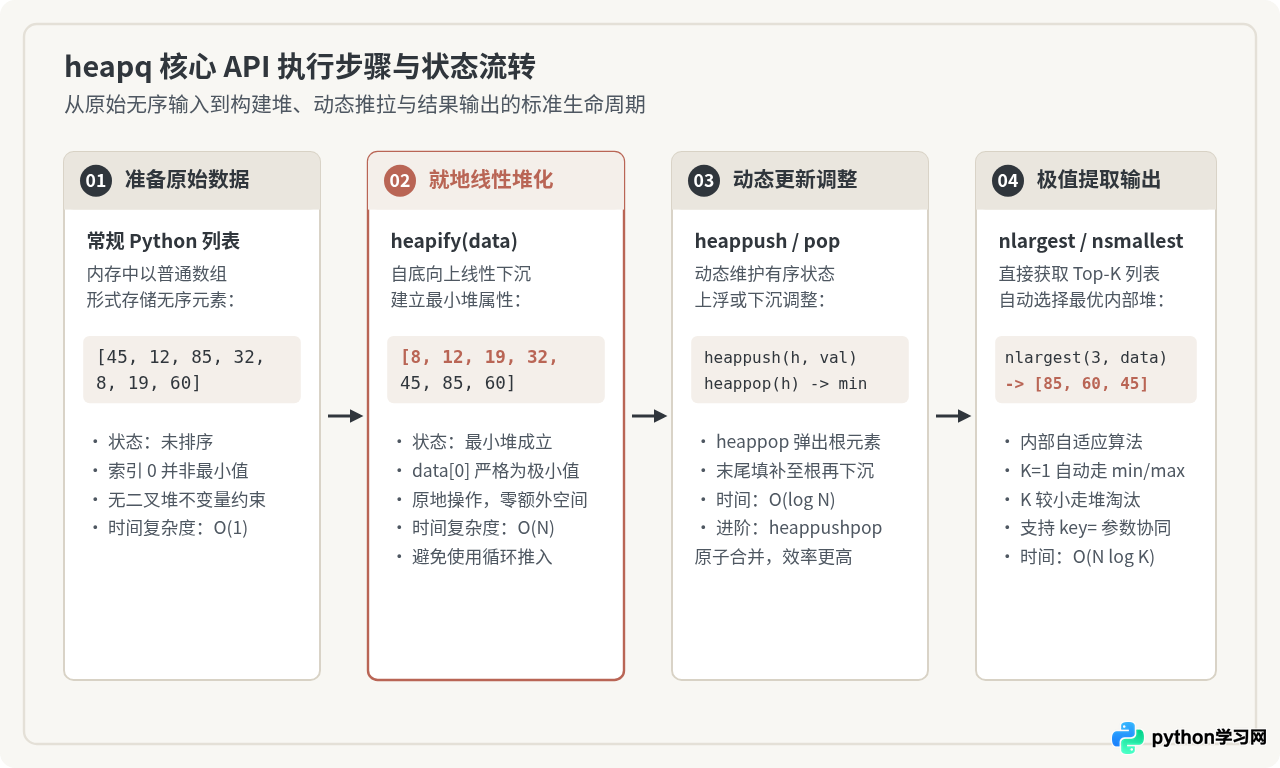
1. 就地堆化:heapq.heapify()
如果已经存在一个包含 \(N\) 个元素的列表,将其转换为合法最小堆的标准方式是调用 heapq.heapify(x)。
许多初学者常犯的错误是通过一个空列表循环调用 heappush。循环推入的建堆复杂度为 \(O(N \log N)\),而 heapify 采用自底向上的下沉算法(Floyd's Heap Construction Algorithm),仅需 \(O(N)\) 线性时间即可在原地重构列表,不产生任何额外内存开销。
import heapq

# 示例 1:对已有无序列表进行线性就地堆化
data = [45, 12, 85, 32, 8, 19, 60]
heapq.heapify(data)

print("堆化后列表:", data)
print("堆顶(全局最小值):", data[0])
执行输出(示例):
堆化后列表: [8, 12, 19, 32, 45, 85, 60]
堆顶(全局最小值): 8
注意:堆化后的列表并不是完全有序的序列!除 data[0] 严格是最小值外,其余元素的排列仅满足父子层级的大小约束,切勿将其误认为是排好序的数组。
2. 动态维护:heappush 与 heappop
当堆已经建立,后续的元素增删必须通过专有函数进行,以确保堆结构不被破坏:
heapq.heappush(heap, item):将新元素追加到列表末尾,随后沿父节点链条执行上浮(sift-up)调整,耗时 \(O(\log N)\)。heapq.heappop(heap):弹出并返回堆顶heap[0],同时将列表末尾元素移至堆顶,执行下沉(sift-down)调整,耗时 \(O(\log N)\)。
3. 高吞吐优化:heappushpop 与 heapreplace
在流式数据过滤(如维持固定大小的 Top-K 窗口)中,经常需要“推入一个新元素,同时弹出一个极值”。heapq 提供了两个合并操作,比分别调用 push 和 pop 效率更高,因为它们只触发一次下沉调整:
| 操作函数 | 执行顺序与行为 | 适用场景 |
|---|---|---|
heappushpop(heap, item) |
先推入新元素,再弹出当前堆顶。如果新元素比堆顶还小,新元素会被直接弹出,堆结构不发生任何变化。 | 流式过滤 Top-K 场景:新数据先入堆参与比较,确保堆内永远是见过的最优元素。 |
heapreplace(heap, item) |
先弹出当前堆顶,再将新元素填入并下沉。要求堆必须非空,新元素必定留存。 | 固定长度队列轮转、归并多个有序流时强制替换已消费的堆顶元素。 |
4. 快捷极值提取:nlargest 与 nsmallest
对于静态数据集的一次性极值查询,heapq 提供了极度封装的快捷函数:
import heapq

scores = [88, 92, 75, 63, 98, 81, 79, 95]

# 获取最大的 3 个元素(输出按降序排列)
top3 = heapq.nlargest(3, scores)
# 获取最小的 2 个元素(输出按升序排列)
bottom2 = heapq.nsmallest(2, scores)

print("前三高分:", top3)
print("后二低分:", bottom2)
执行输出(示例):
前三高分: [98, 95, 92]
后二低分: [63, 75]
nlargest 在底层实现中具备自适应调度策略:当 \(N\) 较小而 \(K\) 很大时,它会自动退化为全量排序切片;当 \(K = 1\) 时,直接调用内置 max();仅当 \(K\) 远小于 \(N\) 时,它才在内部自动构建大小为 \(K\) 的最小堆执行流式遍历。因此开发者无需手写复杂的推拉循环。
三、operator 模块:超越 lambda 的高性能键提取器
无论是 sorted()、list.sort(),还是 heapq.nlargest(),它们都接受一个 key= 参数,用于在对字典、元组或自定义对象进行比较时指定排序基准。
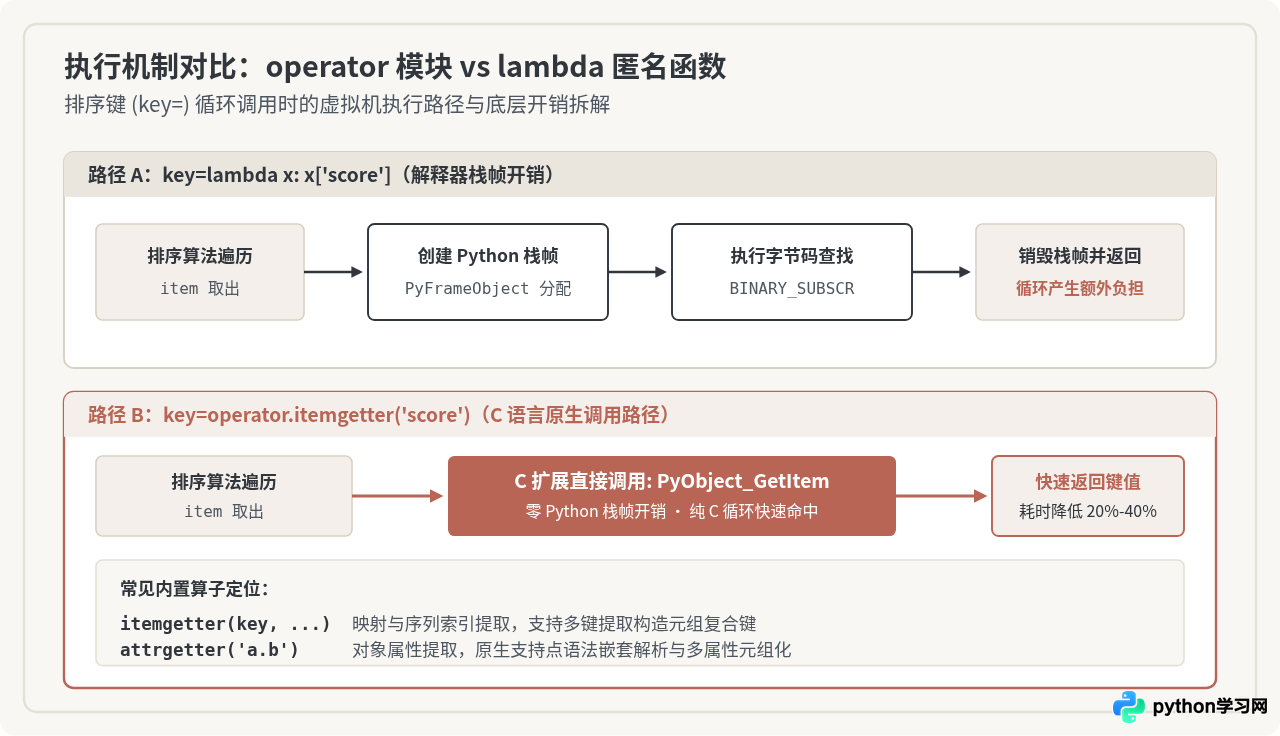
常规写法通常借助匿名函数:key=lambda x: x['score']。这种写法虽然直观,但在处理数十万级以上数据时,会暴露出严重的性能短板。
1. 为什么 lambda 会成为性能瓶颈?
在 Python 虚拟机层面,lambda 本质上是一个完整的 Python 函数对象(PyFunctionObject)。在排序比较的紧凑内层循环中,每比较一对元素,Python 虚拟机就必须:
- 在栈上为该匿名函数实例化一个栈帧对象(
PyFrameObject)。 - 切换解释器上下文,进入字节码求值循环(
LOAD_FAST、LOAD_CONST、BINARY_SUBSCR)。 - 函数执行完毕后清理并销毁栈帧。
当存在百万次比较时,这种栈帧的反复创建与销毁会占据惊人的 CPU 周期。而 operator 模块是用原生 C 语言实现的。例如 operator.itemgetter('score') 内部直接绑定了 C API 的 PyObject_GetItem,完全不走 Python 字节码解释栈,因此速度显著高于 lambda。
2. 核心提取器与用法示例
针对不同的数据结构组织方式,operator 提供了三个主力键提取函数:
(1) operator.itemgetter:序列切片与字典键提取
适用于字典、列表、元组等支持 __getitem__ 的映射或序列对象。更重要的是,它原生支持多键提取,返回一个元组,天然契合多级复合排序需求。
import operator

employees = [
    {"name": "Alice", "dept": "Tech", "level": 4},
    {"name": "Bob", "dept": "Tech", "level": 5},
    {"name": "Charlie", "dept": "Sales", "level": 3},
]

# 按单一字典键提取:等同于 lambda x: x["level"]
get_level = operator.itemgetter("level")

# 按多键提取:先按 dept 升序,dept 相同再按 level 升序
get_dept_and_level = operator.itemgetter("dept", "level")

sorted_staff = sorted(employees, key=get_dept_and_level)
print("多级排序结果:", sorted_staff)
执行输出(示例):
多级排序结果: [{'name': 'Charlie', 'dept': 'Sales', 'level': 3}, {'name': 'Alice', 'dept': 'Tech', 'level': 4}, {'name': 'Bob', 'dept': 'Tech', 'level': 5}]
(2) operator.attrgetter:面向对象属性提取与深层链式点语法
适用于自定义类实例或命名元组(namedtuple)。attrgetter 具备强大的点语法链式解析能力,能够直接跨越多层对象引用,无需手写多重嵌套判断。
import operator

class Address:
    def __init__(self, city, zipcode):
        self.city = city
        self.zipcode = zipcode

class Customer:
    def __init__(self, name, address):
        self.name = name
        self.address = address

customers = [
    Customer("Zhang", Address("Beijing", 100080)),
    Customer("Li", Address("Shanghai", 200000)),
    Customer("Wang", Address("Beijing", 100010)),
]

# 点语法跨对象提取:address.zipcode
sorted_customers = sorted(customers, key=operator.attrgetter("address.zipcode"))
print("按邮编排序:", [c.name for c in sorted_customers])
执行输出(示例):
按邮编排序: ['Wang', 'Zhang', 'Li']
(3) operator.methodcaller:动态方法调用提取
当比较标准由对象上的某个方法计算得出时,operator.methodcaller 允许直接调用该方法,并支持向其传递位置参数与关键字参数,同样避免了定义包装函数的开销。
四、协同实战:heapq 与 operator 联合处理复杂对象 Top-K
在现实业务中,最具性能价值的用法往往是两者的联合调用:使用 heapq.nlargest 或 heapq.nsmallest 锁定极值过滤范围,使用 operator.itemgetter 或 operator.attrgetter 提供高效的原生比较键。
实战场景:电商服务器高并发请求流过滤
假设我们有海量请求指标数据,每条记录包含请求 ID、响应状态码、耗时(毫秒)以及用户评级。目标是以最快的速度找出响应耗时最高的前 3 个请求。
import heapq
import operator

# 模拟从网络流或数据库游标持续拉取的数据源
request_metrics = [
    {"req_id": "req-001", "latency_ms": 124.5, "status": 200},
    {"req_id": "req-002", "latency_ms": 890.1, "status": 504},
    {"req_id": "req-003", "latency_ms": 45.2,  "status": 200},
    {"req_id": "req-004", "latency_ms": 512.8, "status": 500},
    {"req_id": "req-005", "latency_ms": 310.4, "status": 200},
    {"req_id": "req-006", "latency_ms": 1205.6, "status": 502},
]

# 协同过滤:直接利用 itemgetter 作为比较键提取器
slowest_requests = heapq.nlargest(
    3,
    request_metrics,
    key=operator.itemgetter("latency_ms")
)

print("=== 最耗时的 Top 3 请求 ===")
for item in slowest_requests:
    print(f"ID: {{item['req_id']}} | 耗时: {{item['latency_ms']}}ms | 状态: {{item['status']}}")
执行输出(示例):
=== 最耗时的 Top 3 请求 ===
ID: req-006 | 耗时: 1205.6ms | 状态: 502
ID: req-002 | 耗时: 890.1ms | 状态: 504
ID: req-004 | 耗时: 512.8ms | 状态: 500
进阶技巧:处理无法比较对象的堆平局异常(Tie-breaking)
在自定义流式维护优先队列时(使用 heappush(heap, (priority, task))),若两项的 priority 完全一致,Python 会自动比较元组的第二项 task。如果 task 是一个没有重载 __lt__ 的自定义类或字典,解释器就会抛出 TypeError: '<' not supported between instances。
标准库官方推荐的标准解法是在元组中间插入一个单调自增的计数器:
import heapq
import itertools

# 生成全局唯一的防冲突序列号
counter = itertools.count()
pq = []

def add_task(task, priority):
    count = next(counter)
    # 结构为:(优先级, 自增编号, 任务对象)
    heapq.heappush(pq, (priority, count, task))

add_task({"action": "email"}, priority=1)
add_task({"action": "sms"}, priority=1)  # 优先级相同,通过 count 破除平局

priority, _, task = heapq.heappop(pq)
print("弹出首个任务:", task)
自增计数器不仅阻止了对 task 对象的非法比较,还保证了同等优先级任务能够严格按照“先进先出”(FIFO)的稳定顺序出队。
五、选型决策指南与核心注意事项
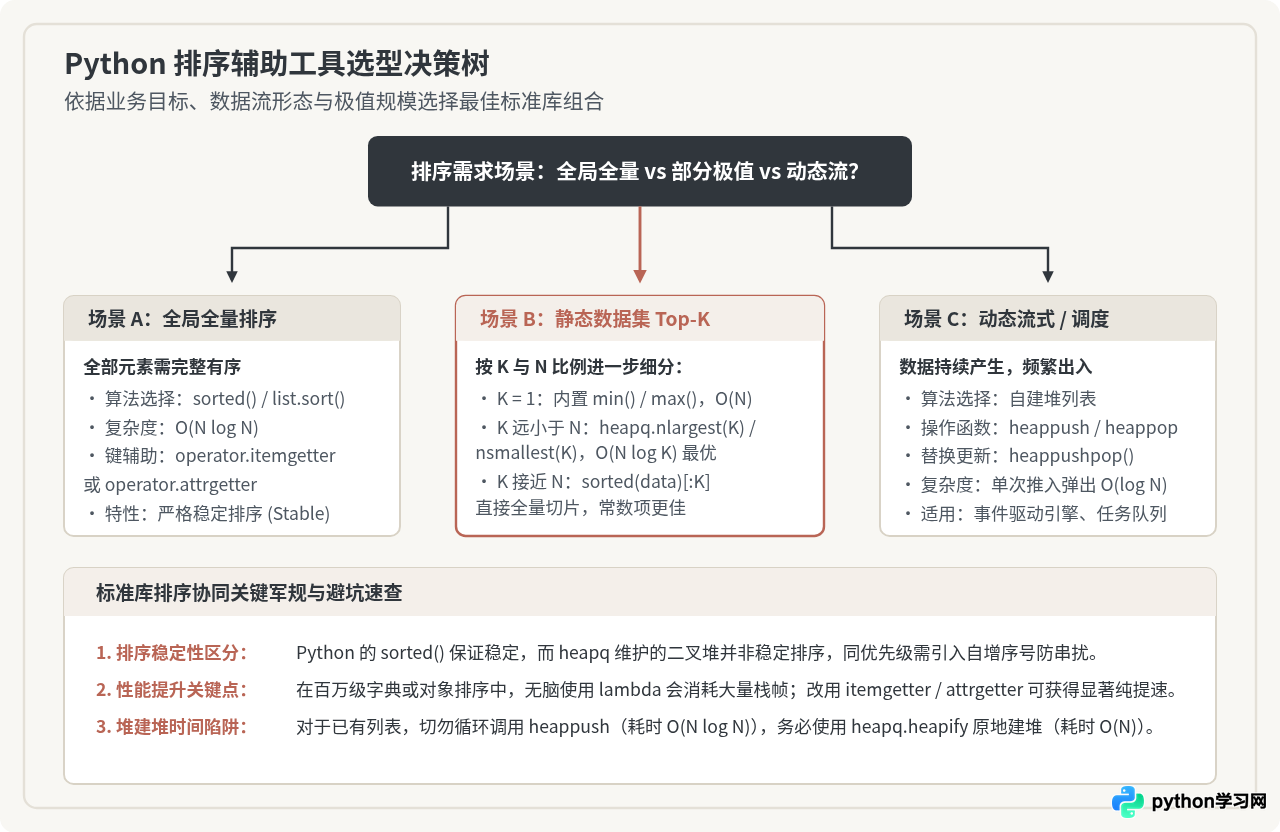
为了在实际架构中做出最精确的技术选型,我们可以将 Python 中的排序辅助需求收敛为一张清晰的决策路径图:
关键区别与排错要点
-
排序稳定性(Stability):
Python 的list.sort()和sorted()均具备稳定性保证(当两个元素 key 相同,原序列中的相对先后顺序在排序后保持不变)。然而,heapq维护的堆结构本身不是稳定排序。如果业务强依赖排序稳定性,必须在键值中主动追加索引(如itemgetter提取多键,或上文提及的计数器方案)。 -
最大堆(Max-Heap)的转换陷阱:
heapq默认仅提供最小堆。若需获取最大极值,除了直接调用nlargest外,在手动推拉场景下,数值型元素可以直接取反(如-priority)。但如果键值是字符串或复杂复合结构,无法取负数,推荐编写一个轻量级的逆序包装类(重载__lt__为self.val > other.val),或者借助nlargest的内部机制。 -
不要对已堆化列表调用常规排序:
如果在已堆化的列表上调用list.sort(),列表会变成全局有序,这虽然不会违反堆不变量,但会抹除原本针对堆操作的局部性优化;反之,若在需要堆操作的列表上直接调用普通修改函数(如append或insert),必须重新调用heapify()恢复堆不变量,否则后续的heappop()返回的数据将不再可靠。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















