


Python接口调用后怎么高效解析嵌套JSON响应数据
深入讲解Python调用接口后高效解析多层嵌套JSON响应数据的核心方法、寻址机制与工程选型,涵盖原生安全提取、JMESPath表达式查询、Pydantic强类型模型反序列化及性能调优实践。
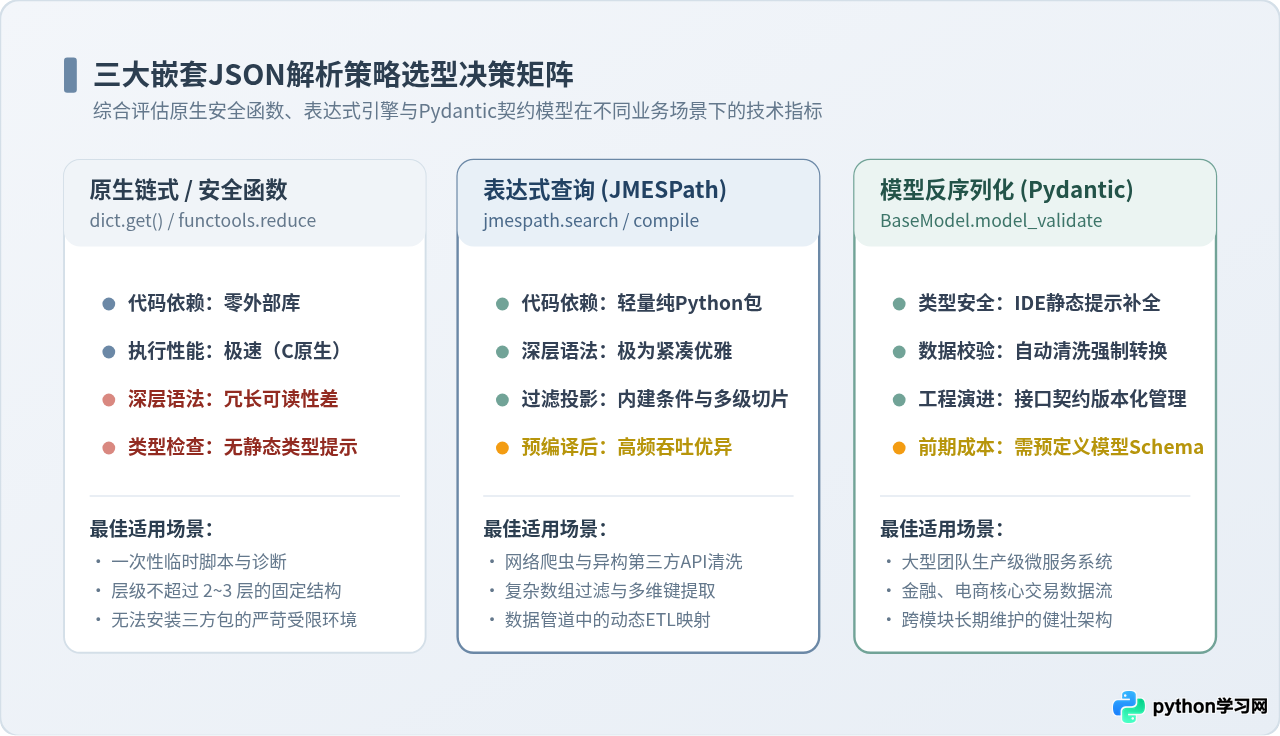
functools.reduce 或链式防御的安全取值;包含多层动态数组与条件筛选的深层数据,采用预编译的 JMESPath 表达式实现单行投影;而对于生产微服务或长链路协作系统,直接借助 Pydantic 模型进行声明式反序列化,能够一次性完成类型转换、缺失值填充与静态校验。
一、认识嵌套 JSON 的典型结构与解析痛点
现代 Web 接口(RESTful 或 RPC 网关)很少返回扁平的键值对,通常包含请求元数据、业务状态、分页信息以及多层级联的业务实体。一个典型的接口响应数据结构如下所示:
import requests

# 模拟调取电商订单或内容聚合接口
response = requests.get("https://api.example.com/v1/orders/recent")
data = response.json()

# 典型的返回数据样例:
# {
#     "code": 200,
#     "message": "success",
#     "data": {
#         "pagination": {"page": 1, "total": 120},
#         "records": [
#             {
#                 "order_id": "ORD-1001",
#                 "buyer": {"id": 8801, "profile": {"nickname": "张三", "city": "杭州"}},
#                 "items": [
#                     {"sku_id": "A1", "price": 49.9, "quantity": 2},
#                     {"sku_id": "B2", "price": 19.0, "quantity": 1}
#                 ]
#             }
#         ]
#     }
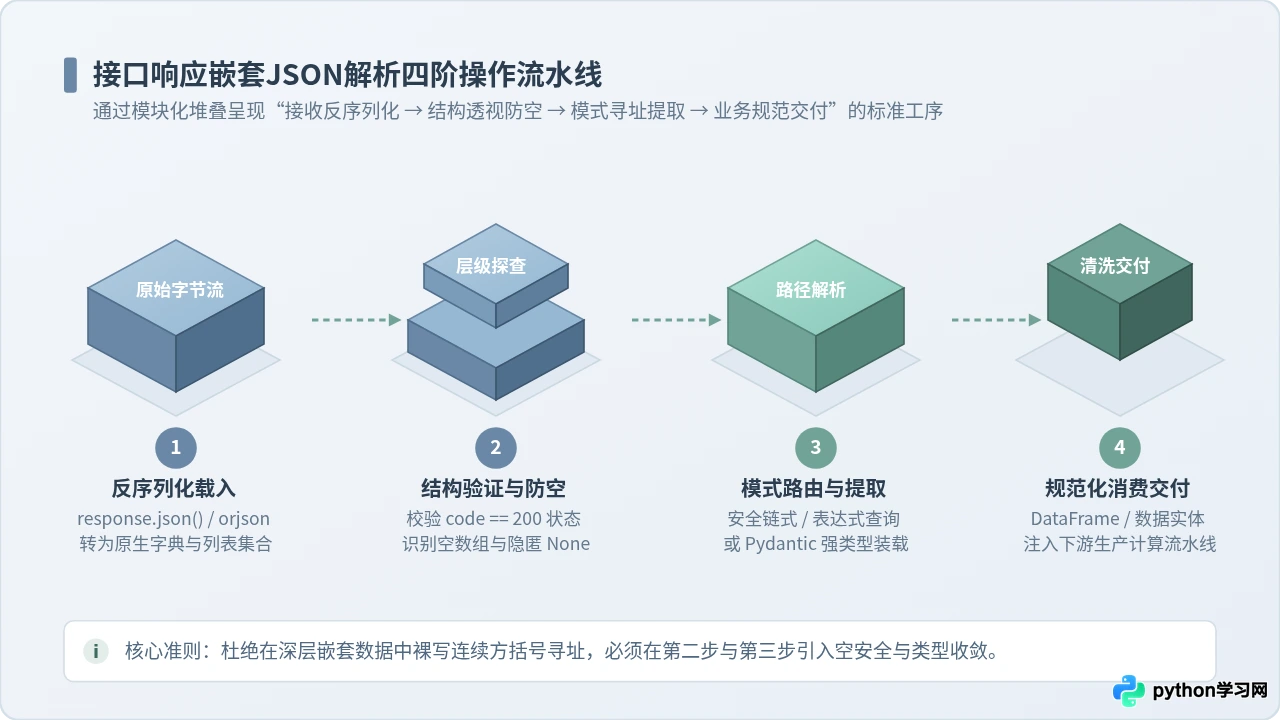
# }面对这类结构,最直观的写法往往是直接按键逐层访问:data["data"]["records"][0]["buyer"]["profile"]["nickname"]。这种写法在实际生产中存在严重的稳定性缺陷:
- 异常敏感脆弱:如果接口偶发异常返回
{"code": 500, "message": "error"},第一层data["data"]就会立即抛出KeyError导致程序崩溃中断。 - 空值隐匿陷阱:即便使用了字典的
.get()方法,例如data.get("data").get("records"),只要"data"对应的字段值为None(API 常用的空状态表达),紧随其后的调用就会抛出AttributeError: 'NoneType' object has no attribute 'get'。 - 列表切片越界:当
records返回空列表[]时,下标[0]会直接触发IndexError。
二、方案一:原生标准库下的高效防御式提取
当项目受限于依赖管理(例如轻量无依赖环境、云函数、一次性数据清洗脚本),或者嵌套结构相对固定时,无需引入第三方库,通过标准库封装函数即可实现零异常的快速寻址。
1. 基于 reduce 实现深层路径安全寻址
借助 Python 标准库内置的 functools.reduce,我们可以将冗长的 .get() 链条抽象为一个通用路径解析器。它接受一个以点号分隔的键路径或序列,层层深入,遇到任何环节为 None 或非字典类型时自动短路并返回预设的默认值:
from functools import reduce
from typing import Any, Mapping

def get_nested(data: Mapping, path: str, default: Any = None) -> Any:
    """
    通过点分路径安全读取多层嵌套字典
    示例: get_nested(data, "data.pagination.total", default=0)
    """
    keys = path.split(".")
    try:
        val = reduce(
            lambda current, key: current.get(key) if isinstance(current, dict) else None,
            keys,
            data
        )
        return default if val is None else val
    except (AttributeError, TypeError):
        return default

# 示例调用:
user_city = get_nested(data, "data.records.0.buyer.profile.city", default="未知")
2. 列表推导式与生成器的高效数组解构
当嵌套数据中包含数组(如订单列表中的商品项)时,若只需获取特定字段集合,可以使用带有保护条件的列表推导式:
# 提取所有订单中所有商品的 sku_id,过滤空值与非法记录
records = (data.get("data") or {}).get("records", [])

all_skus = [
    item["sku_id"]
    for record in records if isinstance(record, dict)
    for item in record.get("items", []) if isinstance(item, dict) and "sku_id" in item
](data.get("data") or {}) 可以有效将接口返回的 None 优雅转换为备用空字典,阻断后续的 AttributeError 连锁反应。
三、方案二:声明式表达式查询(JMESPath)——复杂多层过滤的利器
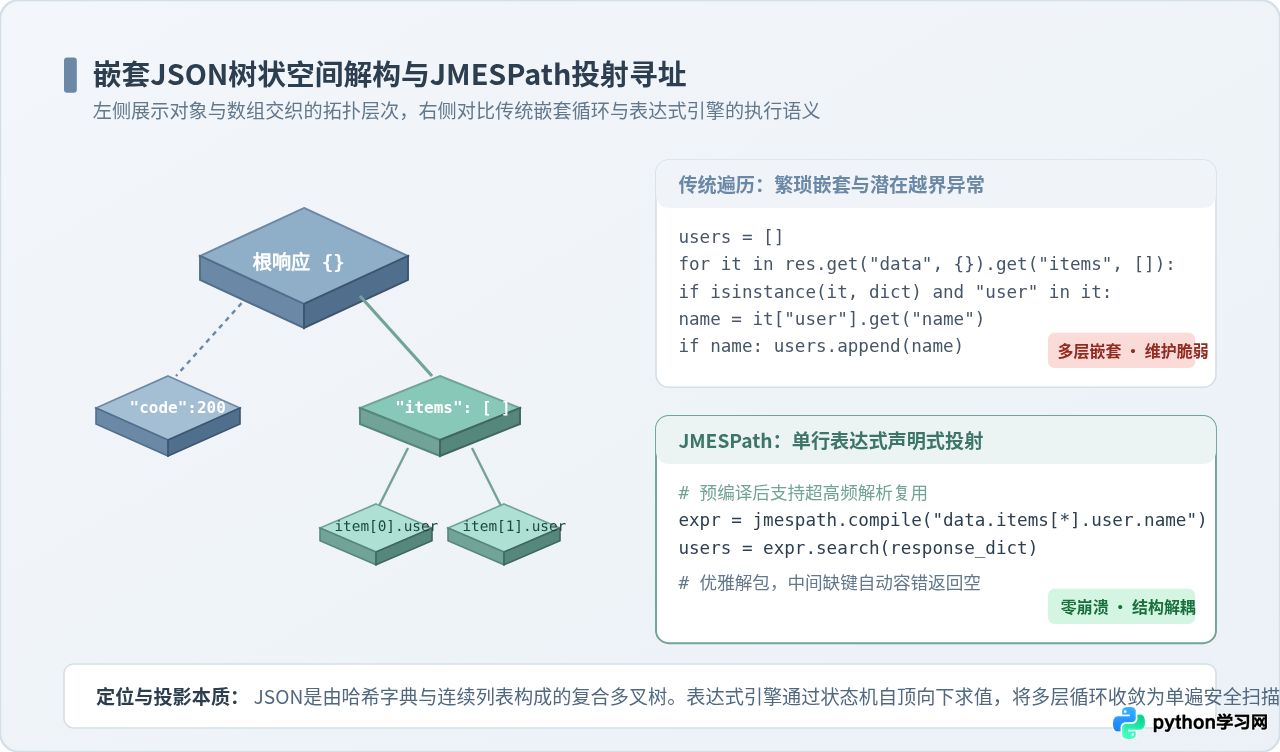
如果接口数据层次深(4 层以上),且包含大量的动态数组投影、条件过滤(如“只取单价大于 30 的商品名称”),手写多层推导式会导致代码可读性急剧恶化。此时,采用 JMESPath 是业界公认最优雅高效的解决方式。
JMESPath 是专门为 JSON 结构设计的声明式查询规范,AWS 官方 CLI 及大量现代框架均将其作为首选解析引擎。在 Python 中,通过 pip install jmespath 即可安装。
1. 常用核心语法与投影范例
JMESPath 允许开发者像编写 SQL 表达式一样,直接提取深层数据,并且内部自动处理所有层级的空值与缺键判断:
import jmespath

response_payload = {
    "data": {
        "records": [
            {
                "order_id": "ORD-1001",
                "buyer": {"name": "张三", "vip": True},
                "items": [
                    {"name": "机械键盘", "price": 299},
                    {"name": "鼠标垫", "price": 29}
                ]
            },
            {
                "order_id": "ORD-1002",
                "buyer": {"name": "李四", "vip": False},
                "items": [
                    {"name": "显示器支架", "price": 149}
                ]
            }
        ]
    }
}

# 1. 数组全量投射:提取所有买家的姓名
names = jmespath.search("data.records[*].buyer.name", response_payload)
# 得到: ['张三', '李四']

# 2. 扁平化多级数组:提取所有订单下的所有商品名称
item_names = jmespath.search("data.records[*].items[*].name[]", response_payload)
# 得到: ['机械键盘', '鼠标垫', '显示器支架']

# 3. 条件过滤:仅筛选出 VIP 用户的订单 ID
vip_orders = jmespath.search("data.records[?buyer.vip == `true`].order_id", response_payload)
# 得到: ['ORD-1001']

# 4. 多重投影构建新字典结构
summary = jmespath.search("""
    data.records[*].{
        id: order_id,
        buyer_name: buyer.name,
        total_items: length(items)
    }
""", response_payload)
2. 性能倍增技巧:预编译表达式
高频调用接口(例如批量爬取或处理数万条消息队列)时,直接调用 jmespath.search 会在每次调用时解析语法树。使用 jmespath.compile 可以将表达式预编译为可复用的 AST 对象,解析吞吐量通常可提升 3 到 5 倍:
# 预编译表达式(作为全局单例或模块级变量)
EXTRACTOR = jmespath.compile("data.records[*].buyer.name")

def process_batch(api_responses):
    result = []
    for payload in api_responses:
        # 直接使用编译对象 search,避开重复词法解析
        result.extend(EXTRACTOR.search(payload) or [])
    return result
四、方案三:基于 Pydantic 的强类型契约反序列化——企业级架构首选
在严肃的企业级系统、微服务交互以及跨团队协作中,接口返回的数据不仅需要“被解析”,更需要“被验证”和“类型固化”。字典操作容易带来拼写错误、类型漂移(如将字符串数字 "100" 与数值混淆)等问题。使用 Pydantic (v2) 能够实现声明式反序列化。
1. 声明嵌套数据模型
通过定义继承自 BaseModel 的类,清晰地映射接口的每个嵌套层级:
from pydantic import BaseModel, Field
from typing import List, Optional

class ItemModel(BaseModel):
    sku_id: str
    price: float
    quantity: int = 1  # 缺省兜底值

class BuyerProfile(BaseModel):
    nickname: str
    city: Optional[str] = "未知"

class BuyerModel(BaseModel):
    id: int
    profile: BuyerProfile

class OrderRecord(BaseModel):
    order_id: str
    buyer: BuyerModel
    items: List[ItemModel] = Field(default_factory=list)

class ApiResponse(BaseModel):
    code: int
    message: str
    records: List[OrderRecord] = Field(alias="data.records", default_factory=list)
2. 一行代码加载与 IDE 静态补全支持
raw_json_dict = response.json()

# 一键反序列化校验
order_data = OrderRecord.model_validate(raw_json_dict["data"]["records"][0])

# 享受完整的类型提示与智能补全
print(order_data.buyer.profile.city)  # IDE 自动提示 city 属性
print(order_data.items[0].price * 2)  # price 已保证转换为 float
如果接口上游修改了字段类型(例如价格字段误传了非法字符),Pydantic 会立即抛出具体的 ValidationError,明确指出具体哪一行、哪个键不符合契约,极大降低了排查链路 Bug 的成本。
五、大规模数据与高并发场景下的解析性能优化
在日常解析中,标准库 json 已经足够通用;但在面临数十兆大报文、百万次高并发接口轮询时,底层的反序列化与内存驻留往往是性能瓶颈所在。
1. 替换反序列化引擎:orjson / ujson
标准库 json.loads() 采用纯 C 扩展,性能尚可,但基于 Rust 开发的 orjson 在反序列化复杂嵌套结构时,速度通常是标准库的 3~6 倍,且内存分配更紧凑:
import orjson

# 直接反序列化 response.content(原始字节流二进制)
# 避免 requests.text 先做 utf-8 字符串解码再反序列化的双重开销
data = orjson.loads(response.content)
2. 超大响应流式分块解析:ijson
当某些历史归档接口一次性吐出几百兆甚至数吉字节的巨大 JSON 时,直接载入内存会导致服务 OOM(内存溢出)。此时应使用 ijson 进行迭代式流式解析:
import ijson

# 流式读取响应流,仅按需加载每一条 record 对象
with requests.get("https://api.example.com/huge-dump", stream=True) as resp:
    # 语法映射对应 data.records 下的每个 item
    records_iter = ijson.items(resp.raw, "data.records.item")
    for record in records_iter:
        # 处理单条记录,处理完即由垃圾回收器释放内存
        process_single_record(record)
六、高效解析关键特性与技术方案横向对比
| 解析技术方案 | 依赖成本 | 解析速度 | 防崩鲁棒性 | 开发代码量 | 工程维护契约 |
|---|---|---|---|---|---|
| 原生 dict.get / reduce | 无(标准库) | 极高 | 需手动防护 | 偏多(中度冗长) | 弱(纯动态字典) |
| JMESPath 表达式 | 极低(纯 Python) | 高(预编译后) | 极高(内部容错) | 极简(单行搞定) | 中(表达式字符串驱动) |
| Pydantic 契约模型 | 中(需安装库) | 中偏高(v2 Rust内核) | 最高(强类型断言) | 初次建模稍多 | 最高(支持IDE重构) |
七、常见陷阱与避坑指南
dict.get(key, default) 的空值误区当 JSON 中明确包含
{"user": null} 时,data.get("user", {}) 并不会返回默认的空字典 {},而是返回 None,因为键 "user" 确实存在!正确的防护写法应是 (data.get("user") or {})。
若字段本身合法取值为
False 或数值 0,使用 or default 会将合法值错误地覆盖为默认值。在区分布尔状态与数值时,应当显式判断 if val is not None,而非依赖隐式布尔转换。
很多接口会将某些嵌套对象再次序列化为 JSON 字符串存放在字段中(即“Stringified JSON”)。遇到形如
"extra": "{\"tag\": \"new\"}" 时,需要明确区分是原生嵌套对象还是嵌套字符串,必要时在数据接入层使用预处理函数进行一次性解包。
八、总结与落地建议
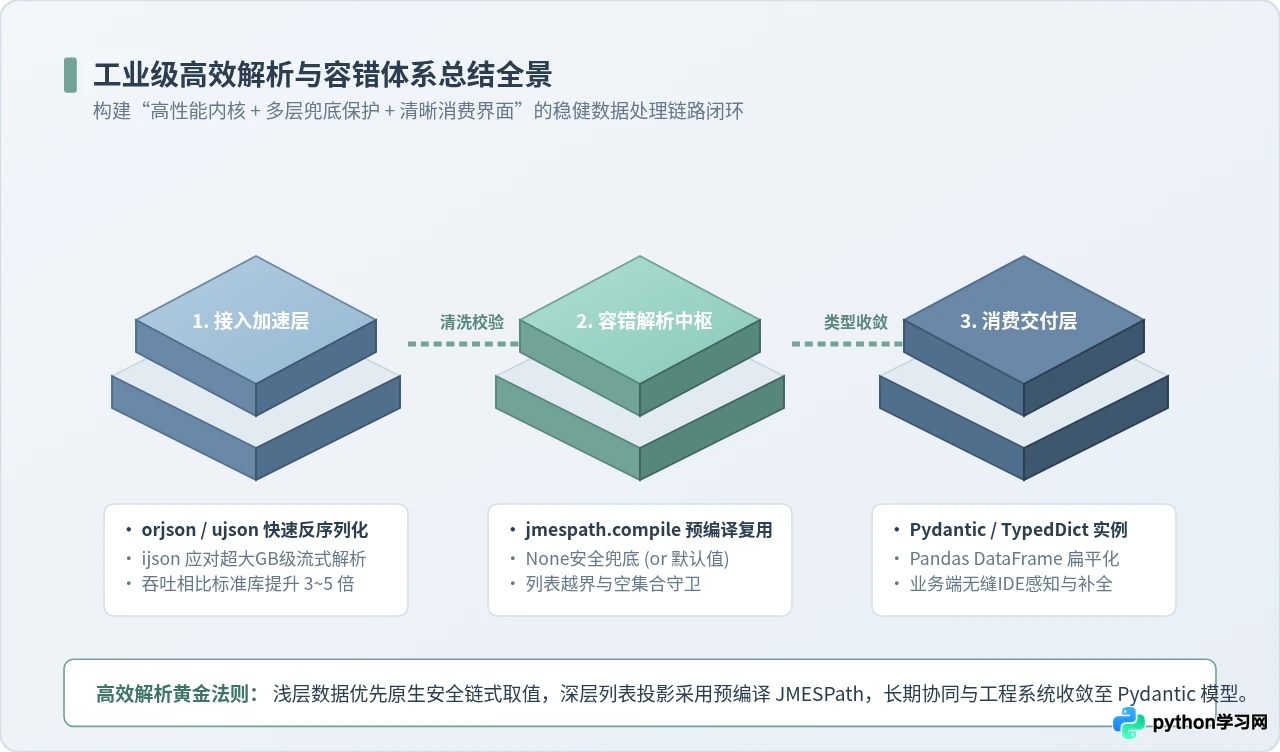
高效解析 Python 接口调用的嵌套 JSON 数据,并非单纯追求写法的简短,而是兼顾开发效率、运行吞吐与防御性编程:
- 快速探查与临时处理:使用封装的
reduce或原生短路逻辑,满足零外部依赖与极速执行需求; - 复杂层次抽取与动态清洗:将
JMESPath表达式预编译为模块对象,以极具表现力的语法完成数组投影与字段切片; - 团队项目与核心业务通道:建立
Pydantic数据契约,将不可控的外部响应规范化为结构严密、类型安全的领域模型。
在实际工程中,结合 orjson 的底层加速与上述模式路由,即可彻底告别混乱的 KeyError,构建出高效稳健的 API 消费管道。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















