


Python异步编程完整代码示例:使用asyncio实现并发网络请求
本文提供使用Python asyncio与aiohttp实现并发网络请求的完整代码示例与深度讲解,涵盖同步与异步机制对比、事件循环运行原理、信号量并发控制及生产级异常处理方案。
在批量采集数据、调用第三方微服务或抓取多个网页时,传统的同步网络请求会造成严重的等待浪费。本文的目标是提供一套能够直接运行且具备生产容错能力的完整代码,利用 Python 内置的 asyncio 模块与高性能异步 HTTP 客户端 aiohttp,在单线程环境下高效实现成百上千个网络请求的并发执行,并解决并发过载控制与超时异常处理等关键工程问题。
一、原理机制:同步阻塞与异步事件循环的本质差异
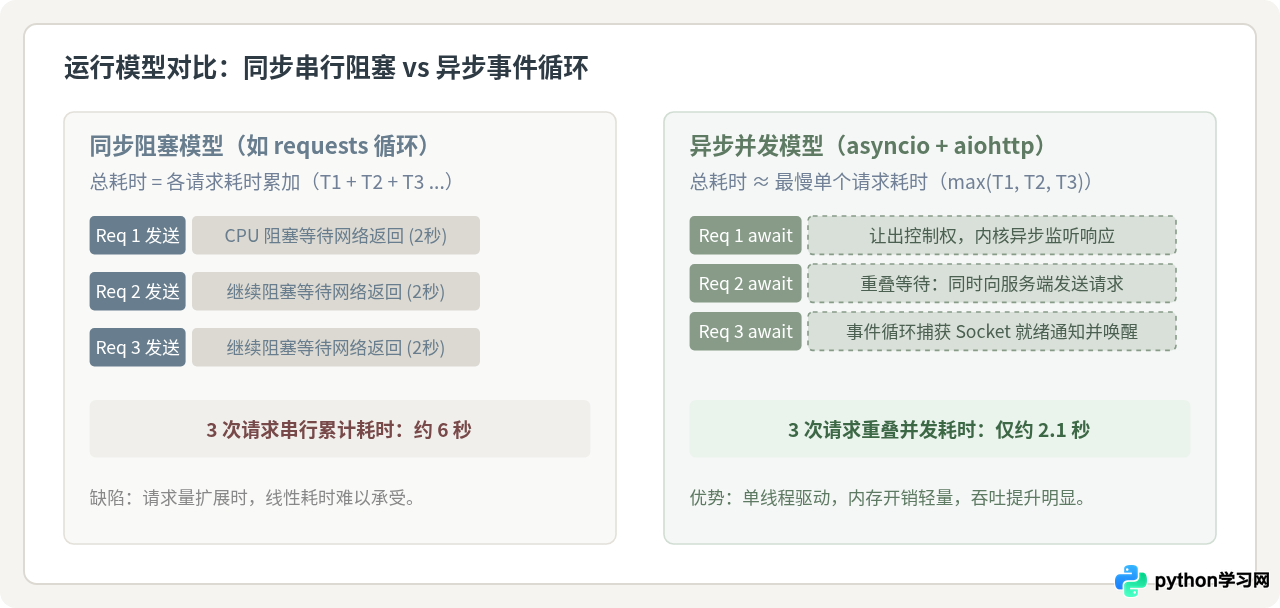
很多初学者会疑惑:为什么不开启多线程或多进程,而要使用 asyncio?要理解这个问题,首先需要在相同的测试条件下对比两种网络处理模式的行为差异。
网络请求属于典型的 I/O 密集型任务。当程序向远程服务器发出 HTTP 请求后,CPU 大部分时间处于空转状态,耗时几乎全部集中在“域名解析、建立 TCP 连接、远程服务端处理、网络数据包传输”这些外部网络通信上。
| 对比维度 | 同步网络请求 (如 requests) | 异步网络请求 (asyncio + aiohttp) |
|---|---|---|
| 并发实现机理 | 依赖操作系统多线程或多进程,每个连接占用一个独立线程上下文。 | 单线程内维护一个事件循环(Event Loop),依靠底层操作系统 epoll/kqueue 进行多路复用。 |
| 等待期间行为 | 线程被系统底层阻塞挂起,无法处理其他计算,线程切换开销随数量攀升。 | 遇到 await 立即主动让渡控制权,让事件循环立刻执行其他就绪任务。 |
| 内存与系统资源 | 线程栈默认占用几百 KB 到数 MB,1000 个线程即可耗尽系统内存。 | 一个协程仅为一个几 KB 的 Python 对象,单进程支持数千并发。 |
二、核心组件与架构流程
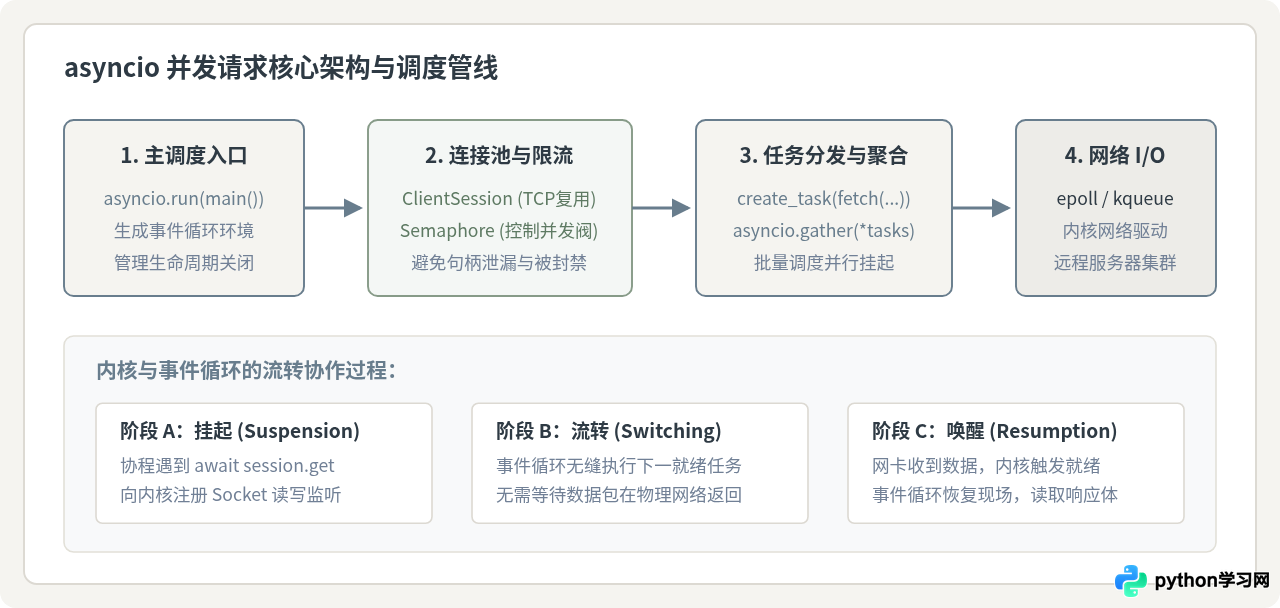
实现高效的异步网络请求,需要协作使用以下四个关键对象:
- Event Loop(事件循环):负责注册、调度和执行所有协程任务的中心调度器,监听网络套接字事件并唤醒挂起的任务。
- aiohttp.ClientSession(客户端会话):统一管理底层 TCP 连接池,复用长连接(Keep-Alive)与 DNS 解析缓存,严禁对每个请求单独新建 Session。
- asyncio.Semaphore(信号量):并发阀门。虽然异步可以瞬间发起数千请求,但远程服务器和本地文件句柄有承受上限,必须通过信号量限制同时在途的连接数量。
- asyncio.gather / create_task(任务包装与聚合):将各个带有参数的异步协程包装为 Task,并发提交至事件循环并收集返回结果。
三、准备工作与环境依赖
Python 3.8 及更高版本已经内置了成熟稳定的 asyncio 核心模块。但由于标准库只提供底层的 Socket 抽象,没有直接提供高层异步 HTTP 客户端,因此需要安装业界标准的第三方异步 HTTP 库 aiohttp:
pip install aiohttp注意:切勿在异步协程中使用同步请求库(例如 requests.get() 或 urllib.request),因为同步调用会直接在底层阻塞整个主线程,导致事件循环中排队的其他全部异步任务无法流转,使异步并发退化为单任务串行。
四、完整可运行代码示例
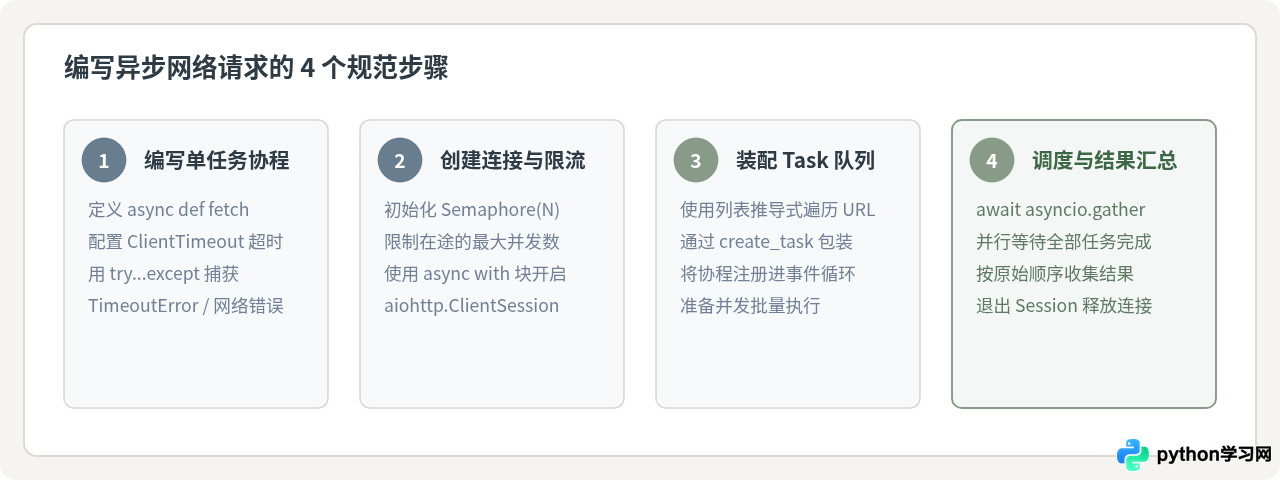
下面给出一段完整的工程化代码。代码中包含了连接池配置、并发限流(信号量)、独立超时设定以及结构化异常返回,避免因某个单点网络异常导致整体流程中断退出。
import asyncio
import aiohttp
import time
from typing import List, Dict, Any

# 测试 URL 列表:包含正常响应与不同延迟的请求接口
URLS = [
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/2",
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/2",
    "https://httpbin.org/status/200",
    "https://httpbin.org/status/404",  # 模拟 HTTP 错误
]

async def fetch_url(
    session: aiohttp.ClientSession,
    url: str,
    semaphore: asyncio.Semaphore
) -> Dict[str, Any]:
    """
    单个网络请求协程
    :param session: 全局复用的 ClientSession 连接池
    :param url: 目标请求地址
    :param semaphore: 控制最大并发数的信号量
    :return: 结构化的请求结果字典
    """
    # 获取信号量配额,超出上限的任务将在该上下文处挂起等待
    async with semaphore:
        # 配置单次请求的超时时间(连接超时 3 秒,总读取超时 10 秒)
        timeout_cfg = aiohttp.ClientTimeout(total=10, connect=3)
        try:
            async with session.get(url, timeout=timeout_cfg) as response:
                status = response.status
                # 当响应为 200 时读取文本;非 200 时记录状态码
                if status == 200:
                    text_content = await response.text()
                    return {
                        "url": url,
                        "status": status,
                        "success": True,
                        "length": len(text_content),
                        "error": None
                    }
                else:
                    return {
                        "url": url,
                        "status": status,
                        "success": False,
                        "length": 0,
                        "error": f"HTTP状态码异常: {status}"
                    }
        except asyncio.TimeoutError:
            return {
                "url": url,
                "status": None,
                "success": False,
                "length": 0,
                "error": "请求超时"
            }
        except aiohttp.ClientError as err:
            return {
                "url": url,
                "status": None,
                "success": False,
                "length": 0,
                "error": f"网络通信故障: {type(err).__name__}"
            }
        except Exception as ex:
            return {
                "url": url,
                "status": None,
                "success": False,
                "length": 0,
                "error": f"未预料异常: {str(ex)}"
            }

async def run_concurrent_requests(target_urls: List[str], max_concurrency: int = 3):
    """
    并发调度主控函数
    :param target_urls: 待抓取的 URL 列表
    :param max_concurrency: 最大并发连接数限制
    """
    # 1. 实例化信号量
    semaphore = asyncio.Semaphore(max_concurrency)

    # 2. 配置 TCP 连接器:限制底层总连接数与每个 Host 的并发连接数
    connector = aiohttp.TCPConnector(limit=20, limit_per_host=5, enable_cleanup_closed=True)

    print(f"[*] 开始执行并发网络请求...")
    print(f"[*] 待请求总量: {len(target_urls)},最大在途并发限制: {max_concurrency}")
    start_time = time.perf_counter()

    # 3. 开启 ClientSession 会话,统一管理连接生命周期
    async with aiohttp.ClientSession(connector=connector) as session:
        # 4. 创建 Task 列表并注册到事件循环
        tasks = [
            asyncio.create_task(fetch_url(session, url, semaphore))
            for url in target_urls
        ]

        # 5. 挂起等待所有并发任务就绪返回,结果顺序与 tasks 一致
        results = await asyncio.gather(*tasks, return_exceptions=False)

    total_time = time.perf_counter() - start_time
    print(f"[✓] 所有网络请求执行完毕,累计总耗时: {total_time:.2f} 秒\n")

    # 输出结果汇总表格
    print(f"{'序号':<6}{'状态':<10}{'大小(字节)':<12}{'目标 URL'}")
    print("-" * 65)
    for idx, item in enumerate(results, start=1):
        if item["success"]:
            status_text = f"200 OK"
            size_text = str(item["length"])
        else:
            status_text = f"FAIL({item['status'] or '-'})"
            size_text = "0"
        print(f"[{idx:<3}] {status_text:<10} {size_text:<12} {item['url']}")

    # 打印错误明细(如果有)
    failures = [r for r in results if not r["success"]]
    if failures:
        print(f"\n[!] 异常请求排查 ({len(failures)}项):")
        for f in failures:
            print(f"    - {f['url']} -> 原因: {f['error']}")

def main():
    # 程序入口:启动 asyncio 顶层事件循环
    asyncio.run(run_concurrent_requests(URLS, max_concurrency=3))

if __name__ == "__main__":
    main()
运行结果示例说明
将上述脚本保存为 async_fetch.py 并运行(python async_fetch.py),控制台输出示例如下:
[*] 开始执行并发网络请求...
[*] 待请求总量: 6,最大在途并发限制: 3
[✓] 所有网络请求执行完毕,累计总耗时: 3.12 秒

序号  状态      大小(字节)   目标 URL
-----------------------------------------------------------------
[1  ] 200 OK     380         https://httpbin.org/delay/1
[2  ] 200 OK     380         https://httpbin.org/delay/2
[3  ] 200 OK     380         https://httpbin.org/delay/1
[4  ] 200 OK     380         https://httpbin.org/delay/2
[5  ] 200 OK     9591        https://httpbin.org/status/200
[6  ] FAIL(404)  0           https://httpbin.org/status/404

[!] 异常请求排查 (1项):
    - https://httpbin.org/status/404 -> 原因: HTTP状态码异常: 404
在同步执行模式下,单是 delay/1 与 delay/2 的 4 次请求就必须串行等待 1+2+1+2 = 6 秒;而在异步并发(限制最大并发数为 3)的场景下,两组耗时重叠,整个过程仅耗费约 3 秒,性能提升超过 100%。
五、工程实践中的核心注意事项与排错指南
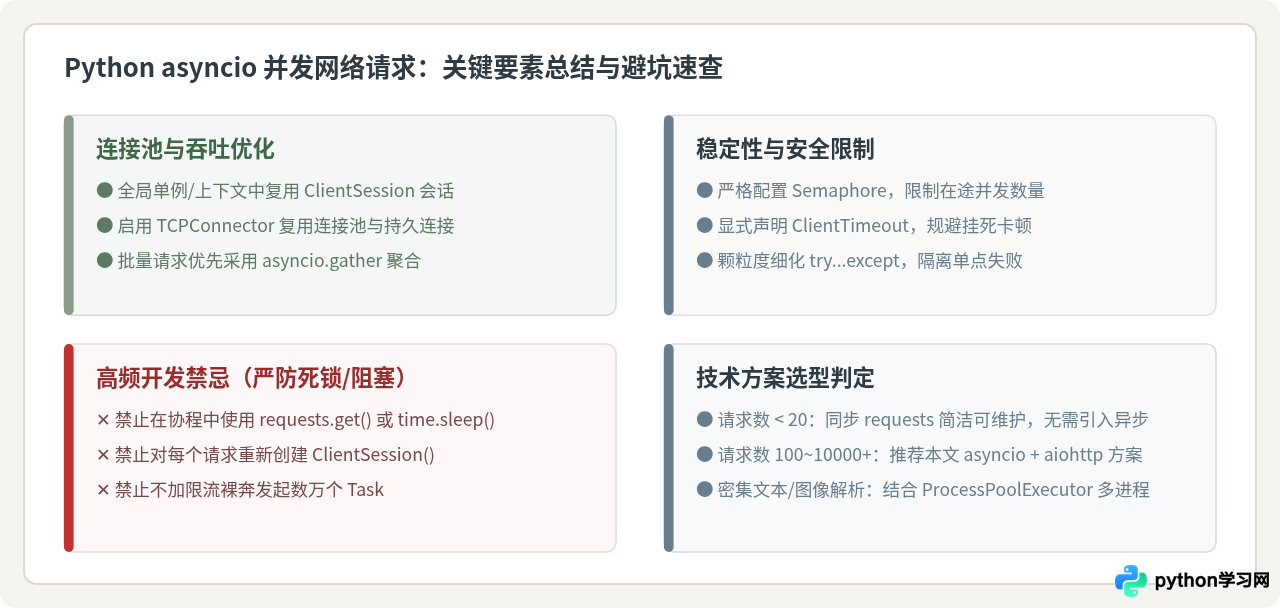
在实际生产项目中编写异步网络请求,有四个极为高发的陷阱需要格外防范:
- 必须复用
ClientSession,禁止单次请求新建:每次新建 Session 都会导致全新的 TCP 握手握手与 TLS 协商,彻底废弃了 HTTP Keep-Alive 连接池,不仅大幅降低速度,还极易引发操作系统的Too many open files(文件描述符耗尽)故障。 - 务必配置
asyncio.Semaphore信号量阀门:虽然异步协程本身可以瞬间生成 10000 个任务,但如果直接将它们同时gather出去,很容易瞬间占满本地可用端口,或者触发目标站点的防爬限流策略(HTTP 429 Too Many Requests)导致 IP 被封禁。 - 使用
ClientTimeout设定双重超时:网络通信中可能存在远端假死或连接卡死现象。若不设超时,协程将永远停留在await状态无法释放。 - 分清 CPU 密集与 I/O 密集任务边界:异步协程运行在单一线程内,如果某个协程内包含了耗时很长的 CPU 计算(如图像处理、密码解密、大规模正则回溯),主线程会被强行霸占,事件循环将停滞不前。遇到高 CPU 计算时,应使用
loop.run_in_executor()转交给进程池处理。
六、总结
Python 的异步编程并非神秘黑盒,其实质是在单线程环境下,利用事件循环协调等待时间,将原本“发呆等待网络响应”的 CPU 空闲期,转用于调度并发送其他任务的请求。遵循 “复用 ClientSession 连接池 + 信号量严格限流 + 设置完善的 ClientTimeout 与异常捕获” 这一范式,即可写出兼具高吞吐量与高稳健性的并发网络程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















