


编写高质量Python注释的最佳实践:避免废话说明
深入探讨编写高质量Python注释的最佳实践,剖析机械复述型废话注释的危害与成因,提供自解释代码重构四步法、Docstring与类型标注的职责分工,以及真正需要编写高质量Why注释的核心场景。
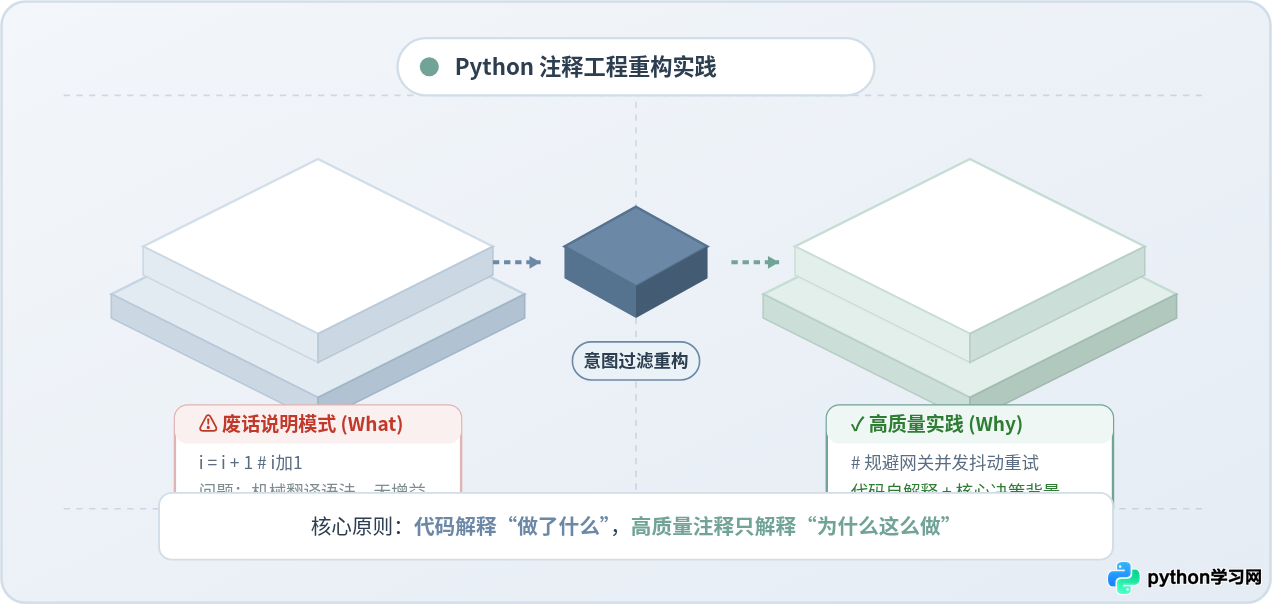
一、什么是“废话说明”:常见典型场景与识别方法
“废话说明”是指那些仅在字面层面机械复述代码语法、变量名或基础操作的注释。阅读这些注释所获得的信息量,完全没有超越代码行本身。在 Python 这样的高可读性语言中,这类注释毫无存在价值。
在实际代码库中,废话注释往往集中出现在以下四类典型场景中:
1. 机械翻译语法与变量名
作者把 Python 语法照搬翻译为自然语言中文。这种注释假设读者不懂基本的编程语言特性,既是对读者智商的低估,也是对屏幕空间的浪费:
i = i + 1  # 将 i 的值自增 1
user_list = []  # 创建一个空的用户列表
is_active = True  # 将激活状态设为 True
return result  # 返回最终结果
2. 给晦涩糟糕代码充当“遮羞布”
许多开发者倾向于在写出复杂的嵌套条件、长单行表达式或毫无意义的单字母变量后,试图用一段长注释向读者交代其含义。这种做法本末倒置——不要试图用注释解释糟糕的代码,而应该直接重构代码本身。
# 如果用户的类型是 1 且账户余额大于 100 并且注册天数超过 30 天,则允许享受 VIP 折扣
if u.t == 1 and u.b > 100 and (now - u.created).days > 30:
    apply_discount(u)
3. 将注释当做版本控制工具与日志
在代码中手动记录修改人、修改日期与历史变更记录,例如 # 2024-03-12 由张三修改为新逻辑。现代软件工程使用 Git 管理历史记录,此类注释极难维护,且会在频繁修改中迅速失去准确性,属于纯粹的代码垃圾。
4. 毫无意义的结构占位与修辞
在类定义或方法内部充斥着 # 初始化方法、# 私有变量开始、# 辅助函数结束 等占位符。Python 的类结构、缩进和方法签名已经清晰展现了这些层级,额外标签完全属于视觉噪声。
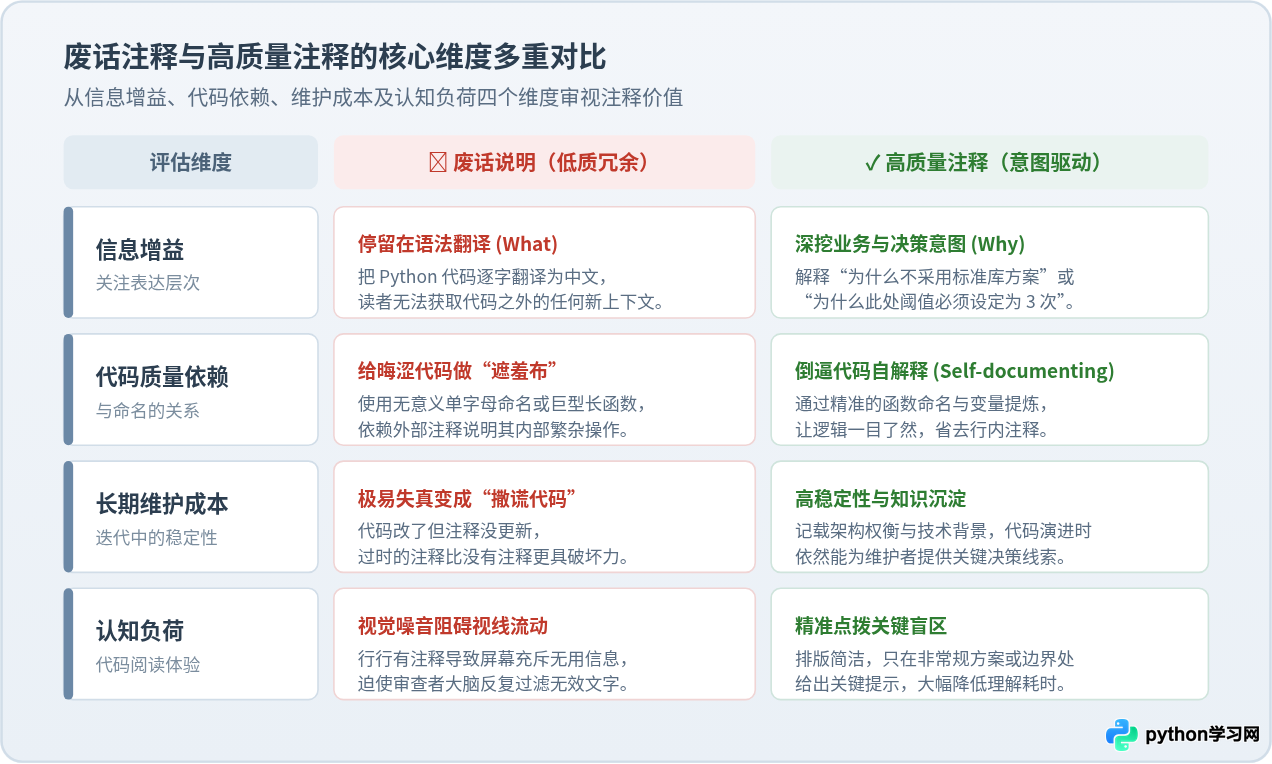
二、注释重构四步法:从“废话说明”到“自解释代码”
消除废话说明并不是倡导“全盘不写注释”,而是建立一套从“发现废话”到“自解释重构”,最终“提炼高质量意图”的系统化操作流程。可以通过以下四个递进步骤完成代码注释的重构:
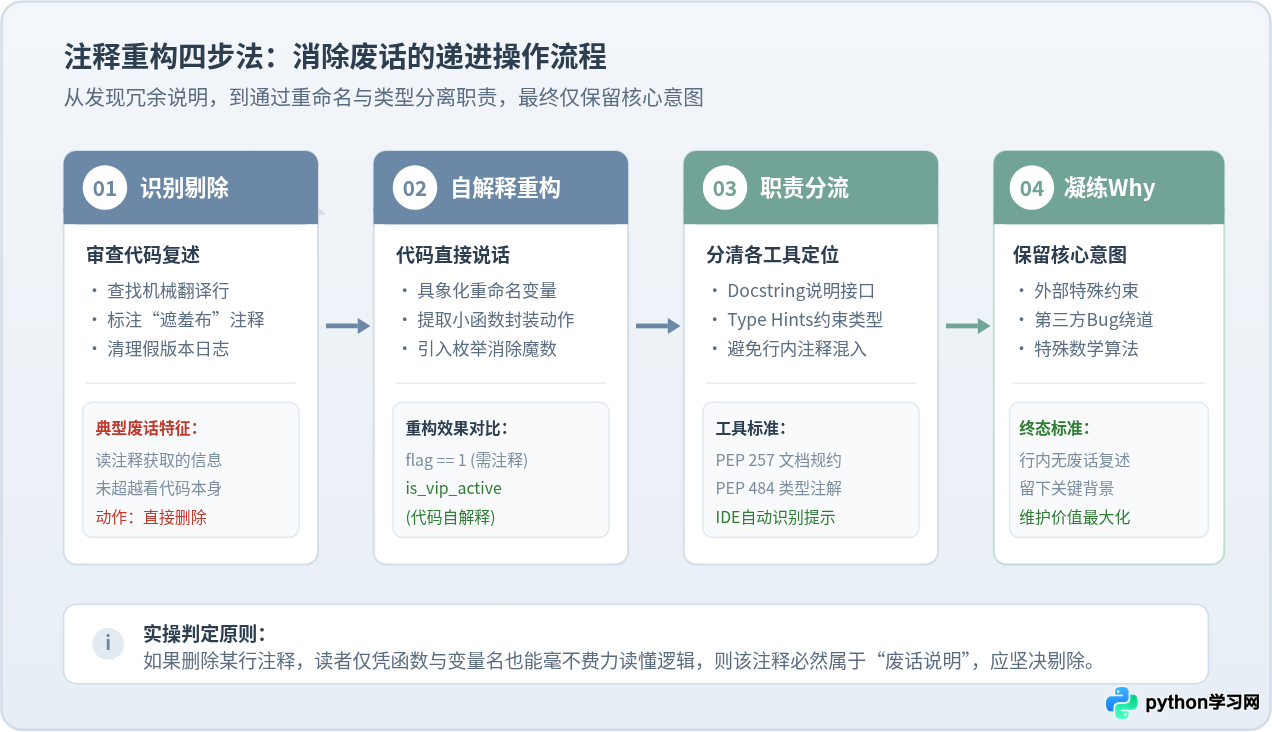
步骤一:审查并坚决删除机械复述
仔细审视代码行的注释:如果遮住该注释,任何具备 Python 基础语法的读者都能从代码本身得出完全相同的信息,那么这行注释就是百分之百的废话。第一反应必须是直接删除,而不是润色文字。
步骤二:通过具象命名与提取函数实现“自解释”
当发现一段逻辑必须依赖注释才能让人看懂“它在做什么”时,应该优先将其重构为自解释代码(Self-documenting Code):
- 将
u.t == 1提取为具名属性或常量user.is_vip_member; - 将复杂的复合布尔表达式提取为独立函数
is_eligible_for_promo(user); - 用明确的业务术语命名变量,消除单字母或模糊缩写。
if is_eligible_for_vip_discount(user):
    apply_discount(user)
步骤三:职责分流到文档字符串与类型注解
许多废话注释本质上是类型说明或参数描述,例如 # timeout: 整数类型,单位毫秒。在现代化 Python 3 实践中,这些信息应当严格分流到语言内置机制中:
- 数据类型约束:直接使用 PEP 484 类型注解
timeout_ms: int,IDE 和 mypy 能够自动校验,永不失真。 - 公开接口契约:使用 PEP 257 规范的 Docstring,完整描述函数目的、输入边界和可能抛出的异常。
步骤四:仅针对特殊意图与边界约束保留高质量 Why 注释
在完成前三步后,留下的代码已经足够自洽清爽。此时仅在代码本身无法直观展现的设计意图、外部第三方缺陷或非直觉决策处,编写精准简练的行内注释。
三、何时真正需要写行内注释:高质量注释的四种核心场景
行内注释在 Python 项目中应该如同“紧急警报器”,少而精湛。一旦出现,就必须能够解答读者的深层疑问。以下四种场景是编写高质量行内注释的标准示范:
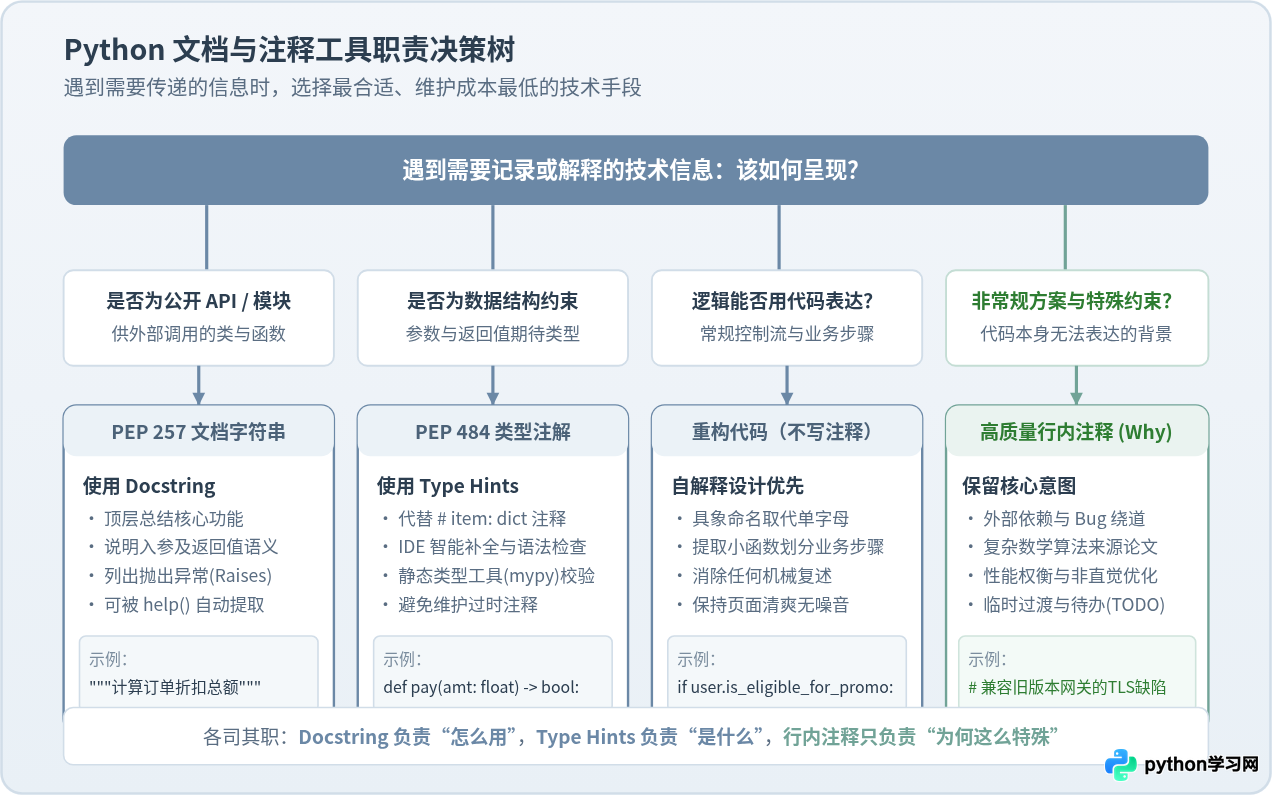
1. 解释业务规则背后的深层缘由
代码能够展现当前的计算公式,但无法展现背后的商业政策或合规约束。如果不写注释,未来的维护者很可能会将看似奇特的规则误以为是 Bug 并“顺手修复”。
# 依据财税 2023 年第 45 号文,跨境小微商户单笔结汇上限临时锁定为 50,000 元
MAX_FOREIGN_EXCHANGE_LIMIT = 50_000
2. 规避第三方依赖或系统的已知缺陷 (Bug / Workaround)
在调用外部 API、操作系统内核特性或特定版本的第三方库时,常常需要采用非标准、非常规的写法来绕过其已知缺陷。如果不写明原因,后续重构者几乎必踩坑:
# 显式休眠 100ms:绕过底层 libuv 在 macOS ARM64 架构下偶发的套接字释放竞态(见 issue #4821)
time.sleep(0.1)
3. 复杂数学算法或非常规性能优化推导
使用高级数学技巧、位运算或特殊算法结构时,代码的可读性可能受限于算法本身的抽象性。此时必须给出算法来源、论文引用或关键推导思路:
# 采用快速平方根倒数算法近似计算光照衰减系数,参考 Quake III 原始推导
number = ctypes.c_float(val)
# ...
4. 临时过渡方案与明确指派的 TODO
临时方案必须写明为何存在、何时移除,以及对应的工单或负责人,避免形成永久技术债务:
# TODO(zhangsan): 待 2.4 版本全量迁移到 gRPC 协议后,废弃此兼容性 JSON 反序列化逻辑 [JIRA-1042]四、实战重构示例:完整案例前后对比
为了直观感受高质量注释带来的代码工程质感提升,我们来看一个实际业务中常见的网络请求与指数退避重试案例:
import time
import requests

# 请求函数
def get_data(u, r=3):
    # 初始化重试计数器
    c = 0
    # 当计数小于最大重试次数时循环
    while c < r:
        try:
            # 发送 GET 请求
            res = requests.get(u, timeout=5)
            # 如果状态码是 200
            if res.status_code == 200:
                # 返回 json 结果
                return res.json()
        except Exception as e:
            # 捕获异常并将计数加 1
            c = c + 1
            # 打印错误
            print(f"Error: {e}")
            # 休眠 2 的幂次方秒
            time.sleep(2 ** c)
    # 如果全部失败返回 None
return Nonefrom typing import Any, Optional
import time
import requests
def fetch_json_with_backoff(
target_url: str,
max_retries: int = 3,
base_timeout_sec: float = 5.0
) -> Optional[dict[str, Any]]:
"""通过指数退避机制拉取远程 JSON 资源。
Args:
target_url: 目标 API 统一资源定位符
max_retries: 最大允许重试次数,默认 3 次
base_timeout_sec: 单次请求超时时间(秒)
Returns:
解析后的字典数据;若所有重试均耗尽仍失败则返回 None。
"""
for attempt in range(1, max_retries + 1):
try:
response = requests.get(target_url, timeout=base_timeout_sec)
if response.status_code == 200:
return response.json()
except requests.RequestException:
if attempt == max_retries:
# 达到最大重试上限,向上层暴露静默失败,由调用方降级兜底
return None
# 引入指数退避避免雪崩:上游支付网关限流器在并发高峰期要求至少等待 2^attempt 秒
backoff_delay = 2 ** attempt
time.sleep(backoff_delay)
return None对比要点分析:重构后的代码删除了所有针对“发送请求”、“判断状态码”、“累加计数器”等语法的机械复述;通过标准类型提示和 PEP 257 Docstring 完整交代了对外输入输出契约;仅有的行内注释精准交代了“为什么最后一次返回 None”以及“为什么指数退避选用 2^attempt 秒(上游支付网关限流器要求)”的核心上下文。
五、最佳实践与编写规范总结
编写高质量 Python 注释并非单纯的文字修饰,而是一项关于“如何传递有效工程信息”的核心素养。在日常开发与 Code Review(代码审查)中,建议团队对照以下四条核心自检清单展开:
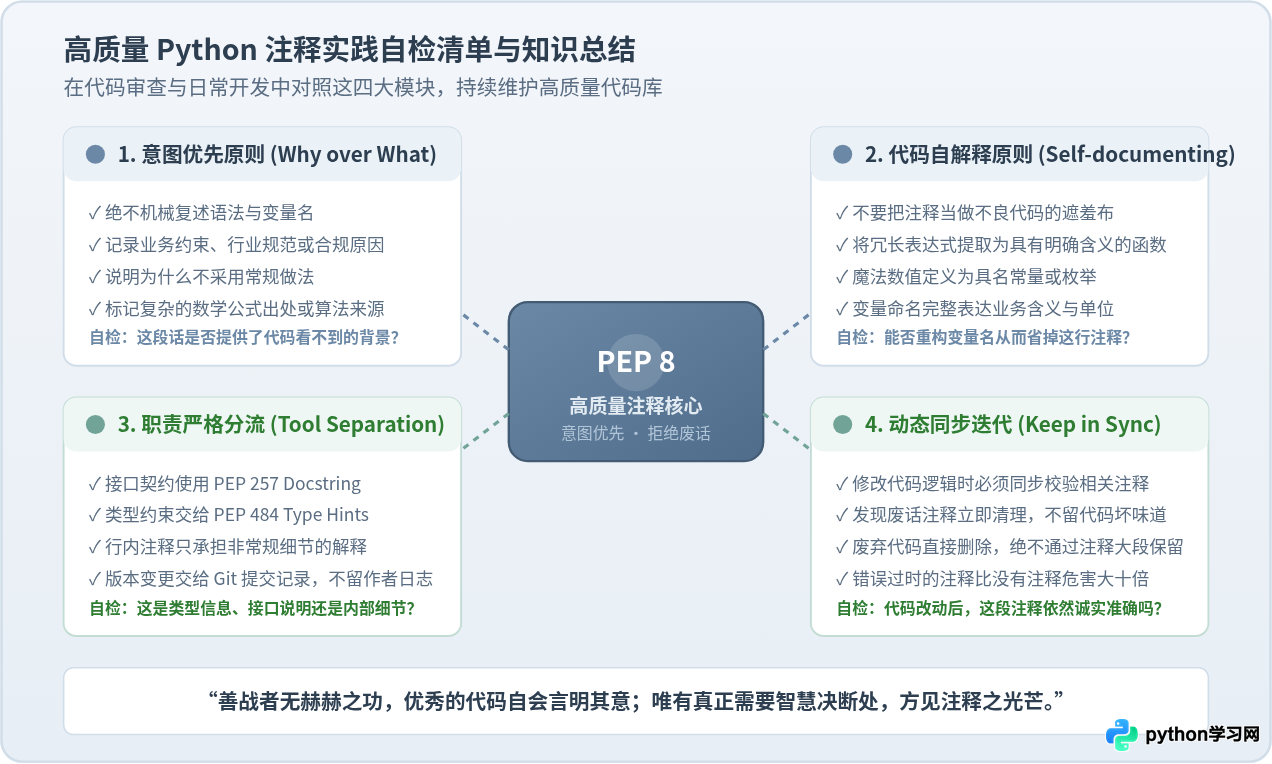
黄金检验准则(The Golden Rule):如果在阅读代码时,你的注释能够让半年后的新成员或者你自己立刻明白“当时为什么选择这条路,而不是直觉上的另一条路”,那么它就是无价的高质量资产;反之,若它只是把 Python 语法翻译了一遍,请立刻敲下删除键。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















