


Python集合交集、并集、差集怎么算?运算符与方法调用对比
深入解析Python集合交集、并集与差集的计算方式,全面对比位运算符(&、|、-)与内置方法(intersection、union、difference)在参数类型、多集合处理与原地修改上的核心差异与选型建议。
&、|、-)或调用集合对象的内置方法(.intersection()、.union()、.difference())。两者的底层集合运算逻辑完全相同,但在参数类型宽容度、多集合传参形式以及就地更新支持上存在重要区别。掌握这些差异,能帮助你在数据去重、筛选与多源数据比对时写出既健壮又清晰的代码。
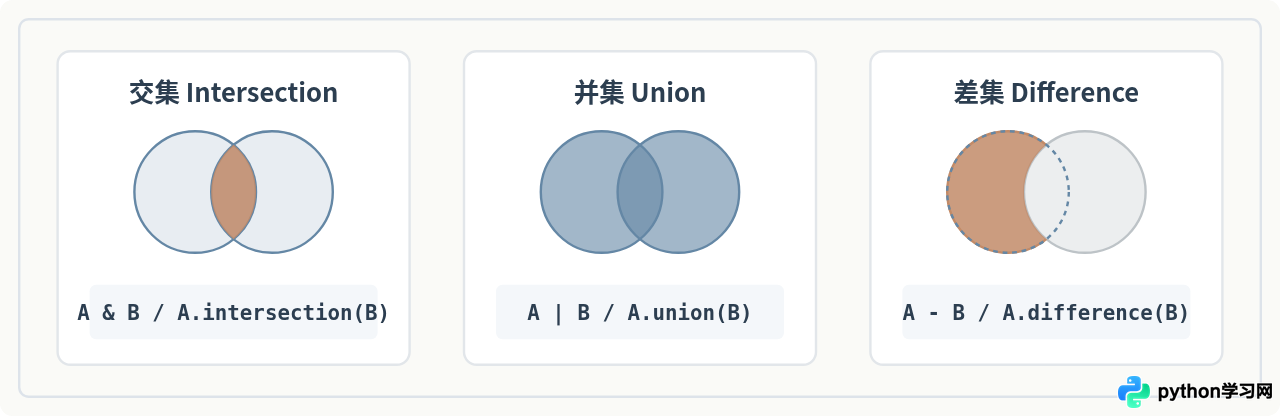
一、交集、并集、差集怎么算?核心语法与示例
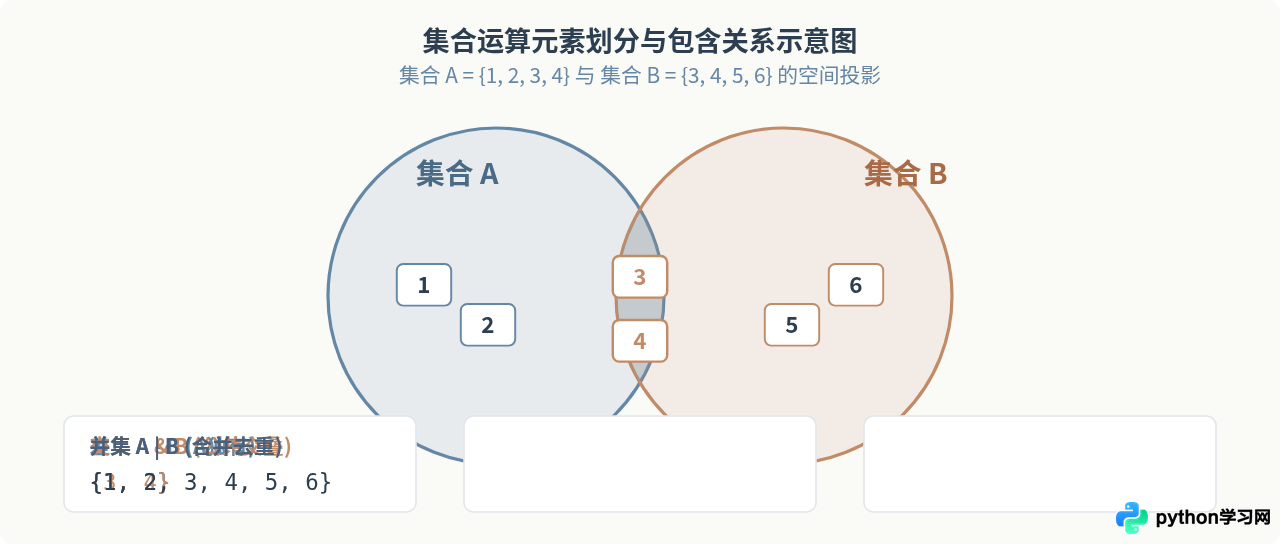
集合(set)是 Python 中用来存放无序且不重复元素的原生数据结构。在日常开发中,我们经常需要对比多组数据的重叠度、合并唯一值或筛选特定差异项。下面通过基础测试数据直观演示三种运算的具体计算方法。
1. 交集(Intersection):获取双方共有的元素
交集运算会提取同时存在于两个(或多个)集合中的公共元素,剔除所有仅属于单个集合的元素。
- 运算符:使用位与符号
& - 方法调用:使用
.intersection()
# 准备两个测试集合
set_a = {1, 2, 3, 4}
set_b = {3, 4, 5, 6}

# 方式 1:使用运算符 &
res_op = set_a & set_b
print("运算符交集:", res_op)
# 示例输出:运算符交集: {3, 4}

# 方式 2:使用方法 intersection()
res_method = set_a.intersection(set_b)
print("方法交集:  ", res_method)
# 示例输出:方法交集:   {3, 4}
2. 并集(Union):合并所有元素并自动去重
并集运算将所有集合中的元素汇总在一起,并依托集合自身特性自动滤掉重复出现的值。
- 运算符:使用竖线符号
| - 方法调用:使用
.union()
# 方式 1:使用运算符 |
union_op = set_a | set_b
print("运算符并集:", union_op)
# 示例输出:运算符并集: {1, 2, 3, 4, 5, 6}

# 方式 2:使用方法 union()
union_method = set_a.union(set_b)
print("方法并集:  ", union_method)
# 示例输出:方法并集:   {1, 2, 3, 4, 5, 6}
3. 差集(Difference):保留属于前者但不属于后者的元素
差集具有严格的方向性。set_a - set_b 表示从集合 A 中剔除同时出现在集合 B 中的元素;反之,set_b - set_a 得到的是属于集合 B 但不属于集合 A 的元素。
- 运算符:使用减号
- - 方法调用:使用
.difference()
# 计算属于 set_a 但不在 set_b 的元素
diff_a = set_a - set_b
print("A 差 B (A - B):", diff_a)
# 示例输出:A 差 B (A - B): {1, 2}

# 计算属于 set_b 但不在 set_a 的元素
diff_b = set_b.difference(set_a)
print("B 差 A (B.difference(A)):", diff_b)
# 示例输出:B 差 A (B.difference(A)): {5, 6}若希望获取“属于 A 或属于 B,但不同时属于两者”的元素(即并集减去交集),可以使用异或符号
^ 或方法 .symmetric_difference()。例如:
set_a ^ set_b 的计算结果为 {1, 2, 5, 6}。
二、运算符与方法调用的核心差异深度对比
许多初学者会疑惑:既然 set_a & set_b 和 set_a.intersection(set_b) 输出结果完全一致,为什么 Python 还要提供两套写法?它们并非简单的语法糖,在底层规则上存在以下三项本质区别。
差异 1:参数类型宽容度(最核心的区别)
这是日常编码中最容易引发错误的关键分水岭:
- 运算符(
&、|、-):要求两侧的操作数必须都为集合类型(set或frozenset)。如果右侧传入了列表、元组或字典,Python 会直接抛出TypeError。 - 方法调用(
.intersection()等):只要调用者是集合,括号内的参数可以是任何可迭代对象(Iterable),例如list、tuple、dict、生成器表达式等。方法内部会自动将其视作集合来处理,省去了显式调用set()转换的步骤。
current_set = {1, 2, 3}
target_list = [2, 3, 4]  # 注意:这是一个普通列表

# ❌ 错误示范:运算符不支持 set 与 list 直接运算
# current_set & target_list
# 报错:TypeError: unsupported operand type(s) for &: 'set' and 'list'

# ✅ 正确示范:方法调用原生支持传入任意 Iterable
res_safe = current_set.intersection(target_list)
print("跨类型交集结果:", res_safe)
# 示例输出:跨类型交集结果: {2, 3}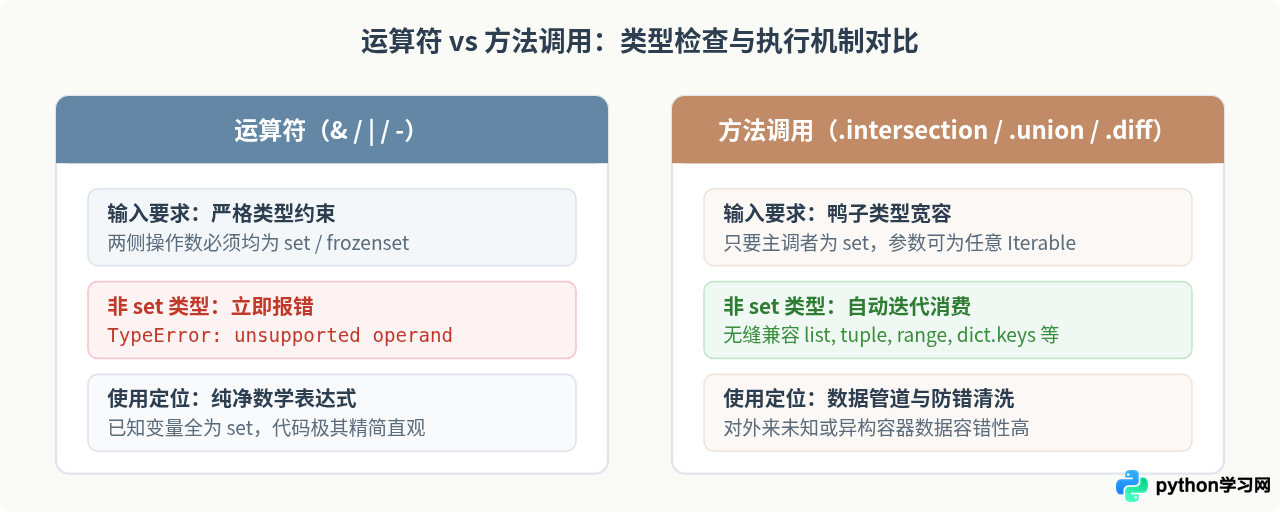
差异 2:多集合运算的书写与传参方式
当涉及三个或更多数据集时:
- 运算符:需要逐个使用符号进行链式连接,如
set_a & set_b & set_c或set_a | set_b | set_c。 - 方法调用:支持在单次调用中传入多个位置参数,例如
set_a.intersection(list_b, tuple_c, dict_d)。在 CPython 底层实现中,多参数方法调用可以通过一次性遍历所有参数直接完成多路比对,效率通常高于连续生成中间集合的链式运算。
base_set = {1, 2, 3, 4, 5}
extra_list = [2, 3, 4]
extra_tuple = (3, 4, 5)

# 方法支持单次传入多个异构可迭代对象
multi_res = base_set.intersection(extra_list, extra_tuple)
print("多参数交集:", multi_res)
# 示例输出:多参数交集: {3, 4}
差异 3:新集合返回 vs 就地修改(In-place Update)
前文介绍的 &、|、- 以及 intersection()、union()、difference() 都属于非破坏性计算,它们不会更改原本的集合,而是构建并返回一个全新的 set 对象。
如果集合体积庞大(例如数十万条数据),频繁生成新对象会带来不必要的内存开销。此时可以使用就地修改(In-place)方式:
- 复合赋值运算符:
&=(交集更新)、|=(并集更新)、-=(差集更新)。注意:复合运算符同样严格要求右操作数必须为set。 - Update 方法:
.intersection_update()、.update()(即并集更新,注意并集没有 union_update)、.difference_update()。这些方法接受任意可迭代对象,直接在原集合上生效,返回值为None。
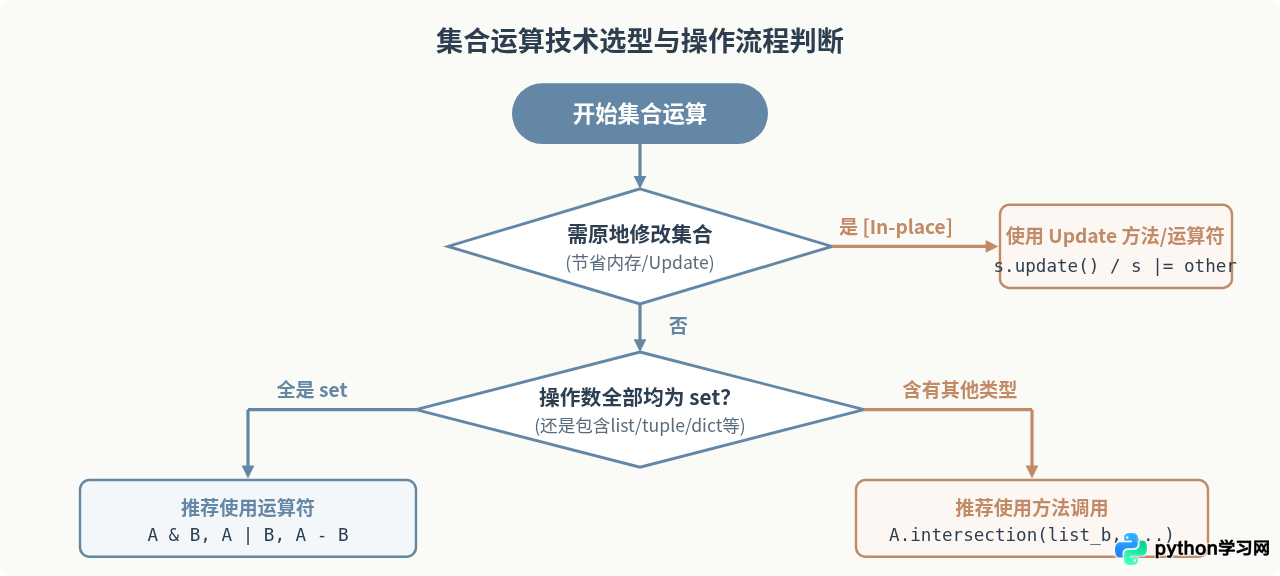
三、决策指南:何时用运算符?何时用方法调用?
了解了两者的异同后,在编写实际工程代码时可以遵循以下原则来做出技术选型:
- 优先选用运算符的场景:
- 所有参与比对的变量在上下文中已被明确构造为
set对象。 - 需要编写具有强烈数学直观表达的代码(如权限矩阵计算、标签重合判定)。
- 追求紧凑的代码风格,例如
user_tags & required_tags。
- 所有参与比对的变量在上下文中已被明确构造为
- 优先选用方法调用的场景:
- 参数来源是函数入参、API 返回值或数据库游标,类型可能为列表、元组或生成器。
- 需要对三组或更多不同数据源一次性进行合并或求交。
- 希望避免显式书写繁琐的
set(param)包装代码。
四、避坑指南:初学者常见的 3 个典型陷阱
1. 空集合的初始化陷阱:set() 而非 {}
在 Python 中,一对空花括号 {} 默认创建的是空字典(dict),而非空集合。若不慎用 {} 初始化变量并使用位运算符,会导致类型错误。
empty_var = {}
print(type(empty_var))
# 示例输出:<class 'dict'>

valid_empty_set = set()
print(type(valid_empty_set))
# 示例输出:<class 'set'>
2. 传入字典时:仅对字典的“键(keys)”生效
当向集合方法传入一个字典时,Python 将字典当作可迭代对象处理,其默认迭代的是字典的键(Keys),字典的值(Values)会被完全忽略。
num_set = {"apple", "banana", "cherry"}
price_dict = {"apple": 5, "pear": 7}

# 实际上比对的是 price_dict.keys()
matched = num_set.intersection(price_dict)
print("与字典交集匹配:", matched)
# 示例输出:与字典交集匹配: {'apple'}
3. 集合元素必须“可哈希(Hashable)”
集合底层依赖哈希表保证唯一性与 $O(1)$ 的查找复杂度。因此,集合的元素必须是不可变对象(如整数、浮点数、字符串、元组)。如果试图将列表或字典放入集合中,或者在运算过程中生成不可哈希内容,会触发 TypeError: unhashable type: 'list'。
五、全景对照速查表与总结
为了便于快速查阅与复习,下表汇总了 Python 中交集、并集、差集及对称差集的所有运算方式:
| 运算类型 | 运算符(严格要求集合) | 内置方法(接受任意可迭代对象) | 就地修改方法(In-place) | 计算含义 |
|---|---|---|---|---|
| 交集 | & | .intersection(*others) | .intersection_update() / &= |
获取所有集合中共有的元素 |
| 并集 | | | .union(*others) | .update() / |= |
合并全部元素并自动剔除重复项 |
| 差集 | - | .difference(*others) | .difference_update() / -= |
属于主集合但不属于后续集合的元素 |
| 对称差集 | ^ | .symmetric_difference(other) | .symmetric_difference_update() / ^= |
只存在于其中一个集合中的元素(排除共有项) |
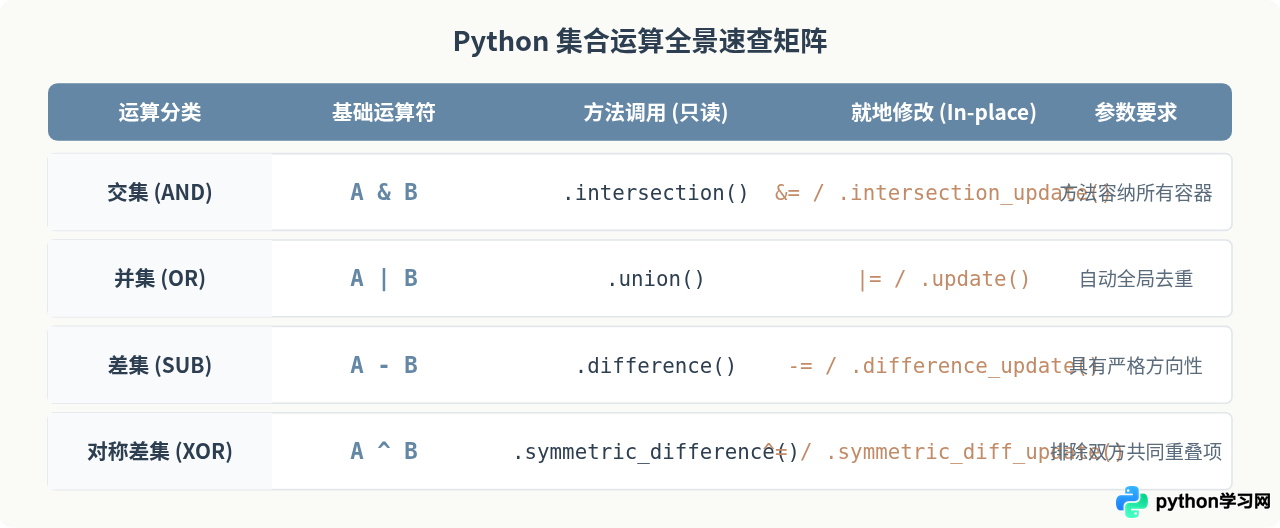
总结来说,当你明确知道运算两端都是 set 对象且追求代码的简洁凝练时,使用 &、|、- 是最直观的选择;而在面对复杂的异构数据源(如掺杂列表、生成器或字典)时,直接调用 intersection()、union() 和 difference() 方法能为程序提供更强的健壮性,省去不必要的数据类型强制转换。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















