


编写合规的Python爬虫:robots.txt协议解读与法律风险规避
深入解读robots.txt协议规范,通过Python标准库实现自动化合规检测,系统解析网络爬虫开发中的技术准则与法律红线规避方法。
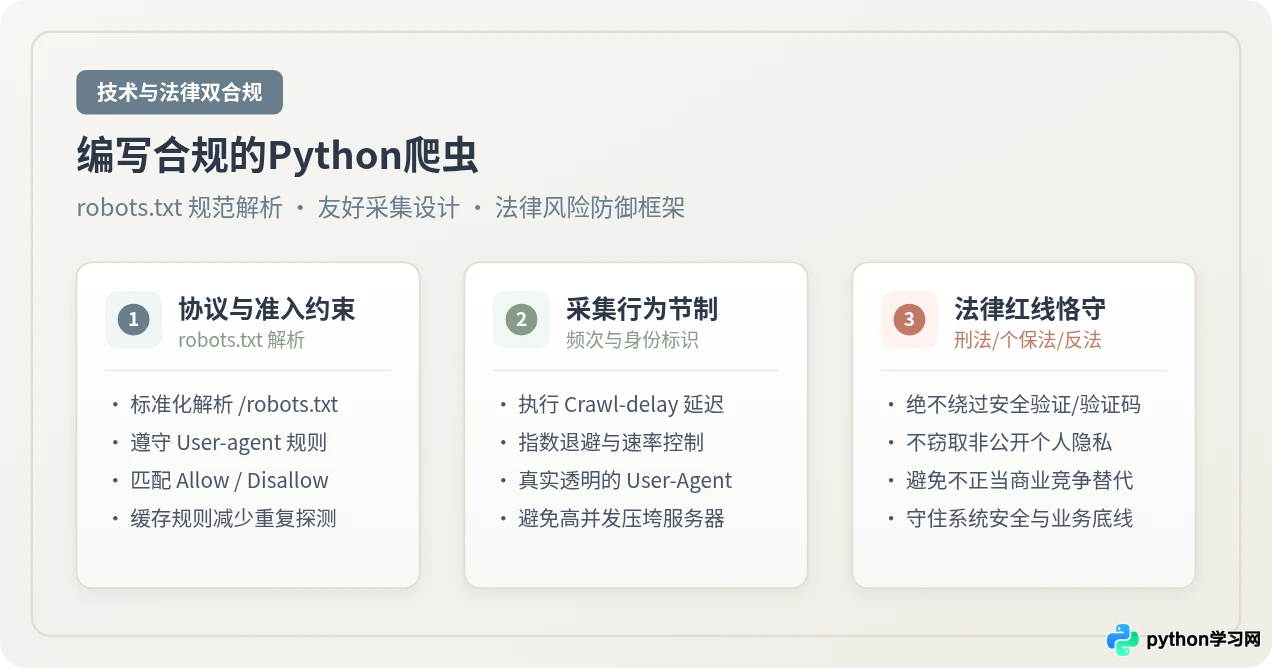
一、深入解读 robots.txt 协议结构与核心匹配规则
网络爬虫排除标准(Robots Exclusion Protocol,已于 2022 年由 IETF 发布为正式标准 RFC 9309)是网站所有者与网络抓取程序之间达成的协商性技术规范。站点将该规范明文存放在网站根目录下的 /robots.txt 文件中。虽然它在技术机制上属于自律性的“君子协议”,但在司法与行政执法实践中,该文件是判定爬虫运营者是否具备主观恶意、是否知晓自身抓取行为违背站点意愿的关键书面证据。
1. 核心指令与语法构成
一个典型的 robots.txt 由若干组记录(Records)构成,每组记录以 User-agent 开头,紧随若干条访问授权指令:
- User-agent:指定该指令块适用的爬虫标识。例如
User-agent: *表示对所有通用网络爬虫生效;指定User-agent: Googlebot则仅约束特定标识的抓取程序。 - Disallow:指明不允许特定爬虫抓取的 URI 前缀或路径模式。若值为
Disallow: /表示全站禁爬;若值为Disallow:(为空)则表示允许抓取全站。 - Allow:在被 Disallow 限制的父路径下,针对特定子路径声明特别开放权限。例如先声明
Disallow: /api/,再声明Allow: /api/public/。 - Crawl-delay:非 RFC 9309 强制字段但被主流搜索引擎和站长广泛支持,声明每次 HTTP 请求之间的建议休眠秒数(例如
Crawl-delay: 5要求每次请求间隔不少于 5 秒)。 - Sitemap:提供站点地图的绝对 URL 地址(如
Sitemap: https://example.com/sitemap.xml),引导合规爬虫优先沿着已整理好的公开结构采集。
2. 前缀匹配、通配符与最长路径匹配原则
许多爬虫开发者容易在匹配逻辑上出现误读。根据 RFC 9309 规范,robots 路径匹配基于字符前缀。例如 Disallow: /tmp 会同时屏蔽 /tmp、/tmp.html 以及 /tmp/data。
当同一路径同时匹配到 Allow 与 Disallow 指令时,决定最终权限的不是指令声明的先后顺序,而是最长匹配原则(Longest Match Rule):匹配字符数更长、更具体的那条规则胜出。如果两条规则长度完全一致,则优先采用 Allow(允许抓取)。
二、基于 urllib.robotparser 的自动化合规检测流程
在 Python 中,不需要依赖第三方库即可完成对 robots.txt 的标准解析。Python 标准库自带的 urllib.robotparser.RobotFileParser 已经封装了完整的 RFC 协议规则匹配、重定向跟踪和权限比对逻辑。
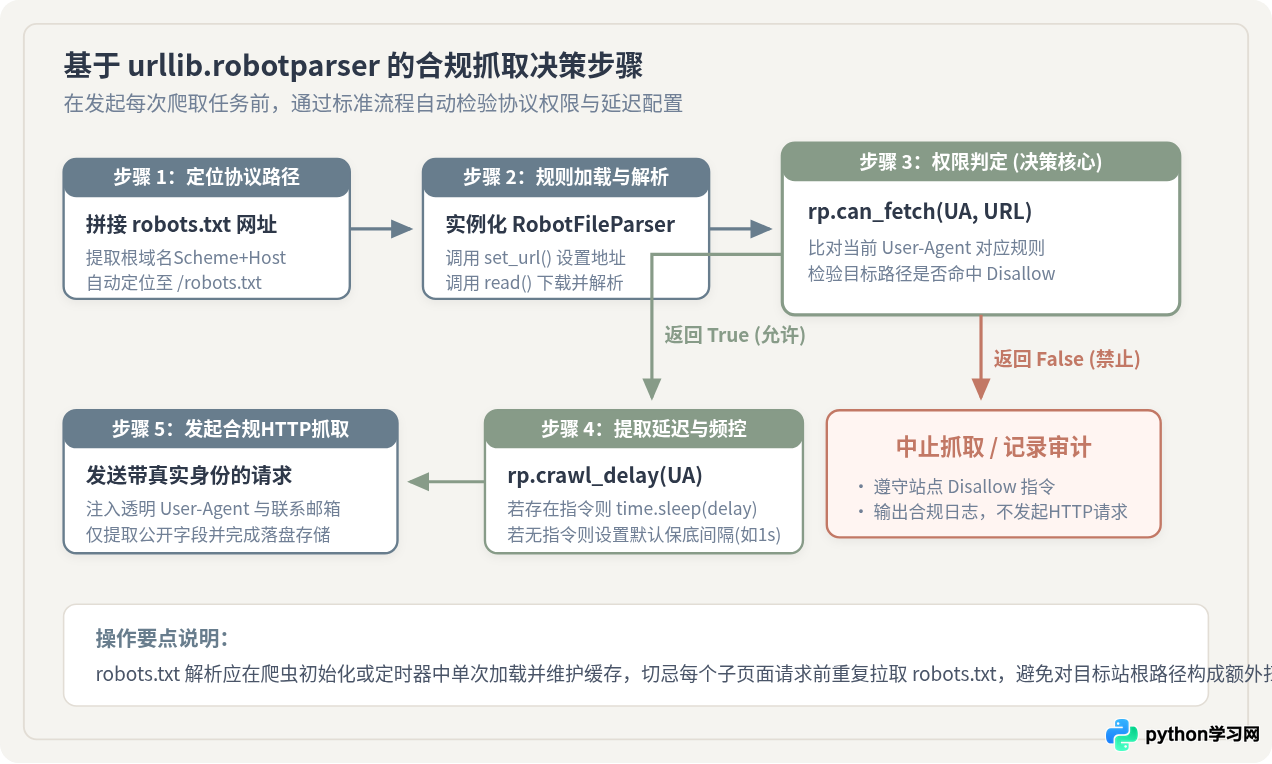
如上图所示,一个合格的自动化抓取流程必须在发起内容采集前经过严格的 5 个执行步骤:定位协议文件、下载并解析规则、执行权限断言判定、读取延迟并应用等待、发起携带真实身份的合规请求。
可直接复用的合规检测代码实现
在实际工程中,不能在每次请求子页面时都重复拉取 robots.txt,否则会在瞬间对目标站点的根目录造成高频冲击。正确的做法是按域名缓存解析结果,并设置合理的生存期(TTL)。
三、行为对照:盲目抓取 vs. 规范合规抓取的关键差异与影响
为了直观理解合规设计的必要性,我们设定一个完全一致的业务场景:某研究团队需要持续采集一个行业公开产品目录中的价格与规格信息。面对相同的目标,两种不同的工程做法在各个维度上展现出截然相反的系统表现与法律风险。
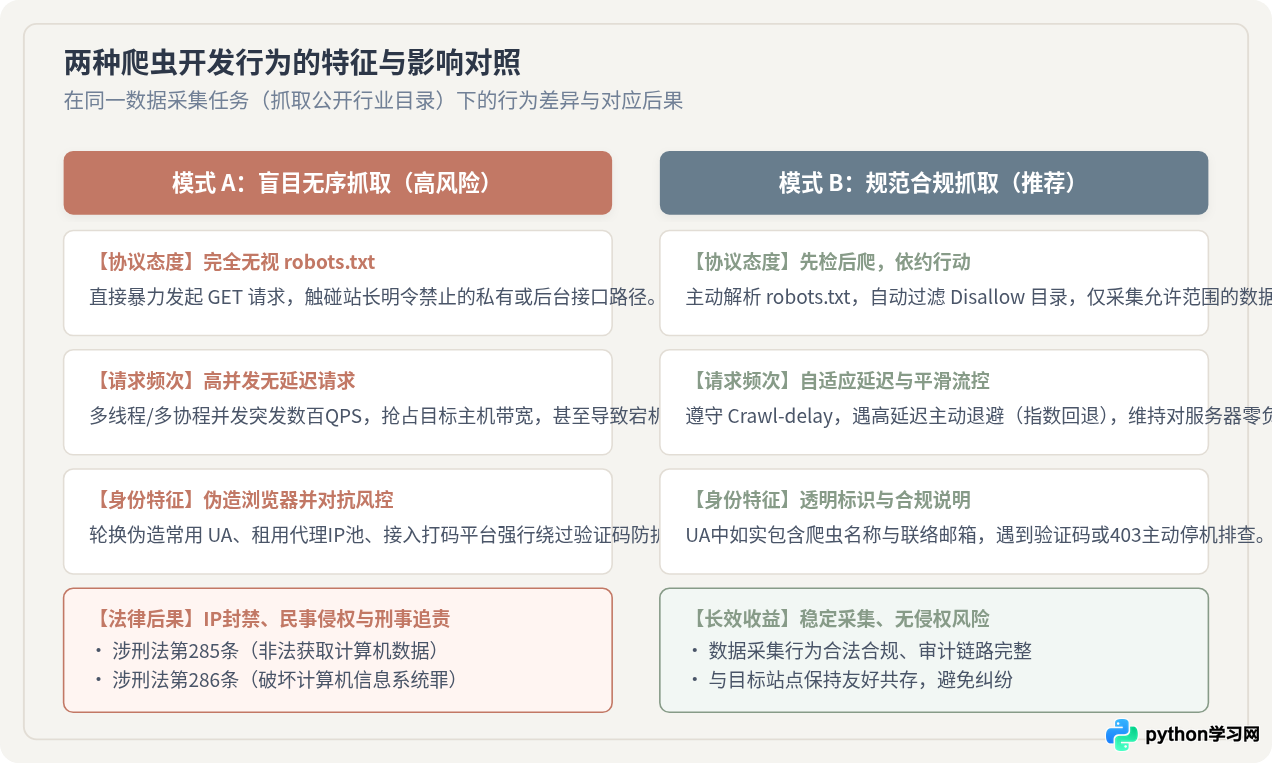
我们把这两种做法在相同执行条件下的关键差异梳理如下:
| 对比维度 | 模式 A:盲目无序抓取(高风险) | 模式 B:规范合规抓取(推荐) | 为什么该差异至关重要 |
|---|---|---|---|
| 协议识别 | 从不检测 robots.txt,直接对子页面发起批量扫描,误扫管理后台与非公开接口。 | 在内存中持久化解析 robots.txt,白名单放行,遇 Disallow 主动剔除任务。 | 司法判定中,知晓并故意违反明文排除规则是认定侵权主观过错的核心依据。 |
| 并发与流控 | 开启数十个并发线程全速发包,每秒数十至数百次请求,无休眠间隔。 | 执行 Crawl-delay(如 1~3 秒),增加微抖动(Jitter),监控响应状态自适应降速。 | 高并发直接消耗目标带宽与计算资源,可能构成破坏计算机信息系统罪。 |
| 身份标识 | 伪造成常见桌面 Chrome/Edge 浏览器的 User-Agent,甚至不断轮换假 UA。 | 明确标识爬虫项目名称、官方说明页面或合规联系邮箱。 | 透明的 User-Agent 允许站长在受到影响时通过技术手段定向联络或限制,不引发全面法律纠纷。 |
| 遭遇风控 | 遇到 403 限制或验证码弹窗,接入第三方打码平台、租用高匿代理池强行突破。 | 遇到权限拒绝或验证码即刻停机,由人工复核是否触碰了网站安全边界。 | 绕过验证码与鉴权防护属于《刑法》第 285 条认定的“侵入”行为,瞬间将民事争议升级为刑事案件。 |
四、爬虫开发者必须规避的三大法律红线
合规编写爬虫不仅是一项代码层面的工程要求,更是开发者必须掌握的法律常识。在我国司法实践中,因爬虫引发的法律纠纷主要集中在刑法、反不正当竞争法和个人信息保护法三个维度。
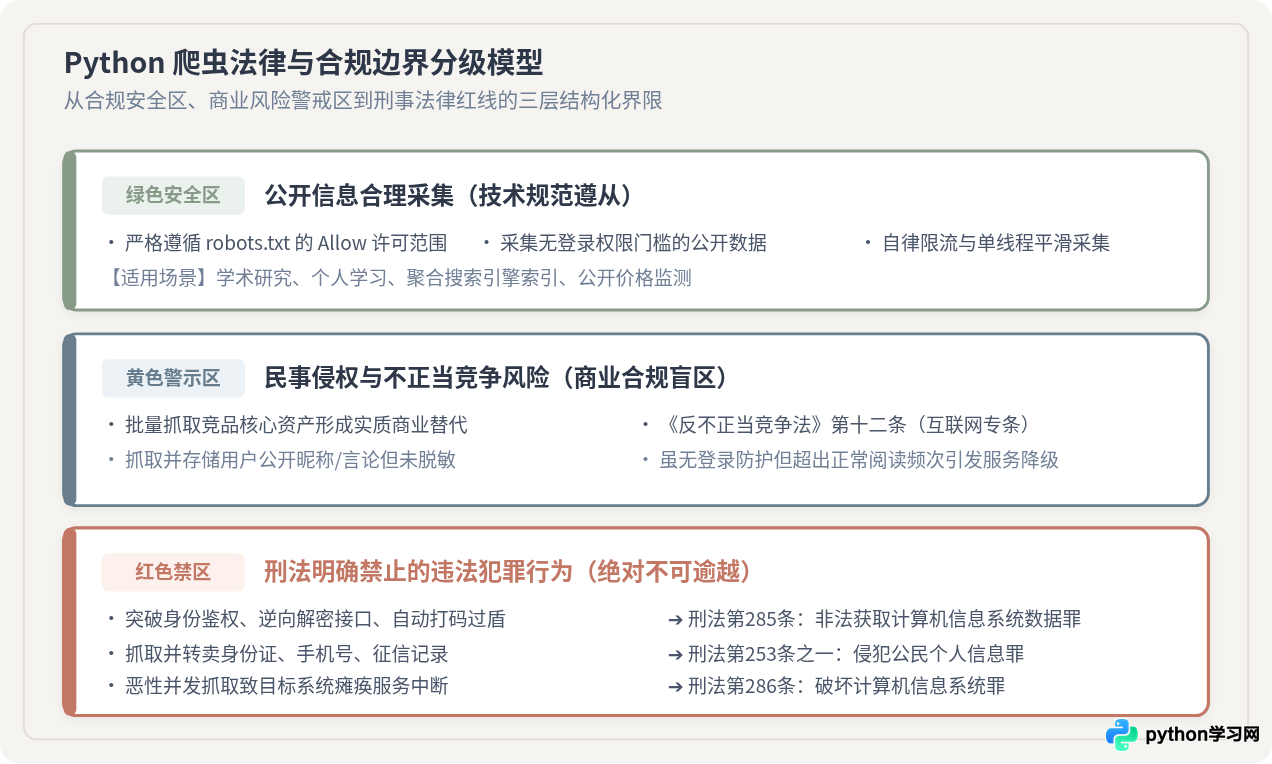
红线一:严禁绕过、破解目标系统的安全防护措施(刑事红线)
这是所有技术人员最容易误入的刑事雷区。《中华人民共和国刑法》第二百八十五条明确规定了非法侵入计算机信息系统罪和非法获取计算机信息系统数据罪。
在法律界定中,只要目标网站部署了技术保护措施(如账号密码鉴权、Token 防刷校验、图形验证码、行为滑动验证、设备指纹等),开发者如果通过逆向解密签名参数、伪造登录凭证、调用打码平台自动过盾等手段强行提取数据,在法律定性上即属于“突破或避开技术保护措施”,一旦达到立案标准(如获取身份认证信息 500 组以上,或违法所得 5000 元以上),即可直接构成刑事犯罪。
红线二:严禁采集并商用竞品核心数据构成“实质性替代”(民事与不正当竞争红线)
即便是完全公开、没有设置登录防护的数据(如电商商品评价、生活服务商家列表、房产挂牌房源),也不意味着可以任意复制商用。
根据《中华人民共和国反不正当竞争法》第十二条(互联网专条)和第二条原则性条款,如果爬虫运营方抓取竞争对手具有商业价值的核心数据库,并直接用于搭建与原告高度重合的同质化产品或服务,导致原告用户流失、实质性损害原告通过长期合法经营积累的竞争优势,法院将认定该行为违反诚实信用原则与商业道德,判令巨额民事赔偿。
红线三:严禁抓取非公开个人信息与未经授权的个人隐私(合规与刑事重罪)
《中华人民共和国个人信息保护法》与《刑法》第二百五十三条之一(侵犯公民个人信息罪)对个人数据设立了极高保护门槛。抓取求职者简历、征信报告、家庭住址、手机号码、精确地理轨迹等能够单独或结合识别特定自然人身份的信息,必须取得当事人明确授权。通过爬虫技术大批量沉淀未经脱敏的公民个人信息并转卖或用于商业画像,直接触犯刑事责任。
五、工程落地的合规实践清单与全生命周期检查
为了将合规要求固化到团队的日常开发流程中,建议建立从需求评审到数据入库的闭环管理机制。
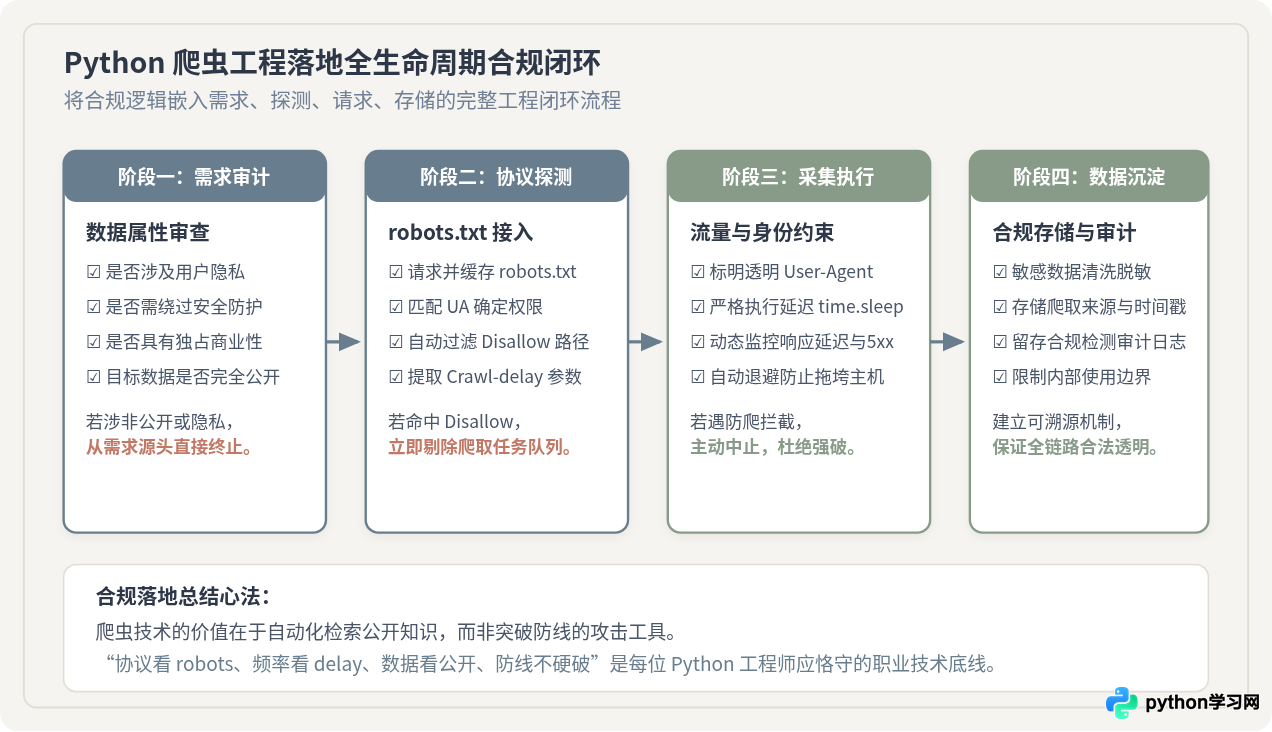
1. 请求头规范化设置
避免使用诸如 Mozilla/5.0 (Windows NT 10.0; Win64; x64) 这种完全匿名的伪装,而应当使用结构化、透明的 User-Agent 字符串。标准格式推荐为:
2. 指数退避与速率控制算法
当遇到 HTTP 429(Too Many Requests)或 503(Service Unavailable)时,程序应主动触发指数退避机制,而不是立即发起重试:
3. 数据入库清洗与审计日志留痕
所有爬虫抓取入库的数据,必须通过字段清洗管道过滤掉可能夹带的手机号、电子邮箱等 PII(个人身份信息)。同时,爬虫程序应当保留完整的调度日志,记录每个 URL 抓取时的 robots.txt 检测结果、响应时间戳与响应状态码,确保在面临潜在质询时具备完整的技术合规举证能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















