


Python读取Excel时日期和数字格式错乱怎么办
针对Python使用pandas或openpyxl读取Excel文件时出现的日期变五位纯数字、长数字转为科学计数法、前导零丢失及浮点数精度漂移等格式错乱问题,系统梳理底层成因,并提供从读取源头类型锁定到后续解析修复的完整解决方案。
dtype={'字段名': str} 或 converters 锁定关键列为纯字符,杜绝不可逆的浮点精度损失;针对已成为浮点序列号的日期列,则通过 pd.to_datetime(series, unit='D', origin='1899-12-30') 准确重置时间起点,从而完整恢复业务数据。
一、Excel 底层存储与 Python 解析机制定位
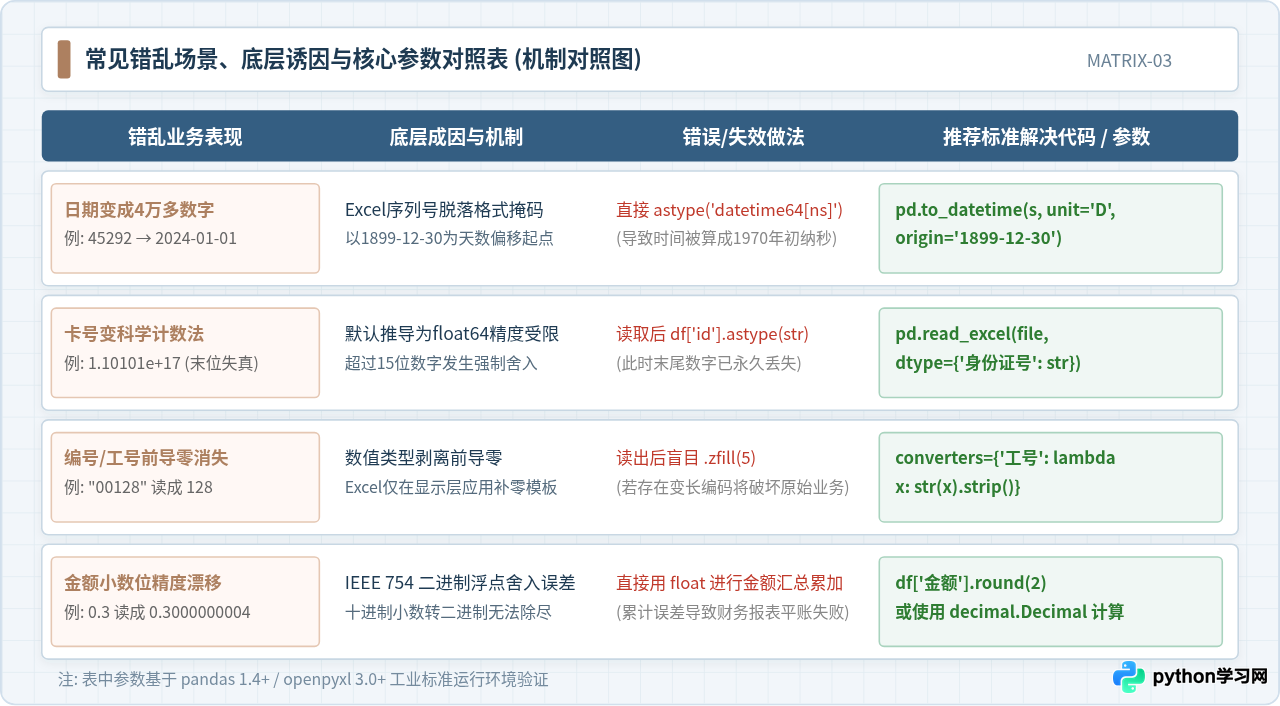
排查格式错乱必须先看 Excel 内部的实际数据模型。在 Excel 的 .xlsx 压缩包底层 XML 中,单元格的“显示外观”与“物理存储值”完全分离。Excel 将公历日期作为基准日期的天数偏移量保存为浮点数,显示格式仅作为视图掩码挂载在样式表上。例如 2024-01-01 在底层只是数值 45292.0。
当 Python 中的 pandas.read_excel() 或 openpyxl 引擎载入表格时,如果未提前显式声明字段类型,解析引擎将依据列样本执行自动类型推导。一旦解析器未能匹配特定的视图样式掩码,就会退回为通用数值,直接将序列号按 float64 读入内存。同时,面对纯数字构成的大长串(如订单号、身份证号),引擎默认将其视为连续数值,只要数值超过 15 位,就会触发 IEEE 754 双精度浮点数的尾数截断,造成不可逆的毁损。
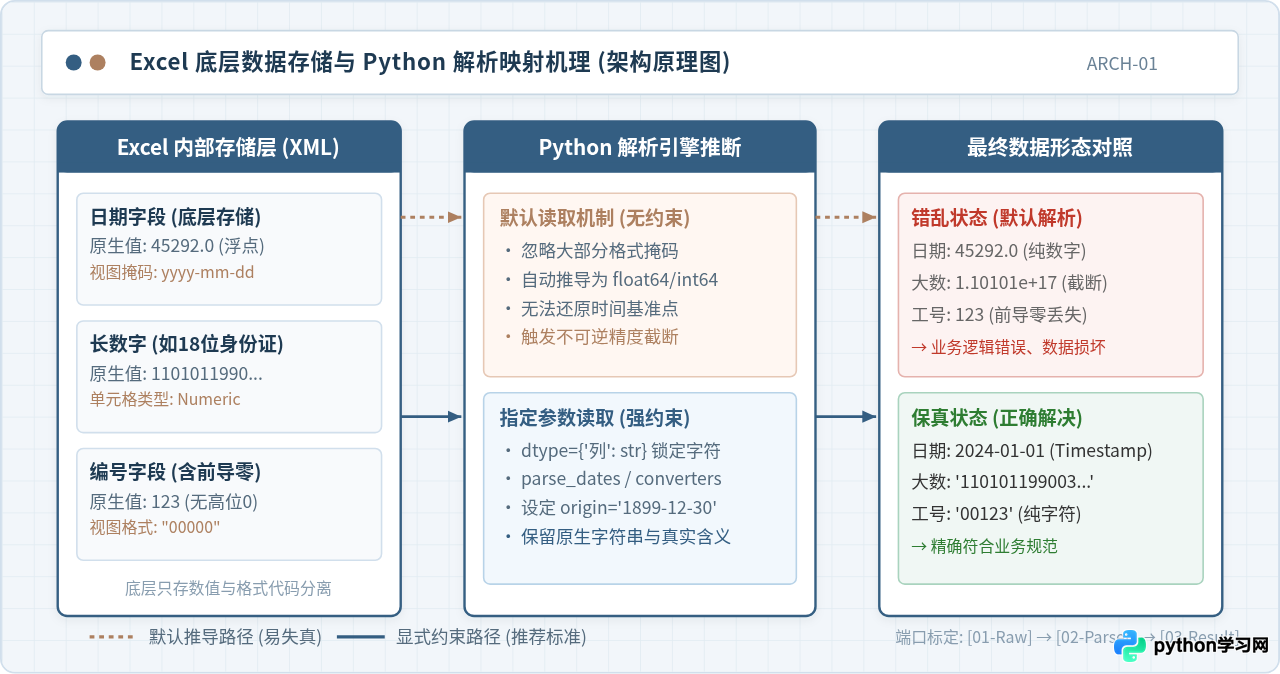
因此,常见错乱通常表现为四种典型状态:
- 日期显示为 40000+ 浮点数:日期单元格底层的连续序列号暴露,未应用公历转换。
- 长数字变科学计数法与末尾失真:如
110101199003072345被推断为浮点数,显示为1.101012e+17,且末尾数字被舍入为 0。 - 编码前导零丢失:如工号
00123被数字解释为123。 - 金额小数精度漂移:单元格数值
0.3在内存中呈现为0.30000000000000004。
二、格式错乱的标准排查与修复流程
规范的排查不应在读取完成后盲目尝试修复,因为一旦浮点转换完成,丢弃的高位 0 和截断的有效数字就已经永远丢失。必须按照“现场诊断 → 源头拦截 → 基准校正 → 闭环固化”的严密流程执行操作。
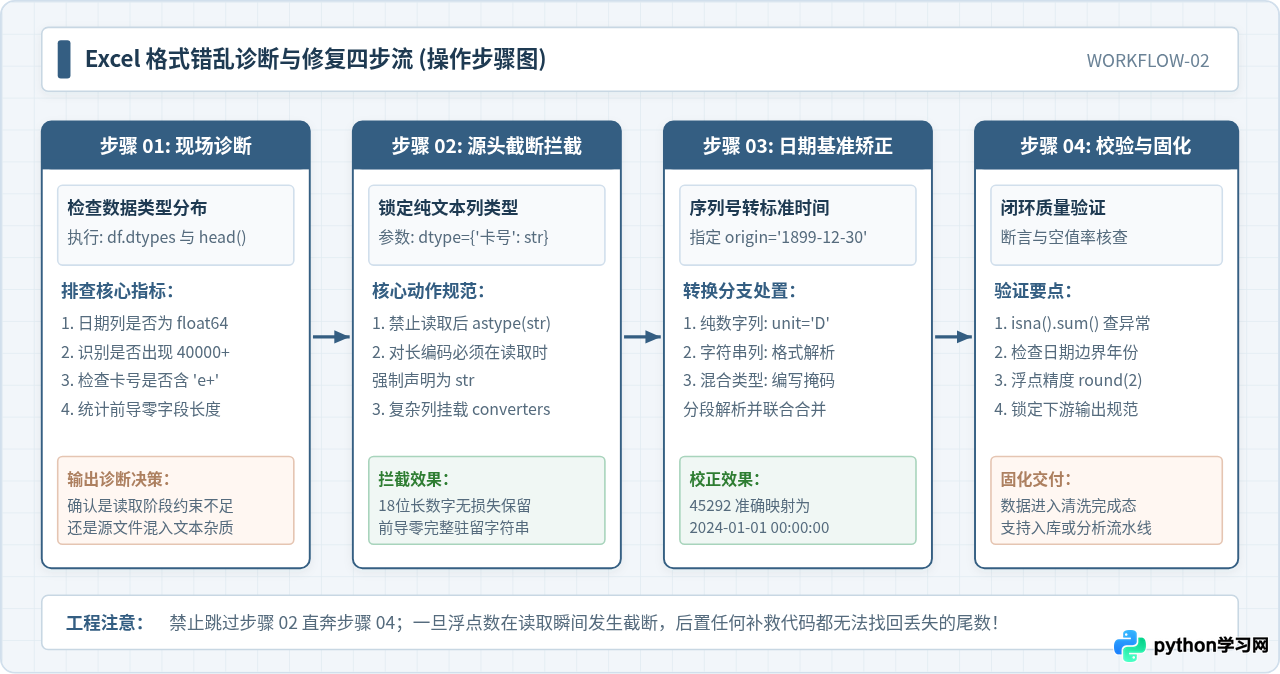
第 1 步:执行现场数据类型诊断
拿到 Excel 文件后,先使用纯探查命令观察前几行数据及推断类型,重点核查各列是否符合业务属性:
import pandas as pd

# 仅读取前 5 行用于结构探测
df_probe = pd.read_excel('sales_data.xlsx', nrows=5)
print("--- 字段自动推导类型 ---")
print(df_probe.dtypes)
print("
--- 样本数据表现 ---")
print(df_probe.head())
在此步骤中,若发现本应是字符串的“身份证号”、“银行卡号”类型为 int64 或 float64,或“创建时间”呈现为数值,必须立即阻断后续业务逻辑,转入源头拦截配置。
三、长数字、卡号与前导零的保真方案
针对超长数字与带有前导零的编码,必须在 read_excel 执行的瞬间进行类型强制约束。
df['卡号'] = df['卡号'].astype(str)。在默认读取完成的毫秒级瞬间,超过 15 位的长数字已经被转换成了带有舍入误差的双精度浮点数,后续转换出来的字符串只会是 '1.234568e+17'。必须在读取时就锁死 str。
1. 使用 dtype 参数显式锁定文本类型
在 pd.read_excel() 中传入 dtype 字典,指定目标列名直接映射为 Python 字符串。
import pandas as pd

# 锁定关键列以纯文本格式载入,阻断任何数值解析
data_types = {
    '身份证号': str,
    '银行卡号': str,
    '员工工号': str,
    '客户邮编': str
}

df = pd.read_excel('sales_data.xlsx', dtype=data_types)

# 验证有效长度与内容无损
print("身份证号示例:", df['身份证号'].iloc[0])
print("工号前导零保留:", df['员工工号'].iloc[0])
2. 使用 converters 预清洗异常混杂格式
若 Excel 源文件由多方人工填写,同一列中可能部分被加上了英文单引号作为文本,部分被存成了浮点数(如 00123.0)。此时可以使用 converters 参数挂载预处理清洗函数,在单元格数据进入 DataFrame 前完成净化:
def sanitize_code(val):
    if pd.isna(val):
        return ""
    val_str = str(val).strip()
    # 消除误保存为浮点数带来的 .0 尾缀
    if val_str.endswith('.0'):
        val_str = val_str[:-2]
    return val_str

converters_map = {
    '员工工号': sanitize_code,
    '订单编码': sanitize_code
}

df_clean = pd.read_excel('sales_data.xlsx', converters=converters_map)
四、日期格式错乱的专项修复
日期错乱有两种常见形式:一种是 Excel 底层序列号直接裸露(呈现为如 45292 这样的五位数值);另一种是同一列内日期格式极度不统一,混合了 2024-01-01、2024/01/01、序列号以及文本异常值。
1. 五位序列号日期转换为标准时间
如果日期已经以浮点或整数形式加载,不能使用常规的字符串解析,而要使用天数偏移换算。很多开发者使用 origin='1900-01-01' 发现计算出来的日期总偏差 2 天,其根因在于早期 Lotus 1-2-3 软件误将 1900 年视作闰年,Excel 为了向下兼容完整保留了这个历史 Bug,加上基准日起始偏移,必须使用 1899-12-30 作为基准原点:
# 纯序列号转换为标准 pandas Timestamp
# 45292 将被精确计算为 2024-01-01
df['标准创建时间'] = pd.to_datetime(
    df['原始日期列'],
    unit='D',
    origin='1899-12-30'
)
2. 混合日期列(字符、序列号、异常值)安全分流方案
在实际生产环境中,某一列常常同时存在标准日期文本与序列号整数。若直接传入统一方法,必然报错或产生 NaT。采用掩码分流是业界标准做法:
def normalize_mixed_dates(series):
    # 识别能够转为数值的项(即序列号)
    numeric_series = pd.to_numeric(series, errors='coerce')
    is_numeric = numeric_series.notna()

    # 初始化结果序列
    result = pd.Series(index=series.index, dtype='datetime64[ns]')

    # 路径 A: 处理 Excel 序列号
    if is_numeric.any():
        result[is_numeric] = pd.to_datetime(
            numeric_series[is_numeric],
            unit='D',
            origin='1899-12-30'
        )

    # 路径 B: 处理常规时间字符串 (如 '2024/05/12', '2024-05-12')
    if (~is_numeric).any():
        result[~is_numeric] = pd.to_datetime(
            series[~is_numeric],
            errors='coerce'
        )

    return result

# 执行综合时间归一化
df['日期归一'] = normalize_mixed_dates(df['登记日期'])
五、数值精度与特殊格式清洗(金额、千分位、百分比)
数值错乱除了整型长数字截断外,还集中体现在包含符号的业务数据无法参与数学运算:
- 千分位逗号被读作文本:数值中带有逗号(如
"1,250,800.50")会导致 pandas 自动将其作为object类型加载。直接在read_excel中指定参数thousands=','即可让引擎自动识别并转为标准浮点数。 - 货币符号与百分比清洗:对于含有
"¥"、"$"或"%"的列,在读取后使用矢量化字符方法去除:# 清理百分比字符串并转化为比率浮点数 df['毛利率'] = df['毛利率'].astype(str).str.rstrip('%').astype(float) / 100.0 # 清洗带有货币符号的字符串 df['实收金额'] = df['实收金额'].astype(str).str.replace(r'[¥$,]', '', regex=True).astype(float) - 金额精确保留:对于财务核算系统,禁止使用原生 float 累加。应在清洗后使用 Python 内置的
decimal.Decimal保持绝对精度,避免0.1 + 0.2 != 0.3导致的报表不平。
六、深入底层的 openpyxl 单元格精准探查
当遇到极为复杂的宏文件、多层合并单元格或损坏的样式表时,pandas 无法获知单元格背后的实际属性。此时可借助底层引擎 openpyxl 直接检查每个单元格的原生类型代码:
import openpyxl

wb = openpyxl.load_workbook('sales_data.xlsx', data_only=True)
sheet = wb.active

for row in sheet.iter_rows(min_row=2, max_row=4):
    date_cell = row[0]
    id_cell = row[1]

    # 输出 openpyxl 识别的底层特征
    print(f"坐标: {date_cell.coordinate}")
    print(f"数据类型 (d=Date, n=Number, s=String): {date_cell.data_type}")
    print(f"是否为日期对象: {date_cell.is_date}")
    print(f"单元格内置格式代码: {date_cell.number_format}")
    print(f"Python原生取值: {date_cell.value}")
通过 is_date 和 number_format,可以清晰查出是 Excel 本身未配置时间样式,还是 Python 读取端配置失当,为编写精确的数据转换规则提供充分依据。
七、总结与闭环决策框架
消除 Python 读取 Excel 时的格式错乱,关键在于放弃“读取后再修补”的试错思路,建立一套覆盖“前置读取防御、中间逻辑校正、后置质量验证”的闭环数据防护体系。
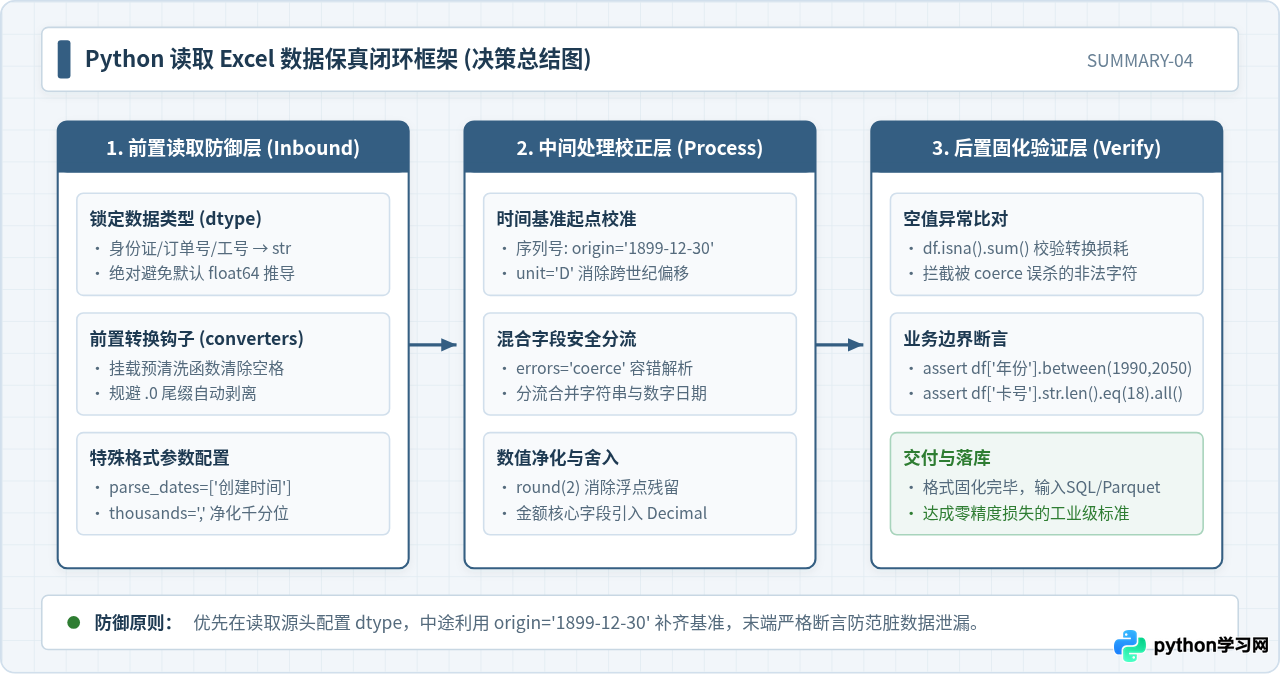
在实际项目落地时,建议将上述实践固化为可复用的模板:
- 长编码、身份证、流水号列,首选
read_excel(..., dtype={col: str})刚性锁定; - 遇到 4 万多整数的日期列,统一使用
origin='1899-12-30'进行天数基准校正; - 在进入核心计算前,使用
df[col].isna().sum()和格式断言确认没有由于强转失败造成的静默数据丢失,确保数据管道的高可靠运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















