


Python基础语法配套微案例:每个知识点都有可运行代码演示
精选Python基础语法核心知识点,包括变量类型、流程控制、常用容器、函数封装与文件异常处理,每个知识点均配有完整可运行的独立微案例与示例输出,即测即懂。
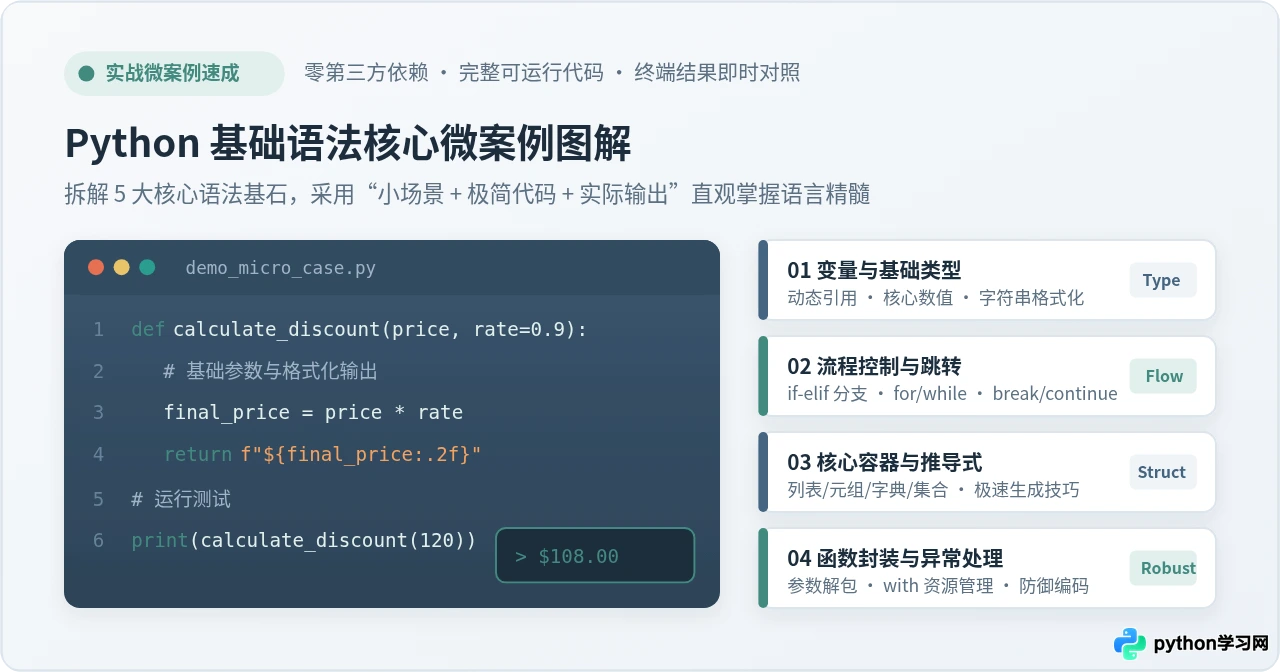 图 1:Python 基础语法核心微案例速览与实战结构全览
一、变量绑定与核心基础数据类型
在 Python 中,变量并不像 C/Java 那样是带有固定类型标记的内存格子,而是“贴在内存对象上的标签”。声明变量时无需指定类型,解释器会根据右侧表达式自动在堆内存中创建对象,并将变量名与该对象建立引用绑定。
Python 最常用的四种基础原子类型包括整数(int,支持任意精度)、浮点数(float,遵循双精度浮点标准)、布尔值(bool,True 与 False 本质为 int 的子类)以及字符串(str,不可变 Unicode 字符序列)。
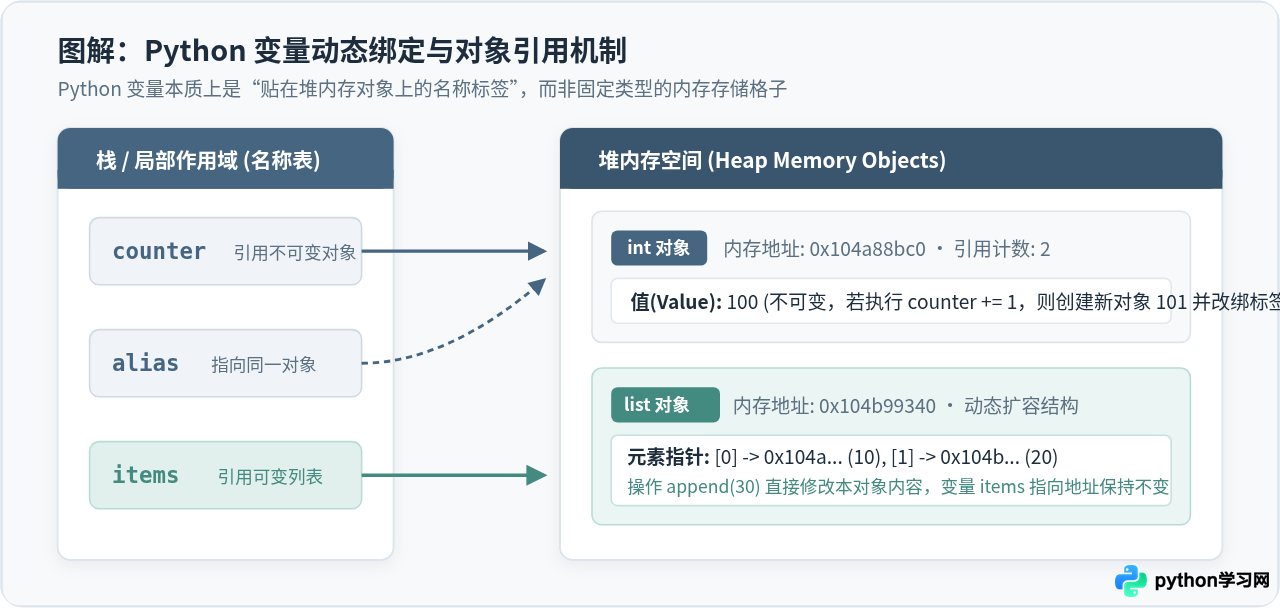 图 2:Python 变量动态绑定机制与堆内存对象模型对比
微案例 1:订单计费计算与 f-string 字符串格式化
本案例演示数值四则运算、类型自动推导、布尔逻辑判定以及现代 Python 中最推荐的格式化输出语法 f-string。
# 1. 基础数据类型赋值
item_name = "机械键盘"      # str 字符串
unit_price = 299.50         # float 浮点数
quantity = 3                # int 整数
is_vip_member = True        # bool 布尔值

# 2. 运算与类型转换
subtotal = unit_price * quantity
discount_rate = 0.85 if is_vip_member else 1.0
final_amount = subtotal * discount_rate

# 3. 查看变量类型与格式化输出
print(f"商品名称类型: {type(item_name).__name__}")
print(f"单价类型: {type(unit_price).__name__},数量类型: {type(quantity).__name__}")
print("-" * 40)
print(f"商品: {item_name} x {quantity}")
print(f"原价总计: ¥{subtotal:.2f}")
print(f"VIP 会员专属折扣: {int(discount_rate * 100)} 折")
print(f"最终应付金额: ¥{final_amount:.2f}")
单价类型: float,数量类型: int
----------------------------------------
商品: 机械键盘 x 3
原价总计: ¥898.50
VIP 会员专属折扣: 85 折
最终应付金额: ¥763.72
decimal.Decimal 替代原生 float;但对于常规工程计算,原生 float 足以满足需求。
二、流程控制:条件判断与循环分支
Python 使用代码缩进(建议 4 个空格)来标定代码块范围,替代了传统的花括号 {}。逻辑控制主要由 if-elif-else 分支结构和 for / while 循环结构组成。
在循环内部,continue 用于立刻终止本轮迭代并跳到下一次循环开头;break 则用于强制彻底跳出整个循环体。此外,Python 的循环还支持可选的 else 块:当且仅当循环正常遍历完毕、未被 break 中断时才会触发执行。
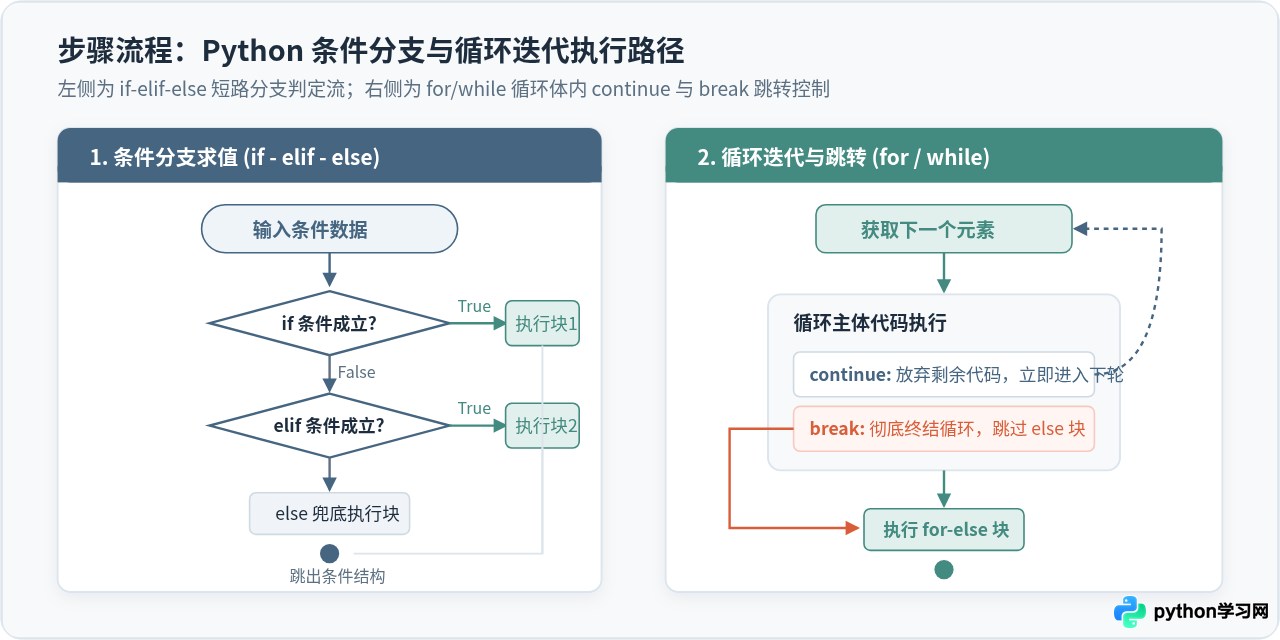 图 3:条件分支梯级判定与循环跳转(continue / break / else)执行流程
微案例 2:模拟带重试上限与黑名单过滤的验证流程
本案例综合使用 for 循环配合 range()、条件分支判断、continue 过滤跳过,以及 break 搭配循环 else 判定是否超限。
# 模拟用户连续输入的密码尝试列表
password_attempts = ["", "123456", "admin888", "correct_pwd_2026"]
correct_password = "correct_pwd_2026"
max_attempts = 3

print("--- 开始安全登录鉴权流程 ---")

for attempt_no, pwd in enumerate(password_attempts, start=1):
    # 场景 1: 输入为空字符串,判定为无效输入,跳过计次
    if not pwd.strip():
        print(f"[提示] 第 {attempt_no} 次输入为空,自动忽略此无效操作。")
        continue

    # 场景 2: 密码正确,认证通过并立即退出循环
    if pwd == correct_password:
        print(f"[成功] 密码正确!在第 {attempt_no} 次尝试时登录成功。")
        break
    else:
        print(f"[拒绝] 密码错误: '{pwd}',剩余尝试机会: {max_attempts - attempt_no}")

    # 场景 3: 达到最大错误次数限制
    if attempt_no >= max_attempts:
        print("[警告] 连续错误已达上限,账户已锁定 15 分钟!")
        break
else:
    # 仅当循环未遇到 break 正常跑完时执行
    print("[信息] 所有尝试已耗尽。")
[提示] 第 1 次输入为空,自动忽略此无效操作。
[拒绝] 密码错误: '123456',剩余尝试机会: 1
[拒绝] 密码错误: 'admin888',剩余尝试机会: 0
[警告] 连续错误已达上限,账户已锁定 15 分钟!
""、空容器 []、数字 0 和 None 评估为逻辑假(Falsy)。因此写 if not pwd.strip(): 比 if len(pwd.strip()) == 0: 更加符合 Python 习惯用法(Pythonic)。
三、核心数据容器:列表、元组、字典与集合
Python 内置了四种核心复合数据结构,它们在有序性、元素可变性以及检索效率上具有鲜明的互补性:
- 列表 (list):方括号
[]定义,有序、元素可变、允许重复,适合存储同质队列。 - 元组 (tuple):圆括号
()定义,有序、元素不可变、轻量只读,适合函数返回多值或作为字典键。 - 字典 (dict):花括号
{k: v}定义,键值对映射,基于哈希表实现,具备平均 O(1) 的高速检索效率。 - 集合 (set):花括号
{}定义,元素无序且绝对唯一,自带高效的集合交集、并集和差集运算。
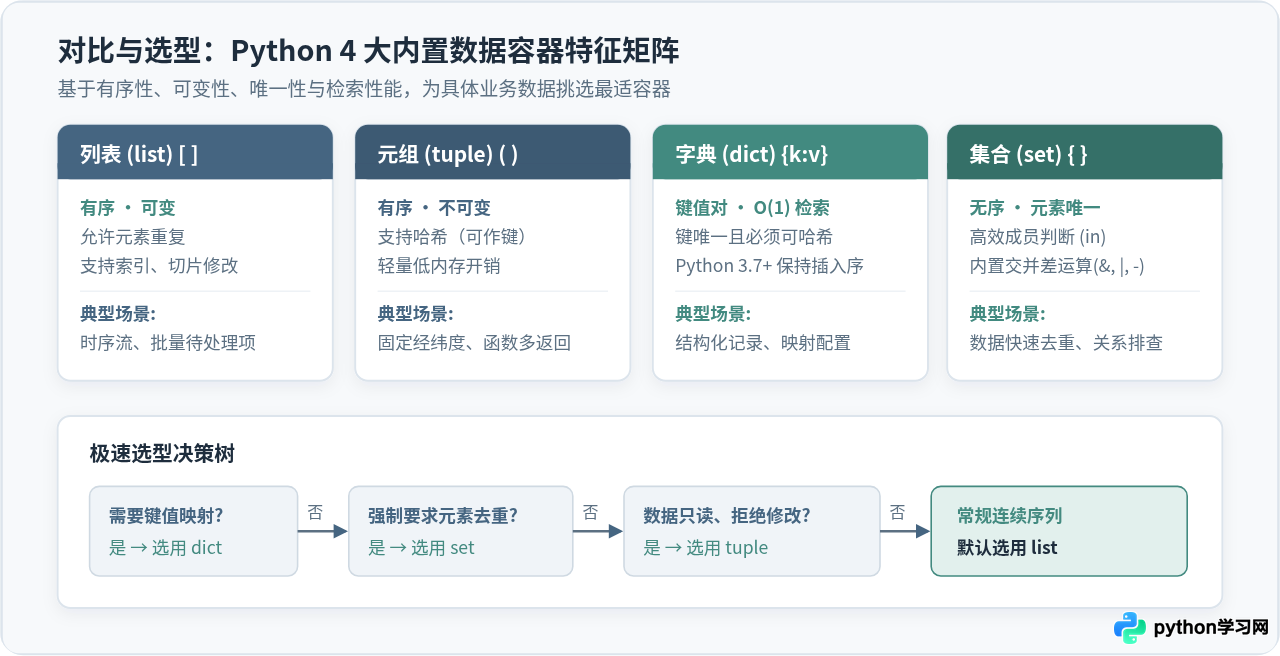 图 4:Python 四大内置数据容器核心特性矩阵与选型决策树
微案例 3:电商多品类商品聚合、去重与推导式转换
本案例展示如何组合使用列表、字典与集合完成原始日志去重、分类分组,并利用简洁优雅的“推导式”(Comprehension)完成数据投影。
# 原始上报订单数据:包含重复记录与脏数据
raw_orders = [
    ("A101", "数码", 399),
    ("A102", "图书", 58),
    ("A101", "数码", 399),  # 重复项
    ("A103", "数码", 129),
    ("A104", "食品", 35),
    ("A105", "图书", 88),
]

# 1. 利用集合对元组数据极速去重
unique_orders = list(set(raw_orders))
print(f"原始单量: {len(raw_orders)},去重后单量: {len(unique_orders)}")

# 2. 列表推导式:过滤出金额大于 100 的数码类订单编号
high_digital_orders = [
    order_id for order_id, category, amount in unique_orders
    if category == "数码" and amount > 100
]
print(f"百元以上数码单号: {sorted(high_digital_orders)}")

# 3. 字典聚合:统计每个分类下的订单总额
category_totals = {}
for _, cat, amount in unique_orders:
    # dict.get(key, default) 优雅处理键不存在的情况
    category_totals[cat] = category_totals.get(cat, 0) + amount

# 4. 字典推导式:筛选销售额超过 100 元的品类,并加上单位
report = {k: f"¥{v}" for k, v in category_totals.items() if v > 100}
print("高销品类汇总表:", report)
百元以上数码单号: ['A101', 'A103']
高销品类汇总表: {'图书': '¥146', '数码': '¥528'}
set 中的元素必须是“可哈希”(Hashable)的不可变对象。元组 tuple 可以放进 set,但如果元组内部包含了可变的列表(如 (1, [2, 3])),则该元组也无法被哈希,强行加入 set 会抛出 TypeError: unhashable type: 'list'。
四、函数封装与参数传递规则
函数是组织逻辑、复用代码的基石,通过 def 关键字声明。Python 的函数参数传递采用“对象引用传递”(Pass by Object Reference):
- 位置参数与默认参数:形参可设定默认值,但在函数声明中,带默认值的参数必须排在所有无默认值参数的后面。
- 可变位置参数
*args:将多余传入的位置实参打包为一个tuple。 - 可变关键字参数
**kwargs:将多余传入的键值对实参打包为一个dict。
微案例 4:指标聚合统计与通用报表日志格式化函数
本案例构建一个可接收任意数量数据点、支持自定义前缀与扩展元数据的多功能通用统计函数。
def summarize_metrics(title, *values, round_digits=2, **metadata):
    # 通用指标汇总函数
    if not values:
        return {"title": title, "count": 0, "status": "EMPTY"}

    total = sum(values)
    avg = total / len(values)
    max_val = max(values)
    min_val = min(values)

    result = {
        "title": title,
        "count": len(values),
        "total": round(total, round_digits),
        "average": round(avg, round_digits),
        "range": (min_val, max_val),
        "extra": metadata
    }
    return result

# 1. 基础调用:传入变长数值
res1 = summarize_metrics("服务响应延时(ms)", 45.2, 38.6, 52.1, 41.0)
print("基础指标:", res1)

# 2. 高级调用:指定小数位,并通过 kwargs 补充环境信息
res2 = summarize_metrics(
    "CPU利用率(%)",
    12.456, 18.231, 25.889,
    round_digits=1,
    env="production",
    cluster="node-bj-01"
)
print("生产指标:", res2)
生产指标: {'title': 'CPU利用率(%)', 'count': 3, 'total': 56.6, 'average': 18.9, 'range': (12.456, 25.889), 'extra': {'env': 'production', 'cluster': 'node-bj-01'}}
def append_item(x, target_list=[])。因为默认参数在 Python 加载模块时仅求值一次,后续所有省略该参数的调用都会操作同一个列表对象,造成隐蔽的数据串扰。正确做法是使用 target_list=None,在函数体内部通过 if target_list is None: target_list = [] 进行初始化。
五、文件安全读写与防御性异常处理
编写工业级 Python 代码时,程序不可避免会面对外部输入缺失、网络中断或磁盘不可达等异常场景。Python 提供了完备的 try-except-else-finally 异常拦截体系与 with 上下文管理器。
with open(...):基于上下文管理协议,确保无论中间是否发生异常,文件句柄都能在跳出代码块时被即时、安全地关闭,彻底避免文件描述符泄漏。try ... except SpecificError:针对具体可能抛出的错误精准捕获,绝不盲目捕获所有异常。else块:当try块内完全没有抛出任何异常时才会执行。finally块:无论是否抛出异常、是否被捕获,都保证百分之百会执行,适合用于资源释放与状态清理。
微案例 5:配置文件的安全解析与容错读写机制
本案例演示如何在无第三方模块依赖的前提下,安全地创建临时配置文本、读取解析键值对,并在面对缺失字段或格式损坏时输出明确的错误提示。
import os

config_filename = "app_runtime.conf"

# 1. 使用 with open 写入初始配置文件
sample_content = (
    "# 应用核心配置\n"
    "server_port=8080\n"
    "max_workers=4\n"
    "enable_debug=true\n"
    "# 脏配置行示例\n"
    "broken_line_without_equal\n"
    "timeout=30.5\n"
)

try:
    with open(config_filename, mode="w", encoding="utf-8") as f:
        f.write(sample_content)
    print(f"[写入] 成功生成配置文件: {config_filename}")
except IOError as err:
    print(f"[错误] 写入磁盘失败: {err}")

# 2. 读取并解析配置,添加精准异常防护
parsed_config = {}

try:
    with open(config_filename, mode="r", encoding="utf-8") as f:
        for line_no, raw_line in enumerate(f, start=1):
            line = raw_line.strip()
            # 忽略空行和注释
            if not line or line.startswith("#"):
                continue

            # 安全按等号拆分
            if "=" in line:
                key, val = line.split("=", 1)
                parsed_config[key.strip()] = val.strip()
            else:
                print(f"[解析告警] 第 {line_no} 行格式非法,跳过: '{line}'")
except FileNotFoundError:
    print(f"[致命错误] 配置文件 {config_filename} 丢失!")
else:
    print("[成功] 配置文件解析完毕,配置项数量:", len(parsed_config))
    print("[数据详情]:", parsed_config)
finally:
    # 模拟环境收尾:清理本次生成的临时文件
    if os.path.exists(config_filename):
        os.remove(config_filename)
        print(f"[清理] 临时配置文件 {config_filename} 已安全移除。")
[解析告警] 第 6 行格式非法,跳过: 'broken_line_without_equal'
[成功] 配置文件解析完毕,配置项数量: 4
[数据详情]: {'server_port': '8080', 'max_workers': '4', 'enable_debug': 'true', 'timeout': '30.5'}
[清理] 临时配置文件 app_runtime.conf 已安全移除。
open() 打开文本文件时,始终显式声明 encoding="utf-8"。不同操作系统(例如 Windows 默认采用 GBK,而 Linux/macOS 默认 UTF-8)的缺省编码不同,显式指定可以彻底规避跨平台运行时的 UnicodeDecodeError。
六、知识速查全景与语法避坑清单
为了便于快速回顾,下方的知识全景速查图整合了本文阐述的五大核心基础模块、推荐代码书写规范,以及初学者在实际编码中最容易踩中的典型雷区。
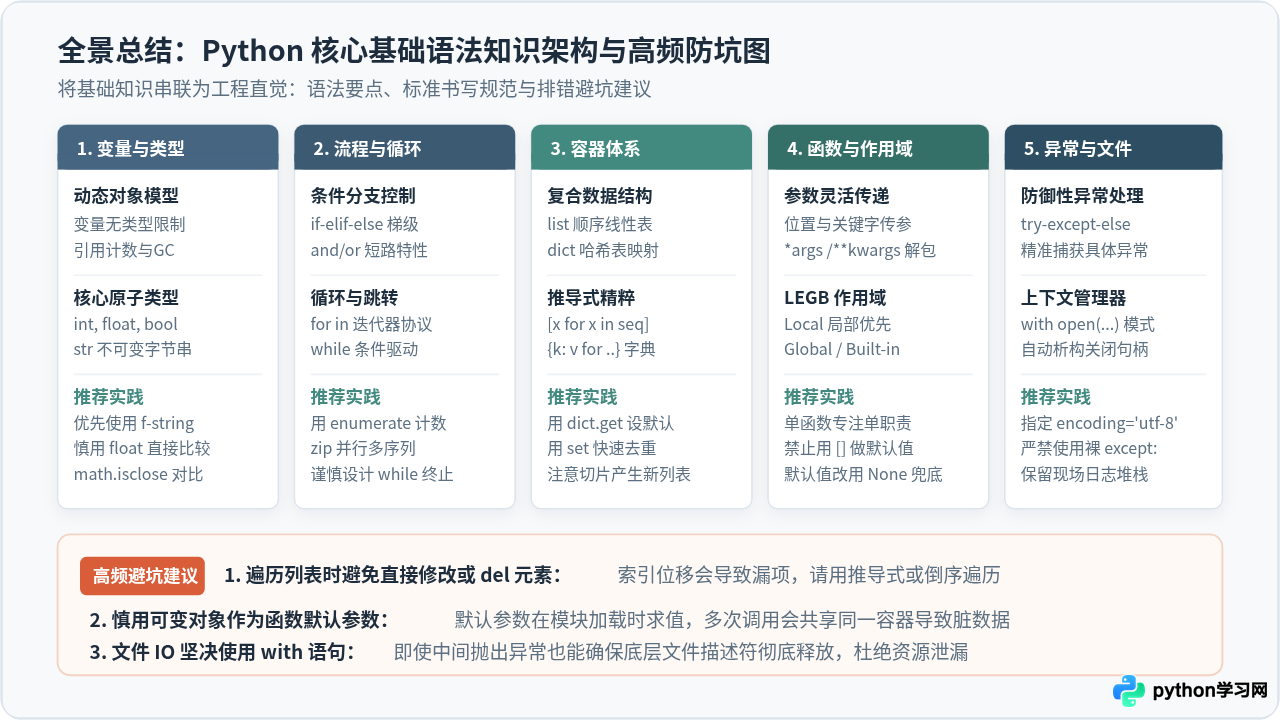 图 5:Python 核心基础语法知识架构与高频避坑全景速查
在实际编写 Python 脚本时,建议遵循以下三条核心验证原则:
- 随时使用内置工具自省:遇到不确定的对象,善用
type(obj)验证其实际类型,使用dir(obj)检查其挂载的方法与属性,或者调用id(obj)核查其内存唯一地址。 - 保持代码意图直观清晰:优先使用
f-string进行文本插值,利用dict.get()与in运算符做防御性判断,避免写出层级过深的多重嵌套循环。 - 把单元功能收拢在函数中:每个函数尽量只完成一件具体事情,对外入参保持明确类型约定,善用
try-except明确可能失败的边界,确保脚本具有良好的健壮性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















