


超越基础语法:适合进阶开发者的Python深度学习网站推荐
针对已经掌握Python基本语法、期望深入理解模型底层原理与工业级工程落地的进阶开发者,系统推荐并深度解析6个核心深度学习技术网站,涵盖底层算子、分布式并行、框架源码与实验调优。
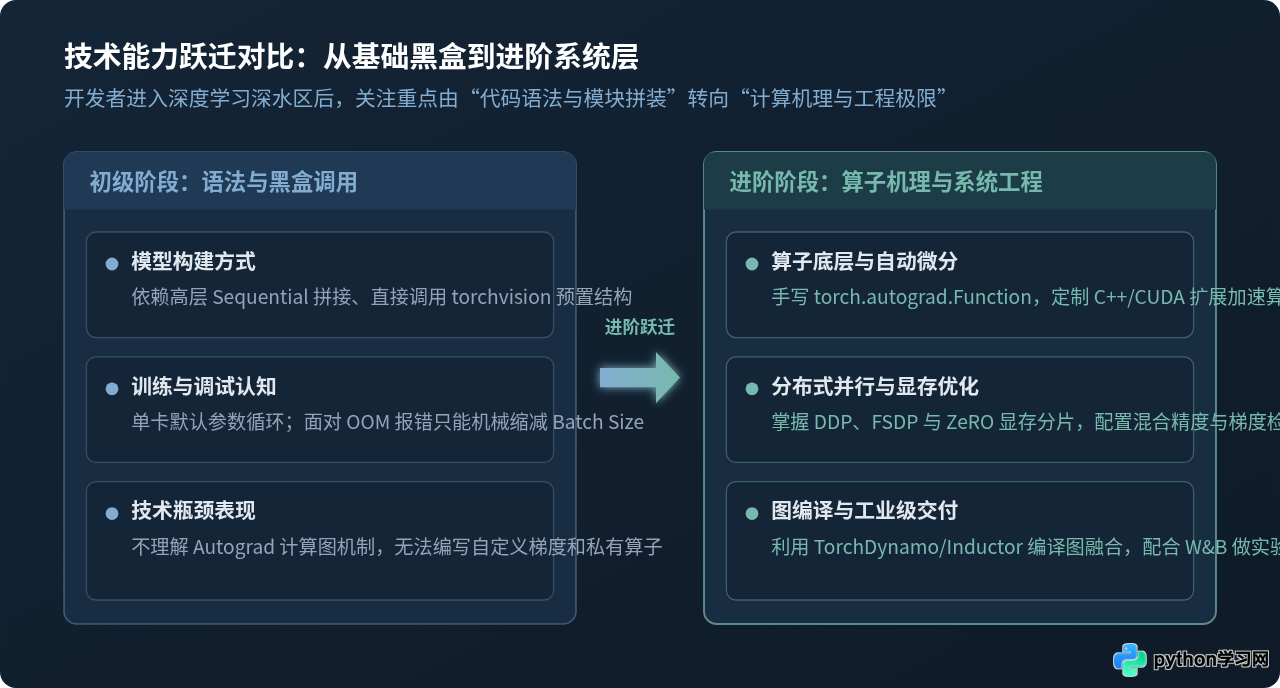
一、进阶开发者的技术能力跃迁路径
掌握 Python 基础语法与常规深度学习 API 只能解决“模型能够跑起来”的问题,而工业级深度学习研发的核心挑战在于“模型如何高效稳定地规模化训练与落地”。进阶开发者面对的代码环境往往伴随着百亿参数体量、多机多卡异构算力集群以及微秒级的推理时延限制。
从初级开发者跃迁至进阶工程师,技术关注点需要完成三个维度的本质转变:
- 从“黑盒拼装”到“算子级白盒剖析”:不再仅仅依赖
torch.nn.Sequential堆叠现成层,而是深入张量内存排布(Strides)、自动微分图的拓扑演进与前向缓存(Save for Backward)机制。 - 从“单卡默认循环”到“分布式并行与显存优化”:理解数据并行(DDP)、完全分片数据并行(FSDP)与张量并行(TP)的通信拓扑,熟练运用激活值检查点(Activation Checkpointing)与混合精度(AMP)技术。
- 从“直觉式改参”到“编译图优化与全流程观测”:掌握现代深度学习编译栈(如 TorchDynamo 与 Inductor),利用系统级 Profiler 工具精准定位显存流与 CUDA Kernel 算力瓶颈。
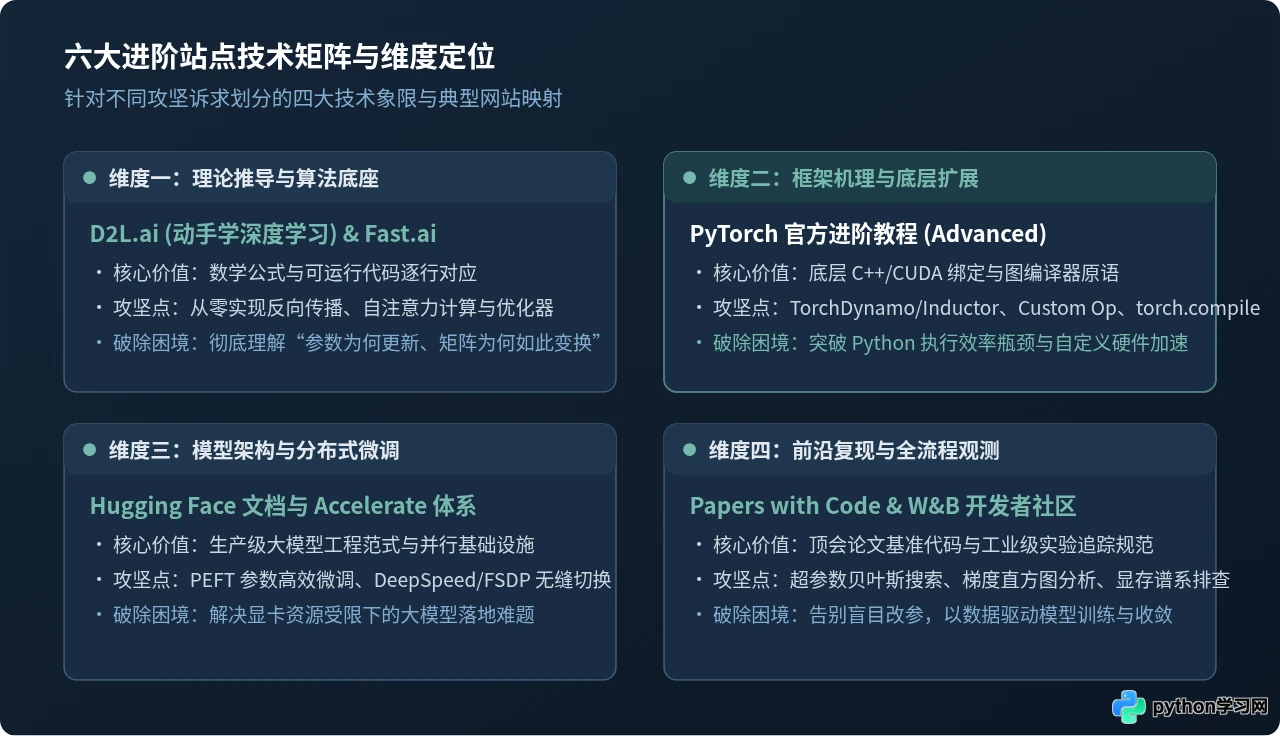
二、六大核心进阶深度学习网站推荐与深度解析
为了完成上述维度的跃迁,进阶开发者需要建立体系化的学习与参考矩阵。以下推荐的 6 个核心技术站点,分别在数学推导、框架底层、工业级架构、分布式并行、论文复现及实验观测等关键领域具备极高的技术密度。
多数开发者在浏览 PyTorch 官网时仅停留在入门板块,而其 Intermediate 与 Advanced 教程才是进阶者的宝藏。该板块系统讲解了 PyTorch 的底层通信原语、自定义 C++/CUDA 算子绑定以及 PyTorch 2.0+ 核心的 torch.compile 编译图捕获机制。
进阶开发者应重点攻坚以下三个模块:
- Custom C++ and CUDA Extensions:学习如何通过
torch.utils.cpp_extension将自研底层 Kernel 无缝注入 Python 运行时,绕过 Python GIL 瓶颈并最大化发挥 GPU 硬件吞吐。 - TorchDynamo 与 TorchInductor 机制:理解基于 Python 字节码分析的图捕获过程,学习如何排查导致编译性能骤降的 Graph Break(图中断)问题。
- Distributed and Parallel Training Tutorials:从底层的
torch.distributed点对点与集合通信(AllReduce、ReduceScatter),逐步过渡到 FSDP 分布式显存分片实现。
例如,要编写一个具备前向与梯度后向绑定的私有算子,开发者必须继承 torch.autograd.Function 并显式管理张量缓存:
import torch

class CustomScaleShiftFunction(torch.autograd.Function):
    # 自定义前向与后向梯度算子,严格管理张量上下文生命周期
    @staticmethod
    def forward(ctx, x, weight, bias):
        # 保存反向传播计算所需的张量,注意只保存必要的中间变量以控制显存占用
        ctx.save_for_backward(x, weight)
        return x * weight + bias

    @staticmethod
    def backward(ctx, grad_output):
        x, weight = ctx.saved_tensors
        grad_x = grad_output * weight
        grad_weight = (grad_output * x).sum()
        grad_bias = grad_output.sum()
        return grad_x, grad_weight, grad_bias

# 进阶验证:使用 gradcheck 进行数值梯度与解析梯度的微积分对齐验证
x_test = torch.randn(2, 2, dtype=torch.float64, requires_grad=True)
w_test = torch.randn(1, dtype=torch.float64, requires_grad=True)
b_test = torch.randn(1, dtype=torch.float64, requires_grad=True)

test_passed = torch.autograd.gradcheck(
    CustomScaleShiftFunction.apply, (x_test, w_test, b_test), eps=1e-6, atol=1e-4
)
print(f"Autograd 数值梯度验证结果: ", test_passed)
由李沐等多位资深 AI 科学家打造的开源巨著《动手学深度学习》(D2L),其最大的特色是“公式不留黑盒,代码严谨对应”。许多开发者虽然了解自注意力机制(Self-Attention)的概念,但面对多头注意力中 Q、K、V 的高维张量变换及转置细节往往含混不清。
D2L 在进阶阶段的核心阅读价值集中在:
- 注意力机制与 Transformer 深度推导:从掩码 Softmax、加性注意力到缩放点积注意力,每一处矩阵变换均附带严格的张量形状注释与单步代码执行。
- 计算性能章节(Computational Performance):专门阐述深度学习在底层硬件上的计算流,包括多 GPU 训练的数据分发原理、参数服务器架构以及自动混合精度(Automatic Mixed Precision, AMP)的底层溢出保护与 Loss Scaling 策略。
.shape、.stride() 与内存连续性 .is_contiguous(),彻底消除数学公式与张量内存布局之间的理解割裂。
Hugging Face 不仅仅是模型权重的共享社区,其官方 Documentation 已经成为事实上的现代工业级 NLP 与大模型架构工程手册。
进阶开发者应跳过基础的 pipeline() 调用,将注意力集中在以下三大核心工程组件:
- Accelerate 库架构设计:提供了单机多卡、DeepSpeed(ZeRO 1/2/3)与 PyTorch FSDP 的统一调度抽象。研读其文档能够清晰理解分布式初始化(
accelerator.prepare)如何自动切分 DataLoader、模型参数与优化器状态。 - PEFT (Parameter-Efficient Fine-Tuning):系统解析 LoRA、Prefix-Tuning 与 Prompt Tuning 的实现机理。详细展示了低秩矩阵如何注入模型注意力投影层,并推导为何使用 QLoRA(4-bit 量化)能在单张消费级显卡上微调百亿参数模型。
- Text Generation Inference (TGI) 与 vLLM 推理架构:探讨 PagedAttention、连续批处理(Continuous Batching)与张量并行在生产环境中的落地细节。
在工业界开发中,进阶工程师与初学者的一个显著区别在于“严谨的可复现性与监控排障能力”。Weights & Biases 的官方工程博客与 Fully Connected 社区提供了大量顶尖工程团队在模型训练排障中的实操记录。
该站点的核心技术价值包括:
- 训练稳定性与梯度异常排查:如何通过在反向传播中挂载 Hook,实时绘制各网络深度的权重与梯度直方图,在训练初期便捕捉到梯度弥散(Vanishing)或爆炸(Exploding)的早期迹象。
- GPU 显存占用与计算吞吐量分析:剖析模型参数、优化器状态(以 Adam 的一阶与二阶动量为例需占用参数量 8 倍显存)、激活值缓存三者之间的显存动态消长曲线。
- W&B Sweep 自动化超参数调优:运用高斯过程或贝叶斯优化(Bayesian Optimization)进行超参数寻优,彻底告别盲目的网格搜索(Grid Search)。
进阶开发者必须保持跟踪前沿架构演进的能力。单纯在 ArXiv 上阅读 PDF 往往会遇到“理论清晰但工程细节缺失”的难题。Papers with Code 建立了顶会学术论文与 GitHub 高质量开源实现的双向链接。
进阶阅读方法:
- 查看官方实现与社区高星复现:通过比对不同团队对同一算法的实现,辨析哪些工程 Trick(如学习率预热 Warmup、Weight Decay 排除 LayerNorm 参数、梯度裁剪 ClipGradNorm)对模型最终指标产生了决定性影响。
- 基准榜单(State-of-the-Art Leaderboards):查看在标准基准数据集上的硬件配置与复现成本,客观评估新算法的计算效率与商业落地可行性。
Fast.ai 常被误认为只适合纯初学者,但其进阶系列课程“Deep Learning from the Foundations”则是技术深度极高的高级教程。课程带领开发者从裸 Python 和基础矩阵相乘运算出发,一步步构建出完整的自动微分、广播机制(Broadcasting)、SGD 优化器及高度可扩展的回调机制(Callback System)。
研读该课程能帮助进阶开发者彻底摆脱对高层框架的畏惧感,在面临特殊业务逻辑(如动态损失加权、早停策略、自定义日志注入)时,能够游刃有余地重构训练主循环。
三、进阶实战演进操作推进路径
面对上述丰富的技术资源,孤立地访问各个站点往往效率低下。进阶开发者应当以一个具体工程任务为牵引,按照“算子推导 → 图编译加速 → 分布式并行 → 工业监控落地”的四步闭环推进实战攻坚。
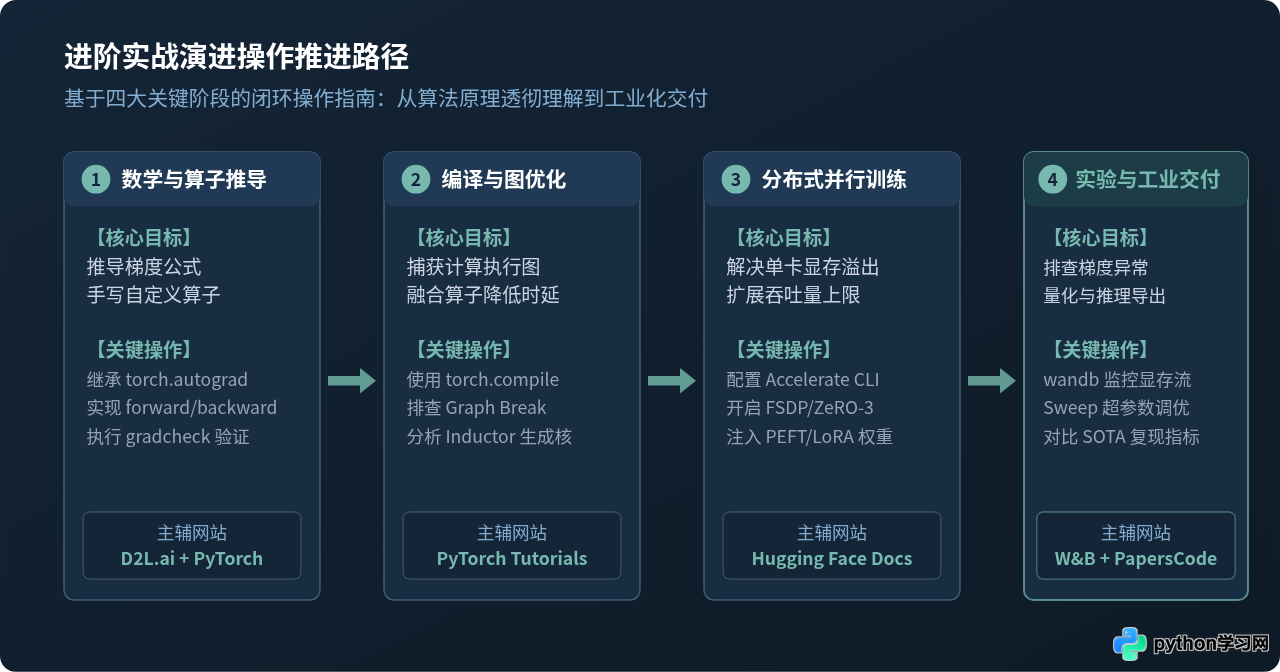
阶段一:数学原理验证与自定义算子实现
首先,在 D2L.ai 中查阅目标算法的数学公式推导,确保对标量求导扩展至高维张量雅可比矩阵的过程无歧义。随后,在本地环境继承 torch.autograd.Function 编写自定义前向与后向算子。
关键验证步骤:必须使用 torch.autograd.gradcheck 进行解析梯度与有限差分数值梯度的逼近测试,确认在不同扰动步长 eps 下的绝对误差(atol)处于阈值范围内。
阶段二:框架计算图解析与编译优化
在实现自定义逻辑后,直接进入 PyTorch 官方进阶教程中的 torch.compile 专栏。通过开启环境变量排查计算图中的中断点:
# 在终端中开启 TorchDynamo 调试日志,分析图中断原因
export TORCH_LOGS="+dynamo"
export TORCHDYNAMO_VERBOSE=1

# 执行模型编译与训练脚本
python train_advanced.py
通过分析生成的执行日志,消除动态形状(Dynamic Shapes)或隐式 Python 数据类型转换导致的图重新编译,使算子能够充分被 Inductor 生成融合后的 Triton 内核。
阶段三:分布式并行扩展与显存分片配置
当单卡显存无法承载全量模型与反向传播激活值时,查阅 Hugging Face Accelerate 文档,配置完全分片数据并行(FSDP)或 DeepSpeed ZeRO-3。
标准操作是在命令行运行交互式配置:
# 生成分布式硬件配置文件
accelerate config

# 交互式选择项推荐:
# - In which compute environment are you running? -> This machine
# - Which type of machine are you using? -> multi-GPU
# - What mixed precision style should be used? -> bf16 (若硬件支持 Ampere 及以上架构)
# - Do you want to use FullyShardedDataParallel? -> true
阶段四:全流程实验追踪与量化导出
在分布式训练主节点集成 Weights & Biases 监控 API。在模型反向传播处通过注册张量钩子(register_hook),将每层梯度范数(Gradient Norm)与显卡实际分配显存(torch.cuda.memory_allocated())持续打点上报。
训练收敛后,参考 Papers with Code 上对应领域的基准精度,通过 BitsAndBytes 或 AWQ 进行 4-bit/8-bit 量化压缩,并导出为 ONNX 或 TensorRT 引擎完成工业级交付。
四、进阶开发中的常见认知误区与排障提醒
在向深层技术迈进的过程中,许多开发者容易陷入思维定式或常见的技术误区,导致花费大量时间却事倍功半:
许多开发者花费数周研读复杂的注意力变体论文,但在实际代码实现后发现训练速度极慢。未经 Profiler 分析的优化往往是徒劳的。进阶开发必须养成“以 PyTorch Profiler 结果为依据进行优化”的习惯,先确定性能瓶颈到底是在数据加载(DataLoader
num_workers 与 pin_memory)、GPU 显存带宽(Memory Bound),还是在算子计算单元(Compute Bound)。
缩减 Batch Size 会改变优化器有效学习率并降低 GPU 硬件利用率。正确的进阶解决路径是:
- 开启自动混合精度(
torch.cuda.amp.autocast或bf16),参数存储开销瞬间减半; - 引入梯度检查点(
torch.utils.checkpoint),通过以计算时间换显存空间,舍弃部分中间激活值并在反向传播时重算; - 使用梯度累积(Gradient Accumulation),在微小 Micro-batch 上多次计算后执行一次参数更新,等效于维持较大的全局 Batch Size。
DataParallel (DP) 与 DistributedDataParallel (DDP)初学者常因写法简单而直接使用
torch.nn.DataParallel,但 DP 基于单进程多线程机制,受制于 Python GIL,且必须在主卡(GPU 0)上汇总并分发所有梯度,极易造成 GPU 0 显存溢出而其他卡闲置。进阶开发必须完全拥抱多进程架构的 DistributedDataParallel,通过 NCCL 后端实现去中心化的环形(Ring-AllReduce)通信。
五、进阶技术网站选型矩阵与研读策略总结
为了让开发者能够根据当前面临的具体工程卡点精准选择对应的站点,下表对这 6 个核心技术平台进行了多维度的综合比对:
| 网站名称 | 核心技术维度 | 最适合突破的瓶颈 | 进阶建议研读模块 | 研读频次建议 |
|---|---|---|---|---|
| PyTorch Advanced | 框架原理与底层扩展 | 私有硬件算子开发、编译加速 | Custom C++/CUDA Ext, TorchDynamo | 技术方案设计时深度精读 |
| D2L.ai (动手学) | 数学推导与基础自研 | 算法数学机制不透彻、从零实现 | Attention, Computational Performance | 巩固理论时系统通读 |
| Hugging Face Docs | 现代模型与分布式工程 | 大模型微调、多卡显存溢出 | Accelerate (FSDP/ZeRO), PEFT (LoRA) | 工程落地日常必备参考 |
| W&B Fully Connected | 实验观测与参数寻优 | 梯度弥散排查、显存流水线调优 | GPU Memory Profiling, Sweep 贝叶斯搜索 | 遇到收敛或性能瓶颈时查阅 |
| Papers with Code | 前沿架构与基准对比 | 复现质量评估、选型对标 | SOTA Benchmarks, Official Git Repos | 立项调研与模型选型时检索 |
| Fast.ai Foundations | 框架设计与底层逻辑 | 破除框架黑盒依赖、自定义优化器 | Callbacks System, Custom Optimizers | 进阶筑基阶段精读实操 |
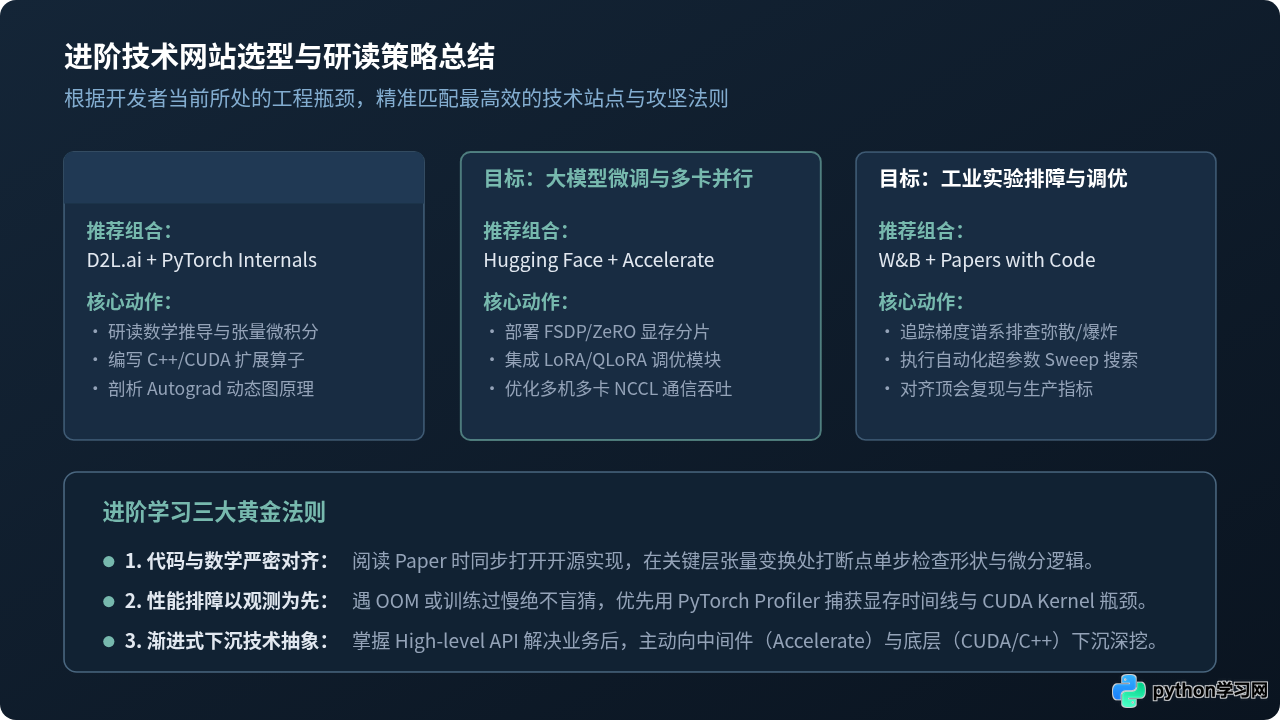
结语:从 Python 基础语法到深度学习工程落地,本质上是一场从“掌握语法规则”向“深入计算机系统、张量微积分与硬件拓扑协同”的技术远征。通过在 D2L 夯实数学机理、在 PyTorch 官方高级教程理解底层图编译、在 Hugging Face 掌握现代分布式范式,并借助 W&B 与 Papers with Code 建立工业级观测与前沿对标,开发者便能彻底打破表层黑盒,真正具备驾驭大规模深度学习研发的实战硬实力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















