


Python循环读取文件时跳过指定行继续读下一行
在Python中循环读取文件时跳过指定行并继续处理下一行,核心是利用循环体内的continue语句配合条件判断,或在循环外使用next()预先跳过。本文详细讲解基于行号、基于内容过滤及处理大文件时的具体实现方法与注意事项。
在 Python 中逐行循环读取文件时,跳过不需要的行并直接继续读取下一行,最直接、通用的解决路径是在循环体内部通过 if 语句匹配跳过条件,随后执行 continue 语句。此外,如果跳过的行集中在文件起始位置(例如文件表头或前 N 行),也可以在进入循环前直接调用 next() 或结合 itertools.islice 预先步进。这两种方法都能保持底层迭代器平稳前进,既不会中断整个读取过程,也不会耗尽系统内存。
一、核心原理:continue 语句与文件迭代器协同
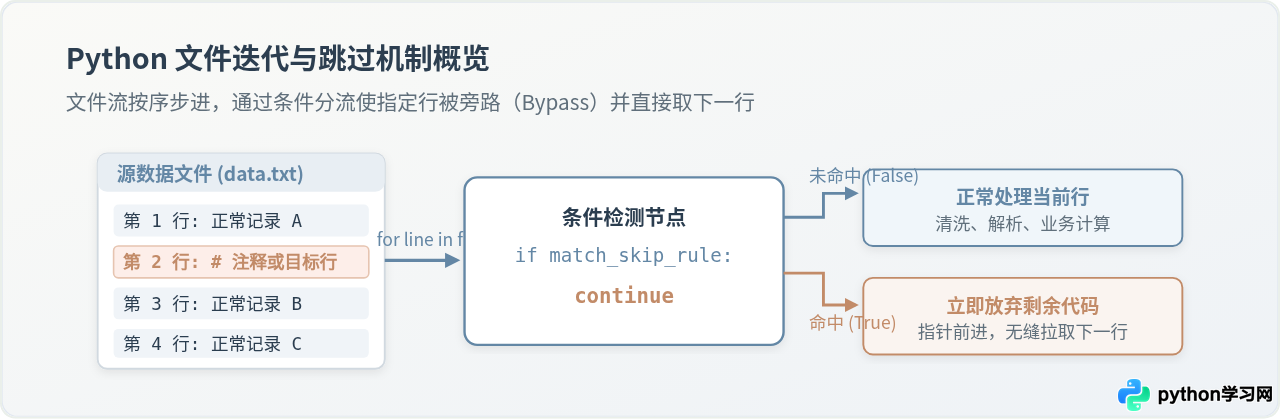
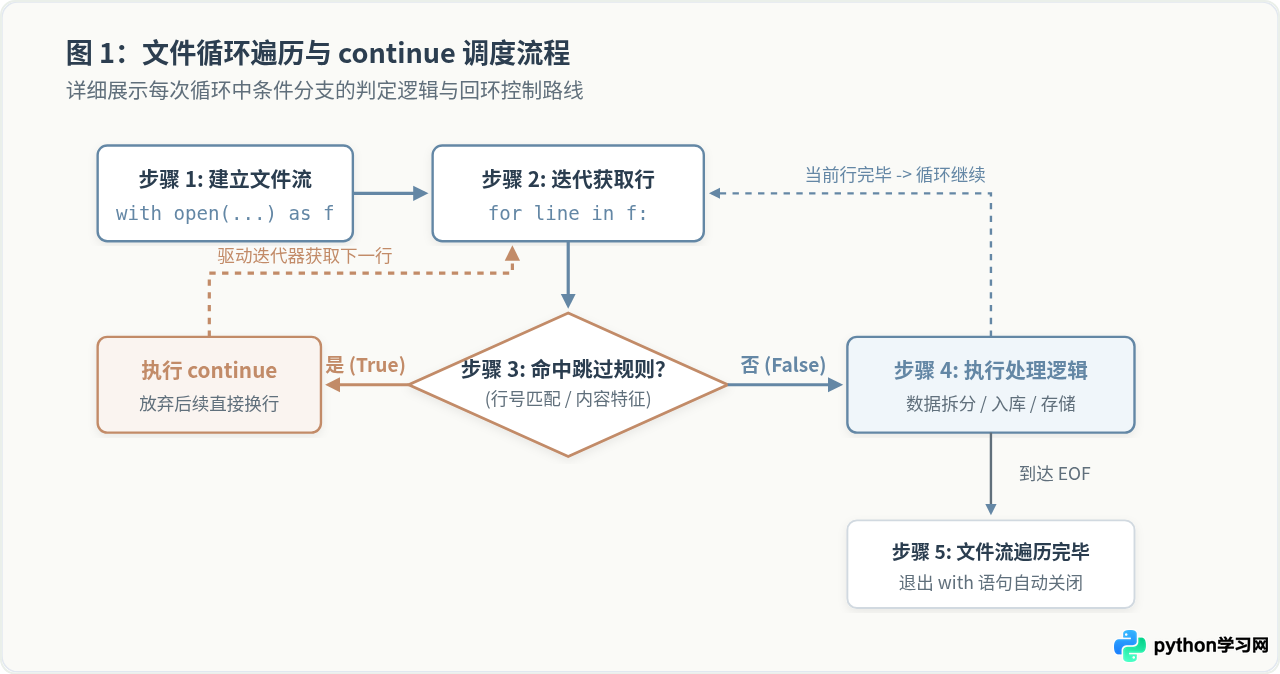
很多初学者在需要跳过某些行时,容易产生一种误解:以为执行了某种跳过操作会导致文件指针乱序,或者必须把文件整体读入列表后再删除元素。实际上,Python 的文件对象是原生的迭代器(Iterator)。当我们在 Python 中写出 for line in f: 时,解释器在每轮循环开始时都会自动调用底层迭代器的 __next__() 方法,从文件中读入下一个文本行。
在这个机制下,continue 语句起到了关键的分流调度作用:一旦代码遇到 continue,Python 会立刻停止执行本轮循环中位于该语句下方的所有逻辑,并直接回到循环开头,促使文件迭代器拉取下一行文本。因此,迭代过程既不会中断,也不会重复处理,跳过的代价非常轻量。
二、按行号跳过指定行:具体场景与实现
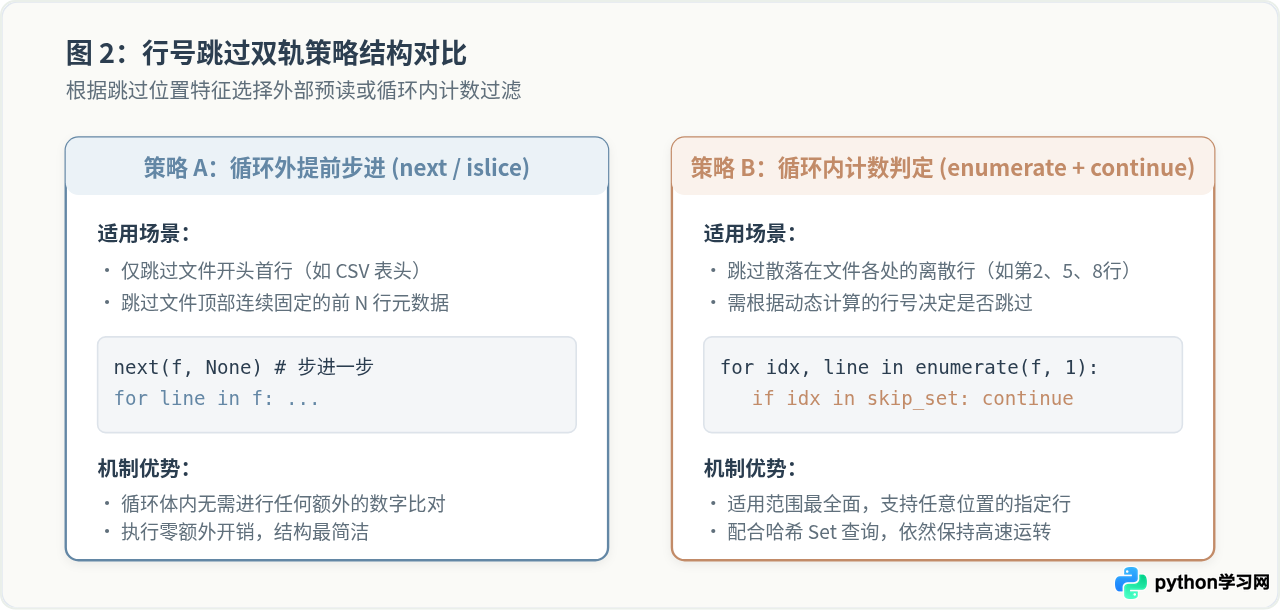
按行号跳过通常分为两种情形:一种是仅跳过开头的固定前几行(如 CSV、日志文件的首行表头或说明信息);另一种是跳过离散分布的指定行号(例如明确要求跳过第 2 行和第 5 行)。
1. 针对文件头部:循环外调用 next() 预先跳过
如果目标仅仅是跳过文件的第一行(例如跳过表头),最干净且性能最高的方式是在进入 for 循环之前,对文件对象调用一次内置函数 next()。这样可以让文件游标先走一步,后续循环从第 2 行开始正常运转。
# 示例 1:使用 next() 跳过第 1 行表头
with open("dataset.csv", "r", encoding="utf-8") as f:
    # 预先读取并丢弃第 1 行(表头)
    # 第二个参数 None 用于防止文件全空时抛出 StopIteration 异常
    next(f, None)

    for line in f:
        # 此时循环直接从第 2 行开始读取
        clean_line = line.strip()
        print(f"处理数据: {clean_line}")
如果需要跳过开头的前 N 行(例如前 3 行属于元数据配置),可以结合标准库 itertools.islice,或者使用简单的下划线循环丢弃:
import itertools

# 示例 2:跳过文件开头的前 3 行
with open("config.txt", "r", encoding="utf-8") as f:
    # islice(可迭代对象, 起始索引, 结束索引)
    # 此处从索引 3(即实际第 4 行)开始向后切片
    for line in itertools.islice(f, 3, None):
        print(f"主体内容: {line.strip()}")
2. 针对离散行号:使用 enumerate() 配合 continue
如果需要跳过的行号位于文件内部或者是不连续的(例如指定跳过第 1 行、第 3 行和第 6 行),我们需要记录当前行对应的行号。推荐使用 Python 内置的 enumerate() 函数,并将起始值 start 设置为 1(符合通常的人类行号习惯)。
为了保证判断效率,待跳过的行号列表应当使用集合(set)存储。集合在 Python 底层使用哈希表实现,in 操作的时间复杂度为 O(1),即便要跳过成百上千个特定行,也不会降低读取速度。
# 示例 3:跳过指定的第 2 行与第 5 行
target_skip_lines = {2, 5}  # 使用 set 集合存储目标行号

with open("records.txt", "r", encoding="utf-8") as f:
    # enumerate 第二个参数 start=1,代表从行号 1 开始计数
    for line_number, line in enumerate(f, start=1):
        if line_number in target_skip_lines:
            # 命中指定行号,跳过当前行,继续读取下一行
            continue

        # 未被跳过的行继续执行
        print(f"[第 {line_number} 行] 正文: {line.strip()}")
三、按内容特征跳过指定行:条件过滤
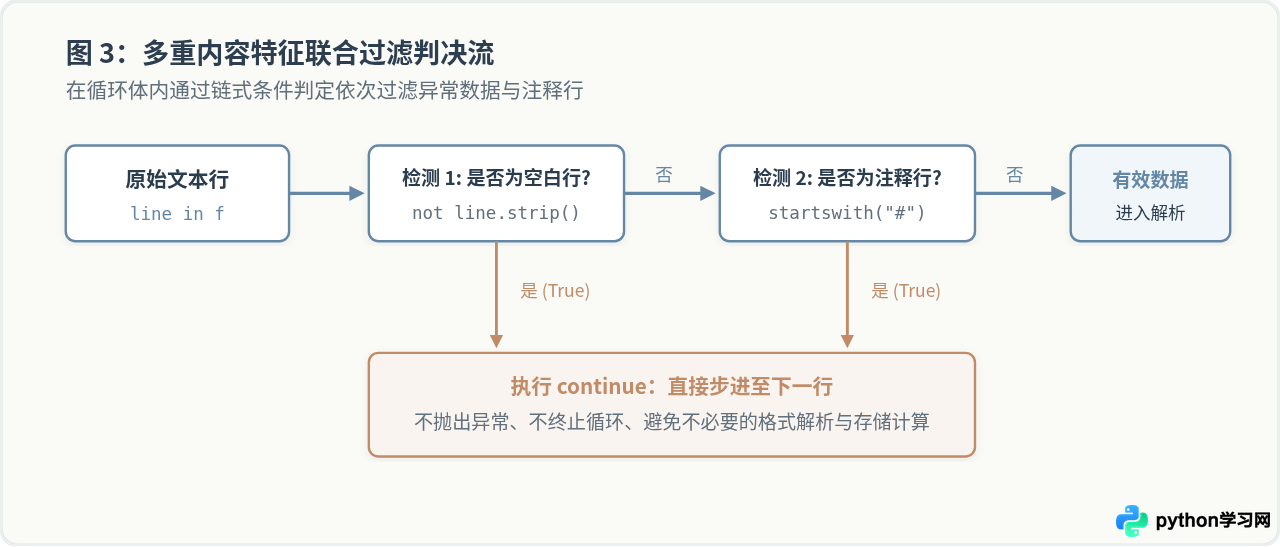
在实际生产环境中,更普遍的需求是根据“该行包含什么内容”来决定是否跳过。最典型的三种情况是:跳过空行、跳过注释行,以及跳过不符合格式规范的异常行。
1. 跳过空白行(纯换行符或仅含空格制表符)
文件中常有连续的回车换行。直接读取时,纯换行符行会得到 "
" 或 "
"。如果直接写 if line == "": 是无法命中空行的,因为换行符也属于字符。正确的判断方式是调用 line.strip() 剥离两端空白后再做真值判断:
# 示例 4:跳过空白行
with open("raw_text.txt", "r", encoding="utf-8") as f:
    for line in f:
        # 去除首尾空白后如果长度为0,说明是纯空行或仅含空格
        if not line.strip():
            continue

        # 正常业务处理
        print(f"有效数据: {line.strip()}")
2. 跳过注释行(以特定标记字符开头)
对于配置文件、脚本或导出的数据表,通常使用 #、// 或 ; 作为注释标记。通过字符串的 startswith() 方法可以快速辨别:
# 示例 5:跳过以 # 或 // 开头的注释行
with open("service.conf", "r", encoding="utf-8") as f:
    for line in f:
        trimmed = line.strip()

        # 遇到空行或注释行均跳过
        if not trimmed or trimmed.startswith(("#", "//")):
            continue

        print(f"解析配置项: {trimmed}")
四、注意事项与避坑指南
f.readlines() 读出整个列表后再切片或遍历。这样会瞬间将整个文件的全部数据塞入内存,造成严重的性能问题甚至 OOM(内存溢出)崩溃。
在编写文件循环跳过逻辑时,有以下几点需要特别注意:
- 逐行惰性迭代:务必直接对文件句柄使用
for line in f:。这种方式每次只载入一行到内存,无论文件体积是 100 KB 还是 50 GB,内存占用始终保持平稳恒定。 - 换行符保留问题:直接从
for line in f读出的line默认末尾包含line.strip(),但在向新文件写回时,需注意是否需要保留原有的换行符。 - 使用 set 加速行号查询:若跳过的行号数量较多,务必将待跳过行放入
set而非list。在包含 10,000 个元素的list中查找每次需要 $O(N)$,而在set中只需 $O(1)$。 - 正确声明编码:在
open()时始终显式传入encoding="utf-8",避免因不同操作系统的默认编码差异(如 Windows 下的 GBK)导致意外解码失败。
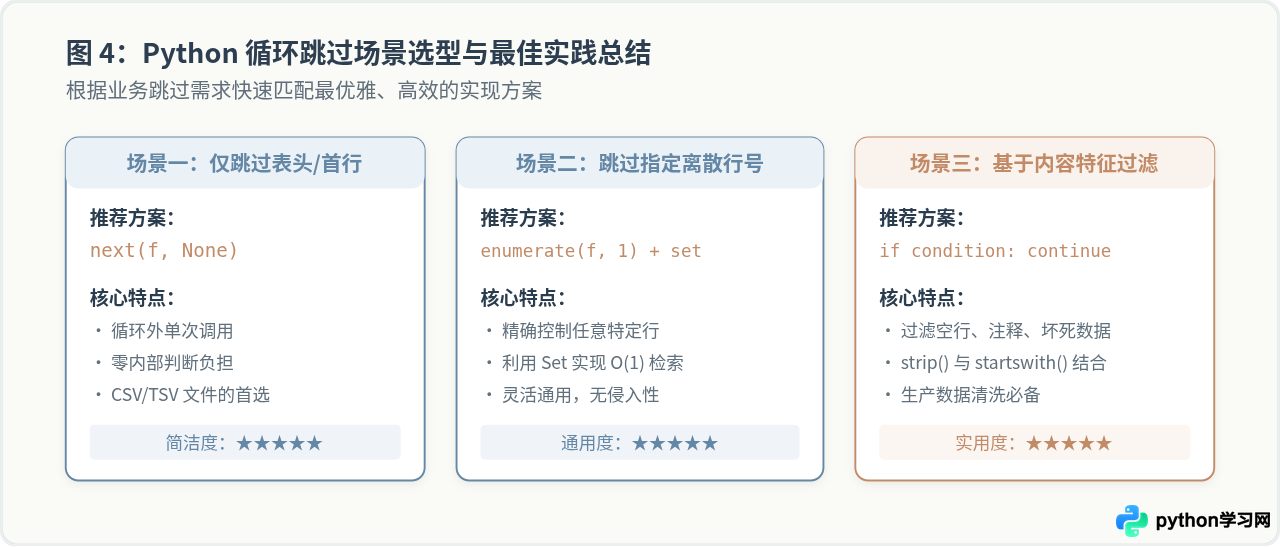
五、方案选型速查表
| 需求场景 | 推荐使用方法 | 代码模式 | 内存与性能表现 |
|---|---|---|---|
| 仅跳过第 1 行(表头) | next(f, None) |
循环外预先执行一次 next() |
最优。单次迭代推进,循环体内零开销 |
| 跳过文件开头前 N 行 | itertools.islice |
for line in islice(f, N, None): |
极高。底层 C 实现切片,高效规避前 N 行 |
| 跳过指定分散行号(如第 2、5 行) | enumerate(f, 1) + set |
if idx in skip_set: continue |
高。哈希集合提供 $O(1)$ 查找,通用性好 |
| 跳过空行或注释行 | strip() + continue |
if not line.strip(): continue |
高。直接针对字符串特性过滤,保护下游逻辑 |
综上所述,Python 循环读取文件时跳过指定行并继续执行的本质,是通过控制循环语句的流程跳转(continue)或外部提前步进迭代器(next)。把握住文件对象的流式迭代特性,配合针对性的条件判断,即可在保持代码清晰明了的同时,获得稳定而高效的文件处理表现。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















