


Python列表切片索引越界为什么不报错
深入解析Python中列表单元素索引越界抛出IndexError,而切片越界却安全返回空列表或截断子列表的核心原因。包含语义模型、CPython源码执行机制、栅栏坐标系对比及实战规避建议。
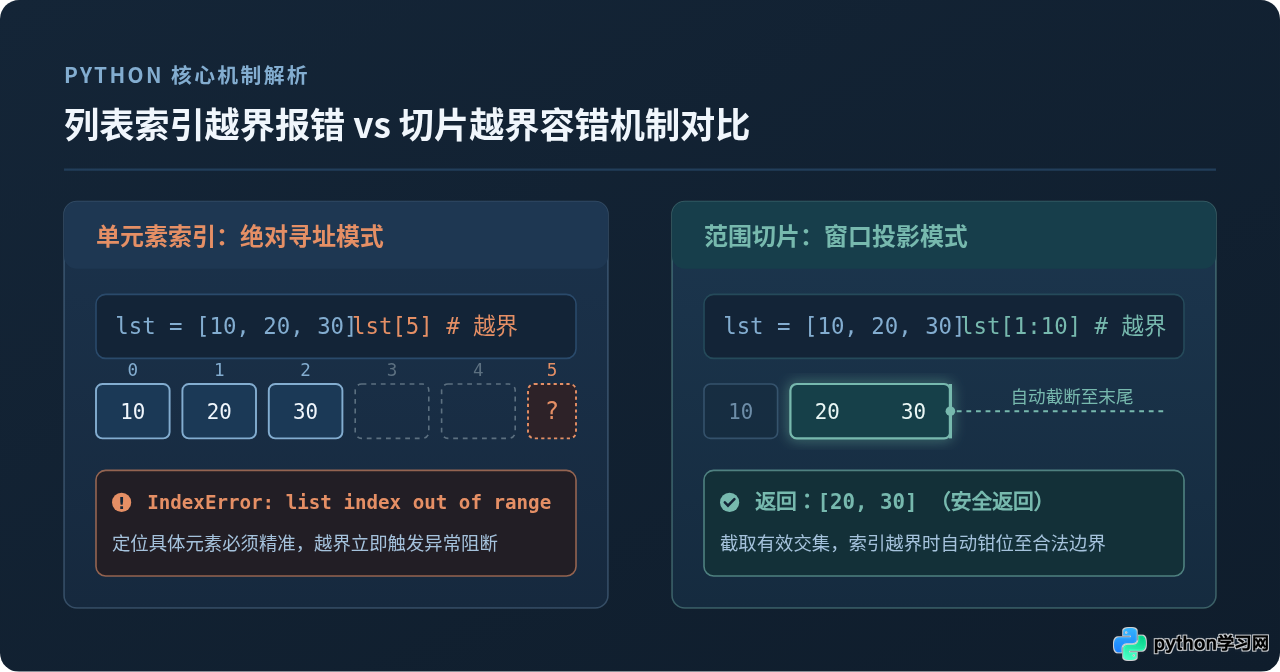
在 Python 日常编码中,很多初学者都会遇到一个反直觉的现象:当你通过单索引 lst[10] 访问一个仅包含 3 个元素的列表时,解释器会毫不犹豫地抛出 IndexError: list index out of range;然而当你执行切片操作 lst[1:10] 或者 lst[10:20] 时,代码不仅没有任何报错,反而稳稳当当地返回了截断的有效元素或一个空列表 []。本文将从设计意图、语义差异、底层 CPython 源码实现以及数学边界模型四个维度,彻底讲透切片不报错的原因与实际工程中的注意事项。
一、现象重现:单索引报错与切片容错的表现差异
我们先通过一段最直观的代码来观察这两种行为的截然不同:
# 准备一个长度为 3 的普通列表
nums = ['A', 'B', 'C']

# 情况 1:单元素普通索引超出边界
try:
    print(nums[5])
except IndexError as e:
    print(f"单索引越界触发异常: {e}")
# 示例输出:单索引越界触发异常: list index out of range

# 情况 2:切片终点越界
print(nums[1:10])
# 示例输出:['B', 'C'] (截取所有有效内容,不报错)

# 情况 3:切片起点和终点全部严重越界
print(nums[100:200])
# 示例输出:[] (无重叠区间,安全返回空列表)

# 情况 4:负数索引极大越界
print(nums[-100:2])
# 示例输出:['A', 'B'] (负数被归一化并钳位至头部 0)
表面上看,两者都使用了中括号语法 [],但其底层所承载的操作语义截然不同。单索引是在做“对象寻址”,而切片是在做“区间提取”。
二、语义设计:为什么单索引必须严苛,而切片应当宽容?
编程语言的设计并不是随意的,每一个看似例外的规则背后都有严谨的工程权衡:
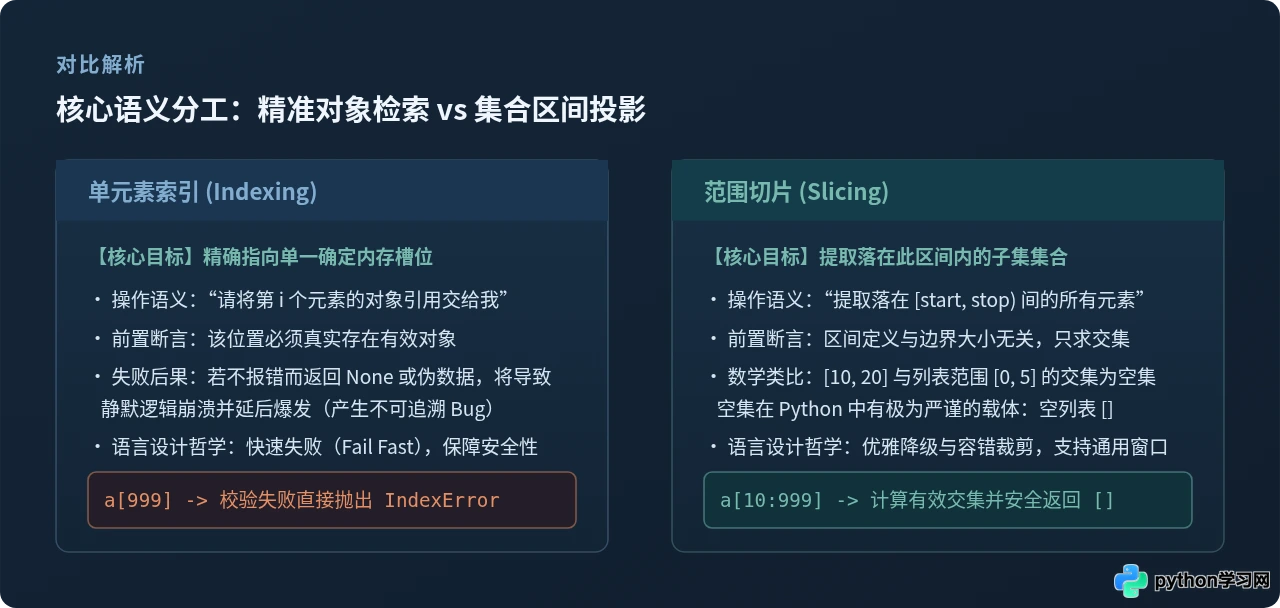
1. 单索引语义:确定性定位与快速失败(Fail Fast)
当开发者编写 elem = nums[i] 时,表达的是非常确定的意图:“请把位于位置 i 的具体对象引用拿给我”。如果位置 i 并不存在对应的数据,解释器只有两种选择:
- 选择 A(宽松但不负责任):静默返回一个特殊值(如
None)。这种做法在后续代码继续对elem调用属性或方法时,会在距离现场极远的地方爆出莫名其妙的AttributeError: 'NoneType' object has no attribute ...,排查成本极高。 - 选择 B(严格且明确,Python的做法):当场抛出
IndexError,强制中断并告知开发者索引越界,确保错误在发生的第一时间被捕获。
2. 切片语义:提取落入窗口内的全部可用集合
切片 nums[start:stop] 的本质是定义了一个观察窗口。在数学与集合论中,一个闭开区间 [start, stop) 与有序序列的交集可能包含多个元素、一个元素,也可能是空集。如果交集为空,返回一个合法且类型一致的空容器 [],完全符合自洽的数学逻辑,无需报错。
试想在文本处理或批处理场景中:如果你想截取字符串或列表的前 10 个字符 data[:10],如果切片强制检查长度,开发者在任何截取前都必须额外写一层防御:data[:min(len(data), 10)]。这不仅会让代码充满冗余的样板代码,还会严重削弱 Python 的可读性与优雅性。
三、源码视角:CPython 底层如何处理切片索引?
在 CPython 解释器源码中,列表单元素访问与切片访问调用的是完全不同的内部函数。
对于单索引访问,底层通过 list_item(PyListObject *a, Py_ssize_t i) 函数实现。源码中的检查非常硬编码:
/* CPython 源码 Objects/listobject.c 简略逻辑 */
if (!valid_index(i, Py_SIZE(a))) {
    PyErr_SetString(PyExc_IndexError, "list index out of range");
    return NULL;
}
return a->ob_item[i];
只要 i 超出 [0, len-1] 的范围,直接设置 IndexError 异常并返回空指针。
而对于切片访问,CPython 则调用 list_subscript,进而调用核心函数 PySlice_Unpack 与 PySlice_AdjustIndices(位于 Objects/sliceobject.c)。核心工作是对传入的 start、stop 进行归一化与钳位裁剪(Clamping):
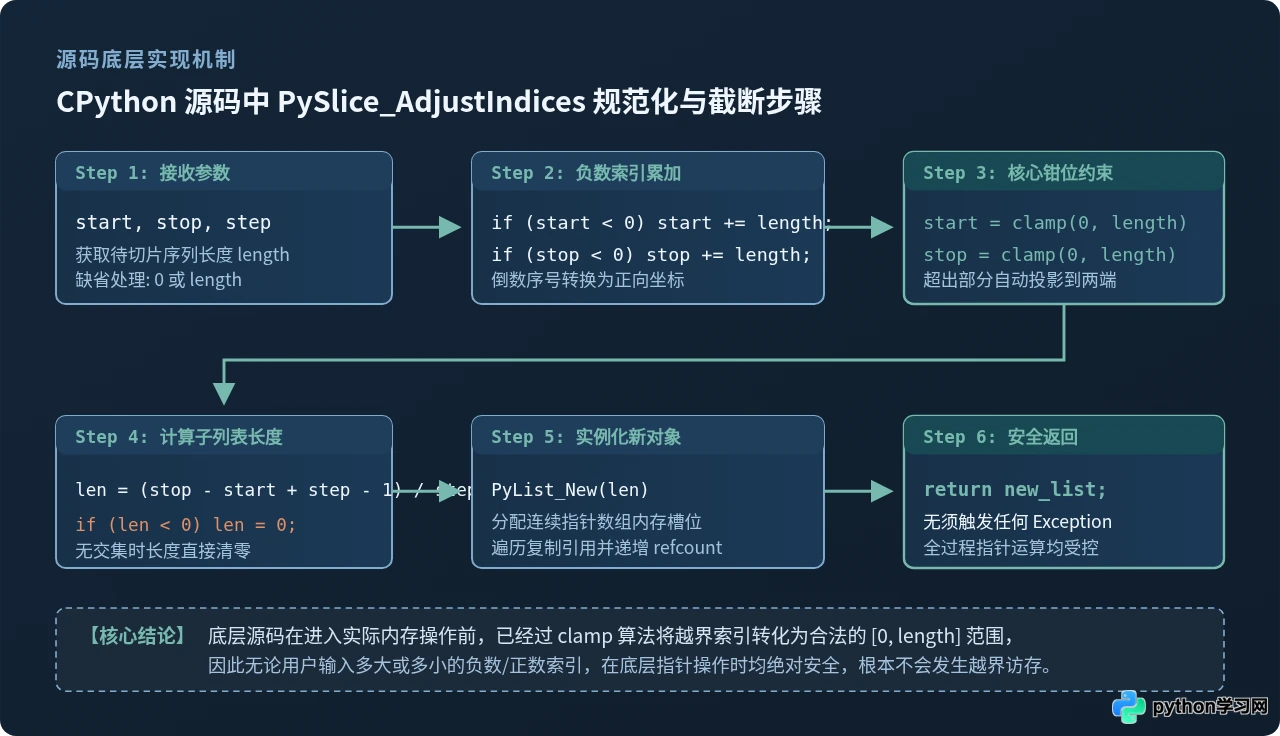
以步长 step > 0 为例,其核心 C 语言算法逻辑如下:
/* 简化的 PySlice_AdjustIndices 核心逻辑 */
if (*start < 0) {
    *start += length;
    if (*start < 0) *start = 0; /* 负数极大越界,钳位到 0 */
} else if (*start >= length) {
    *start = length; /* 正数极大越界,钳位到 length */
}

if (*stop < 0) {
    *stop += length;
    if (*stop < 0) *stop = 0;
} else if (*stop >= length) {
    *stop = length; /* 超出右边界,钳位到 length */
}
通过这套钳位机制,无论 Python 层传入多么夸张的数字(例如 nums[-99999:88888]),在进入 C 语言真正的内存指针寻址前,起止位置都已经被平滑约束在 0 <= start <= length 与 0 <= stop <= length 之间。因此底层分配内存和拷贝指针时绝不会发生内存非法越界,自然不需要触发任何异常。
四、几何模型:栅栏刻度坐标系(Fencepost Model)
计算机科学先驱 Edsger W. Dijkstra 曾在论述数组从 0 开始计数时阐述过类似思想。理解 Python 切片最好的心智模型是“栅栏刻度模型”:
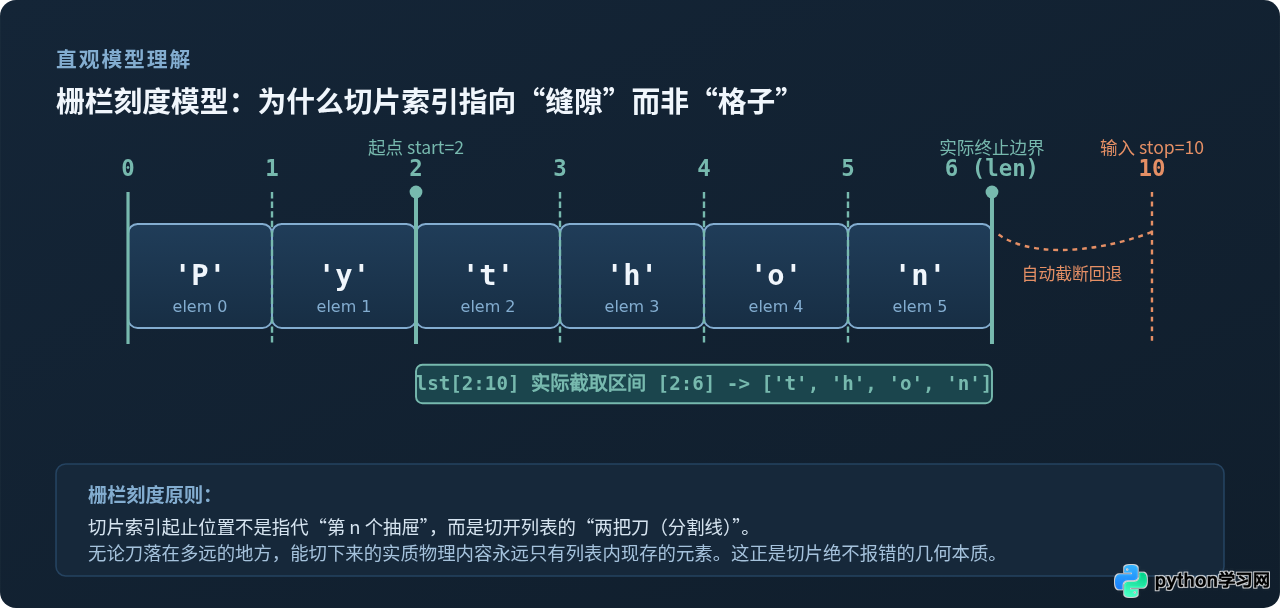
在这个模型中:
- 单索引访问:指向的是具体的格子内部。若要求访问第 5 个格子,而队伍里只有 3 个格子,必然引发“扑空”的致命错误。
- 切片索引:指向的是格子之间的分割线(栅栏)。数字 0 代表最左侧栅栏,数字
len代表最右侧栅栏。 - 当你执行
nums[1:10]时,意味着用两把刀分别切在刻度 1 和刻度 10 的位置。第二把刀即便划到了操场外面,能够被两把刀实际圈出来的物理元素,依然只有从刻度 1 到右边界现存的元素。
五、切片容错机制在工程中的典型应用
切片的不报错机制并非只是为了“偷懒”,在日常工程开发中,它极大地简化了大量常见模式的代码复杂度:
1. 稳健的分页与批处理(Chunking)
在实现数据分页读取时,最后一页的数据条数往往不足一整页。如果切片会报错,每一页都需要先判断剩余数量:
def paginate(items, page_size=10):
    total = len(items)
    for i in range(0, total, page_size):
        # 切片自动处理最后一页不足 page_size 的情况,无需额外 min() 判定
        yield items[i : i + page_size]
2. 安全的字符串前缀与后缀截取
在清洗用户输入或生成预览摘要时,数据长度通常不可预知:
# 安全提取前 5 个字符,即使 title 为空字符串或只有 2 个字也绝不崩溃
summary = title[:5]
# 安全丢弃末尾换行或固定后缀
clean_line = line[:-1]
六、开发者必知的两个隐蔽“陷阱”与防范策略
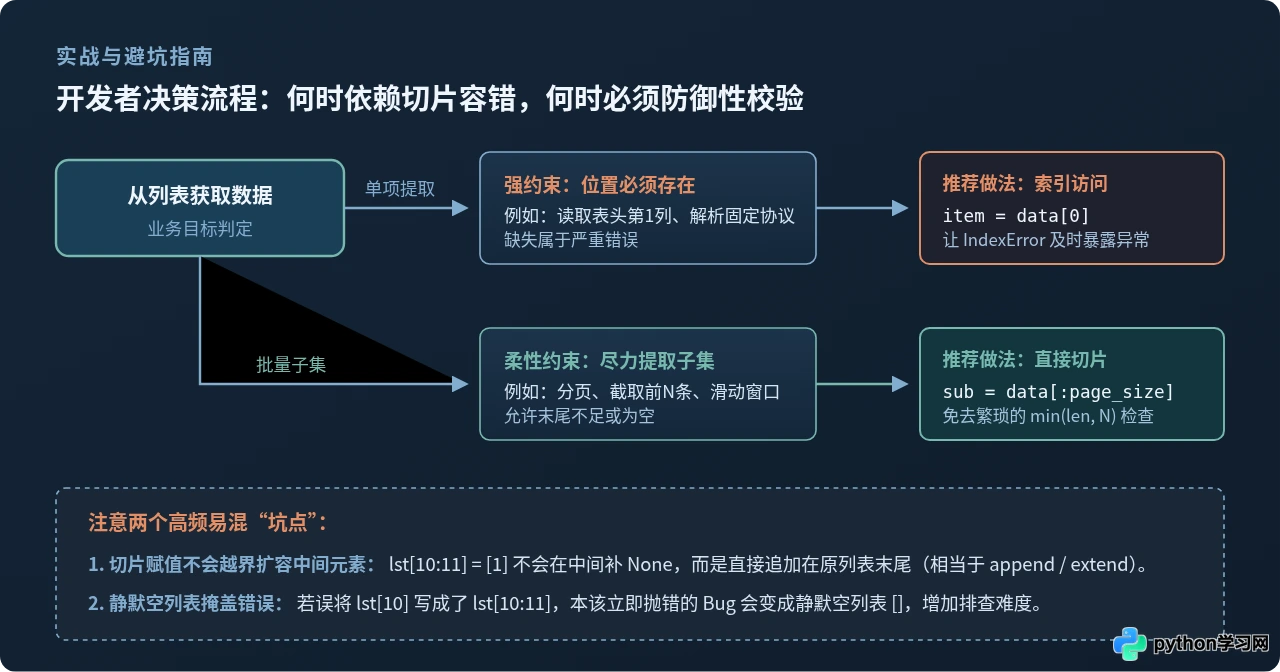
切片不报错虽然带来了便利,但在特定场景下也会成为掩盖 Bug 的元凶。开发者需要重点防范以下两点:
原本想取出列表的第一个元素并处理:
item = records[0](若为空列表立即崩溃排查)。如果误写成了 item = records[0:1],此时 item 不仅不会报错,反而得到一个 []。如果后续代码是 if item:,逻辑会默默走入非预期分支,而不会有任何错误日志抛出。
切片除了能读,还能写。例如
a[10:20] = [99]。如果 a 原本长度只有 2,该语句不会在索引 2 到 9 之间填充 None,而是相当于 a.extend([99]),直接将新列表拼接在原序列末尾。这可能打破某些基于固定位置赋值的业务假设。
七、总结与特性对照表
通过前面的解析,我们可以将 Python 列表的这两种访问机制完整梳理对照如下:
| 特性维度 | 单元素普通索引 lst[i] |
范围切片 lst[start:stop] |
|---|---|---|
| 越界行为 | 立即抛出 IndexError |
自动截断裁剪,安全返回子列表或 [] |
| 核心语义 | 精确取单个对象指针 | 计算连续观察窗口与原序列的交集 |
| 底层函数 | list_item(严格范围断言) |
PySlice_AdjustIndices(坐标钳位规范化) |
| 坐标对象 | 格子实体内部槽位 | 格子之间的分割线(栅栏刻度) |
| 典型场景 | 协议解析、必选字段提取、强断言场景 | 数据分页、批处理窗口、文本截断、容错子集提取 |
归根结底,Python 列表切片越界不报错是经过精心推敲的语言设计:它通过数学上的区间交集语义与底层 C 语言的坐标钳位机制,在保障内存绝对安全的前提下,赋予了代码极高的通用性与表达力。理解了“单索引的严格”与“切片的宽容”,我们就能在需要精准捕获异常与需要高效容错处理的不同场景中,游刃有余地做出正确的选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















