


Python二进制模式与文本模式读写换行符的行为差异
深入解析Python文本模式与二进制模式在读写换行符时的底层行为差异、通用换行符机制(Universal Newlines)、跨平台CRLF/LF转换规律及实战避坑指南。
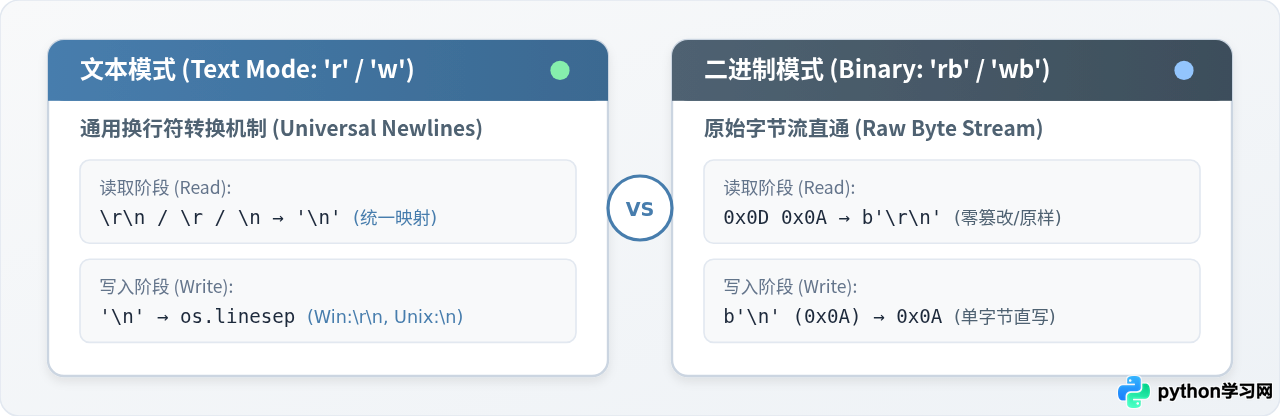
'r' / 'w')与二进制模式('rb' / 'wb')处理换行符的核心差异在于通用换行符转换机制(Universal Newlines):二进制模式直接在磁盘与程序之间透传原始字节流,不对任何字节做修改;而文本模式在默认情况下,读取时会将不同操作系统的换行符(
、 、
)统一替换为内部的
,写入时则将代码中的
隐式转换为当前宿主操作系统的默认换行符(Windows 下为
,Linux/macOS 下为
)。理解这一差异,是避免跨平台文件乱码、数据破坏以及 CSV 空行等常见故障的关键。
换行符的历史背景与底层存储
在计算机系统中,“换行”在底层由特定的 ASCII 字符表示。历史上,不同操作系统对行结尾字符序列的设计存在分歧:
- Unix / Linux / 现代 macOS:采用 LF(Line Feed,换行,ASCII 码
10,十六进制0x0A,Python 转义表示为 - Windows / DOS:采用 CRLF 序列,即 CR(Carriage Return,回车,ASCII 码
13,十六进制0x0D,转义为0x0D 0x0A,转义为 - 早期 Mac OS(OS 9 及更早版本):单独采用 CR(
0x0D,转义为
这种底层字节差异意味着同一个包含两行文字的文件,在 Windows 上保存为物理文件时比在 Linux 上多了 的物理字节。为了让开发者无需针对每一个操作系统编写专门的换行解析逻辑,Python 3 在文本模式中引入并完善了通用换行符转换机制。
双通道 I/O 架构:文本流与字节流的本质分工
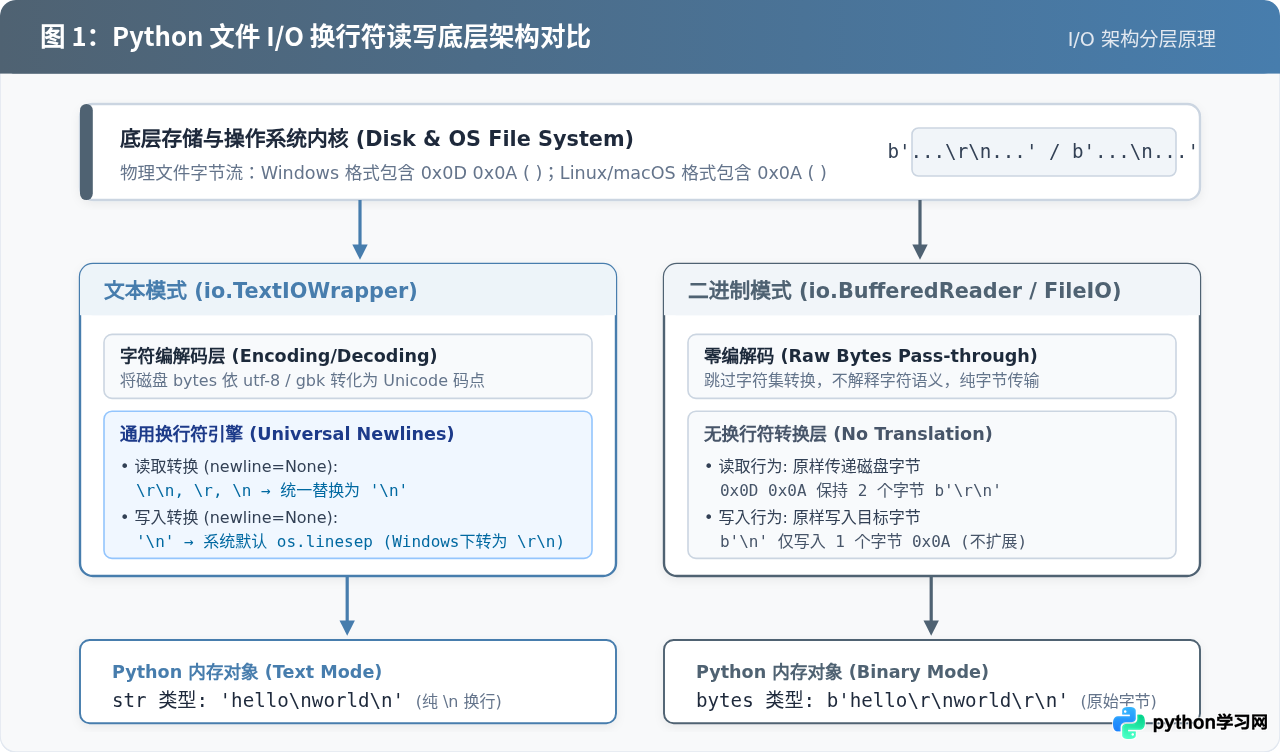
当通过内置函数 open() 打开文件时,Python 在底层依据 mode 参数构建完全不同的流对象体系:
- 文本模式(省略
'b'):底层构筑io.TextIOWrapper。这一层负责字符集编解码(如 UTF-8、GBK)以及通用换行符的动态转换。程序读取得到的是 Pythonstr(字符串),写入时也必须传入str。 - 二进制模式(带有
'b',如'rb'、'wb'):底层构筑io.BufferedReader或io.BufferedWriter。这一层直接对接操作系统的文件描述符,跳过所有编解码和换行符探测逻辑。程序读取得到的是原始bytes(字节串),写入时也必须传入bytes。
文本模式下的通用换行符机制 (Universal Newlines)
在 open(filename, mode='r', encoding=..., newline=...) 中,参数 newline 直接决定换行符的识别与转换策略。默认情况下 newline=None,它的具体行为如下:
1. 默认读取行为 (mode='r', newline=None)
Python 启用通用换行模式。输入文件流中出现的任何
、 或
,在被读入内存转换为 str 时,都会被统一替换为单独的
。文件对象同时会记录所遇到的换行符类型,存放在属性 f.newlines 中(若文件中同时存在多种换行符,该属性会记录一个包含多种换行符的元组)。
2. 默认写入行为 (mode='w', newline=None)
当向文件写入字符串时,代码中包含的任何
字符,都会被自动替换为宿主系统的默认行分隔符 os.linesep。在 Windows 操作系统中,写入的
会静默膨胀为
(磁盘上多出 0x0D 字节);在 Linux 和 macOS 上,系统默认换行符本就是
,因此字节保持不变。
3. 显式控制 newline 参数
Python 允许开发者显式指定 newline 参数以覆盖默认行为:
newline='':读取时开启通用换行符探测,但不进行任何替换,保留行尾的原生换行符(读取 Windows 文件将保留newline=' '或newline=' ':读取时仅将指定的字符串视为行结束符进行行切分,未被指定的换行符不被解析为行尾;写入时将所有的
二进制模式的“原样透传”特性
在二进制模式下('rb' / 'wb' / 'ab'),open() 函数不允许传入 encoding 与 newline 参数。如果尝试传入,Python 会立即抛出 ValueError: binary mode doesn't take an encoding/newline argument 异常。
二进制模式建立了一条无损的数据通道:
- 读取
b' ',内存中收到的就是两个连续字节0x0D 0x0A,长度为 2; - 写入
b'hello ',无论当前是在 Windows 还是 Linux 上运行,磁盘物理扇区中写入的永远是0x68 0x65 0x6C 0x6C 0x6F 0x0A,绝对不会被转换为
0x0A 的二进制数据。如果在 Windows 平台上使用文本模式打开或保存这些文件,所有的 0x0A 都会被自动篡改成 0x0D 0x0A,导致文件结构完全损坏无法打开。
4 步实验验证换行符转换行为
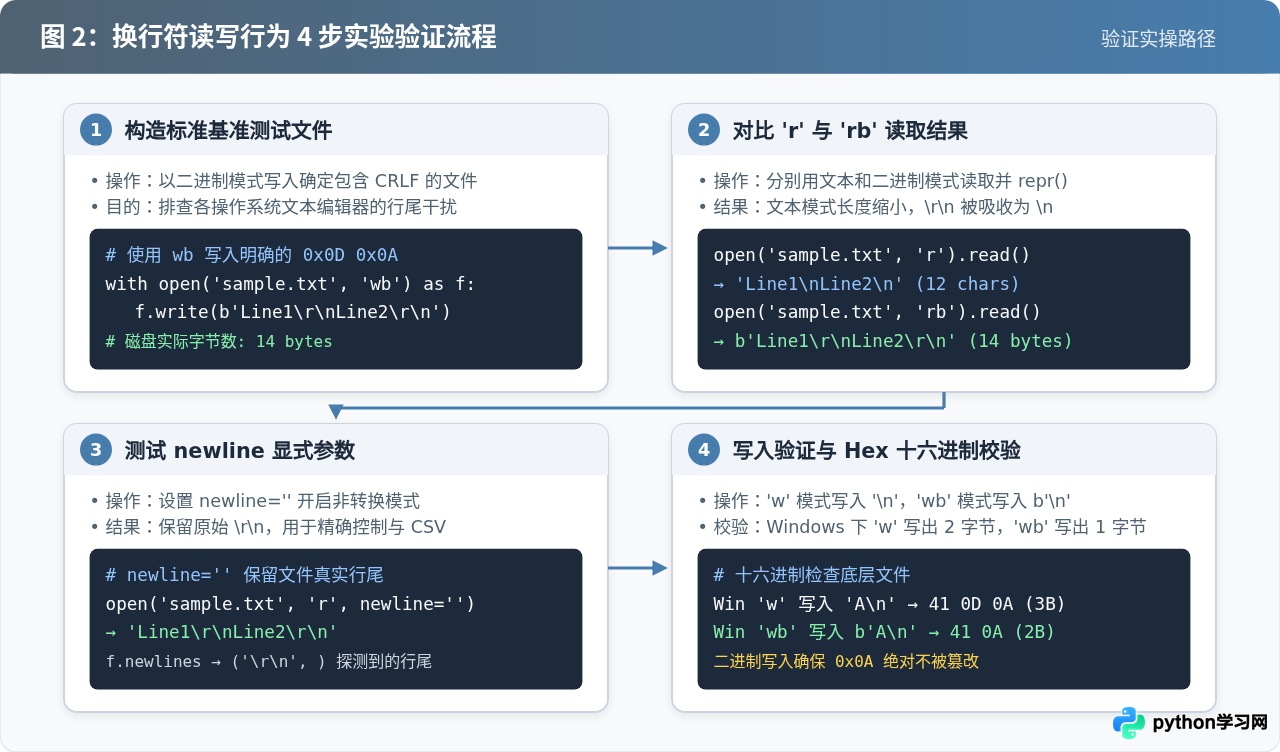
为直观检验文本模式与二进制模式的差异,我们可以通过一段自包含脚本完成实测验证。验证流程包含基准文件创建、读取对比、参数控制与物理字节检查 4 个关键阶段。
实验代码与步骤说明
# -*- coding: utf-8 -*-
import os
# 步骤 1:使用二进制模式生成确定的 CRLF 基准文件
benchmark_path = "crlf_sample.txt"
with open(benchmark_path, "wb") as f:
f.write(b"Alpha\r\nBeta\r\nGamma\r\n")
# 步骤 2:分别以文本模式和二进制模式读取
with open(benchmark_path, "r", encoding="utf-8") as f_text:
content_text = f_text.read()
detected_newlines = f_text.newlines
with open(benchmark_path, "rb") as f_bin:
content_bin = f_bin.read()
# 步骤 3:测试 newline='' 显式参数
with open(benchmark_path, "r", encoding="utf-8", newline="") as f_exact:
content_exact = f_exact.read()
# 输出检验结果
print("=== 步骤 2 & 3: 读取行为对比 ===")
print("文本模式 read() repr: ", repr(content_text))
print("文本模式字符长度: ", len(content_text))
print("文本模式检测到的行尾: ", detected_newlines)
print("二进制模式 read() repr: ", repr(content_bin))
print("二进制模式字节长度: ", len(content_bin))
print("newline='' read() repr: ", repr(content_exact))
# 步骤 4:写入行为与十六进制校验
with open("out_text.txt", "w", encoding="utf-8") as f_out_text:
f_out_text.write("Item\n")
with open("out_bin.txt", "wb") as f_out_bin:
f_out_bin.write(b"Item\n")
print("\n=== 步骤 4: 写入文件实际磁盘字节校验 ===")
with open("out_text.txt", "rb") as f_check:
raw_text_out = f_check.read()
print("文本模式写 'Item\\n' 实际字节: ", raw_text_out.hex(" "))
with open("out_bin.txt", "rb") as f_check:
raw_bin_out = f_check.read()
print("二进制写 b'Item\\n' 实际字节: ", raw_bin_out.hex(" "))
# 清理测试文件
for p in [benchmark_path, "out_text.txt", "out_bin.txt"]:
if os.path.exists(p):
os.remove(p)
=== 步骤 2 & 3: 读取行为对比 ===
文本模式 read() repr: 'Alpha\nBeta\nGamma\n'
文本模式字符长度: 18
文本模式检测到的行尾: \r\n
二进制模式 read() repr: b'Alpha\r\nBeta\r\nGamma\r\n'
二进制模式字节长度: 21
newline='' read() repr: 'Alpha\r\nBeta\r\nGamma\r\n'
=== 步骤 4: 写入文件实际磁盘字节校验 ===
文本模式写 'Item\n' 实际字节: 49 74 65 6d 0d 0a
二进制写 b'Item\n' 实际字节: 49 74 65 6d 0a
输出结果解读:
- 在步骤 2 中,磁盘上的 21 字节文件被文本模式读取后,变成了 18 个字符。原本的 3 个
0x0D和0x0A都清晰可见。 - 在步骤 3 中,指定
newline=''读取时,得到了 21 个字符的字符串'Alpha Beta Gamma ',证明通用换行符虽然能识别换行位置,但跳过了字符替换。 - 在步骤 4 中,Windows 环境下文本模式写入单字符
'Item '时,底层十六进制显式呈现为49 74 65 6d 0d 0a,即0x0D 0x0A;而二进制模式写入b'Item '时,十六进制严格为49 74 65 6d 0a,单字节0x0A得到保全。
跨平台读写行为对照矩阵
不同操作系统与不同打开模式的组合,对换行符的读写影响可以通过下表完整总结:
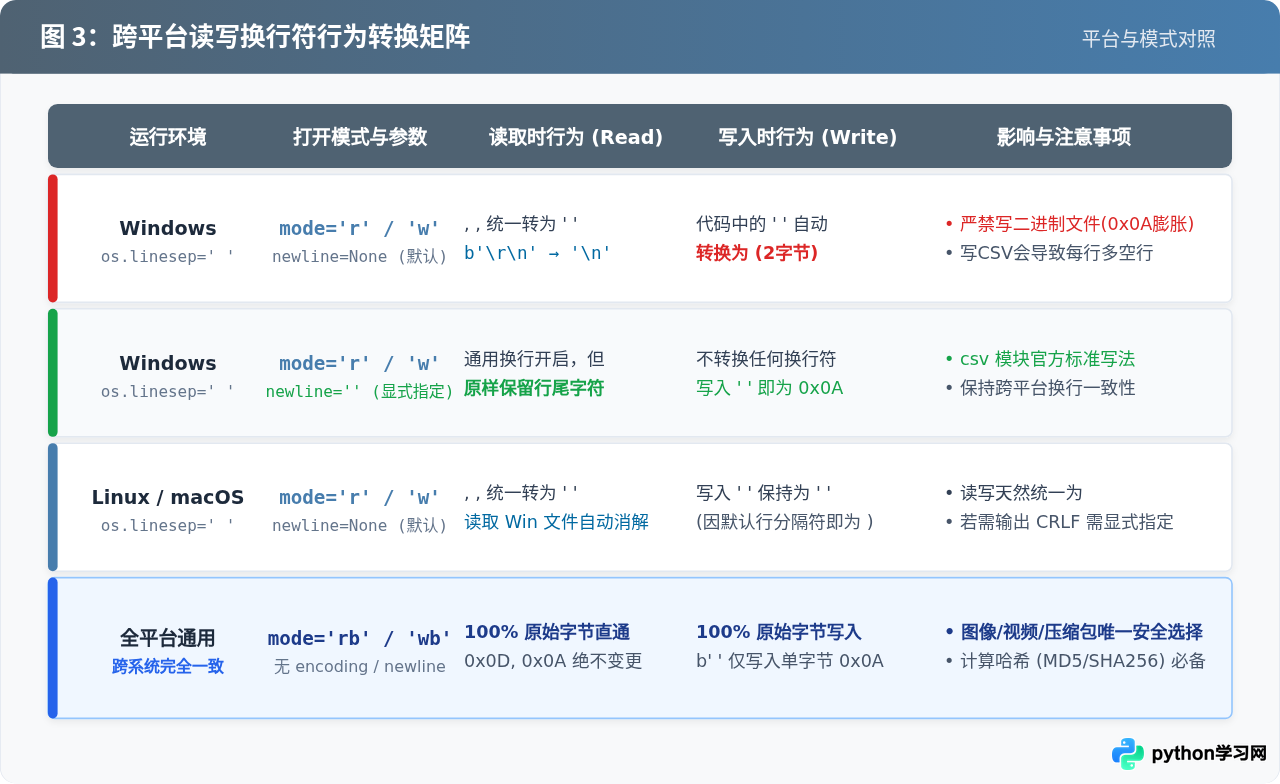
| 操作系统 | 打开模式与参数 | 读取行为 (Read) | 写入行为 (Write) | 典型应用场景与注意事项 |
|---|---|---|---|---|
| Windows | mode='r' / 'w'newline=None (默认) |
, ,
均转换为内存中的
|
内存中的
自动转换为磁盘上的
|
常规文本处理。严禁用于保存二进制数据,否则 0x0A 变成 0x0D 0x0A 导致损坏。 |
| Windows | mode='r' / 'w'newline='' |
识别换行但不转换,保留原本的
或
|
写入
保持为 0x0A,不做转义 |
CSV 文件读写标准模式。避免写入额外空行。 |
| Linux / macOS | mode='r' / 'w'newline=None (默认) |
, ,
均转换为内存中的
|
写入
保持为
(因系统默认即为
) |
读取来自 Windows 的 CRLF 文本时自动净化为
,输出自然遵循 Unix 习惯。 |
| 全平台通用 | mode='rb' / 'wb'(禁止传 newline) |
原样读取原始字节,不检查亦不改变 0x0D / 0x0A |
原样写入原始字节,写入 b'
' 严格占 1 个物理字节 |
多媒体、图像、PDF、压缩包、哈希校验唯一正确选择。 |
实际开发中的三大典型陷阱与解决方案
陷阱 1:Windows 下使用 csv 模块写入时产生多余空行
这是 Python 初学者在 Windows 平台上最常遇到的问题。标准库 csv.writer 在行尾默认使用
作为分隔符(通过 lineterminator='
' 参数控制)。如果在打开文件时使用了默认的文本模式(newline=None),那么 csv.writer 写入的
中的
又会被 Windows 文本模式额外转换一次,变成
。某些文本阅读器会将
渲染为多出一个空白行。
csv.reader 或 csv.writer 的文件时,始终传入 newline='':
import csv
# 正确示例:显式传入 newline=''
with open('data.csv', 'w', encoding='utf-8', newline='') as f:
writer = csv.writer(f)
writer.writerow(['ID', 'Name', 'Score'])
writer.writerow([1, 'Alice', 95])
陷阱 2:使用文本模式计算文件哈希导致跨平台校验失败
计算文件的 MD5 或 SHA-256 校验和时,必须对物理存储的字节流进行计算。如果误用文本模式读取字符串再通过 .encode('utf-8') 计算哈希,由于通用换行符机制在 Windows 上将
替换为了
,算出的哈希值会与原始文件不一致,更会导致 Windows 与 Linux 机器对同一文件算出不同的哈希。
'rb' 二进制只读模式:
import hashlib
def calculate_sha256(filepath):
hasher = hashlib.sha256()
with open(filepath, 'rb') as f:
while chunk := f.read(65536):
hasher.update(chunk)
return hasher.hexdigest()
陷阱 3:跨平台 Git 协作中代码行尾被无序污染
当自动化 Python 脚本负责修改跨平台代码仓库(例如批量给 Python、JavaScript 或 Markdown 文件追加头注释)时,如果运行在 Windows 上且使用了默认文本模式写入,会将整份代码文件原本的 LF 统一转换为 CRLF。这会导致 git diff 显示整份文件的所有行都被修改,破坏版本提交历史。
newline='' 获取真实内容,写入时显式指定目标行结束符(如 newline='
')。
总结与实战选型决策指南
在日常开发中,选择合适的文件模式和换行符参数可以遵循以下简明逻辑:
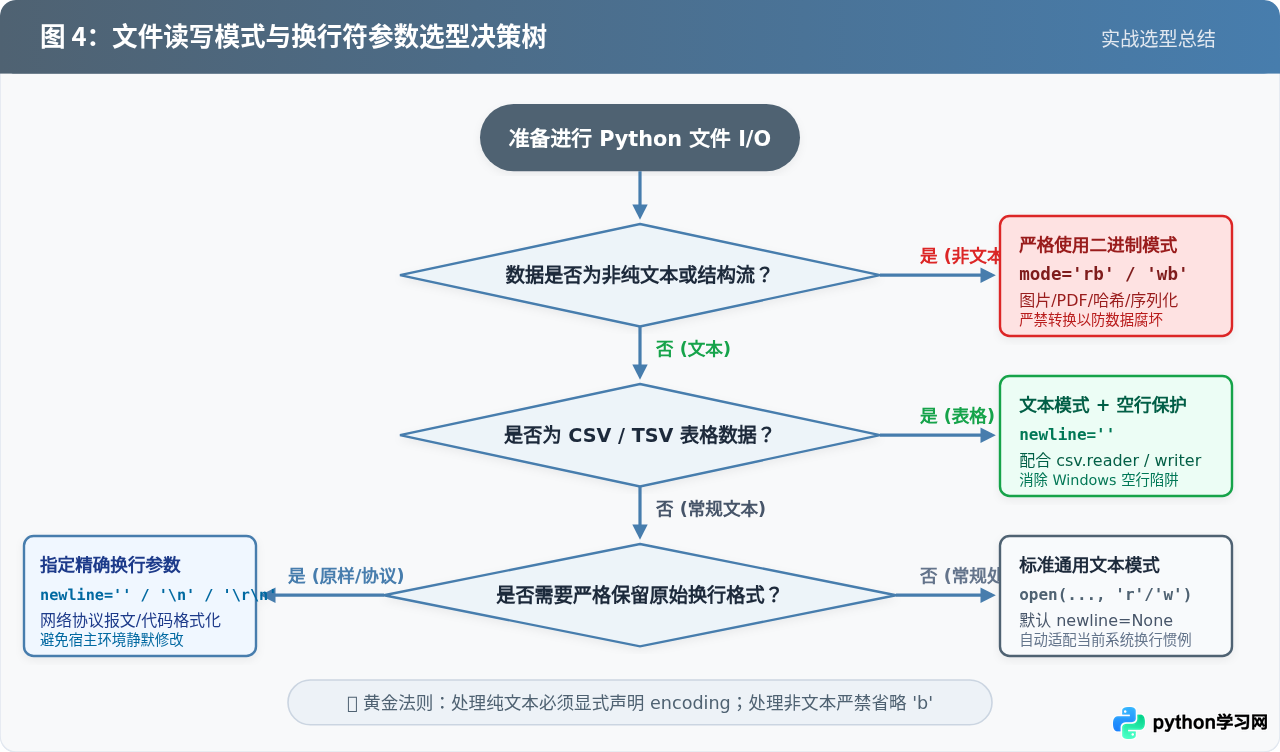
- 非纯文本数据(二进制数据):只要处理的文件类型包括图片、音视频、PDF、压缩包、Protobuf、Pickle 序列化对象或哈希校验,必须且只能使用二进制模式(
'rb'/'wb'),绝不可依赖文本模式。 - CSV / TSV 表格数据:使用文本模式,并且必须显式指定
newline=''和encoding='utf-8',彻底杜绝 Windows 空行问题。 - 严格跨平台网络协议与代码文件:若文件遵循明确的行尾标准(如 HTTP 协议头要求必须是
newline=' '或newline=' ',避免依赖宿主操作系统的默认值。 - 本地日志与常规纯文本:使用文本模式并保持默认的
newline=None,让 Python 自动将多平台的输入统一转换为encoding='utf-8'的良好习惯,避免 Windows 平台默认回退到 ANSI/GBK 编码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















