


Python 2 print重定向输出到文件的方法
详细解析Python 2中将print语句输出重定向到文件的核心方法,涵盖专有双大于号语法、sys.stdout流重定向、__future__模块函数化调用及终端重定向,并提供编码与缓冲区处理方案。
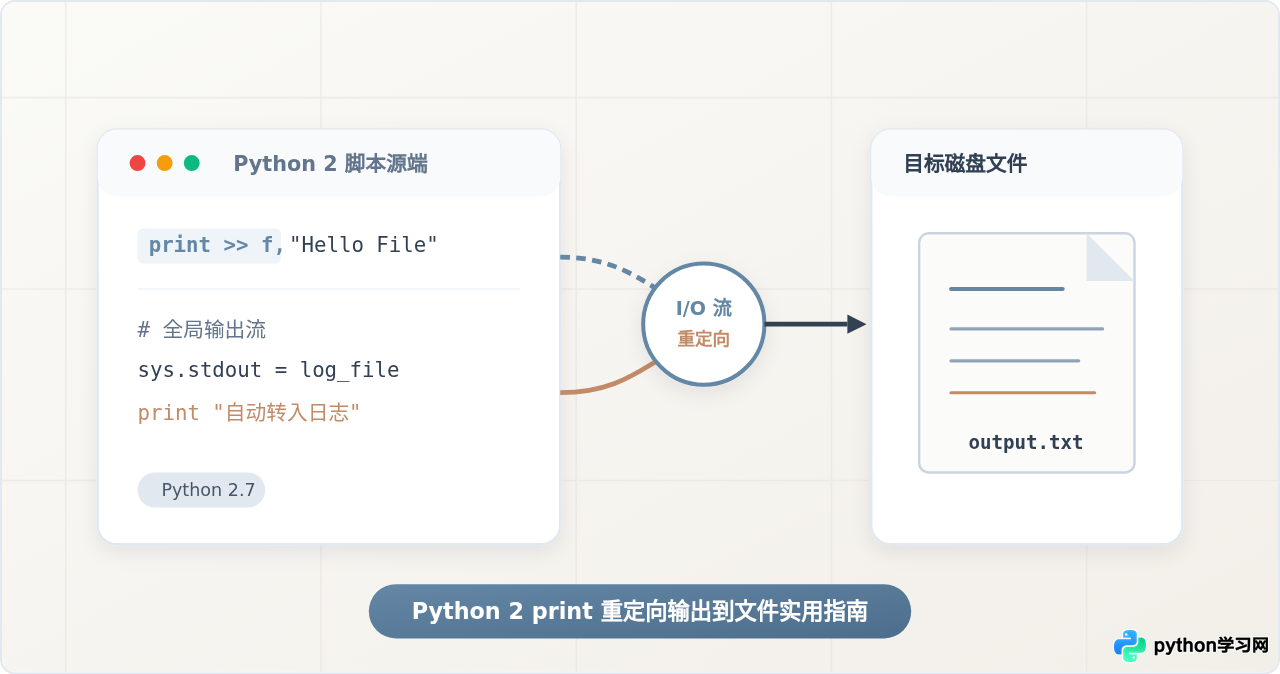
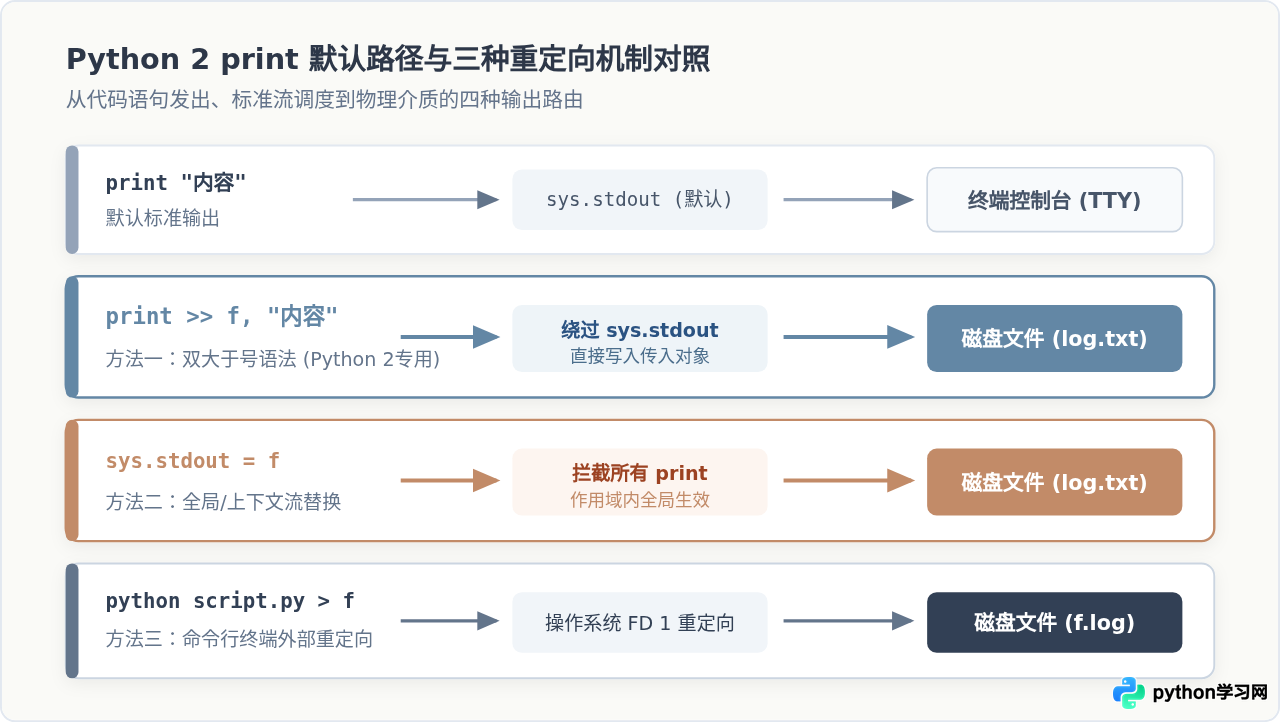
print 本质上是一条内置语句而非函数。要将其输出从默认的终端控制台(sys.stdout)转移写入到本地文件,主要有四种成熟可靠的技术途径:使用 Python 2 专有的双大于号语法(print >> f)、重置或替换 sys.stdout 标准输出流、通过 __future__ 引入现代 print() 函数,以及在终端执行时利用命令行重定向操作符。理解每种方法的生效边界、资源回收机制与缓冲区特点,能帮助开发者根据不同场景安全地记录数据与运行日志。
一、Python 2 专有的双大于号重定向语法(print >>)
Python 2 提供了一种非常直接且语法独特的重定向方式:在 print 关键字后紧跟两个大于号 >>,随后指定目标文件对象或具备 write() 方法的流对象。这种语法只影响当前这一行 print 语句,不会干扰程序中其他代码向控制台的常规输出。
1. 基础写入示例
下面是一个将文本写入文件的完整示例。在 Python 2.6 及 2.7 中,推荐使用 with 语句管理文件,确保文件在使用完毕后自动关闭:
# -*- coding: utf-8 -*-
# 打开文件并写入一行内容(覆盖模式)
with open('output.txt', 'w') as f:
    print >> f, "这是使用 print >> 语法输出到文件的内容"
    print >> f, "第二行:计算结果 =", 42 * 2
当执行上述代码后,当前目录下会生成 output.txt 文件,打开后可查看到两行由 print 自动追加换行符格式化后的文本内容:
[文件 output.txt 示例内容]
这是使用 print >> 语法输出到文件的内容
第二行:计算结果 = 84
2. 追加模式与抑制换行
如果需要将多批次输出累加到已有日志文件中,只需在 open() 时指定 'a'(append)模式。此外,若希望多次 print 内容保存在同一行中,只需在语句末尾加上半角逗号 , 即可抑制自动换行:
with open('output.txt', 'a') as f:
    for i in range(3):
        print >> f, i,  # 末尾逗号避免自动换行,以空格分隔各输出项
    print >> f, ""     # 打印空行完成最后的换行
3. 重定向到标准错误流
除了常规文件句柄外,>> 后面还可以接收任何具备 write() 接口的对象。例如在输出报警或错误信息时,常将其重定向到 sys.stderr:
import sys

# 将致命警告输出到标准错误流
print >> sys.stderr, "Error: 发生非预期异常,输出至错误流"
二、全局与上下文级别的 sys.stdout 流重定向
当程序中存在大量现成的 print 语句,或者需要调用某个无法修改源码的第三方模块并将其输出统一保存到文件时,逐行修改为 print >> f 是极不现实的。此时最有效的做法是直接接管全局的 sys.stdout。
1. 手动替换与复原 stdout
print 在没有显式指定输出目标时,底层会自动调用 sys.stdout.write()。因此,将 sys.stdout 指向一个打开的文件对象,后续所有的普通 print 就会自动流向该文件。
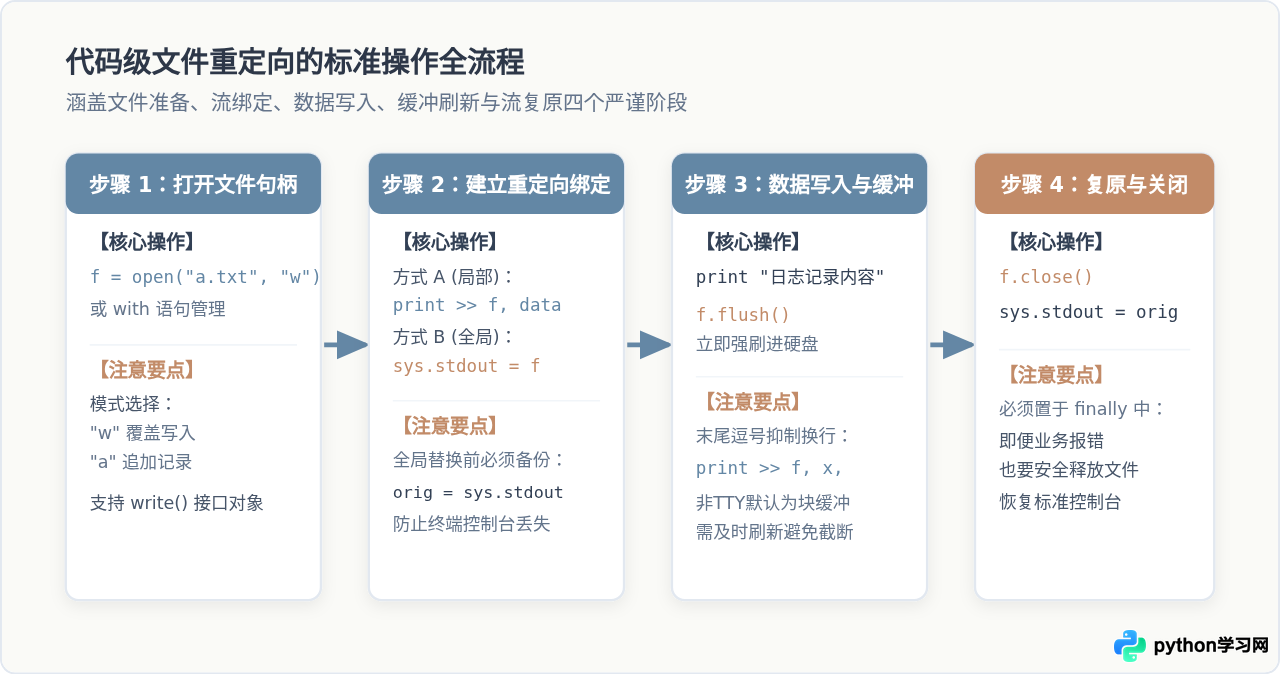
sys.stdout,整个运行环境后续的所有控制台输出都将被屏蔽。因此必须在修改前保留原始标准输出引用(通常在 sys.__stdout__ 或保存为变量),并在操作结束或发生异常时通过 try...finally 恢复。
# -*- coding: utf-8 -*-
import sys

# 1. 备份原始控制台标准输出
orig_stdout = sys.stdout

# 2. 打开文件准备写入
log_file = open('batch_log.txt', 'w')

try:
    # 3. 将标准输出重定向到文件对象
    sys.stdout = log_file

    # 4. 执行常规 print 语句(全部被写入文件)
    print "任务开始执行..."
    for step in range(1, 4):
        print "正在处理第 %d 个工作单元" % step
    print "全部任务完成。"
finally:
    # 5. 确保文件被冲刷并关闭,同时恢复标准输出
    log_file.flush()
    log_file.close()
    sys.stdout = orig_stdout

# 此时 print 已经恢复到控制台
print "控制台:文件记录已完毕,标准输出已恢复"
2. 编写优雅的上下文管理器(with 语法)
在实际工程中,为了避免手动书写繁琐的 try...finally 逻辑,可以通过 Python 的 contextlib 模块封装一个可复用的上下文管理器:
import sys
from contextlib import contextmanager

@contextmanager
def redirect_stdout_to(target_file):
    orig = sys.stdout
    sys.stdout = target_file
    try:
        yield
    finally:
        sys.stdout.flush()
        sys.stdout = orig

# 实际使用演示
with open('managed_log.txt', 'w') as f:
    with redirect_stdout_to(f):
        print "这行代码在上下文作用域内,输出写入文件"
    print "离开上下文作用域,输出重新回到屏幕终端"
三、面向现代兼容性的 __future__.print_function 方法
在 Python 2.6 和 Python 2.7 版本中,官方提供了向 Python 3 平滑过渡的特性。通过导入 print_function 特性,print 会从语法关键字转换为一个内置函数,从而可以使用 Python 3 规范的 file=... 命名参数。
1. 引入与使用规范
from __future__ import print_function 必须放置在 Python 脚本除注释与文档字符串之外的最开始第一行有效代码处:
# -*- coding: utf-8 -*-
from __future__ import print_function
import sys

# 使用函数形式将内容写入文件
with open('future_log.txt', 'w') as f:
    print("使用 __future__ 函数式输出", file=f)
    print("数值列表:", [10, 20, 30], sep=" | ", end="
", file=f)
这种做法的最大优势在于完全兼容 Python 3。如果当前维护的 Python 2 项目后续有升级迁移计划,优先采用此方式能够实现两代解释器下的无缝兼容运行,避免未来在升级到 Python 3 时遭遇 SyntaxError: invalid syntax 报错。
四、脚本外部的终端重定向与缓冲区处理
如果运行的 Python 2 脚本代码完全不允许修改,或者需要在运维调度(如 Linux Crontab、Shell 脚本)中快速捕获程序运行结果,直接在操作系统命令行使用 I/O 重定向操作符是标准的做法。
1. 常用命令行重定向操作符
python script.py > output.log:将脚本的标准输出以覆盖模式写入目标文件。python script.py >> output.log:将脚本的标准输出以追加模式写入目标文件。python script.py > output.log 2>&1:将标准输出(1)与标准错误(2)合并重定向到同一个文件中,避免遗漏崩溃堆栈。
2. 致命的“块缓冲”延迟与应对方案
很多开发者在执行终端重定向时会发现:程序明明已经在运行,甚至打印了日志,但查看目标文件却长时间为空,直到脚本完全退出后内容才突然出现。
这是由于 C 标准库及 Python 底层的 I/O 缓冲机制所致:
- 交互式终端(TTY):系统采用行缓冲(Line-buffered),每次输出换行符
- 非终端管道或文件:一旦标准输出被重定向到磁盘文件,Python 会自动切换为全缓冲(Block-buffered),通常需要积累满 4KB 或 8KB 字节后才会执行一次实际的磁盘写操作。
解决该问题的两种途径:
- 启动命令添加
-u参数:python -u script.py > output.log。-u(unbuffered)强制 Python 对stdin、stdout和stderr采用完全无缓冲模式,确保每一条print都能在发出瞬间落地到磁盘。 - 代码中周期性主动冲刷:调用
sys.stdout.flush()或文件句柄的f.flush()方法强制清空内存缓冲区。
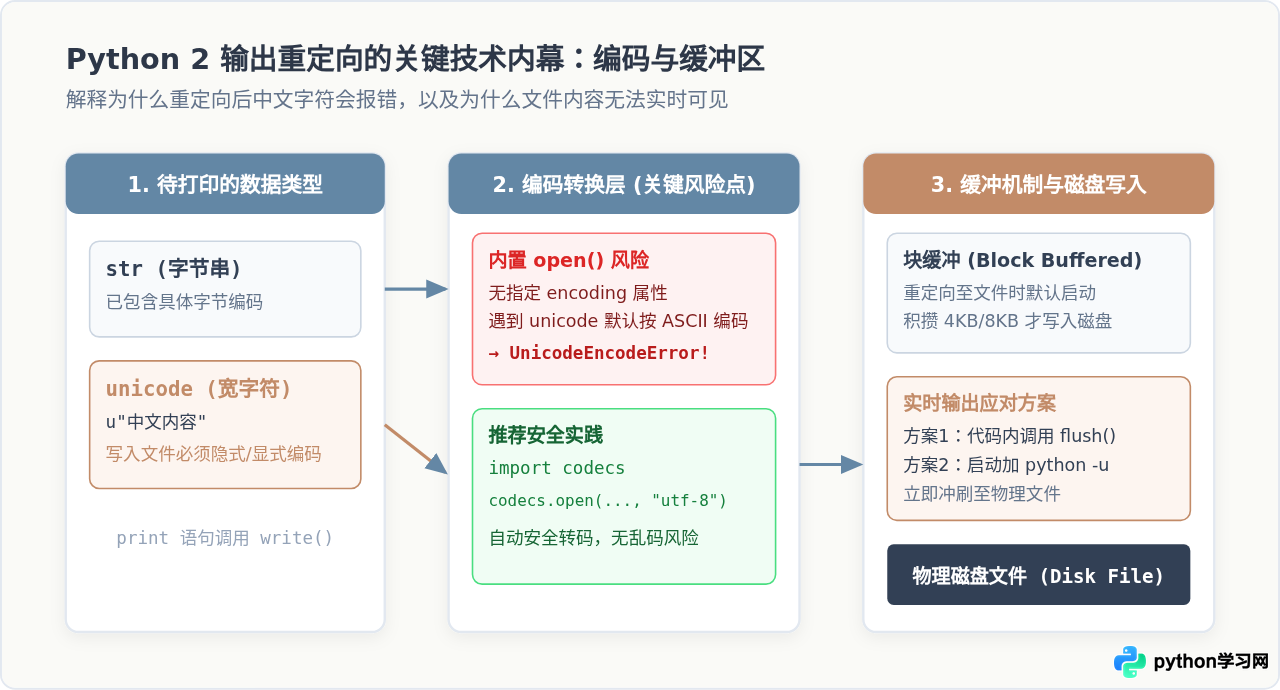
五、Python 2 重定向中的中文编码陷阱
在 Python 2 中,由于区分 str(原始字节序列)与 unicode(宽字符文本),在重定向至文件时极易发生经典且令人困惑的 UnicodeEncodeError: 'ascii' codec can't encode character...。
1. 报错产生的内在原因
在标准控制台下,Python 2 会根据操作系统终端的环境变量(如 LANG=zh_CN.UTF-8)将 sys.stdout.encoding 自动推断为 UTF-8。然而,当 sys.stdout 被重定向到磁盘普通文件或管道时,其 encoding 属性往往会退化为 None 或系统默认的 ascii。
当执行 print u"包含中文的 unicode 对象" 时,Python 2 发现目标流需要字节流,于是尝试调用系统默认的 ascii 编解码器对宽字符进行转换,进而引发报错中断。
2. 严谨的解决方案:使用 codecs 模块
在 Python 2 中处理带有中文等多字节字符的文件输出时,最稳健的做法是使用标准库内置的 codecs.open() 替代原生的 open():
# -*- coding: utf-8 -*-
import codecs

# 使用 UTF-8 编码明确打开目标流
with codecs.open('chinese_log.txt', 'w', encoding='utf-8') as f:
    # 无论是 unicode 还是跨版本字符串都能被正确无损写入
    print >> f, u"Python 2 核心中文内容:你好,世界!"
    print >> f, u"测试特殊字符:★■▲"
六、重定向方案对比与决策建议
针对不同的工程诉求,下表横向梳理了四种主要重定向方式的适用维度与特性:
| 重定向方案 | 修改代码范围 | 对其他输出的影响 | Python 3 兼容性 | 推荐使用场景 |
|---|---|---|---|---|
| print >> f, data | 仅目标语句 | 无影响(精确隔离) | 不兼容(Py3报语法错) | 纯 Python 2 遗留脚本的快速单点输出 |
| sys.stdout 替换 | 局部包装块 | 全局拦截(需手动复原) | 兼容 | 批量捕获既有函数/第三方模块的输出 |
| __future__ 导入 | 文件头部与语句 | 无影响 | 原生完美兼容 | 新编写或未来需要迁移至 Python 3 的项目 |
| Shell 命令行重定向 | 无需改动代码 | 全脚本标准流 | 不涉及语言差异 | 自动化调度、黑盒执行、批处理部署 |
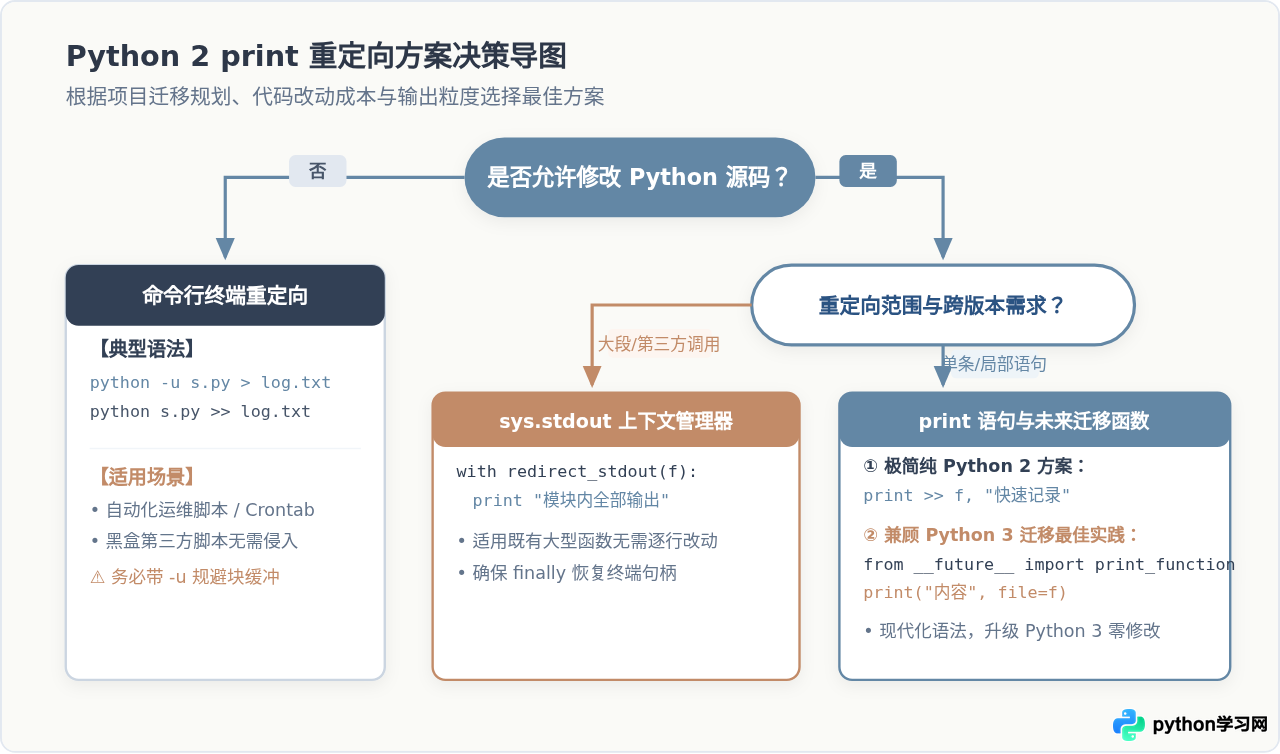
综上所述,在维护或编写 Python 2 代码时,如果仅需要快速向指定文件追加记录一两行状态,print >> f, data 是最为紧凑的手段;若面临庞大的存量代码,结合 contextlib 编写 sys.stdout 切换上下文能在零侵入业务逻辑的前提下完成输出重定向;而若项目处于向 Python 3 演进的生命周期中,采用 from __future__ import print_function 结合 codecs.open() 则能从根本上规避语法断裂与编码隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















