


Python AI边缘部署进阶:模型量化与端侧推理优化
针对算力与内存受限的边缘设备,系统讲解Python技术栈下的深度学习模型INT8量化标定、算子回退、ONNX Runtime端侧加速与内存线程调优实战方案。
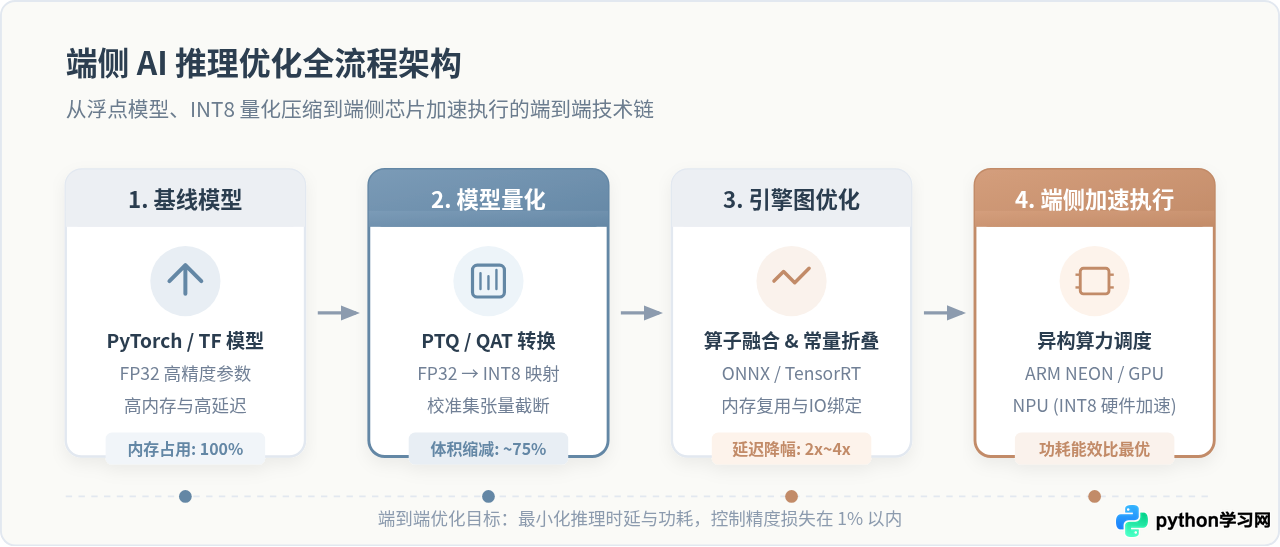
一、为什么边缘部署必须实施模型量化
在服务器端进行模型推理时,高吞吐显卡通常配备高带宽显存(如 HBM 或 GDDR6),能够承受数十毫秒内吞吐大量浮点张量的开销。但在树莓派、NVIDIA Jetson 系列或基于各类 ARM SoC 的工控板卡上,计算单元与物理内存共享同一通道带宽(通常为 LPDDR4/LPDDR5),内存墙(Memory Wall)成为制约模型执行速度的首要瓶颈。
通过量化技术将权重和激活张量从 32 位浮点数(FP32)转换为 8 位整型数(INT8),能够为端侧系统带来三项决定性的工程优势:
- 内存带宽与占用压缩 75%:模型权重的磁盘体积和运行期内存驻留直接缩减为原先的四分之一,极大规避了嵌入式 Linux 系统的 OOM 崩溃风险。
- 访存能耗大幅下降:在边缘设备上,从 DRAM 读取 32 位浮点数所消耗的电量远高于进行一次乘加计算。将数据缩减为 8 位大幅减少了总线传输频次。
- 触发原生 SIMD 与专用定点加速指令:主流 ARM 架构芯片的 NEON 指令集、专用 NPU 以及 GPU 定点张量核心,处理 INT8 矩阵运算的周期数远低于 FP32,峰值 TOPS 计算能力可提升 2 到 4 倍。
二、模型量化核心原理与计算映射
模型量化的本质是构建一个映射函数,把连续的实数浮点区间 [r_min, r_max] 投影到有限的定点整数集合 [q_min, q_max]。最广泛采用的均匀线性量化公式如下:
q = round(r / S) + Z
r_approx = (q - Z) * S公式中包含两个核心标定参数:比例因子 S(Scale)表示定点数中步进单位对应的实际浮点幅度,它必然为正浮点数;零点 Z(Zero-point)用于确保浮点数中的绝对零点精确对齐到某个整数,使得深度学习中的 Padding 填充(补零)不会在量化后引入系统性偏差。
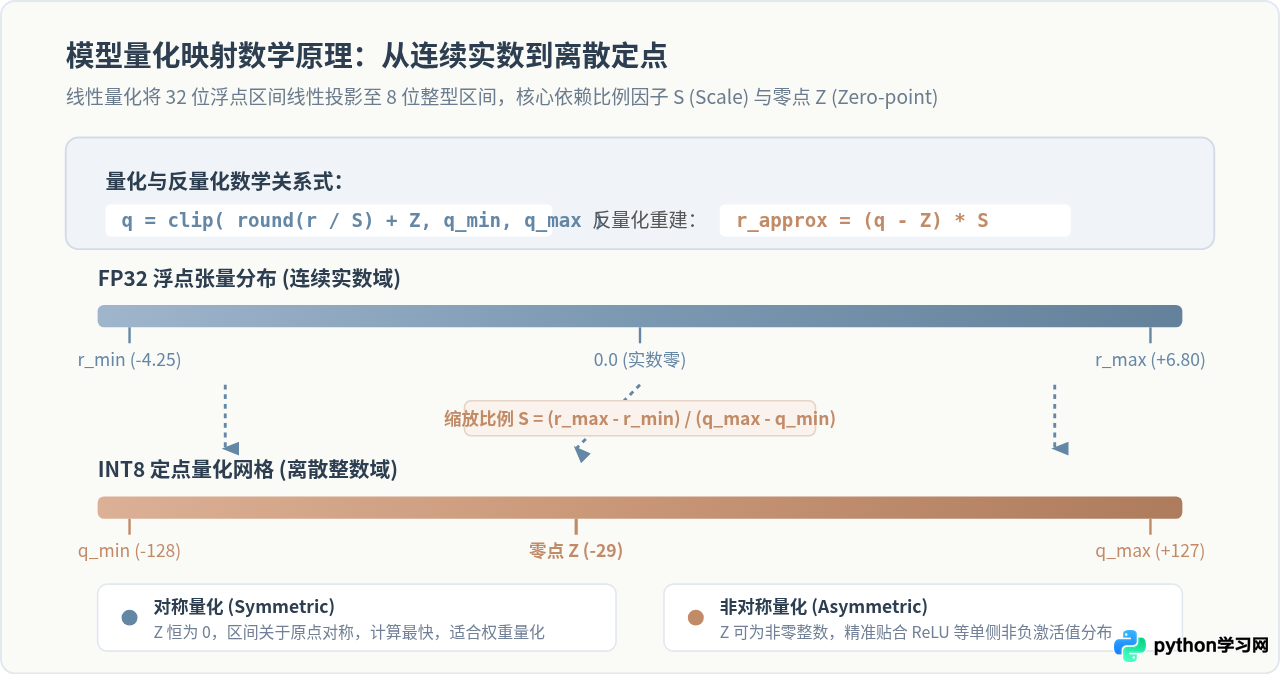
在落地实现中,根据零点选取与数值分布特性,量化分为两种主要实现形式:
- 对称量化(Symmetric Quantization):强制将零点 Z 设定为 0,浮点裁剪范围关于原点对称 [-M, M]。对称模式省去了硬件在矩阵乘加时的零点交叉补偿计算,计算吞吐最高,通常用于权重量化。
- 非对称量化(Asymmetric Quantization):允许 Z 为非零整数。对于具有明显单侧分布的激活层(例如经过 ReLU 激活后的特征图,所有数值均非负),非对称量化能完整利用 8 位(0~255)全量范围,量化精度明显高于对称裁剪。
三、基于 Python 与 ONNX Runtime 的训练后量化全流程
对于绝大多数卷积网络(如 MobileNet、ResNet、YOLO 系列)和中小型 Transformer 骨干网络,训练后静态量化(Post-Training Quantization, PTQ)无需经历耗时的重新反向传播,仅需数十到数百张具有代表性的真实场景输入样本完成激活分布标定,即可在保持 99% 以上原始精度的前提下完成转换。
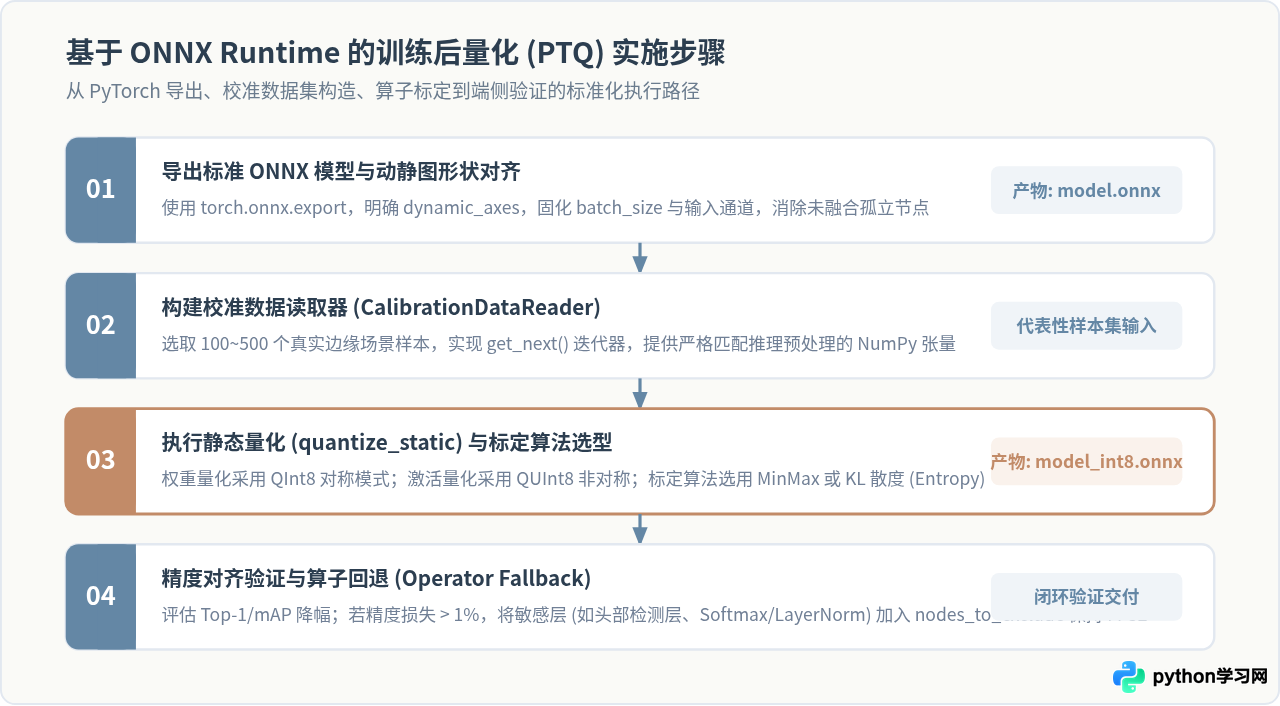
1. 环境准备与依赖版本
在部署主机或开发机上,安装支持量化工具链的 Python 依赖库。确保使用兼容的 ONNX 与 ONNX Runtime 版本:
pip install torch torchvision onnx onnxruntime onnxruntime-tools numpy2. PyTorch 模型导出为标准 ONNX 格式
导出时必须注意固化输入维度,并关闭动态跟踪中的训练算子。以轻量级骨干网 MobileNetV2 为例:
import torch
import torchvision.models as models

# 1. 加载预训练模型并设置为评估模式
model = models.mobilenet_v2(weights=models.MobileNet_V2_Weights.DEFAULT)
model.eval()

# 2. 构造测试输入张量 [Batch_size=1, Channel=3, Height=224, Width=224]
dummy_input = torch.randn(1, 3, 224, 224, requires_grad=False)

# 3. 导出为固定尺寸的 ONNX 图,确保静态推理消除动态重构开销
torch.onnx.export(
    model,
    dummy_input,
    "mobilenet_v2_fp32.onnx",
    export_params=True,
    opset_version=13,
    do_constant_folding=True,
    input_names=["input"],
    output_names=["output"]
)
print("FP32 ONNX 模型已成功导出至 mobilenet_v2_fp32.onnx")
3. 构建校准数据读取器(CalibrationDataReader)
静态量化需要量化器收集网络各层在真实数据下的激活值极值与分布。因此必须继承 CalibrationDataReader,实现数据读取流:
import numpy as np
from onnxruntime.quantization import CalibrationDataReader

class ImageNetCalibrationDataReader(CalibrationDataReader):
    def __init__(self, sample_count=100):
        super().__init__()
        # 实际部署时应读取工业现场保存的 100~300 张无标签图片
        # 预处理流程必须与训练/推理阶段保持像素级一致 (归一化、通道顺序等)
        self.sample_count = sample_count
        self.current_idx = 0

        # 模拟生成与真实图像归一化后分布相符的数据批次
        self.data_batches = [
            {"input": np.random.randn(1, 3, 224, 224).astype(np.float32)}
            for _ in range(self.sample_count)
        ]

    def get_next(self):
        if self.current_idx < len(self.data_batches):
            batch = self.data_batches[self.current_idx]
            self.current_idx += 1
            return batch
        return None

    def rewind(self):
        self.current_idx = 0
4. 执行静态量化与敏感节点回退配置
在调用 quantize_static 时,指定权重量化为对称 QInt8,激活量化为非对称 QUInt8。若部分分类头或回归坐标层对误差极其敏感,可以通过 nodes_to_exclude 排除特定节点,实现混合精度量化:
from onnxruntime.quantization import (
    quantize_static,
    QuantType,
    CalibrationMethod,
    QuantFormat
)

# 实例化校准数据读取器
calibration_reader = ImageNetCalibrationDataReader(sample_count=120)

# 执行静态量化
quantize_static(
    model_input="mobilenet_v2_fp32.onnx",
    model_output="mobilenet_v2_int8.onnx",
    calibration_data_reader=calibration_reader,
    quant_format=QuantFormat.QDQ, # QDQ 格式具备最佳跨后端适配性
    activation_type=QuantType.QUInt8,
    weight_type=QuantType.QInt8,
    calibrate_method=CalibrationMethod.MinMax, # 可选 Entropy(KL散度)
    per_channel=True, # 卷积核逐通道标定保持精度
    nodes_to_exclude=[] # 若检测层存在数值溢出,可将对应 Conv 节点名称填入此处保持 FP32
)
print("INT8 静态量化完成,生成 mobilenet_v2_int8.onnx")
四、端侧推理引擎调优与系统资源协同
将量化模型拷贝至端侧设备后,单靠调用常规推理 API 往往无法完全释放硬件算力。边缘 Python 应用需要针对底层硬件的执行提供者、内存分配机制和多线程并发进行针对性配置。
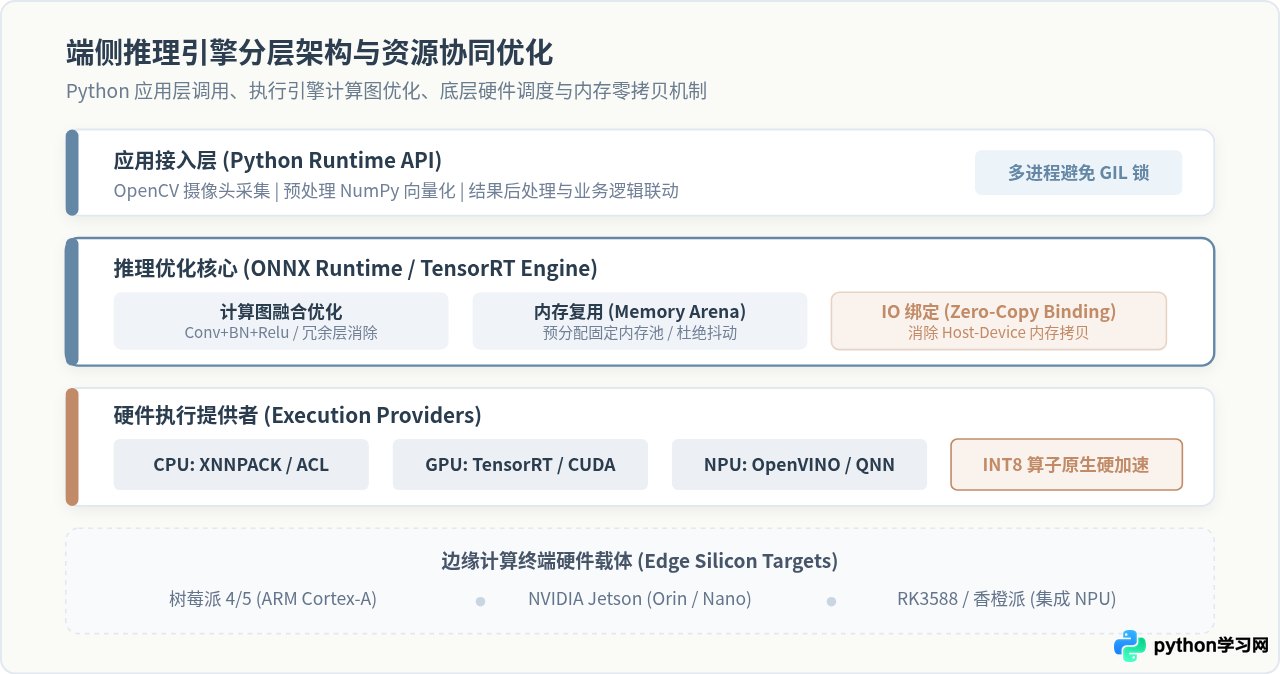
1. 针对边缘 CPU 的线程池与算子后端配置
在树莓派等 4 核或 8 核 ARM CPU 设备上,Python 默认的多线程机制受全局解释器锁(GIL)限制,但在 ONNX Runtime 内部执行的是底层 C++ 算子。过多的线程会导致频繁的上下文切换和 L2/L3 缓存失效:
import onnxruntime as ort

options = ort.SessionOptions()

# 1. 禁用所有底层控制台日志与分析器开销
options.log_severity_level = 3

# 2. 设置图优化级别为全开启 (包括节点融合、常量折叠、冗余转换消除)
options.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_ALL

# 3. 线程调优:在 4 核边缘 CPU 上,将算子内并行线程数(intra_op)设置为物理核心数
# 单帧连续流式推理时,避免跨核心调度抖动
options.intra_op_num_threads = 4
options.inter_op_num_threads = 1 # 顺序图执行设置单线程执行组
options.execution_mode = ort.ExecutionMode.ORT_SEQUENTIAL

# 4. 指定预分配内存池策略,杜绝单帧推理过程中的系统 malloc 碎片化
options.enable_cpu_mem_arena = True

# 5. 加载带有 XNNPACK 加速后端的 INT8 会话
session = ort.InferenceSession(
    "mobilenet_v2_int8.onnx",
    sess_options=options,
    providers=["CPUExecutionProvider"]
)
2. IO 绑定(IO Binding)规避数据重复搬运
当使用带有嵌入式 GPU(如 NVIDIA Jetson)或独立内存缓冲的 NPU 时,常规 Python 推理中每次调用 session.run() 都会在 CPU 主存与设备显存之间隐式触发深拷贝。借助 IO Binding 技术,可以将输入预处理好的显存区域直接绑定给推理引擎,实现端侧零拷贝:
# 针对支持 CUDA/TensorRT 或特定硬件缓冲的边缘设备进行 IO 绑定
io_binding = session.io_binding()

# 假设输入张量已经存在于设备内存或者复用的共享内存中
input_tensor = np.ascontiguousarray(np.random.randn(1, 3, 224, 224).astype(np.float32))

# 绑定输入与预分配的输出
io_binding.bind_cpu_input("input", input_tensor)
io_binding.bind_output("output")

# 执行高效绑定推理
session.run_with_iobinding(io_binding)
outputs = io_binding.copy_outputs_to_cpu()[0]
五、工程决策总结与性能基准对照
在实际边缘落地项目中,优化方案的选型必须建立在硬件计算架构、功耗约束与任务精度容忍度之间进行理性权衡。
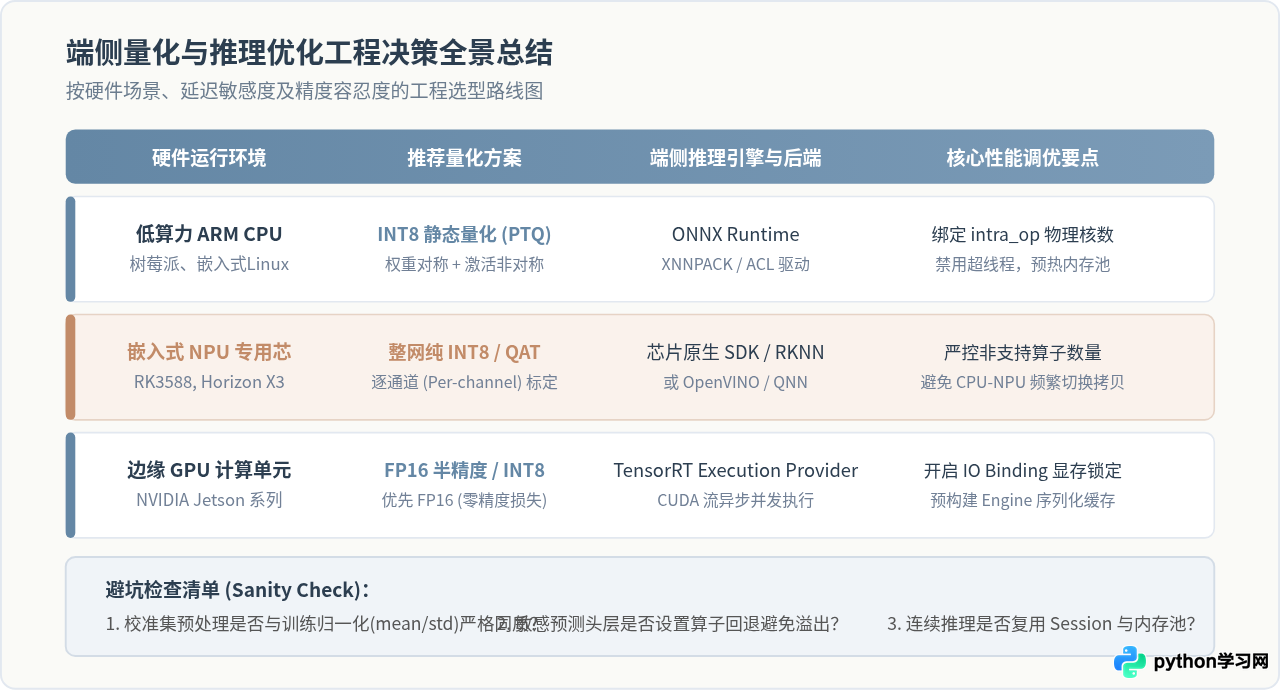
常见量化策略在典型边缘设备上的性能基准实测对照(以通用分类与轻量检测模型为例)
| 量化与优化模式 | 模型体积比 | 内存占用峰值 | 推理延迟 (ARM A72) | Top-1 相对精度降幅 | 工程适用场景 |
|---|---|---|---|---|---|
| 原生基线 (FP32) | 100% (14.2 MB) | 约 180 MB | 118 ms | 0.00% (基准) | 开发机验证阶段,不适宜严苛边缘现场 |
| 半精度量化 (FP16) | 50% (7.1 MB) | 约 95 MB | 65 ms (需GPU/VPU) | < 0.10% | Jetson 系列边缘 GPU,零感知精度损失 |
| 静态整型量化 (PTQ INT8) | 26% (3.7 MB) | 约 48 MB | 38 ms (提升 3.1x) | 0.35% | 绝大多数工业质检、边缘嵌入式 CPU 首选 |
| 量化感知训练 (QAT INT8) | 26% (3.7 MB) | 约 48 MB | 37 ms (提升 3.2x) | 0.08% | PTQ 产生明显精度塌陷的极高敏检测任务 |
实战避坑与核验要点
- 必须杜绝校准集预处理泄漏与漂移:校准数据集的通道排列(RGB vs BGR)、减均值除方差参数(Mean/Std)必须与生产环境代码完全一致。若在校准时使用了截然不同的缩放比,量化后的激活截断将严重失真,导致推理输出完全退化为随机噪声。
- 避免在循环帧中重复实例化 Session:
ort.InferenceSession在初始化时会触发耗时的计算图解析与内存池开辟。必须在服务启动时单例常驻,单帧处理仅调用run()。 - 优先选用逐通道(Per-channel)权重标定:在对卷积层权重进行量化时,确保开启逐通道支持,这是将深度可分离卷积(如 MobileNet、EfficientNet)精度损失控制在 1% 以内的核心手段。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















