


怎么使用pathlib模块处理Python文件路径
详细讲解如何使用Python内置的pathlib模块处理文件和目录路径。涵盖Path对象创建、路径属性拆解、斜杠拼接、目录遍历、文件读写及常见问题解决。
os.path 模块,开发者需要不断在字符串拼接、切片以及跨平台分隔符之间反复转换。Python 官方内置的 pathlib 模块从根本上改变了这一现状:它把文件系统路径抽象为面向对象模型,通过直观的斜杠运算符 / 和统一的 API,让路径操作兼具可读性、健壮性与跨平台一致性。本文将完整介绍 pathlib 的基础用法、核心属性、目录遍历及实战注意事项。
一、认识 Path 对象与基础路径构建
使用 pathlib 的第一步是从模块中导入 Path 类。Path 是该模块最核心的入口,当我们在代码中实例化 Path 时,它会根据当前操作系统自动选择具体实现:在 Windows 上实例化为 WindowsPath,在 Linux 或 macOS 上实例化为 PosixPath。
from pathlib import Path

# 1. 获取当前工作目录
current_dir = Path.cwd()
print(f"当前目录: {current_dir}")

# 2. 获取当前用户主目录
home_dir = Path.home()
print(f"用户主目录: {home_dir}")

# 3. 通过字符串或相对路径创建 Path 对象
project_path = Path("workspace/project/data.json")

# 4. 解析为规范绝对路径(同时解析符号链接)
abs_path = project_path.resolve()
print(f"绝对路径: {abs_path}")
通过 Path.cwd() 和 Path.home(),我们可以脱离繁琐的 os.getcwd() 与 os.path.expanduser("~")。更重要的是,创建出来的对象是一个真正的路径对象,而不是普通字符串,可以直接链式调用后续方法。
二、Path 对象的组成部分与属性拆解
日常开发中,我们经常需要获取文件名、纯文件名前缀、后缀扩展名或父级目录。在以往的 os.path 中,这需要配合 os.path.basename、os.path.splitext 与 os.path.dirname 进行多次切割。而在 pathlib 中,这些信息已经被解析为对象的直接属性。
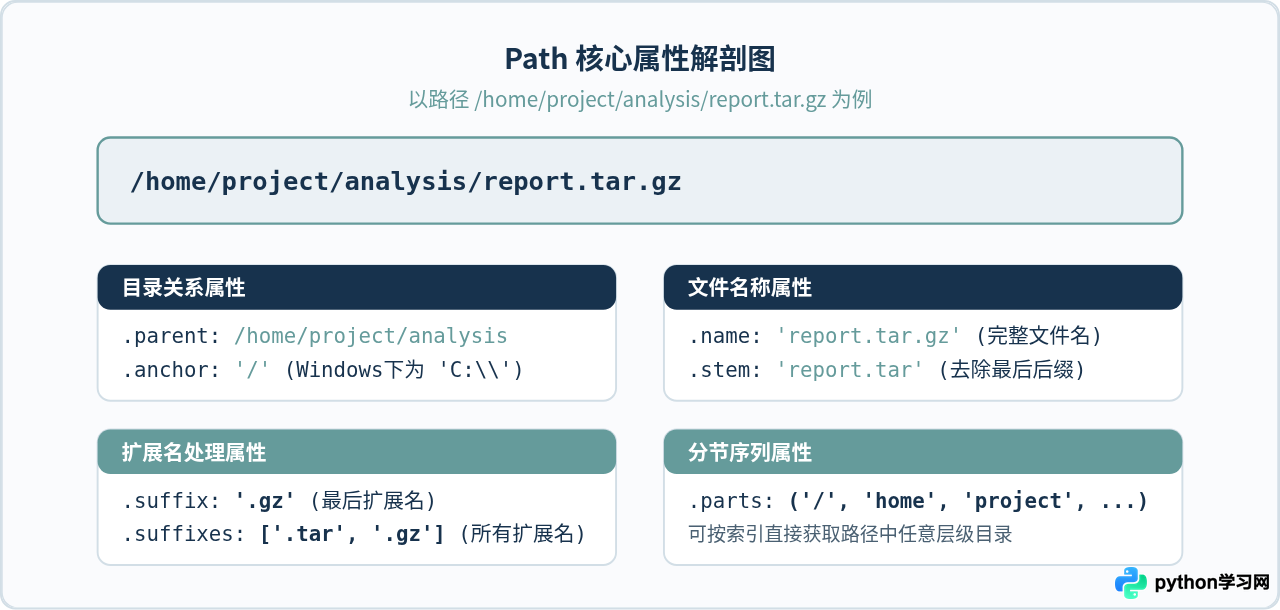
除了只读属性外,Path 还提供了两个非常实用的派生方法:
with_name(new_name):替换文件名并返回新的 Path 对象。例如p.with_name("new_report.csv")。with_suffix(new_suffix):修改或追加文件后缀。例如p.with_suffix(".zip")。如果传空字符串"",则代表去除后缀。
三、路径拼接:优雅的斜杠运算符
pathlib 最令人称道的设计之一是重载了除号运算符 /。只要左侧或右侧至少有一个是 Path 对象,就可以直接像写文件路径一样使用 / 拼接,不需要手动处理操作系统特定的路径分隔符。
base_dir = Path("/var/log")
app_name = "nginx"
file_name = "access.log"

# 使用 / 运算符进行直观拼接
target_file = base_dir / app_name / file_name
print(target_file)  # Linux输出: /var/log/nginx/access.log

# 也可以直接与字符串、子路径自由组合
archive_file = base_dir / f"{app_name}_backup" / Path("2026/10/archive.tar.gz")
print(archive_file)
这种写法比 os.path.join(base_dir, app_name, file_name) 更加简洁直观,且内部会妥善处理不同系统下的斜杠规范(如 Windows 下的反斜杠 \ 与 POSIX 下的正斜杠 /)。
四、目录遍历与文件模式匹配
在进行文件批处理时,我们经常需要查找某一类型的文件。pathlib 提供了三个核心遍历方法:
iterdir():列出当前目录下的所有直接子项(非递归,包含文件与文件夹)。glob(pattern):根据通配符模式匹配当前目录下的子项。rglob(pattern):递归检索所有子目录及多层嵌套目录下的匹配项。等价于glob("**/" + pattern)。
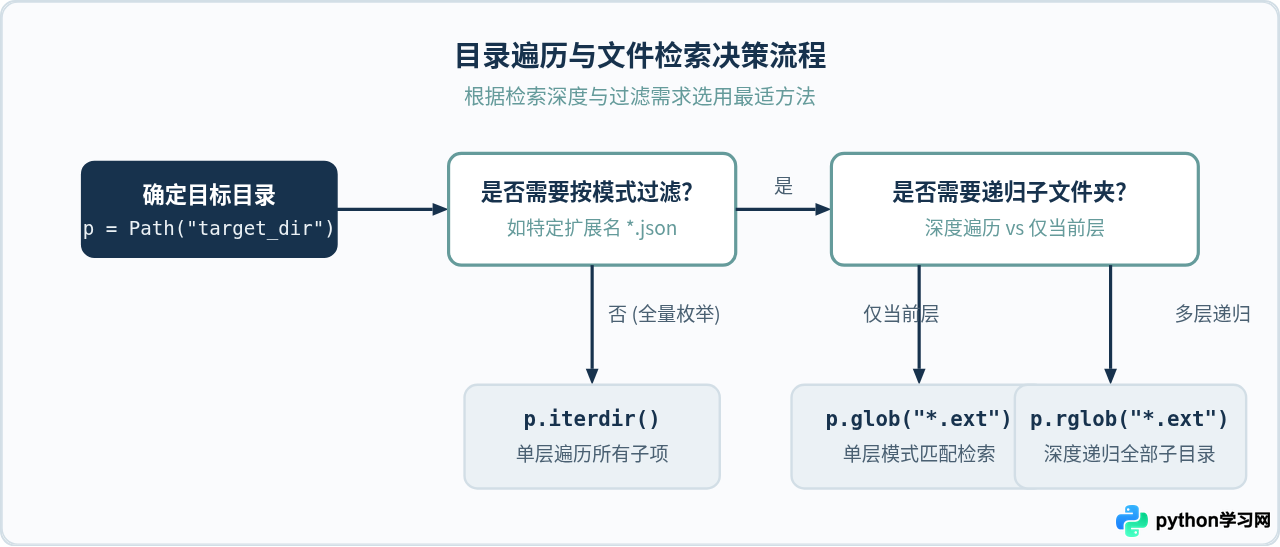
以下是使用这些方法的具体代码示例:
docs_dir = Path("./documents")

# 1. 遍历当前目录,筛选出普通文件并打印大小
for item in docs_dir.iterdir():
    if item.is_file():
        print(f"文件: {item.name}, 大小: {item.stat().st_size} 字节")

# 2. 递归查找所有 .py 源代码文件
python_files = list(docs_dir.rglob("*.py"))
print(f"找到 {len(python_files)} 个 Python 脚本")

# 3. 复杂通配匹配:查找所有以 test_ 开头的 Python 测试文件
for test_script in docs_dir.glob("test_*.py"):
    print(f"测试模块: {test_script.name}")
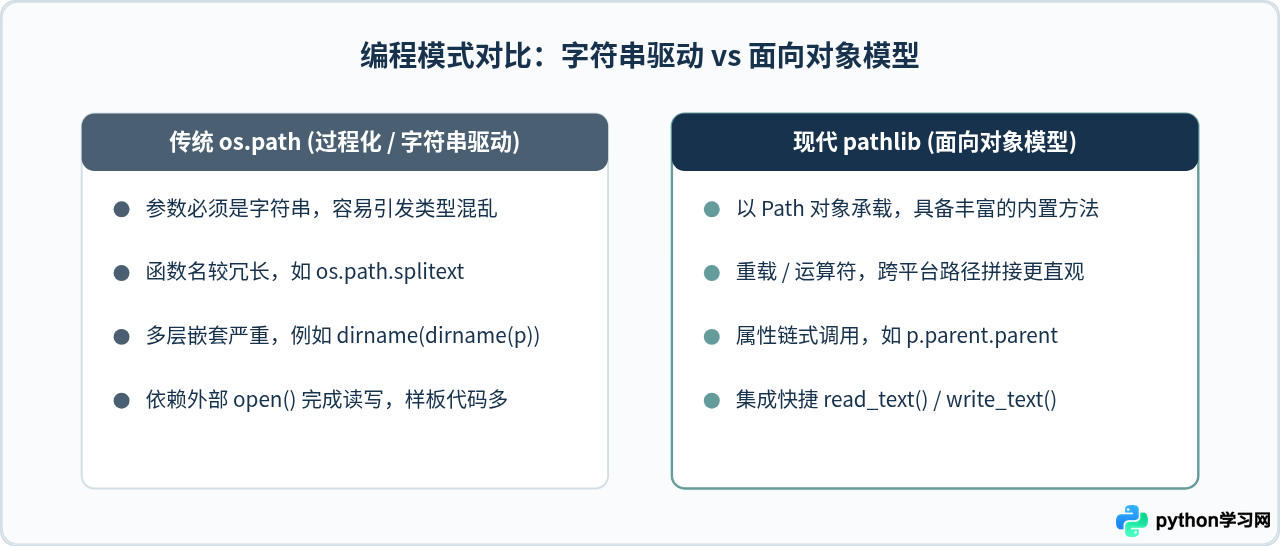
五、os.path 与 pathlib 的编程模式对比
为了帮助习惯了 os 与 os.path 的开发者快速过渡,下表总结了最常用的等价替换关系:
| 操作目标 | 传统 os / os.path 方式 | 现代 pathlib 方式 |
|---|---|---|
| 路径拼接 | os.path.join(a, b) |
a / b 或 a.joinpath(b) |
| 获取绝对路径 | os.path.abspath(path) |
path.resolve() |
| 提取文件名 | os.path.basename(path) |
path.name |
| 提取不带后缀名 | os.path.splitext(os.path.basename(p))[0] |
path.stem |
| 提取文件后缀 | os.path.splitext(p)[1] |
path.suffix |
| 获取父级目录 | os.path.dirname(path) |
path.parent |
| 检查存在性 | os.path.exists(path) |
path.exists() |
| 判断是否为文件 | os.path.isfile(path) |
path.is_file() |
| 判断是否为目录 | os.path.isdir(path) |
path.is_dir() |
| 创建多级目录 | os.makedirs(path, exist_ok=True) |
path.mkdir(parents=True, exist_ok=True) |
六、创建、读写与删除:一站式文件系统操作
pathlib.Path 不仅仅是路径描述工具,它还封装了许多常见的文件读写与目录维护操作,使常规任务无需手动打开文件句柄。
1. 安全创建目录
output_dir = Path("build/output/reports")

# parents=True 类似于 mkdir -p,递归创建缺失的父级目录
# exist_ok=True 避免目录已存在时抛出 FileExistsError
output_dir.mkdir(parents=True, exist_ok=True)
2. 便捷读写文本与二进制数据
针对中小文件的读写,pathlib 提供了极简的包装,内部会自动处理打开、写入或读取以及妥善关闭文件:
log_file = output_dir / "summary.txt"

# 一步写入文本内容,指定编码
log_file.write_text("状态: 运行正常\n耗时: 120ms\n", encoding="utf-8")

# 一步读取全文内容
content = log_file.read_text(encoding="utf-8")
print(content)

# 二进制读写对应 read_bytes() 与 write_bytes()
raw_bytes = log_file.read_bytes()
3. 文件与目录的删除
temp_file = output_dir / "temp.log"
if temp_file.exists():
    temp_file.unlink()  # 删除文件或符号链接

empty_dir = output_dir / "cache"
if empty_dir.exists():
    empty_dir.rmdir()   # 仅能删除空目录
七、常见注意事项与最佳实践
Path.rmdir() 遵循系统底层系统调用,无法删除非空目录。如果需要递归删除整个目录树,应配合标准库的 shutil.rmtree()。
尽管绝大多数现代 Python 标准库和第三方库(如
requests、pandas、open)都原生支持 Path 对象,但在极少数老旧接口中,仍可能要求纯 str 参数。此时使用 str(path) 或 os.fspath(path) 转换即可。
pathlib 还包含 PurePath(及其子类 PurePosixPath、PureWindowsPath)。Pure 路径只进行纯粹的字符串和语法计算,不执行任何实际的磁盘 I/O(不能调用 exists()、read_text() 等)。在 Linux 服务器上处理 Windows 格式的路径文本时,使用 PureWindowsPath 会非常有用。
八、核心功能总结全景
掌握 pathlib 只需要理清“构建-解析-检索-操作”四条主线。下图汇总了日常使用频率最高的关键 API:
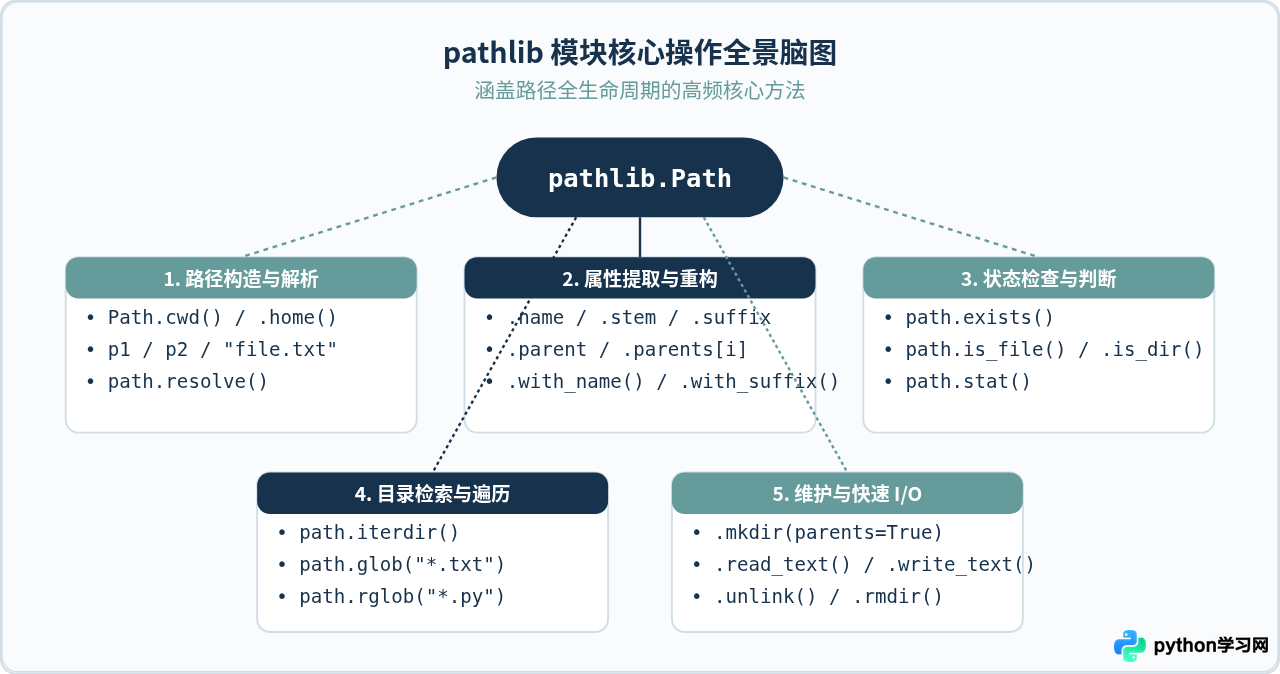
在编写现代 Python 代码时,强烈推荐将 pathlib 作为处理路径的首选方式。它不仅消除了不同操作系统间的分隔符差异,而且将分散的 os、os.path、glob 整合为统一的面向对象范式,能够显著提升代码的清晰度与可维护性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















