


怎么使用Python集合快速去除列表中的重复元素
详细讲解如何使用Python集合(set)快速去除列表中的重复元素,深入分析其两步转换流程、底层哈希原理、时间复杂度优势,以及不保序特性与不可哈希元素的处理策略。
在 Python 中去除列表中的重复元素,最直接、执行效率最高的方法是将列表转换为集合(set),然后再转换回列表:unique_list = list(set(raw_list))。集合在底层依靠哈希表实现,具备元素互异性与 O(1) 的平均查找插入速度,能够在 O(n) 时间复杂度内完成去重。本文将介绍该方法的具体操作步骤、底层哈希原理,并针对去重后顺序丢失和遇到不可哈希对象时的解决方案进行详细说明。
一、核心做法:两步类型转换法
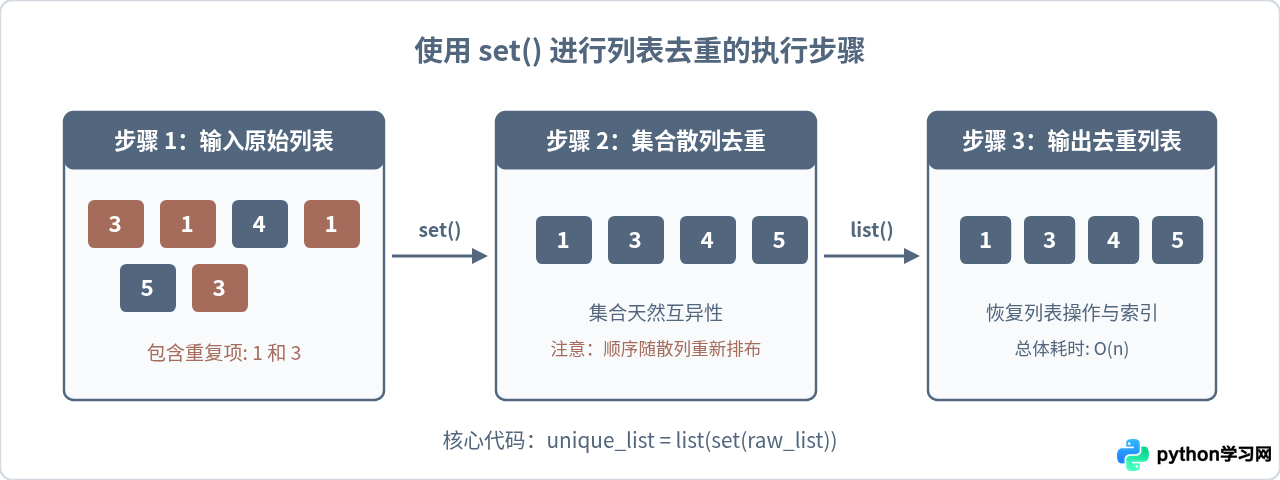
使用集合去重的核心逻辑只有两个步骤:第一步调用 set() 构造器将列表转为集合,由集合自动剔除重复项;第二步调用 list() 将去重后的集合重新封装为列表结构。
# 示例:通过 set() 对整数列表去重
raw_list = [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5]

# 执行去重
unique_list = list(set(raw_list))

print("去重前:", raw_list)
print("去重后:", unique_list)
# 示例输出:去重后: [1, 2, 3, 4, 5, 6, 9] (注意:元素排列顺序可能与原列表不同)在上述代码中,raw_list 中重复出现的数值 1、3 和 5 在转换为集合后均只保留了一份。转回 list 后,读者可以继续使用列表的索引切片、排序和追加等常规方法。
二、原理解析:为什么集合去重具备极高的执行效率
初学者容易尝试使用 for 循环配合 not in 判断来去重:
# 传统循环去重(不推荐用于大规模数据)
result = []
for item in raw_list:
    if item not in result:
        result.append(item)
这种循环写法虽然直观,但在每次执行 item not in result 时,Python 都会从头到尾线性扫描 result 列表(单次判断耗时 O(k))。当原列表长度为 n 时,总时间复杂度会上升至 O(n²),在数据量达到数万级别时运行速度会急剧下降。
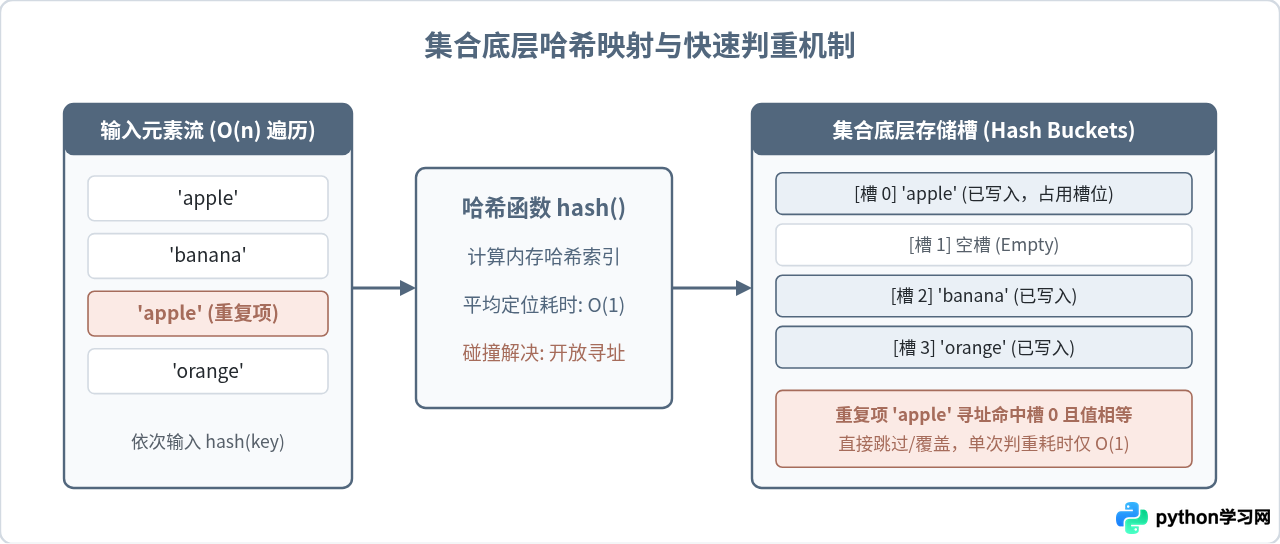
相比之下,集合(set)在 CPython 底层是基于哈希表(Hash Table)实现的。向集合中添加元素时,Python 首先调用对象的 hash() 方法获取哈希值,然后根据哈希值直接映射到对应的内存存储槽(Bucket)。由于哈希表的查找与定位平均只需 O(1) 的时间,因此即使列表包含数百万个元素,遍历并构建集合的整体耗时也仅为 O(n),效率呈数量级提升。
三、关键限制与两类常见问题
虽然 list(set(raw_list)) 非常高效,但在实际工程中使用时必须注意以下两处限制:
1. 元素原有顺序被打乱(无序性)
Python 集合并不维护元素的插入次序,其内部排列由哈希值和哈希表的扩容状态决定。如果你的业务逻辑要求去重后的列表必须保留元素首次出现的先后顺序,直接使用集合会导致顺序错乱。
保序方案:在 Python 3.7 及以上版本中,标准字典(dict)保证按照插入顺序存储键。因此,可以利用字典键的互异性来实现既保序又快速(O(n))的去重:
# Python 3.7+ 保留原始顺序的去重方式
raw_items = ["b", "a", "c", "b", "a"]

# 利用 dict.fromkeys() 保留插入顺序
ordered_unique = list(dict.fromkeys(raw_items))
print(ordered_unique)
# 示例输出:['b', 'a', 'c'] (严格保留首次出现的次序)
2. 列表包含不可哈希对象(Unhashable Types)
集合要求存入的所有元素都必须是可哈希对象(Hashable)。常见的数字、字符串、元组(tuple)都是可哈希的;但列表(list)、字典(dict)和集合(set)等可变类型不是可哈希对象。
# 错误示例:列表内包含子列表
nested_list = [[1, 2], [1, 2], [3, 4]]
# list(set(nested_list))
# 抛出异常:TypeError: unhashable type: 'list'
当列表中包含子列表或嵌套字典时,必须先将内部的可变结构转换为不可变对象(例如将内部子列表转为 tuple),或者使用自定义键遍历过滤:
# 解决嵌套列表去重:先将子项转为不可变元组
nested_list = [[1, 2], [1, 2], [3, 4]]
unique_nested = [list(item) for item in set(tuple(x) for x in nested_list)]
print(unique_nested)
# 示例输出:[[1, 2], [3, 4]]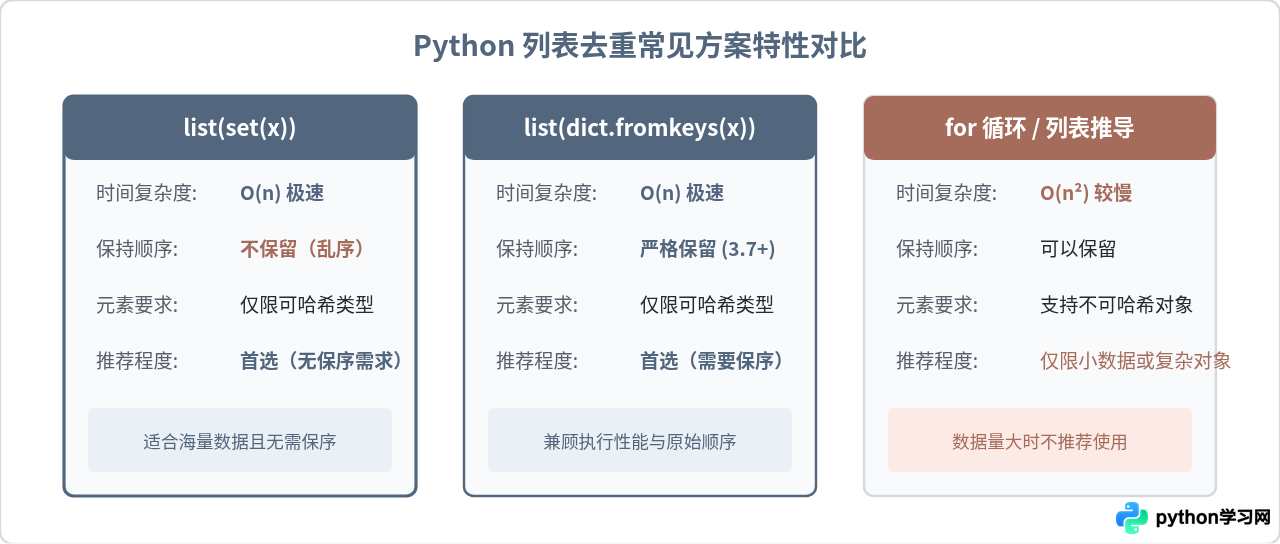
四、选型建议与决策总结
面对不同的业务场景,建议根据数据特性做出明确的技术选型:
- 常规去重,无需关心元素次序:直接使用
list(set(raw_list))。代码最精炼,执行速度快,内存消耗低。 - 要求保留元素原有的出现次序:首选
list(dict.fromkeys(raw_list))。在现代 Python 中同样具备 O(n) 的高效处理能力,且无任何乱序副作用。 - 元素包含嵌套列表或字典:先用推导式将内部可变结构序列化为元组(
tuple),再使用集合去重,避免触发TypeError。
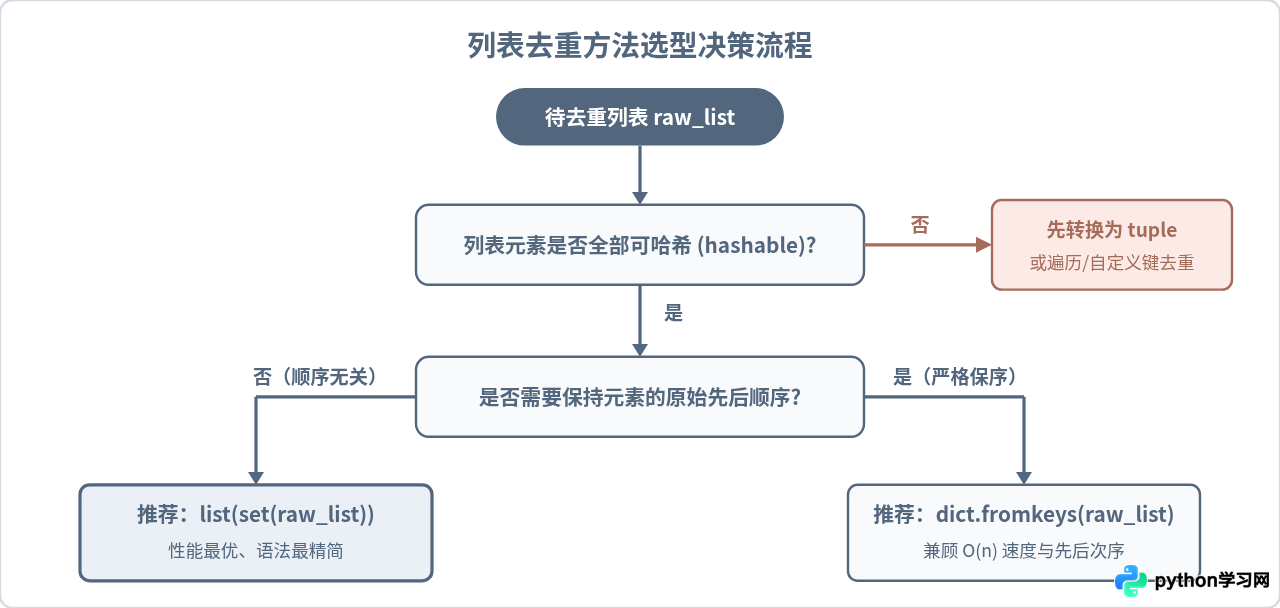
list(set(x)) 是 Python 中去除列表重复项的标准惯用法,也是处理无序去重性能最好的方式。在实际开发中,理解其底层的哈希特性不仅有助于写出高效代码,也能在遇到乱序或不可哈希异常时准确选择替代方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















