


Python字符串拼接的5种常用方法及代码示例
全面解析Python字符串拼接的5种常用方法:加号拼接、str.join()、f-string、str.format()及%占位符,结合完整代码示例、底层内存机制与场景选型决策指南。
在日常 Python 编程中,字符串拼接是出现频次极高的基本操作。然而,由于 Python 中的字符串(str)是不可变对象(Immutable Object),一旦在内存中创建就无法直接修改其字符序列。不同的拼接方式在底层内存分配、语法可读性以及执行开销上有着显著差异。编写不当的拼接代码,在处理海量数据时可能导致原本几毫秒的任务恶化至数秒甚至分钟级。
本文将围绕 5 种最常用的 Python 字符串拼接方法展开全面拆解:加号运算符(+ 与 +=)、str.join() 方法、格式化字符串字面值(f-string)、str.format() 方法以及经典 % 格式化操作符。不仅提供可直接运行的代码示例与输出结果,还将结合底层内存原理与决策流程,帮助你在实际开发中选出最契合的方案。
1. 加号运算符(+ 与 +=)—— 最直观的基础拼接
加号运算符是接触 Python 时最先学到的拼接手段。它的语义直观易懂:直接在两个或多个字符串之间使用 + 即可连接,或者使用 += 进行原地累加赋值。
代码示例
# 基础加号拼接示例
first_name = "Guido"
last_name = "van Rossum"

# 使用 + 拼接
full_name = first_name + " " + last_name
print("拼接结果:", full_name)

# 使用 += 累加
greeting = "Hello"
greeting += ", "
greeting += full_name
greeting += "!"
print("累加结果:", greeting)拼接结果: Guido van Rossum
累加结果: Hello, Guido van Rossum!
加号拼接的优点在于完全不需要记忆额外的函数名或特定占位符,在只有两三个固定字符串短片段的场景下非常简练。然而,加号拼接严格要求参与运算的两侧操作数必须都是 str 类型。如果尝试将整数直接与字符串相加,例如 "Count: " + 10,Python 会直接抛出 TypeError: can only concatenate str (not "int") to str,必须显式调用 str(10) 进行强转。
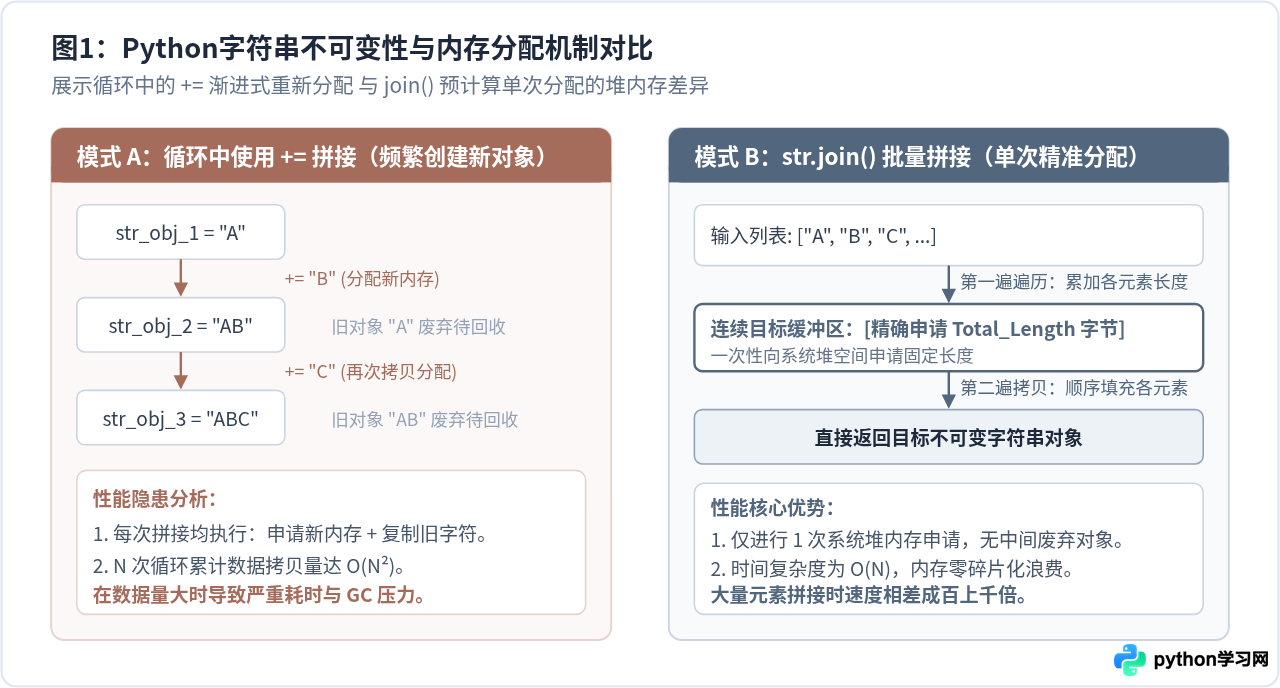
绝对不要在循环体内(特别是数千次以上的长循环)使用
+= 拼接字符串!因为 Python 字符串不可变,每次 += 都需要在堆内存中申请一块新空间,并将旧数据与新数据逐字节拷贝进去。循环 N 次时,累计数据搬运量会上升到 O(N²) 级别,导致严重的内存抖动与计算开销。
2. str.join() 方法 —— 大规模可迭代序列的高效解决方案
当需要将列表、元组、集合或生成器中的大量字符串连接为一个整体时,str.join() 是 Python 官方推荐的标准解决方案。该方法的语法逻辑为 separator.join(iterable),即由“连接分隔符字符串”作为调用主体,接收一个包含若干字符串元素的可迭代对象。
代码示例
# 1. 列表拼接
words = ["Python", "is", "concise", "and", "powerful"]
sentence = " ".join(words)
print("句子拼接:", sentence)

# 2. 路径与分隔符构建
parts = ["usr", "local", "bin", "python3"]
path_str = "/".join(parts)
print("路径拼接:", "/" + path_str)

# 3. 包含非字符串元素的转换拼接
scores = [95, 88, 76, 100]
# 先用 map 转换为字符串,再使用 join
scores_text = ", ".join(map(str, scores))
print("分数列表:", scores_text)句子拼接: Python is concise and powerful
路径拼接: /usr/local/bin/python3
分数列表: 95, 88, 76, 100
底层原理深度解析
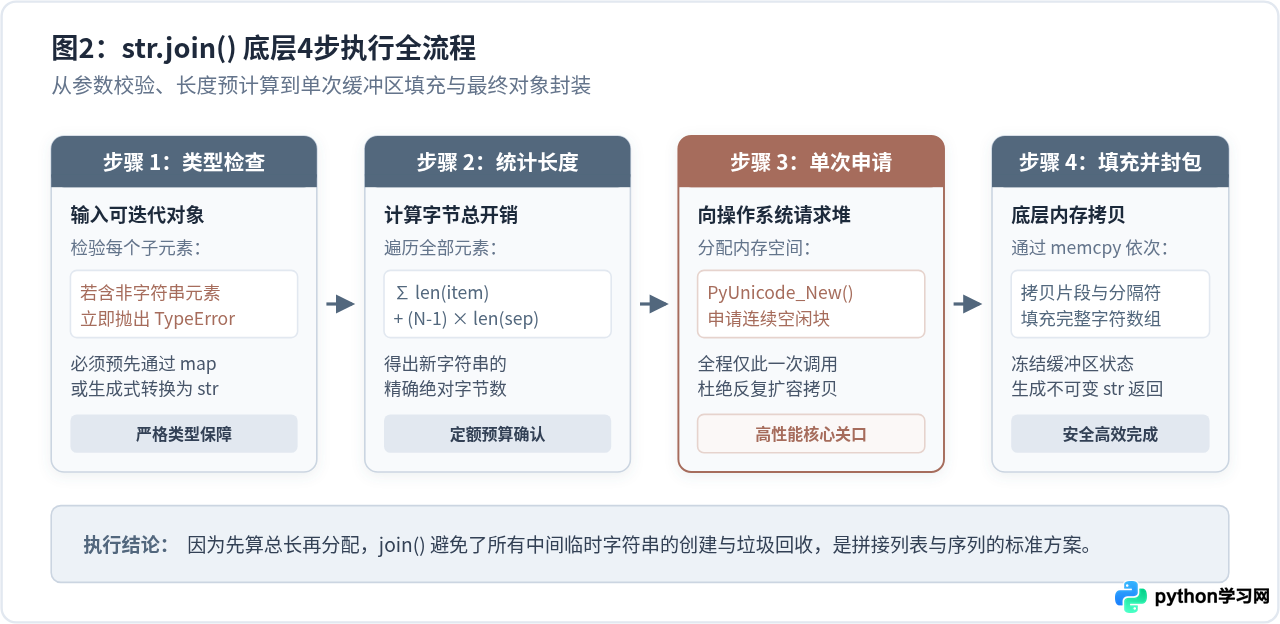
为什么 join() 在处理数万甚至数十万个元素时远快于加号?因为 CPython 在底层实现 join() 时采用的是两遍扫描算法(Two-pass Algorithm):
- 第一遍预计算:遍历整个可迭代对象,检查每个元素是否都是字符串类型(若不是则立即报错),同时快速累加所有子字符串的长度,加上
(N - 1) * 分隔符长度,精确计算出最终字符串的总字节数。 - 单次申请缓冲区:调用底层的
PyUnicode_New()向系统堆申请一块刚好容纳最终字符串的连续内存区域。 - 第二遍直接填充:利用高效的底层内存拷贝(如
memcpy)将每个字符串片段和分隔符依次复制到连续内存中,最终封装为单一不可变对象返回。
整个过程仅向内存管理器申请一次空间,时间复杂度稳定在 O(N),无中间废弃对象,不会给垃圾回收器(GC)造成额外压力。
3. 格式化字符串字面值(f-string)—— 现代 Python 首选方案
从 Python 3.6 开始引入的格式化字符串字面值(通常称作 f-string,PEP 498),彻底重塑了 Python 开发者处理字符串的方式。只需在字符串引号前加上前缀 f 或 F,便可在花括号 {} 中直接写入任意合法的 Python 表达式,解析器会在运行时自动求值并替换。
代码示例
name = "Alice"
role = "工程师"
experience = 5
salary = 15800.5

# 1. 基础变量插值与表达式运算
info = f"姓名: {name}, 职位: {role}, 工作年限: {experience}年, 明年工龄: {experience + 1}年"
print(info)

# 2. 格式化规范:浮点数保留两位小数、千分位、左侧补零
formatted = f"月薪标准: {salary:,.2f} 元, 员工工号: {42:0>6d}"
print(formatted)

# 3. Python 3.8+ 调试语法(打印 变量名=值)
width = 1920
height = 1080
print(f"分辨率详情: {width=}, {height=}")姓名: Alice, 职位: 工程师, 工作年限: 5年, 明年工龄: 6年
月薪标准: 15,800.50 元, 员工工号: 000042
分辨率详情: width=1920, height=1080
f-string 不仅仅是语法糖。在字节码层面,CPython 在编译阶段直接将 f-string 解构为高效的专用字节码指令(例如 FORMAT_VALUE 与 BUILD_STRING),其执行速度通常比 str.format() 快 2~3 倍,甚至略微优于 % 操作符。其可读性也是所有拼接方案中公认最高的,有效避免了长文本拼接中“变量与占位符位置错位”的经典 Bug。
4. str.format() 方法 —— 兼顾灵活性与模板复用
在 Python 2.6 和 3.0 中引入的 str.format() 方法,通过在模板字符串中使用 {} 作为插槽,再通过函数实参传入填充值。虽然日常变量拼接已被 f-string 大规模替代,但 str.format() 在一个关键场景下依然不可替代:模板与数据解耦。
如果你的字符串模板需要预先定义在配置文件中、从数据库加载、或者用于多语言国际化(i18n),此时变量在定义时尚不存在,无法直接写成 f-string。str.format() 允许先声明模板,后续按需多次注入不同数据。
代码示例
# 1. 预定义模板,后续多次复用
template = "尊敬的 {user},您的订单 {order_id} 已于 {status}。"

msg_1 = template.format(user="张先生", order_id="SN-20261030-01", status="已发货")
msg_2 = template.format(user="李女士", order_id="SN-20261030-02", status="派送中")
print(msg_1)
print(msg_2)

# 2. 位置索引与字典解包 (kwargs)
log_pattern = "[{level}] {timestamp} - {module}: {message}"
log_context = {
    "level": "INFO",
    "timestamp": "2026-10-30 21:42:00",
    "module": "payment_service",
    "message": "支付通道校验成功"
}
log_line = log_pattern.format(**log_context)
print(log_line)尊敬的 张先生,您的订单 SN-20261030-01 已于 已发货。
尊敬的 李女士,您的订单 SN-20261030-02 已于 派送中。
[INFO] 2026-10-30 21:42:00 - payment_service: 支付通道校验成功
5. % 百分号占位符(printf 风格)—— 经典语法与日志占位
% 格式化操作符是 Python 最早期的字符串格式化手段,沿袭自 C 语言的 printf 语法族。虽然在现代应用开发中已不作为首推方案,但在两类特定场景中仍然广泛存在:维护既有历史代码库,以及 Python 标准库 logging 模块的日志记录中。
代码示例
# 1. 基础类型占位符:%s 为字符串,%d 为整数,%.2f 为浮点数
item_name = "机械键盘"
count = 2
unit_price = 499.0
total = count * unit_price

receipt = "商品: %s | 数量: %d | 单价: ¥%.2f | 合计: ¥%.2f" % (item_name, count, unit_price, total)
print(receipt)

# 2. 字典键映射占位
config_str = "Host: %(host)s, Port: %(port)d" % {"host": "127.0.0.1", "port": 8080}
print(config_str)商品: 机械键盘 | 数量: 2 | 单价: ¥499.00 | 合计: ¥998.00
Host: 127.0.0.1, Port: 8080
在调用标准日志记录器时(如
logger.info("Task %s completed in %.2f ms", task_id, duration)),推荐保留 %s 占位传参,而不要预先用 f-string 拼接。因为 logging 采用了惰性求值(Lazy Evaluation)机制:如果当前日志级别高于 INFO(例如设置为 WARNING),日志系统根本不会执行参数插值运算,从而在生产高吞吐环境下节省宝贵的 CPU 周期。
6. 场景选型决策指南与常见误区
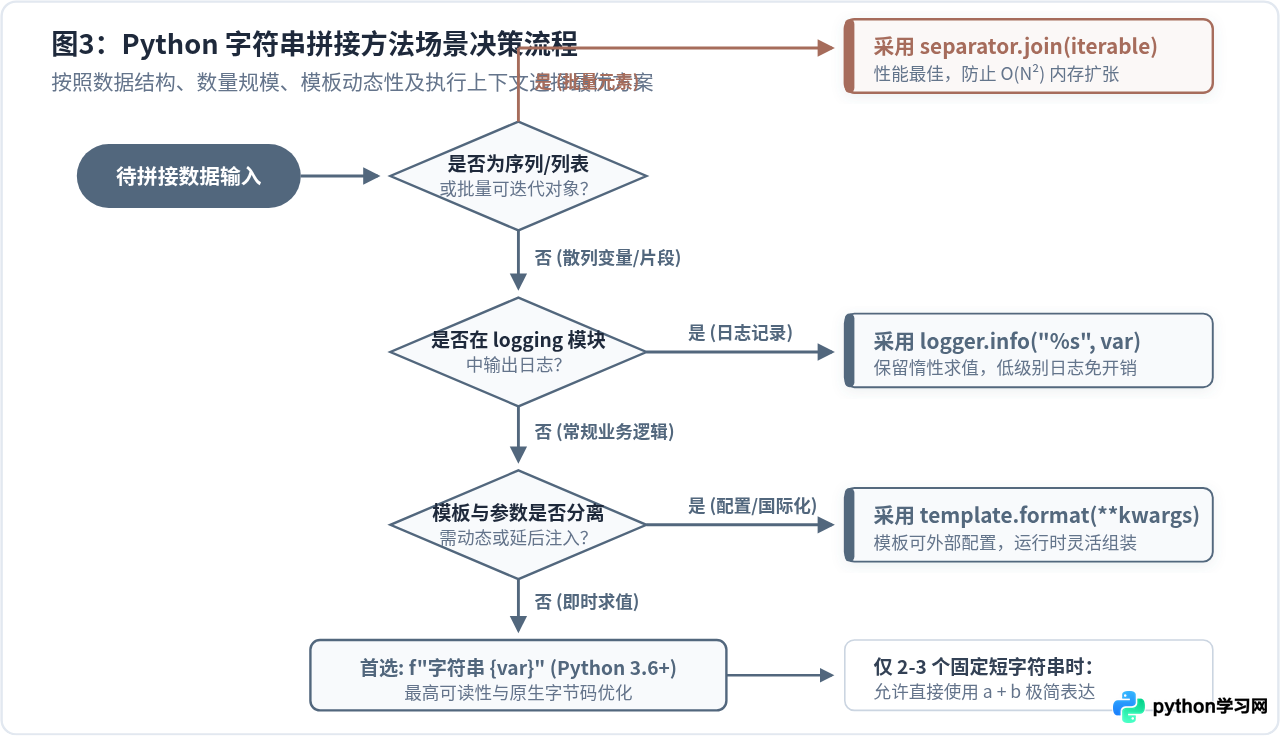
了解了 5 种拼接方法后,在实际编码中应如何做出最优选择?可依据待处理数据的结构、规模、生命周期与上下文环境,遵循下方的决策流程:
开发中需规避的三大常见误区
- 误区一:混淆数据类型直接相加。如前所述,
"ID: " + 1001会直接抛出异常。而 f-stringf"ID: {1001}"或str.format()会在内部自动调用对象的__format__或__str__方法,兼具安全性与简洁性。 - 误区二:在容器遍历中累加字符串。如果需要拼接集合元素,务必先收集到
list中,最后调用一次"".join(list),坚决杜绝在循环内部result += item。 - 误区三:给 join 传入非字符串生成器未做转换。若执行
",".join([1, 2, 3])会直接触发TypeError: sequence item 0: expected str instance, int found。正确写法为",".join(str(x) for x in [1, 2, 3])或",".join(map(str, [1, 2, 3]))。
7. 5种拼接方法综合对比与总结
为了给读者提供直观的速查参考,下表综合展示了 5 种拼接方式在语法、版本支持、性能及推荐场景维度的横向对比:
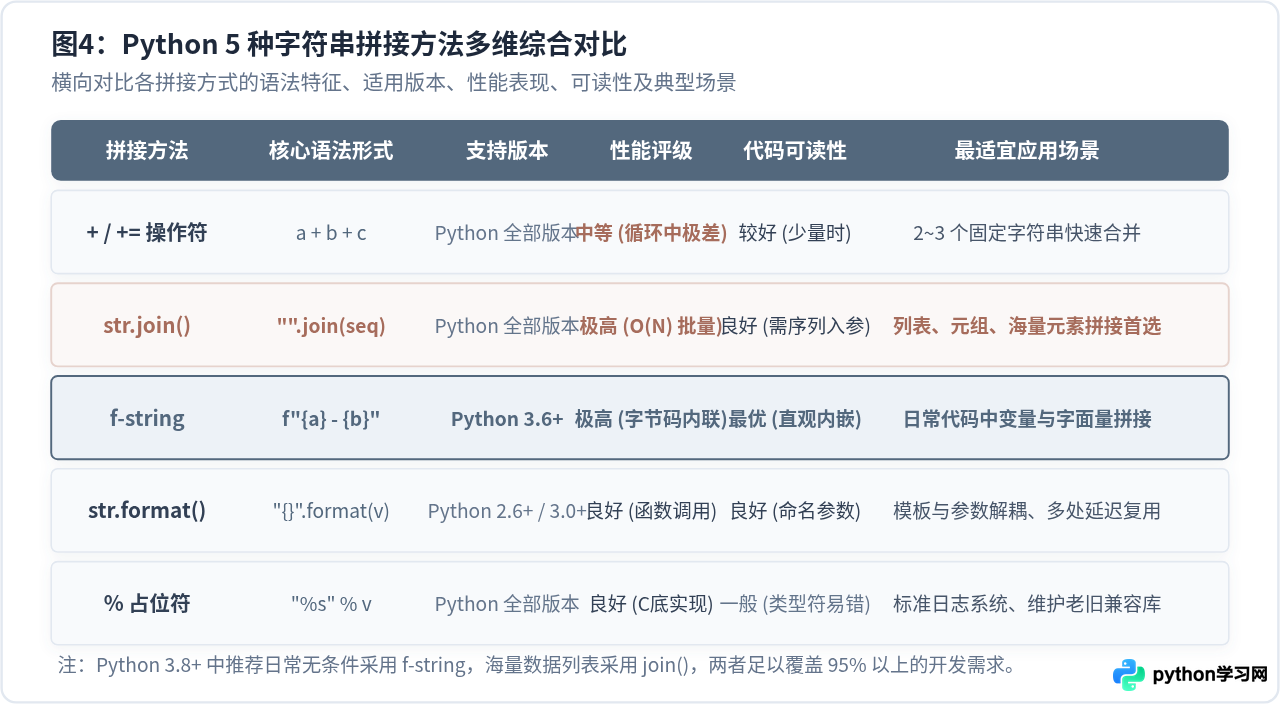
| 拼接方法 | 典型语法示例 | 支持版本 | 底层性能 | 核心推荐场景 |
|---|---|---|---|---|
| + / += 运算符 | a + " " + b |
全部版本 | 少量中等 / 循环极差 | 2~3 个固定字符串即时合并 |
| str.join() | "-".join(str_list) |
全部版本 | 极高(单次内存分配) | 列表、元组、海量元素批量合并 |
| f-string | f"User: {name}, Age: {age}" |
Python 3.6+ | 极高(原生字节码加速) | 现代 Python 业务逻辑与日常拼接首选 |
| str.format() | "{} {}".format(a, b) |
Python 2.6+ / 3.0+ | 良好 | 字符串模板分离、外部配置、国际化复用 |
| % 格式化 | "%s: %d" % (k, v) |
全部版本 | 良好 | 标准 logging 日志传参、遗留代码库维护 |
总结口诀:日常业务优先使用 f-string,可读性与性能兼具;列表与批量数据统一交由 str.join() 搞定,避免内存性能陷阱;模板与参数解耦使用 str.format();日志记录保留 logging 原生占位享受惰性求值优势。掌握这套选型逻辑,即可在 Python 文本处理中游刃有余。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















