


Python自定义类怎么实现for循环迭代
深入解析Python自定义类实现for循环迭代的三种核心机制:通过__iter__搭配yield生成器、实现标准__iter__与__next__迭代器协议,以及通过__getitem__序列协议实现遍历。包含底层运作原理、状态隔离陷阱排查与选型决策指南。
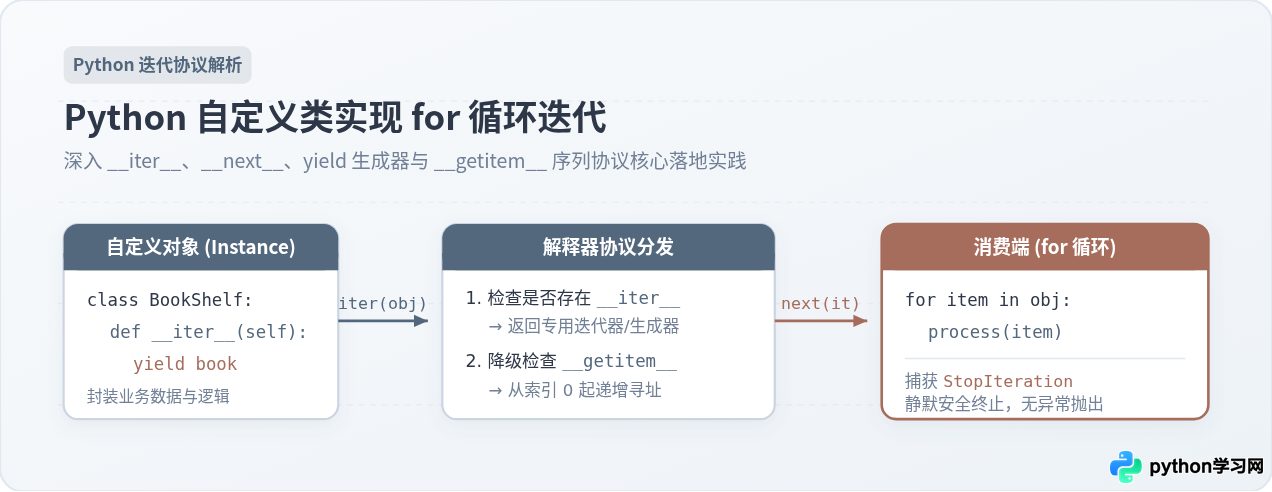
要在 Python 中让自定义类支持 for 循环,核心在于让该类遵循 Python 的迭代协议(Iteration Protocol)。最直接的标准做法是在类中定义 __iter__() 方法,让它返回一个迭代器对象。在现代 Python 编程中,最优雅、最不易出错的方式是在 __iter__() 中结合 yield 关键字将其写成生成器函数;而若需要精细的状态控制,也可以编写独立的迭代器类配合 __next__() 方法;此外,对于序列类容器,实现 __getitem__() 也能自动获得 for 循环的支持。理解这几种方式的机制差异与游标生命周期,是写出健壮自定义容器的关键。
一、for 循环底层究竟在寻找什么?
当我们书写 for item in obj: 这样一句直观的代码时,Python 解释器背后并不是直接读取 obj 的属性,而是经历了一套严密而平滑的协议寻址过程:
- 获取迭代器:解释器首先执行内置函数
iter(obj)。它首先探查obj的类中是否定义了__iter__()方法。若存在,则直接调用obj.__iter__(),并期待其返回一个合法的迭代器(Iterator)。 - 序列协议降级兜底:如果类中没有
__iter__(),解释器不会立即放弃,而是回退检查是否存在__getitem__()方法。如果存在,Python 会自动构建一个内置的序列迭代器,从索引0开始逐一递增取值。 - 逐项获取与退出机制:拿到迭代器后,解释器在每次循环开始时调用
next(iterator)(对应内部的iterator.__next__())。如果该方法返回数据,则赋值给循环变量并执行循环体;如果方法抛出StopIteration异常(或者在序列模式下捕获到IndexError),解释器会自动将其静默吸收,无缝退出循环。
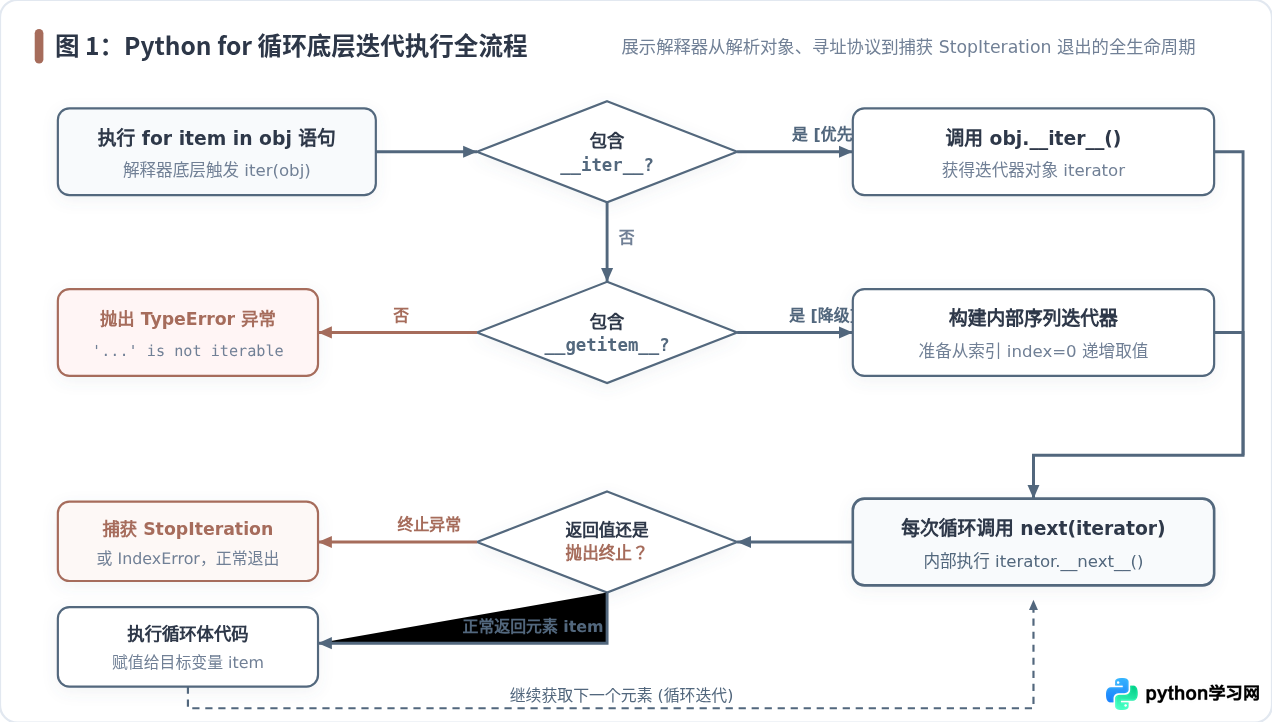
明确了这一底层逻辑后,我们可以发现:让自定义类支持 for 循环,本质就是为解释器提供一个能够不断产出数据并在终点主动发出终止信号的通道。
二、最推荐的方式:在 __iter__ 中使用 yield 生成器
在日常业务开发中,如果你封装了一个包含多项数据的集合类(如团队、购物清单、批量任务管理等),通过 yield 定义 __iter__() 是最简洁、最 Pythonic 的做法。
因为在 Python 语法中,任何包含 yield 关键字的函数都会被自动编译为生成器工厂。每次调用 __iter__() 时,它都会产生一个全新的生成器实例。生成器本身自带完整的迭代器行为(内部自动实现了 __next__,并在执行完毕时自动抛出 StopIteration),省去了我们手动计算游标指针和状态恢复的所有繁琐步骤。
完整实现示例
class DevTeam:
    def __init__(self, team_name):
        self.team_name = team_name
        self.members = []

    def add_member(self, name, role):
        self.members.append({"name": name, "role": role})

    def __iter__(self):
        # __iter__ 包含 yield,调用时直接返回一个全新的生成器迭代器
        for member in self.members:
            # 可以在 yield 产出前进行过滤、格式化或业务包装
            yield f"{member['name']} ({member['role']})"

# 验证执行
team = DevTeam("AI 平台研发组")
team.add_member("张三", "架构师")
team.add_member("李四", "后端工程师")
team.add_member("王五", "前端工程师")

# 第一次遍历
for person in team:
print("团队成员:", person)注意观察上面的 team 对象:不仅第一次 for 循环顺利打印,如果紧接着再写一个 for person in team:,它依然能够完整执行。这是因为每次循环触发 iter(team) 时,都会重新进入 __iter__ 函数生成一个新的生成器对象,内部的状态游标完全隔离,天生支持多次重复遍历。
三、标准迭代器模式:分离容器与迭代器对象
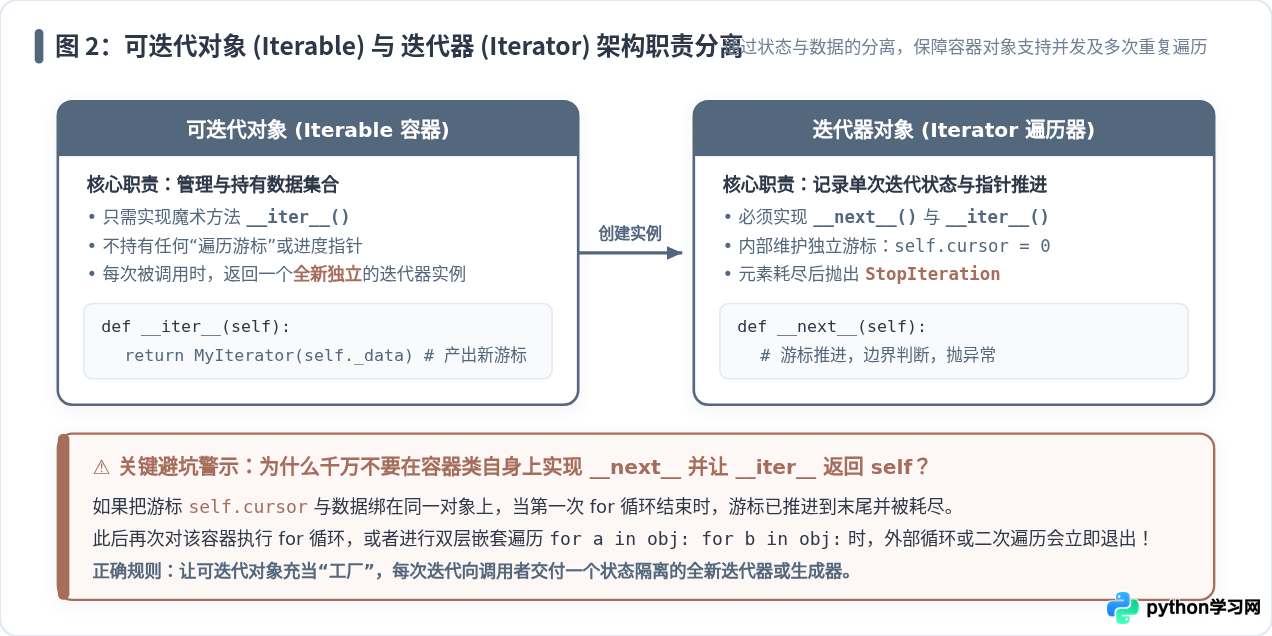
有些时候,类的内部状态转移非常复杂,或者需要记录详细的单向行进轨迹,此时我们可以采用经典的迭代器设计模式:定义两个类,一个负责“装数据”(可迭代对象 Iterable),另一个负责“维护遍历进度”(迭代器 Iterator)。
根据 Python 的官方协议规范,一个合格的迭代器类必须满足两点:
- 实现
__next__(self):返回下一个元素;当没有更多元素时,必须显式抛出raise StopIteration。 - 实现
__iter__(self):迭代器本身的__iter__必须返回自身(return self),以便迭代器本身也能直接传给for循环或内置函数使用。
面向对象标准实现代码
class BookShelf:
    """可迭代对象 (Iterable):只负责保存书籍清单,不记录当前读到哪一本"""
    def __init__(self):
        self.books = []

    def append(self, book_title):
        self.books.append(book_title)

    def __iter__(self):
        # 关键点:每次请求迭代器时,都 new 出一个独立的游标对象
        return BookShelfIterator(self.books)


class BookShelfIterator:
    """迭代器 (Iterator):持有数据引用,维护当前行进指针 cursor"""
    def __init__(self, books):
        self._books = books
        self._cursor = 0

    def __iter__(self):
        # 按照 Python 迭代协议,迭代器自身的 __iter__ 必须返回 self
        return self

    def __next__(self):
        if self._cursor >= len(self._books):
            # 元素耗尽,必须抛出 StopIteration 通知解释器终止循环
            raise StopIteration

        current_book = self._books[self._cursor]
        self._cursor += 1
        return current_book

# 验证多次遍历与独立性
shelf = BookShelf()
shelf.append("《深入理解计算机系统》")
shelf.append("《Fluent Python》")

print("--- 第 1 次遍历 ---")
for b in shelf:
    print(b)

print("--- 第 2 次遍历 ---")
for b in shelf:
print(b)初学者常常为了图省事,将 self._cursor = 0 直接写在 BookShelf 类里,并在同一个类中同时定义 __iter__ 和 __next__,其中 __iter__ 简单地写成 return self。
这样虽然也能跑通第一次 for 循环,但这个对象在循环结束后就永远“报废”了!因为 self._cursor 已经走到了末尾,第二次调用 for 循环时,__next__ 会在第一步直接抛出 StopIteration,导致第二次循环没有任何输出且不报错。更隐蔽的是,如果有内外双层嵌套循环(for x in shelf: for y in shelf:),外层仅走一步,内层跑完就把共享的游标耗尽了,导致逻辑全盘失真。因此,必须保持数据容器与游标状态的分离。
四、基于序列协议的替代方案:__getitem__ 隐式迭代
除了显式的 __iter__,Python 还支持经典的序列协议。如果你的自定义类天生具有整数索引访问的需求(例如像自定义列表、向量或 PyTorch 中的 Dataset 数据集),你甚至不需要编写 __iter__,只要正确实现 __getitem__,类就会自动支持 for 循环。
代码实现
class DataRecords:
    def __init__(self, raw_data):
        self._items = list(raw_data)

    def __len__(self):
        return len(self._items)

    def __getitem__(self, index):
        # 关键点:当 index 越界时,必须抛出 IndexError
        # 如果捕获异常后返回 None 而不抛 IndexError,for 循环将陷入无限死循环!
        return self._items[index]

# 验证执行
dataset = DataRecords(["Sample_A", "Sample_B", "Sample_C"])

# 支持下标访问
print("第 0 号记录:", dataset[0])

# 自然支持 for 循环
for record in dataset:
print("循环读取:", record)在没有 __iter__ 的情况下,for record in dataset 底层会从索引 0 开始,依次调用 dataset[0]、dataset[1]、dataset[2]……直到 dataset[3] 触发了 IndexError,解释器捕获到这个越界异常便正常停下来。如果编写自定义数据结构时忘记抛出 IndexError,循环就会永无休止地执行下去。
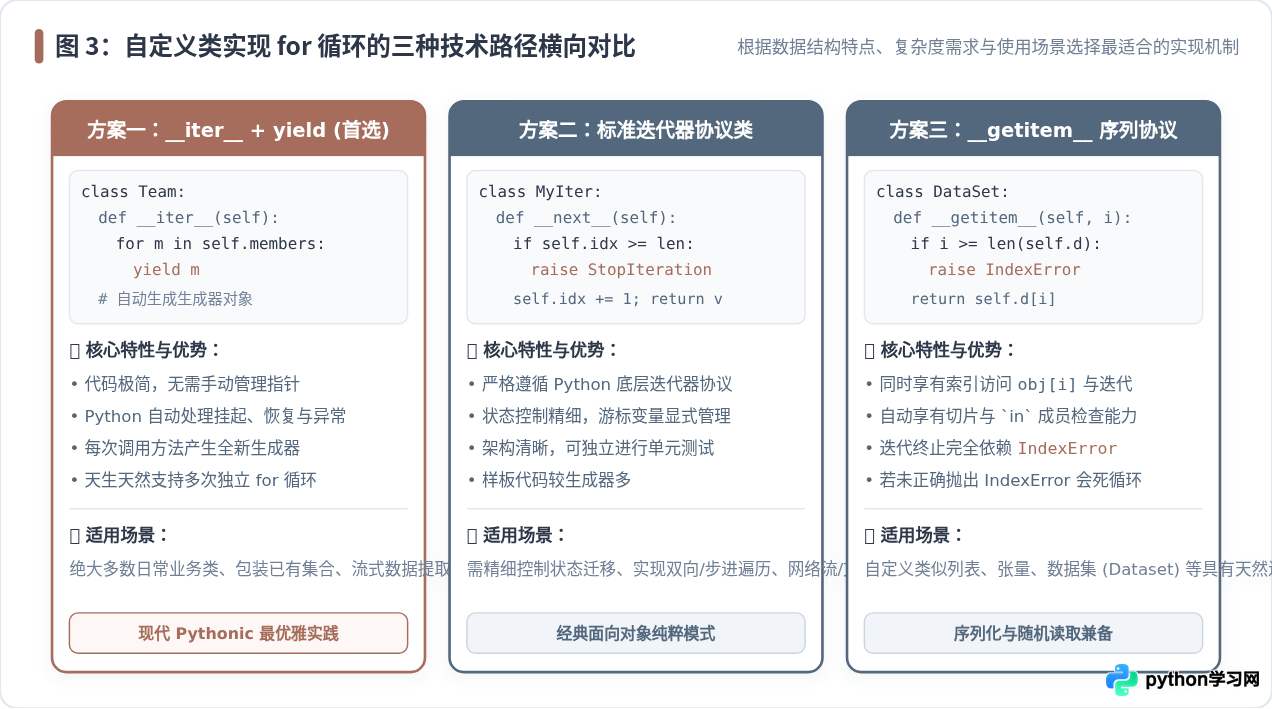
五、三种实现路径横向对比
为了帮助大家在架构选型时做出最符合场景的决策,我们将上述三种实现形式的核心维度对比如下:
| 对比维度 | 方案一:__iter__ + yield | 方案二:独立迭代器协议类 | 方案三:__getitem__ 序列协议 |
|---|---|---|---|
| 代码复杂度 | 极低(几行生成器逻辑搞定) | 较高(需要手写两个类及游标) | 低(专注实现下标取值) |
| 多次遍历支持 | 原生完全支持(每次产出新生成器) | 完全支持(每次交付新游标实例) | 完全支持(每次从索引 0 重新取) |
| 下标访问 obj[i] | 不支持 | 不支持 | 原生支持(含切片语法) |
| 终止信号 | 函数执行结束自动终止 | 显式 raise StopIteration |
越界时 raise IndexError |
| 最佳适用场景 | 绝大多数通用容器、流式转换、树形遍历 | 复杂业务状态机、硬件游标、网络分块调度 | 类数组、张量、离散时序数据集 |
六、技术选型决策与开发避坑指南
在实际编码中,可以根据下图所示的决策路径快速锁定最合适的实现手段,并在上线前依照右侧清单进行自检:
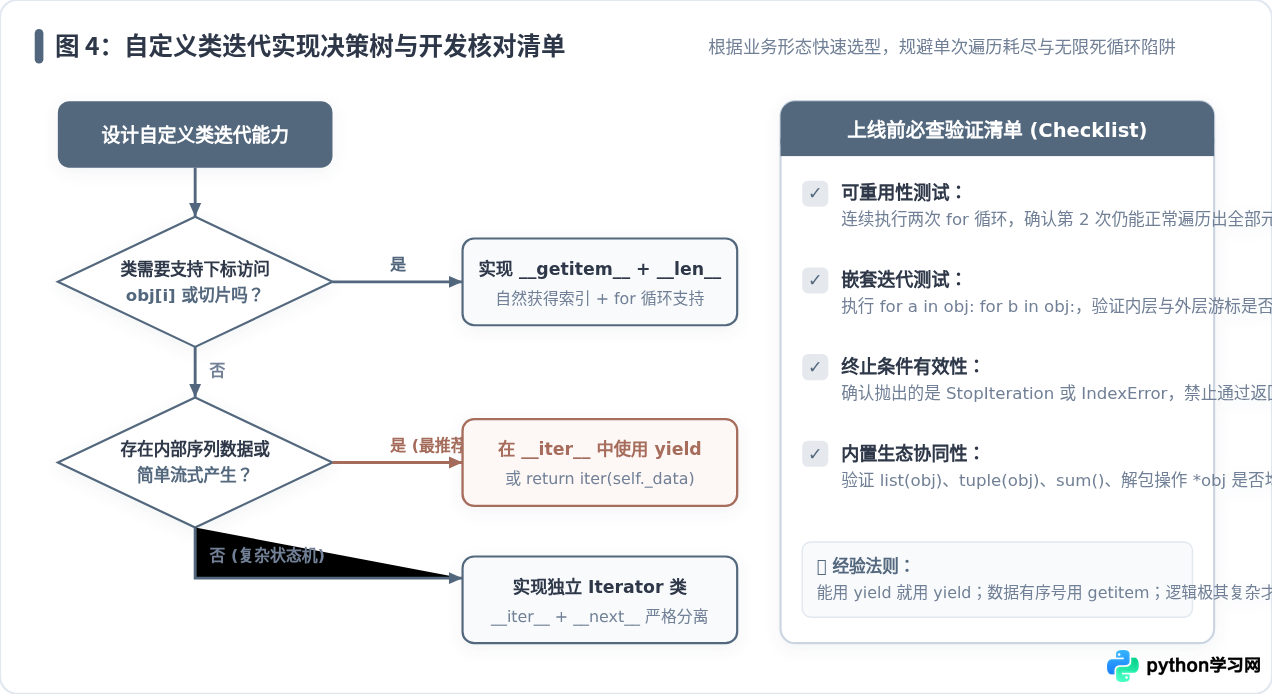
常见排错与注意事项
- 不要用
return None代替StopIteration:在迭代器__next__中,如果不抛出StopIteration而是返回None,for循环会认为本次产出的值就是None,并将None持续传递给循环体,引发无穷无尽的死循环。 - 善用委托转发:如果你的自定义类只是包装了一个内部已有的
list或dict,你甚至连yield都不需要写,直接在__iter__中调用return iter(self._internal_list),将生成迭代器的任务直接委托给 Python 原生列表,运行速度最快且最不容易出错。 - 免费获得的 Python 生态红利:一旦你的类正确实现了
for循环支持,你将自动免费获得大量内置功能的支持——例如list(my_obj)强转、[x for x in my_obj]列表推导式、*my_obj参数解包,以及sum(my_obj)、min(my_obj)、max(my_obj)等聚合函数的直接调用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















