


Python标准库csv与pandas处理CSV文件的适用场景对比
深入对比Python内置标准库csv模块与第三方数据分析库pandas在解析和处理CSV文件时的底层机制、内存表现、代码模式与适用场景,提供系统化的选型判断依据与实战避坑建议。
一、现实情境与核心答案
假设你正在为一台配置只有 1 核 1GB 内存的边缘服务器编写日志抽取脚本,每天凌晨需要从一个体积达 15GB 的 CSV 访问日志中提取所有状态码为 500 的请求路径。如果你直接敲下 import pandas as pd; df = pd.read_csv('access.log'),程序几乎会在几秒内因触发操作系统的 OOM Killer(内存溢出终止)而直接崩溃。反之,如果你在数据探索分析项目中,需要对上百所学校、数万名学生的成绩按照年级和科目求均值、中位数并计算及格率,却依然坚持使用 Python 标准库 csv,你将不得不手写几十行冗长且容易出错的嵌套字典遍历和浮点累加代码。
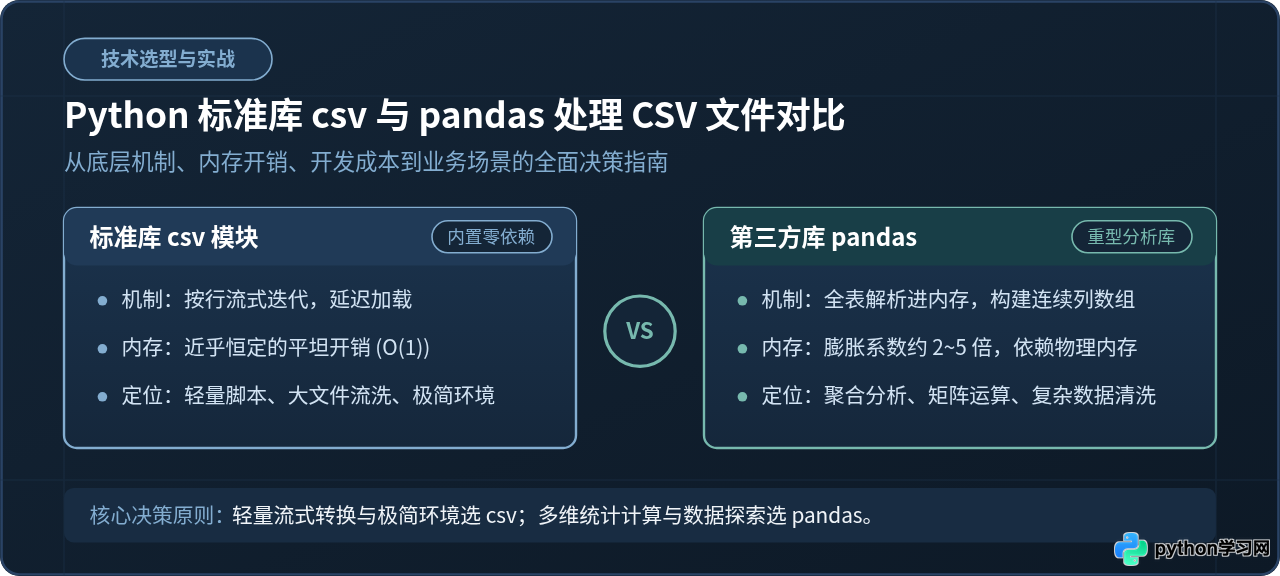
这就是 CSV 处理中经常面临的选型分野。回答这个问题的核心在于看清两个工具的本质差异:Python 标准库 csv 是一个轻量级、面向字符流的逐行迭代解析器,它不承载任何计算模型,核心优势是零外部依赖、恒定极低的内存开销与即开即用的灵活性;而 第三方库 pandas 是一个重型、面向列式内存数组的表格分析引擎,核心优势是强大的向量化运算、多维数据统计与极为高效的表达能力,但代价是较高的内存膨胀倍数与庞大的第三方依赖体积。
简要结论是:在资源受限环境、轻量 ETL 流水线、超大文件过滤及无第三方依赖的打包分发脚本中,坚决选择标准库 csv;在统计分析、报表聚合、多表关联、数据清洗探索及已有科学计算生态中,坚决选择 pandas。
二、底层机制与数据模型差异
理解两者适用边界的第一步,是剖析它们在读取文件时对计算机资源的不同调度方式。这两者并不是“功能多”与“功能少”的简单包装,而是采用了截然相反的架构哲学。
1. 标准库 csv:单行流式迭代游标
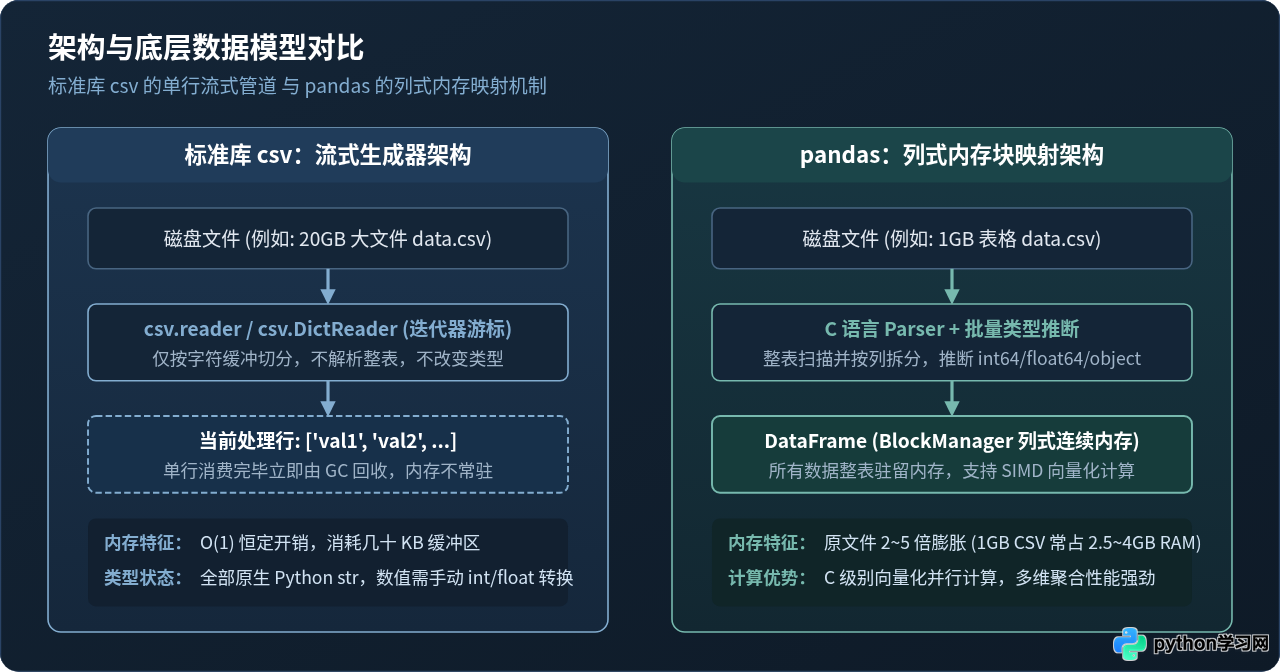
Python 内置的 csv 模块直接建立在底层文件对象(File Object)的基础之上。无论是使用 csv.reader 还是 csv.DictReader,它在内存中都只维护一个小容量的读取缓冲区(通常只有几十 KB)。当代码执行 for row in reader: 时,解析器仅仅根据换行符切出当前行,按照分隔符切割成一个由原生 Python 字符串组成的 list 或 dict。当前行在循环体内处理完毕后,引用的对象立即被垃圾回收机制(GC)释放。
这种机制决定了:无论输入的 CSV 文件是 100KB 还是 100GB,标准库 csv 运行时的内存占用始终保持平坦恒定,空间复杂度为 O(1)。此外,它从不尝试猜测字段是整型、浮点型还是日期,所有字段一律保持为原生 str,省去了昂贵的类型推断开销。
2. 第三方库 pandas:列式连续内存二维表
当调用 pd.read_csv('data.csv') 时,底层调用的通常是由 C 语言编写的高性能解析引擎。引擎会一次性扫描整份文件或大块数据,分配连续的内存块,将每一列转换为对应类型的 NumPy 数组(内部通过 BlockManager 管理),最终封装为 DataFrame 二维表格对象。
由于连续数组能够利用 CPU 高速缓存(L1/L2 Cache)以及 SIMD 向量化指令,pandas 在执行整列加减乘除、均值方差或布尔索引过滤时,速度可以比纯 Python 循环快上数十甚至数百倍。但这种优异性能建立在“以空间换时间”的基础之上:不仅需要将整表全部装入内存,由于对象元数据、列指针、索引(Index)以及字符串类型的指针开销,pandas 内存中的 DataFrame 体积通常是原始磁盘 CSV 文件的 2 到 5 倍。一个 1GB 大小的纯文本 CSV,载入 pandas 后往往需要消耗 2.5GB 到 4GB 的实际物理内存。
三、常见操作模式与完整代码实操对比
为了让选择依据具象化,我们通过三个真实开发中最常见的业务场景,对比两者的具体写法、代码量和执行行为。
场景 A:字段提取与条件过滤(轻量转换任务)
任务要求:读取 transactions.csv,筛选出交易金额(amount)大于 1000 且状态为 SUCCESS 的记录,将商户名与金额写入新的 CSV 文件。
使用标准库 csv 实现:
import csv

input_path = "transactions.csv"
output_path = "filtered_transactions.csv"

# 必须设置 newline='' 且显式指定编码
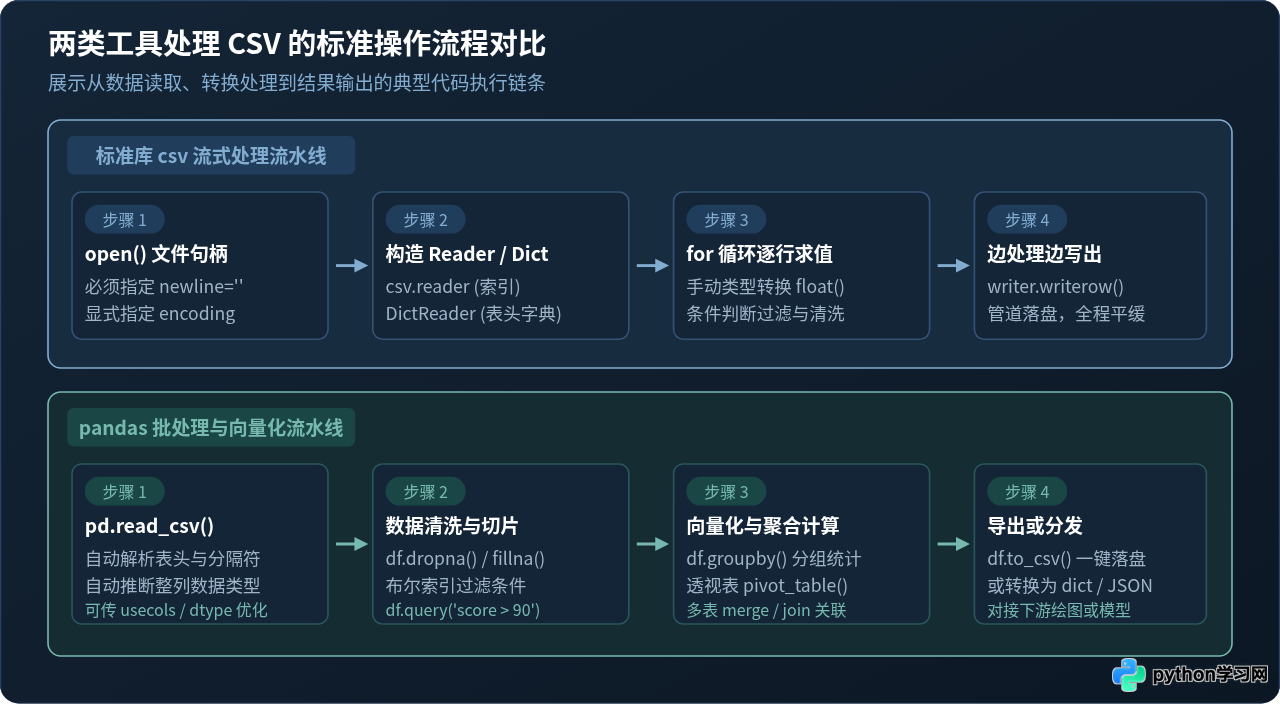
with open(input_path, mode="r", encoding="utf-8", newline="") as infile,      open(output_path, mode="w", encoding="utf-8", newline="") as outfile:

    reader = csv.DictReader(infile)
    # 指定写出的字段列
    fieldnames = ["merchant_name", "amount"]
    writer = csv.DictWriter(outfile, fieldnames=fieldnames)
    writer.writeheader()

    for row in reader:
        # csv 模块读出的数值皆为 str,必须显式做安全转换
        try:
            amt = float(row.get("amount", 0))
        except ValueError:
            continue

        if amt > 1000 and row.get("status") == "SUCCESS":
            writer.writerow({
                "merchant_name": row["merchant_name"],
                "amount": f"{amt:.2f}"
            })
使用 pandas 实现:
import pandas as pd

# 读取并利用向量化布尔索引直接过滤
df = pd.read_csv("transactions.csv", usecols=["merchant_name", "amount", "status"])

# 自动推断类型并执行条件过滤
filtered_df = df[(df["amount"] > 1000) & (df["status"] == "SUCCESS")]

# 一次性写出目标列
filtered_df[["merchant_name", "amount"]].to_csv("filtered_transactions.csv", index=False)场景对比评述:在单纯的行级别条件过滤任务中,两种方案均能顺利完成。若文件体积小,pandas 代码更为精炼;但若 transactions.csv 高达数十 GB,标准库 csv 的边读边写管道在任何服务器上都能顺畅跑完,而 pandas 方案会直接因内存暴涨而崩溃。
场景 B:分组聚合与多维指标统计(分析类任务)
任务要求:读取销售数据表,按部门(department)和季度(quarter)计算总销售额、平均客单价以及交易笔数。
使用标准库 csv 实现(需要手工管理多级字典与计数器):
import csv
from collections import defaultdict

# 结构: stats[(dept, qtr)] = [total_amount, count]
stats = defaultdict(lambda: [0.0, 0])

with open("sales.csv", mode="r", encoding="utf-8", newline="") as f:
    reader = csv.DictReader(f)
    for row in reader:
        key = (row["department"], row["quarter"])
        amt = float(row["amount"])
        stats[key][0] += amt
        stats[key][1] += 1

# 手动组装计算结果
summary_rows = []
for (dept, qtr), (total, count) in stats.items():
    avg_price = total / count if count > 0 else 0.0
    summary_rows.append({
        "department": dept,
        "quarter": qtr,
        "total_sales": round(total, 2),
        "avg_price": round(avg_price, 2),
        "order_count": count
    })
使用 pandas 实现:
import pandas as pd

df = pd.read_csv("sales.csv")

# 声明式链式聚合,两行搞定复杂的统计指标
summary = df.groupby(["department", "quarter"])["amount"].agg(
    total_sales="sum",
    avg_price="mean",
    order_count="count"
).reset_index()

summary.to_csv("sales_summary.csv", index=False)场景对比评述:在多维聚合场景下,pandas 展现出压倒性的优势。标准库 csv 无法提供内置统计运算,开发者不得不自行编写双重循环、除零保护、字典累加等逻辑,不仅代码繁琐脆弱,而且解释执行纯 Python 字典查询的速度远逊于 pandas 的 C 引擎分组算法。
场景 C:超大文件的分块处理(Chunking 方案)
面对单机内存放不下的超大 CSV 文件时,如果依然需要使用 pandas 丰富的统计清洗函数,可以采用 chunksize 参数进行流式分块迭代:
import pandas as pd

chunk_size = 50000  # 每次载入 5 万行
running_total = 0

# 以生成器模式分块读取,控制内存峰值
for chunk in pd.read_csv("huge_dataset.csv", chunksize=chunk_size):
    # chunk 为标准的 DataFrame,可直接使用向量化运算
    running_total += chunk["amount"].sum()

print(f"全量总计: {running_total}")
这种分块方式融合了 pandas 的便捷 API 与迭代器的内存安全性,但在需要跨块进行全局排序(sort_values)或去重(drop_duplicates)时,仍需额外的全局归并设计。
四、关键选型维度与决策推导
在面对具体业务需求时,技术选型不应凭开发者个人的习惯盲目决定。以下从运行环境、数据规模、计算类型和冷启动四个维度建立明确的评估路径。
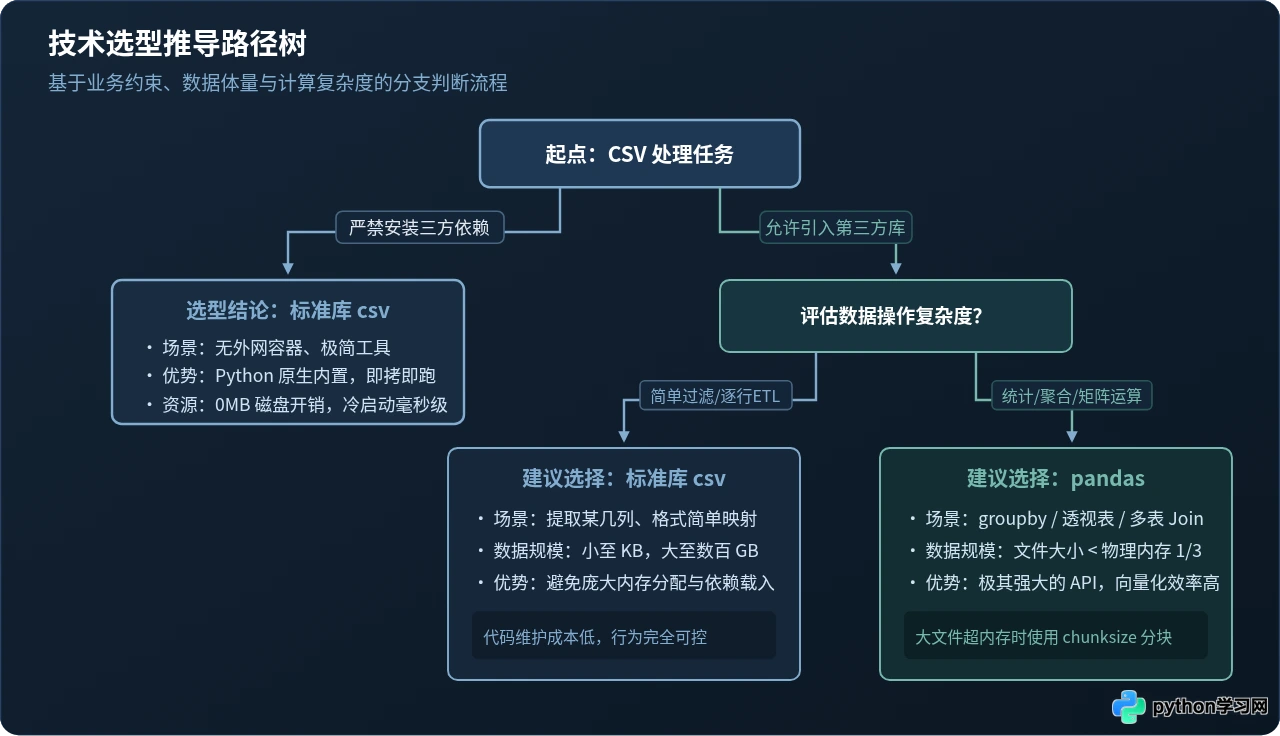
1. 运行环境与依赖约束
这是最具排他性的一道筛选门槛:
- 极简打包与自动化分发:如果你的代码需要打包成独立的轻量命令行工具(CLI)、在客户内网封闭隔离的裸机运行,或者嵌入到只提供标准 Python 解释器的环境中,标准库
csv无需网络、无需编译、没有版本兼容包袱。 - Serverless 与云函数冷启动:AWS Lambda、腾讯云 SCF 等无服务器函数计费与内存分配和执行时长直接挂钩。
import pandas仅导入过程就可能需要 100~300 毫秒,且打包镜像常常超出数十兆限制;而标准库csv冷启动耗时小于 1 毫秒,包体积为 0。
2. 数据体量与物理内存上限
评估待处理数据相对于当前硬件环境的比例:
- 数据量 < 可用内存的 1/3:放心地使用
pandas,你可以获得极致的开发效率和快速的交互式调试能力。 - 数据量 > 可用内存的 1/2:直接使用
pd.read_csv极易触发内存告警或系统交换区(Swap)频繁换页导致机器卡死。此时应优先考虑标准库csv流式处理,或者使用 pandas 的chunksize逐块消化。
3. 计算任务的形态
- 行级独立操作(Row-wise):如果处理逻辑只关乎“当前行”,例如数据清洗、格式重构、敏感信息脱敏、行过滤、分发入库,标准库
csv是最佳选择,吞吐稳定,逻辑直接。 - 集合与跨行操作(Cross-row):如果处理逻辑涉及列之间的矩阵相乘、滑动窗口计算(Rolling)、透视转换(Pivot)、缺失值插值填充或统计建模,编写纯 Python 循环非常痛苦,应当坚决使用
pandas。
五、实战避坑与关键注意事项
在 Python 3 中使用 open() 打开 CSV 文件时,如果不传入 newline='',Python 的通用换行符机制会在写入或读取带有嵌入换行符的单元格(例如长文本描述)时产生错乱。特别是在 Windows 平台上,缺少 newline='' 会导致写出的 CSV 文件每一行后都多出一个空白空行(
)。记住标准用法:with open(filename, 'w', newline='', encoding='utf-8') as f:。
pandas 在载入时会自动推断列的数据类型。如果有一列是员工工号、身份证号或订单编号(例如 "001245"),pandas 会将其误判为整数列并自动转换为 1245,导致前导零丢失,从而造成灾难性数据损坏;若整数列中含有缺失值(NaN),在旧版 pandas 中该列还会被强行升格为浮点型(Float64)。
防范方法:在读取可能存在前导零标识的列时,必须使用 dtype 参数显式锁定为文本格式:pd.read_csv('orders.csv', dtype={'order_id': str, 'phone': str})。
标准库 csv 默认限制单个字段的最大长度为 128KB(防止畸形文件导致内存耗尽)。如果处理的 CSV 中包含大文本字段(如 HTML 网页爬取内容或错误日志堆栈),会直接报错。可通过在代码开头提高上限予以解决:import sys, csv; csv.field_size_limit(sys.maxsize)。
六、综合场景对照表与最终选型建议
综合各项指标与工程经验,两者的全方位对比如下表所示:
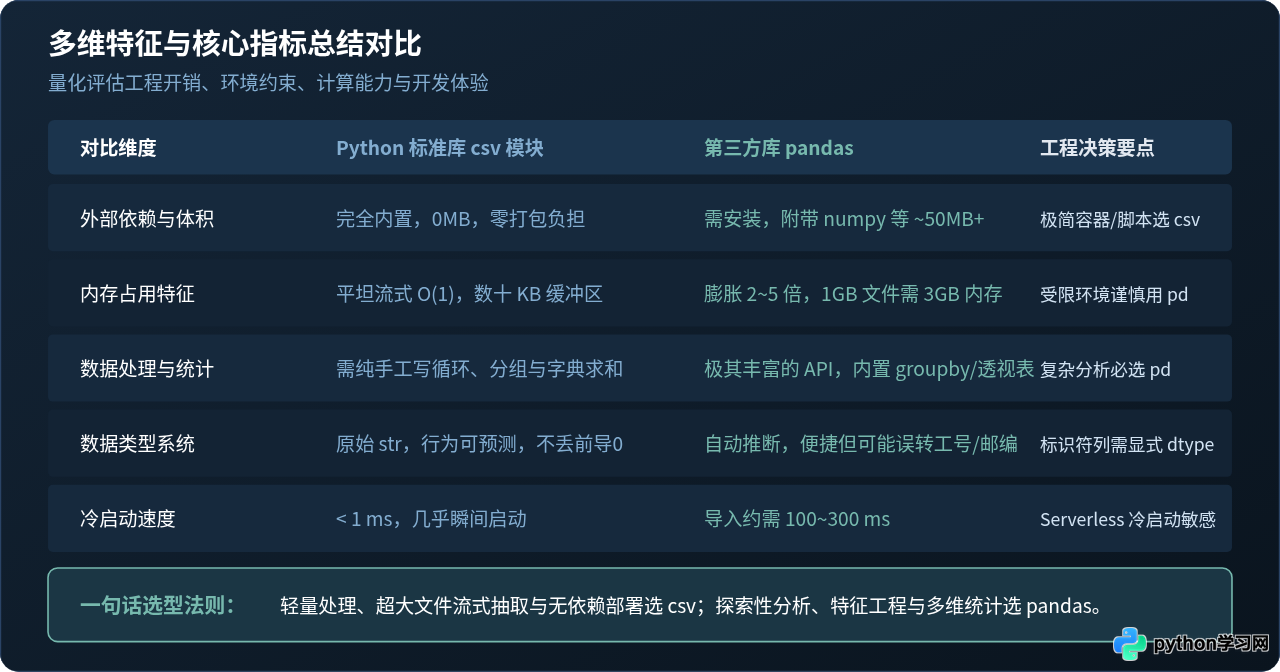
| 评估维度 | Python 标准库 csv | 第三方库 pandas |
|---|---|---|
| 外部依赖 | 完全内置,零第三方安装 | 需额外安装 pandas、numpy 等依赖包 |
| 空间复杂度 | O(1),平坦流式缓冲区,百 KB 级 | O(N),整表常驻,膨胀为文件大小的 2~5 倍 |
| 单行读写吞吐 | 极快,底层 C 语言字符切分 | 全表整体速度快,但受限于解析推断开销 |
| 多维统计能力 | 无内置算法,需纯手写循环与数据结构 | 拥有完备的分组、透视、时间序列与统计函数 |
| 类型系统 | 所有字段皆为字符串,行为严格可控 | 自动识别数值、日期等,偶有前导零丢失风险 |
| 超大文件容纳度 | 天然支持,数百 GB 级文件流式抽取无压力 | 需要借助 chunksize 分块或多进程切分 |
| 适用场景归纳 | 无依赖运维脚本、极简微服务、大文件逐行过滤 | 数据挖掘探索、交互式分析、报表聚合、多表合并 |
总结建议
在 Python 生态中,标准库 csv 和 pandas 并不是相互取代的关系,而是定位在不同层级的互补工具。标准库 csv 就像一把锋利小巧的手术刀,在数据清洗管道的起点负责无损、低耗、轻便的流式流转;而 pandas 则是全功能的重型加工机床,在进入统计建模、报表挖掘与特征工程时释放强大的生产力。
在面对新项目时,切忌盲目依赖习惯。如果任务只是简单的字段转换、筛选切分或日志归档,毫不犹豫地拿起标准库 csv;若任务涉及复杂的统计分析、分组对比与多维清洗,则充分发挥 pandas 的强大表达能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















