


Python自动化能做什么?Excel批量处理、邮件发送与PDF合并实战场景
深入解析Python在日常办公与数据处理中的实际价值。通过Excel多表聚合与清洗、差异化邮件批量发送、多份PDF文件智能排序合并三大经典实战场景,提供完整的代码方案、工程实践逻辑与关键避坑指南。
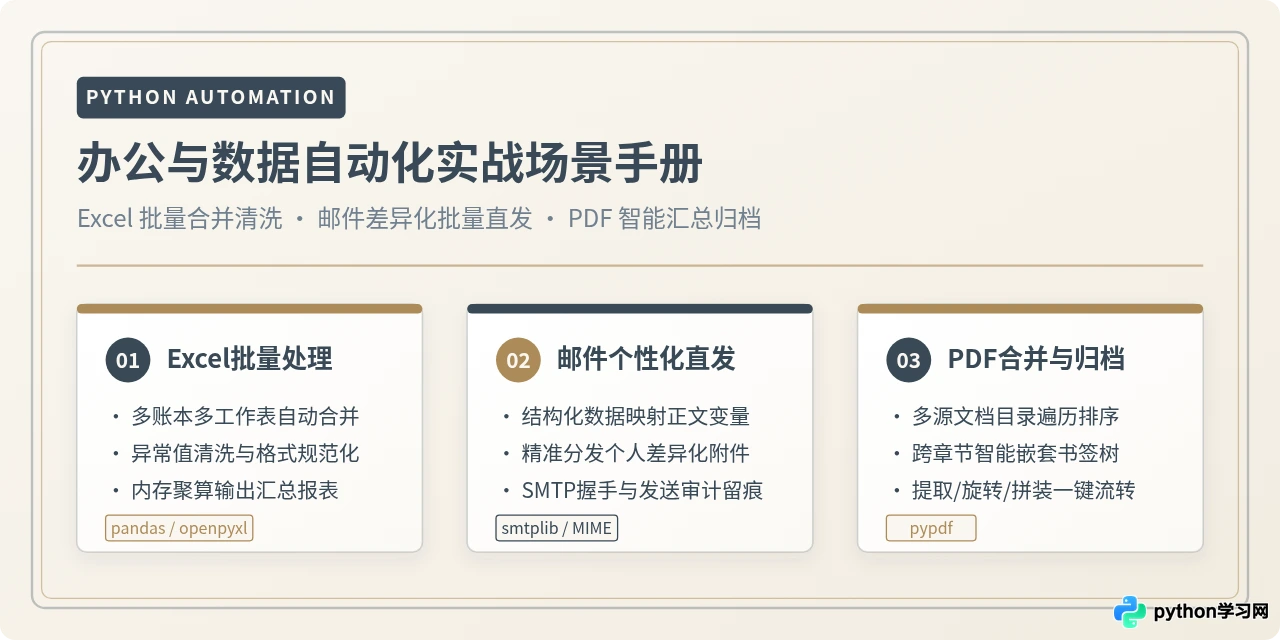
一、Python自动化能做什么:核心能力边界与适用标准
在很多初学者的印象中,自动化往往等同于“写一个脚本点点鼠标”。实际上,在真实的业务场景下,基于图形界面模拟(如模拟鼠标键盘点击)的自动化不仅运行脆弱,而且极易受分辨率变动、弹窗干扰和系统卡顿影响。真正具备生产级价值的Python自动化,是基于数据协议与文件结构的底层直读直写。
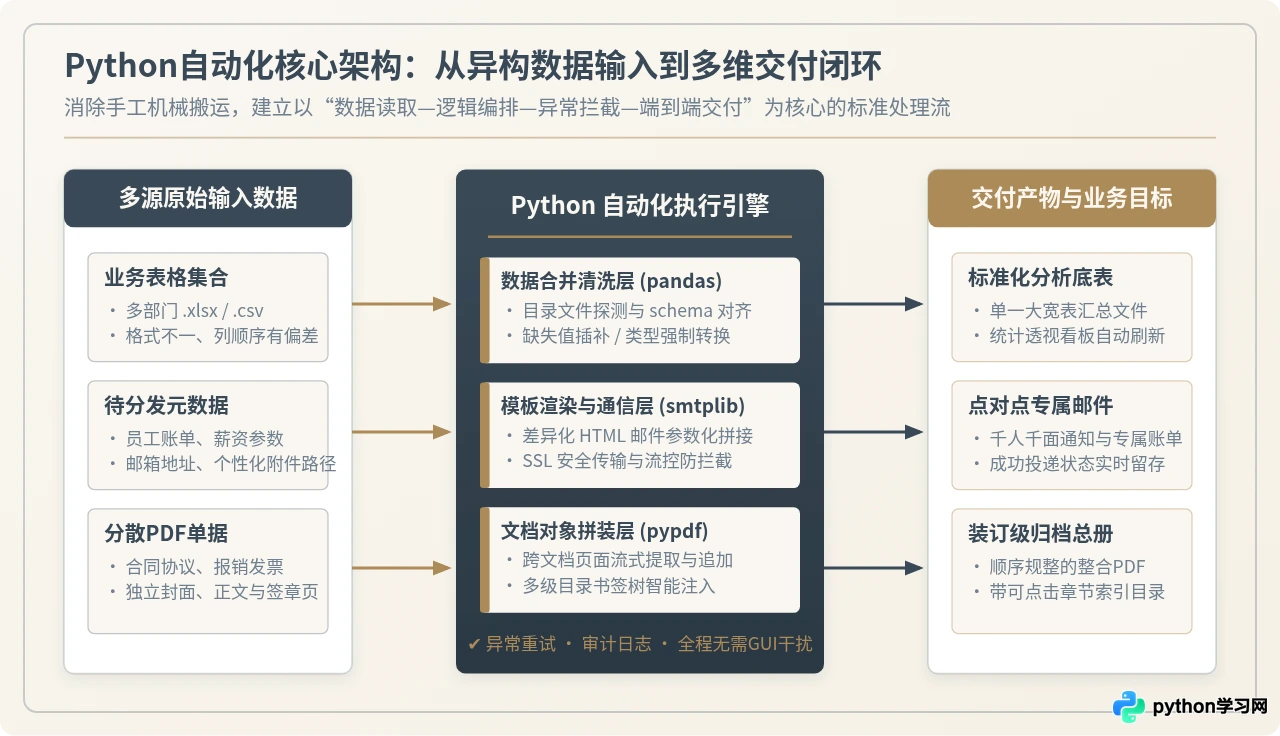
Python具备极其成熟的第三方生态,能够绕过操作系统的图形界面,直接在内存中解析和重组Office文档、PDF流以及网络通信协议。具体而言,它主要覆盖以下四类核心工作能力:
- 批量文件操作与归集:在毫秒级内递归扫描包含数千个子目录的磁盘路径,按预设命名规则或时间戳完成筛选、重命名、移动与归档。
- 结构化数据清洗与矩阵运算:通过
pandas、openpyxl等工具,对海量表格进行列名对齐、异常值剔除、格式强制转换以及跨表多维统计。 - 基于协议的网络交互与信息推送:通过
smtplib、企业微信/飞书 API 等通道,将清洗好的数据报告或个性化账单精准投递至对应责任人。 - 复杂文档生成与拼装:动态提取报表生成可视化图表,并将图像、文字、分散PDF扫描件拼装成规范装订的综合报告。
二、实战场景一:Excel批量处理、数据清洗与多表汇总
面对分布在各个部门、各个网点提交的数十乃至上百个Excel表格,手工打开、复制、粘贴不仅极其耗费精力,而且极易因操作失误遗漏行、篡改日期格式或引入错误的空格。通过Python,可以在后台一键完成全部表格的扫描、表头校验、数据去重与总表聚合。
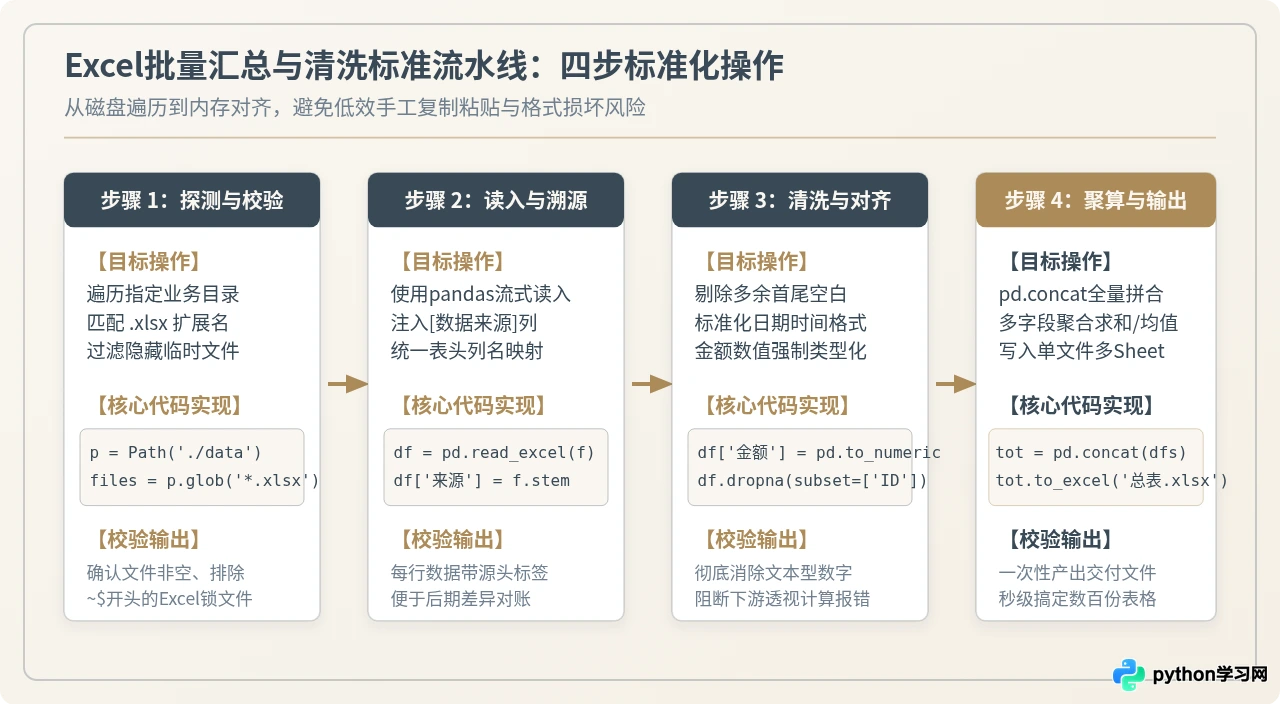
1. 业务目标与处理流程
假设某零售公司下属各个门店每天上报一份名为 门店名_销售日结.xlsx 的工作簿,各工作簿的表头基本一致,但包含空白行、首尾多余空格、文本型数字以及需要回溯的“数据来源”标签。我们的目标是将指定目录下的所有日结表自动合并为一个 年度销售全量汇总.xlsx,并生成各门店销售额汇总明细。
2. 完整实战代码实现
该方案使用 pathlib 遍历磁盘,利用 pandas 高效完成内存级的数据转换与聚合输出:
# -*- coding: utf-8 -*-
import os
from pathlib import Path
import pandas as pd

def batch_merge_sales_reports(input_dir: str, output_file: str):
    data_dir = Path(input_dir)
    # 1. 检索所有.xlsx文件,自动排除Excel打开时的临时锁文件(以~$开头)
    excel_files = [f for f in data_dir.glob("*.xlsx") if not f.name.startswith("~$")]

    if not excel_files:
        print("未在指定目录下找到有效的Excel文件。")
        return

    df_list = []
    required_cols = ["订单编号", "商品分类", "销售金额", "销售日期"]

    for file_path in excel_files:
        try:
            # 2. 读取工作簿,将所有列默认转换为合适类型
            df = pd.read_excel(file_path, sheet_name=0)

            # 校验必要字段是否完整
            if not all(col in df.columns for col in required_cols):
                print(f"跳过格式不合规文件: {file_path.name}")
                continue

            # 3. 数据清洗:去除文本前后空白字符
            for col in df.select_dtypes(include=["object"]).columns:
                df[col] = df[col].astype(str).str.strip()

            # 金额列强制转数值型,非数字转为 NaN 后填充为 0
            df["销售金额"] = pd.to_numeric(df["销售金额"], errors="coerce").fillna(0.0)
            # 统一日期格式为 YYYY-MM-DD
            df["销售日期"] = pd.to_datetime(df["销售日期"], errors="coerce").dt.strftime("%Y-%m-%d")

            # 注入溯源标签:保存来源文件名
            df["来源文件"] = file_path.name

            # 剔除订单编号缺失的无效空行
            df = df.dropna(subset=["订单编号"])
            df_list.append(df)
            print(f"成功读取: {file_path.name},有效行数: {len(df)}")
        except Exception as e:
            print(f"读取 {file_path.name} 异常: {e}")

    if not df_list:
        print("无可用数据合并。")
        return

    # 4. 内存聚合
    total_df = pd.concat(df_list, ignore_index=True)

    # 5. 多维度聚合计算
    pivot_summary = total_df.groupby(["来源文件", "商品分类"])["销售金额"].agg(["count", "sum"]).reset_index()
    pivot_summary.rename(columns={"count": "订单总量", "sum": "销售总额"}, inplace=True)

    # 6. 一键写入多Sheet的最终交付Excel
    with pd.ExcelWriter(output_file, engine="openpyxl") as writer:
        total_df.to_excel(writer, sheet_name="全量明细", index=False)
        pivot_summary.to_excel(writer, sheet_name="分类汇总", index=False)

    print(f"合并完成!总条目: {len(total_df)},输出保存至: {output_file}")

# 示例调用(目录需按实际业务替换)
# batch_merge_sales_reports('./reports', './年度销售全量汇总.xlsx')
3. 核心机制与关键注意事项
- 临时锁文件过滤:当同事或业务人员打开Excel时,系统会自动生成以
~$开头的隐藏锁文件。若不加过滤直接读取,会导致解析报错中断。代码中通过if not f.name.startswith("~$")从源头彻底隔绝该问题。 - 类型污染防御:Excel中常见把纯数字工号或金额存为文本的情况。使用
pd.to_numeric(..., errors="coerce")可以防止脚本因遇到异常字符直接崩溃,并将非法字段统一转化为安全数值。
三、实战场景二:结构化数据驱动的个性化邮件批量发送
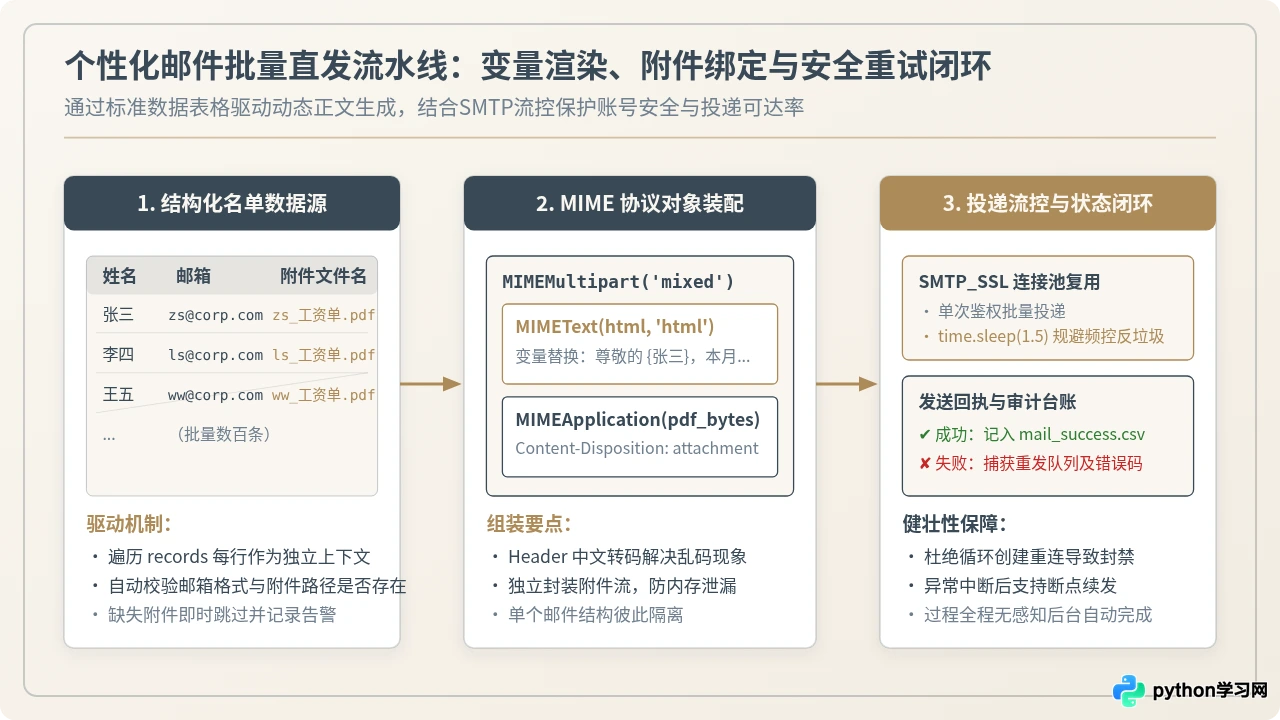
在HR发放每月工资条、财务推送客户往来对账单或运营批量发送签约邀请时,核心要求是千人千面、高度保密且零差错。一旦人工在群发时点错附件,就会造成极严重的隐私泄露事故。Python的邮件自动化能将表格中的每一行作为独立的隔离上下文,实现“参数替换—专属附件绑定—单点投递”的绝对安全闭环。
1. 协议原理与MIME结构
Python标准库内置了 smtplib(实现SMTP网络传输协议)和 email.mime(负责生成符合RFC标准的多结构报文)。一封兼备HTML富文本格式与独立二进制附件的邮件,本质是一个 multipart/mixed 容器:
- 容器主节点(MIMEMultipart):承载整体邮件头(From、To、Subject、Date)。
- 正文子节点(MIMEText):使用
'html'编码,渲染带有CSS样式的表格与动态变量。 - 附件子节点(MIMEApplication):以二进制流形式加载本地的PDF、Excel文档,并设置
Content-Disposition请求头标明文件名。
2. 生产级自动化发信脚本
# -*- coding: utf-8 -*-
import smtplib
import time
from email.mime.multipart import MIMEMultipart
from email.mime.text import MIMEText
from email.mime.application import MIMEApplication
from email.header import Header
from pathlib import Path

def send_personalized_emails(user_list: list, smtp_cfg: dict):
    # 建立 SSL 加密连接
    server = smtplib.SMTP_SSL(smtp_cfg["host"], smtp_cfg["port"])
    try:
        server.login(smtp_cfg["user"], smtp_cfg["auth_code"])
        print("SMTP服务器鉴权成功,开始执行批量投递...")

        for item in user_list:
            emp_name = item["name"]
            emp_email = item["email"]
            base_salary = item["base"]
            bonus = item["bonus"]
            attach_path = Path(item["attachment"])

            # 校验专属附件是否存在,阻断空投与错投
            if not attach_path.exists():
                print(f"[警告] 员工 {emp_name} 附件不存在: {attach_path},跳过发送。")
                continue

            # 1. 创建多部分邮件容器
            msg = MIMEMultipart()
            msg["From"] = Header(f"财务管理部 <{smtp_cfg['user']}>", "utf-8")
            msg["To"] = Header(f"{emp_name} <{emp_email}>", "utf-8")
            msg["Subject"] = Header(f"【专属通知】{emp_name} 个人月度账单明细", "utf-8")

            # 2. 组装个性化 HTML 正文
            html_body = f"""
            <div style="font-family: Arial, sans-serif; line-height: 1.6; color: #333;">
                <p>尊敬的 <strong>{emp_name}</strong> 同事:</p>
                <p>您本月的薪酬与考核核算已完成,基础额度为 <span style="color:#AD8B58;">{base_salary} 元</span>,绩效奖金为 <span style="color:#AD8B58;">{bonus} 元</span>。</p>
                <p>完整签章版账单见邮件附件,请妥善保管,勿向外部人员转发。</p>
                <hr style="border: 0; border-top: 1px solid #ddd;" />
                <p style="font-size: 12px; color: #888;">此邮件由系统自动化发出,无需直接回复。</p>
            </div>
            """
            msg.attach(MIMEText(html_body, "html", "utf-8"))

            # 3. 挂载专属附件
            with open(attach_path, "rb") as f:
                part = MIMEApplication(f.read())
                # 解决附件中文名在主流邮件客户端乱码问题
                part.add_header("Content-Disposition", "attachment", filename=("utf-8", "", attach_path.name))
                msg.attach(part)

            # 4. 执行投递
            server.sendmail(smtp_cfg["user"], [emp_email], msg.as_string())
            print(f"成功投递至: {emp_name} ({emp_email})")

            # 5. 关键流控:休眠1.5秒,避免被公共邮件网关判定为SPAM垃圾邮件封禁
            time.sleep(1.5)

    except Exception as e:
        print(f"发送过程出现异常: {e}")
    finally:
        server.quit()
print("SMTP 会话正常关闭。")- 认证凭据安全:
auth_code绝非日常登录邮箱网页的明文密码,必须前往邮箱设置页面申请专用的SMTP授权码 / 应用专用密码。 - 复用连接切勿反复握手:切忌在
for循环内部每次都执行server = SMTP_SSL()与server.login()。频繁握手会被企业邮箱网关直接加入临时黑名单。正确做法是在循环外保持长连接,批量发送后再统一quit()。
四、实战场景三:多源文件扫描、分页裁剪与PDF合并
在招标投标、合同档案整理或大型审计项目中,各类材料通常是分散保存的单页PDF。传统做法是用收费的PDF阅读器逐个拖拽合并,不仅耗时,而且一旦出现目录层级变动,就必须全盘重来。利用现代Python库 pypdf,几行代码就能完成上百个文件的自动按序拼接,并智能注入具有多级大纲的树状书签。
1. PDF合并的核心机制
与图像直接拼接不同,PDF本质是一种复杂的面向对象矢量页面描述语言。页面内部包含字体映射表、文本流操作符、注解与交叉引用表(XRef)。在Python中,现代合并工具采用页面对象流式迁移:先在内存中构建 PdfWriter,通过 PdfReader 解析各个子文件后,按页追加到写入器中,最后再重写大纲书签树并序列化到磁盘。
2. 完整合并与自动打书签脚本
# -*- coding: utf-8 -*-
import os
from pathlib import Path
from pypdf import PdfReader, PdfWriter

def merge_pdf_documents_with_bookmarks(input_dir: str, output_filepath: str):
    pdf_dir = Path(input_dir)
    # 1. 扫描目录下所有PDF文件,按文件名自然顺序排序(如:01_封面.pdf, 02_目录.pdf)
    pdf_files = sorted(list(pdf_dir.glob("*.pdf")), key=lambda x: x.name)

    if not pdf_files:
        print("未检测到需要合并的PDF文件。")
        return

    writer = PdfWriter()
    current_page_index = 0

    print(f"找到 {len(pdf_files)} 个待合并PDF文件,开始顺序追加...")

    for pdf_path in pdf_files:
        try:
            reader = PdfReader(str(pdf_path))
            num_pages = len(reader.pages)

            if num_pages == 0:
                print(f"跳过空文件: {pdf_path.name}")
                continue

            # 提取章节标题(去掉文件后缀名)
            chapter_title = pdf_path.stem

            # 2. 为当前文件在总册中创建一级大纲书签,锚定到当前文件的起始页码
            writer.add_outline_item(
                title=chapter_title,
                page_number=current_page_index
            )

            # 3. 逐页追加到写入容器
            for page_idx, page in enumerate(reader.pages):
                # 可在此处处理页面方向纠正(例如横向页面自动旋转):
                if page.rotation != 0:
                    page.transfer_rotation_to_content()

                writer.add_page(page)

            print(f"已合并: {pdf_path.name} (共 {num_pages} 页,起始页: {current_page_index + 1})")
            current_page_index += num_pages

        except Exception as e:
            print(f"处理 {pdf_path.name} 失败: {e}")

    # 4. 二进制流落盘写入
    output_path = Path(output_filepath)
    output_path.parent.mkdir(parents=True, exist_ok=True)

    with open(output_path, "wb") as f_out:
        writer.write(f_out)

    print(f"PDF合并完毕!累计总页数: {current_page_index},输出总册: {output_filepath}")

# 示例调用
# merge_pdf_documents_with_bookmarks('./contract_parts', './最终审计总册.pdf')pypdf 专长于页面级组装、页面裁剪、旋转与书签控制。若业务场景涉及从扫描仪生成的“纯图片PDF”中提取具体文字或表格,则属于图像OCR领域,必须搭配 pytesseract 或专门的文档理解模型处理,单纯依靠矢量PDF库只能提取到空白文本。
五、工程实践总结与技术选型避坑清单
将上述三个实战场景串联起来,就构成了一套典型的企业级“月结/年结自动化工作流”:从各处汇总Excel并计算清洗 → 生成个性化对账单并转为PDF → 通过邮件自动分发至客户与员工。但在自动化程序长期无人值守运行的过程中,往往会遇到边界异常。
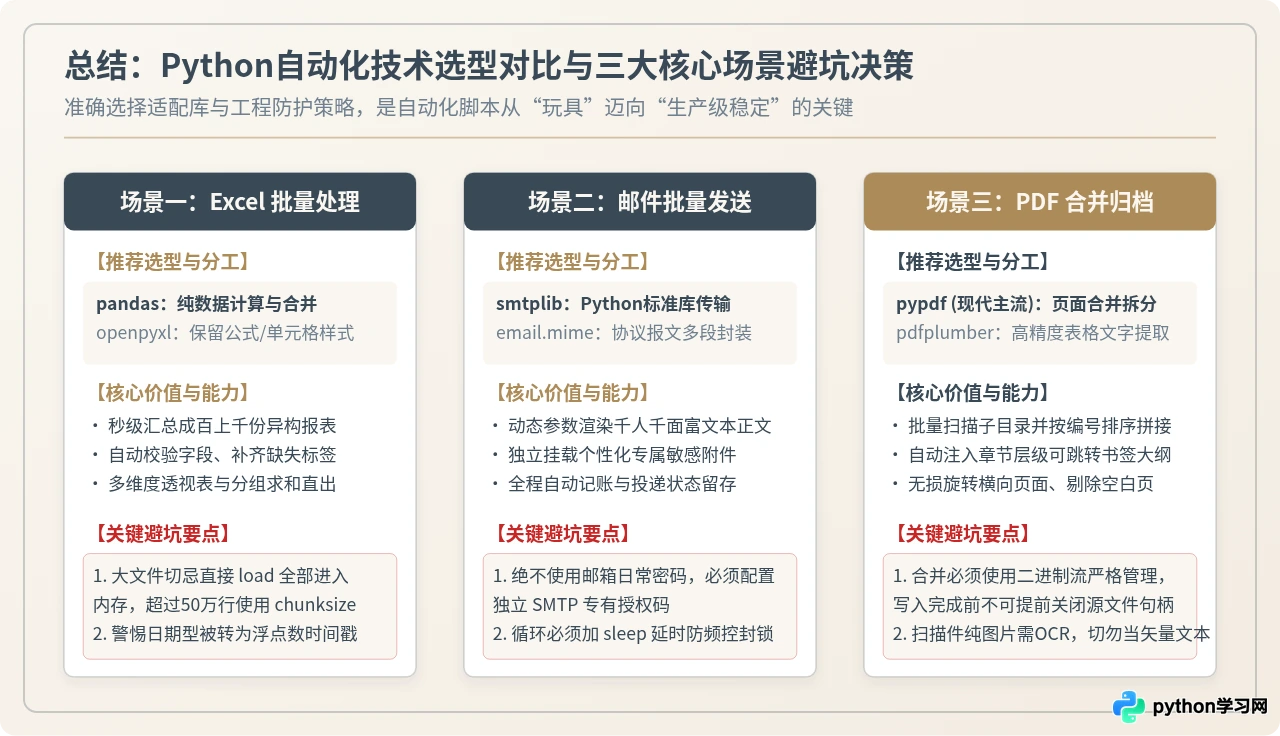
| 场景模块 | 标准技术栈 | 核心优势 | 高频踩坑点与防御方案 |
|---|---|---|---|
| Excel批量聚合 | pandas + openpyxl |
内存计算极快,轻松应对数十万行数据跨表运算 | 踩坑:表头名称存在多余空格导致字段对不齐。 防御:使用 df.columns.str.strip() 并在读入前预先标准化。 |
| 邮件批量直发 | smtplib + email.mime |
免安装第三方软件,原生支持SSL加密与参数化HTML渲染 | 踩坑:循环内无延时或循环建立连接被网关拉黑。 防御:外部保持单个会话连接,循环内显式加入 time.sleep(1.5)。 |
| PDF自动拼装 | pypdf (>=3.0) |
纯Python轻量化依赖,支持大纲书签树动态注入与页面纠偏 | 踩坑:中文文件名在部分系统解析报错或文件未正常关闭。 防御:统一采用 Path.glob() 并使用 with open(...) 确保句柄及时释放。 |
落地建议:从脚本化走向可复用资产
要让自动化真正服务于日常工作,建议在完成基础逻辑后,增加以下三项轻量工程设计:
- 参数外置化(配置文件化):将文件路径、邮件发信账号、定时执行周期等写在独立的
config.json中,避免每次变动都需要修改核心业务逻辑代码。 - 执行日志审计化(Logging):用 Python 原生
logging模块代替零散的print(),将每天的执行时间、处理成功条数、跳过的异常文件名以时间戳记录在本地日志文件中,便于出问题时随时调阅对账。 - 系统定时任务绑定:在 Windows 下利用“任务计划程序”(Task Scheduler),在 macOS / Linux 下利用
cron,设定工作日下班后或每周一早晨自动静默触发脚本,实现真正的无人值守自动化办公。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















