


Python异步爬虫实战:用aiohttp实现高并发数据抓取
深入浅出讲解如何基于Python的asyncio和aiohttp构建高并发、高可用异步爬虫,包含事件循环原理、连接池优化、Semaphore限流及重试容错实战。
一、异步与同步机制解析:为什么 aiohttp 吞吐率远超 requests
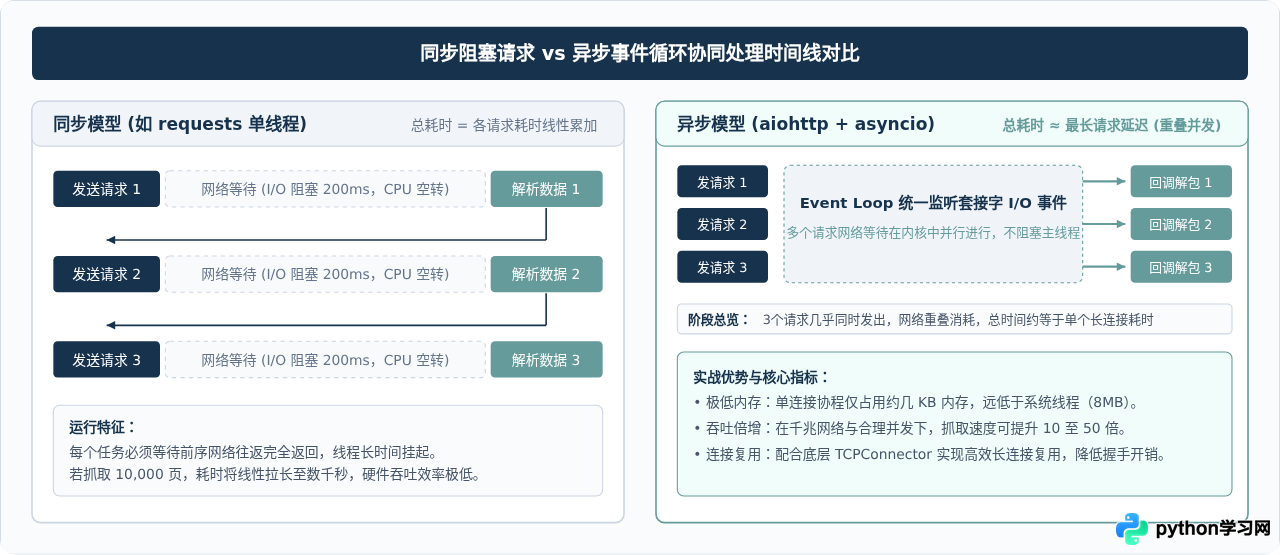
在标准的同步爬虫开发中,我们通常习惯使用 requests 库。每当调用 requests.get() 时,程序所在的线程便会进入操作系统级别的“阻塞等待”状态,直到远端服务器处理完毕并将全部字节流经由网卡返回给本地缓冲区,后续代码才能继续执行。在单次抓取耗时 200 毫秒的网络环境中,CPU 实际用于处理数据的时间通常不足 1 毫秒,剩余超过 99% 的时间均被白白浪费在空转等待上。
虽然多线程或多进程可以通过并行发起请求来弥补等待时间,但操作系统分配每个系统线程通常需要占用 8MB 左右的虚拟内存,上千个线程还会引发极其剧烈的 CPU 上下文切换消耗。
与此不同,基于 asyncio 和 aiohttp 的异步模型采用“事件循环(Event Loop)+ 非阻塞套接字(Non-blocking Socket)”体系。当协程发起一个 HTTP 请求后,并不等待响应结果,而是通过 await 关键字主动交出 CPU 执行权,事件循环立刻切换去调度执行下一个抓取协程。当某个连接的网络数据到达并触发套接字就绪事件时,事件循环会及时唤醒挂起在该事件上的协程继续读取解析。这种单线程协作式多任务调度,将网络 I/O 等待时间完美重叠,单机即可轻松维持数百至上千的稳定并发。
二、核心准备与组件生命周期:ClientSession 正确用法
编写 aiohttp 爬虫时,首先要正确管理 ClientSession。初学者常犯的一个严重错误是在每一个采集协程中都临时创建一个新的 Session 对象,如下所示:
# 错误示范:每次调用都新建并销毁 Session,导致连接池无法复用且引发连接泄漏
async def fetch_bad(url):
    async with aiohttp.ClientSession() as session:
        async with session.get(url) as resp:
            return await resp.text()
ClientSession 的内部封装了一个连接池(Connection Pool),负责管理底层 TCP 连接的建立、复用(HTTP Keep-Alive)和关闭。如果在每个请求里重复新建 Session,每次请求都会重新执行完整的 TCP 三次握手和 TLS 握手,不仅性能骤降,还会导致大量本地套接字停留在 TIME_WAIT 状态,最终耗尽系统的临时端口。
正确规范:在整个爬虫生命周期中,通常只需要初始化一个共享的 ClientSession,将其作为参数传递给所有的抓取协程,在所有任务全部完成后再统一关闭。
三、高并发爬虫四步走架构
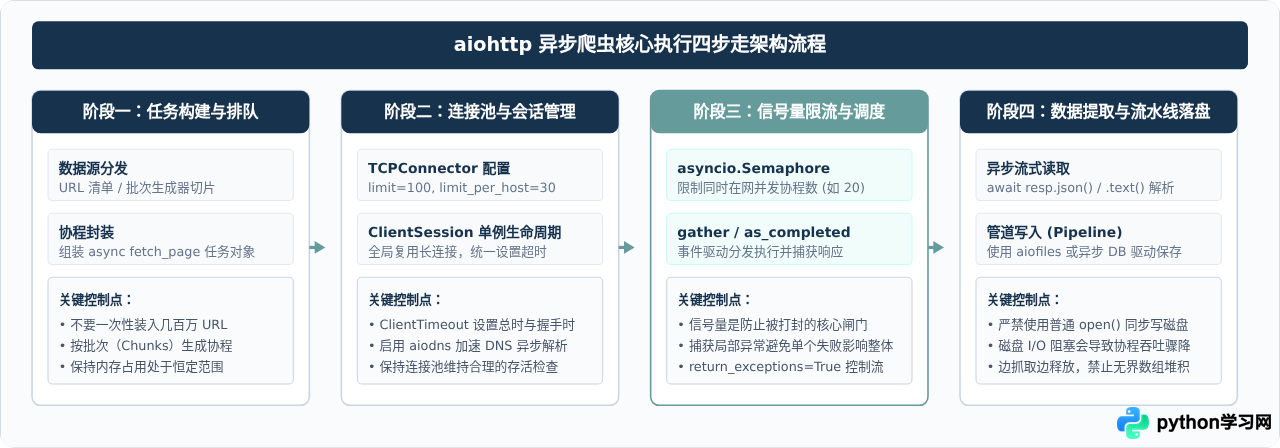
一个可在生产环境稳定落地的异步爬虫,不能仅仅简单地将所有 URL 包装为 Task 扔进 asyncio.gather。没有流量管制的并发会瞬间打满操作系统的文件描述符(触发 OSError: Too many open files),或者直接因触发对方服务器防护机制而被封禁 IP。
成熟的高并发爬虫应当遵循四个清晰的阶段设计:
四、实战代码:带信号量限流与连接池的高并发采集器
下面是一个完整的、工业级标准的可运行异步爬虫核心代码。该示例通过 TCPConnector 配置连接池大小,利用 asyncio.Semaphore 严格限制在网的瞬时请求数量,并对网络超时进行了细粒度定义。
import asyncio
import aiohttp
from typing import List, Dict, Any, Optional

class AsyncScraper:
    def __init__(self, max_concurrency: int = 20, max_keepalive: int = 100):
        """
        :param max_concurrency: 信号量限制的在网瞬时最大请求数
        :param max_keepalive: 连接池允许维持的最大 TCP 连接数
        """
        self.semaphore = asyncio.Semaphore(max_concurrency)
        self.connector = aiohttp.TCPConnector(
            limit=max_keepalive,          # 全局最大连接数
            limit_per_host=10,            # 单个目标域名最大连接数,防止单点压力过大
            ttl_dns_cache=300             # DNS 解析缓存 5 分钟
        )
        self.timeout = aiohttp.ClientTimeout(
            total=15,                     # 请求总超时时间(秒)
            connect=5,                    # 建立连接握手超时(秒)
            sock_read=10                  # 读取数据包超时(秒)
        )
        self.session: Optional[aiohttp.ClientSession] = None

    async def init_session(self):
        """初始化全局共享的 ClientSession"""
        headers = {
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
        }
        self.session = aiohttp.ClientSession(
            connector=self.connector,
            timeout=self.timeout,
            headers=headers
        )

    async def fetch(self, url: str) -> Optional[Dict[str, Any]]:
        """带信号量保护的单个页面抓取函数"""
        # 进入信号量:如果已有 max_concurrency 个协程在运行,其他协程在此排队挂起
        async with self.semaphore:
            if self.session is None:
                raise RuntimeError("Session 尚未初始化,请先调用 init_session")

            try:
                async with self.session.get(url) as response:
                    if response.status == 200:
                        content = await response.text()
                        return {"url": url, "status": 200, "length": len(content)}
                    else:
                        return {"url": url, "status": response.status, "length": 0}
            except asyncio.TimeoutError:
                # 单独捕获超时异常
                return {"url": url, "status": -1, "error": "Timeout"}
            except aiohttp.ClientError as err:
                # 捕获 aiohttp 底层网络连接异常(DNS失败、连接重置等)
                return {"url": url, "status": -2, "error": str(err)}

    async def run(self, urls: List[str]):
        """主执行流程:调度成批抓取任务"""
        await self.init_session()
        try:
            tasks = [asyncio.create_task(self.fetch(u)) for u in urls]
            # gather 并发调度全部任务,保留执行结果
            results = await asyncio.gather(*tasks, return_exceptions=True)
            return results
        finally:
            # 必须安全关闭 Session 与 Connector
            if self.session:
                await self.session.close()

# 运行验证入口
if __name__ == "__main__":
    target_urls = [f"https://httpbin.org/get?page={i}" for i in range(1, 51)]
    scraper = AsyncScraper(max_concurrency=10)

    # Python 3.7+ 推荐运行方式
    results = asyncio.run(scraper.run(target_urls))
    success_count = sum(1 for r in results if isinstance(r, dict) and r.get("status") == 200)
print(f"总计划抓取: {len(target_urls)}, 成功返回: {success_count}")async with self.semaphore:是控制并发的关键守卫。无论你用asyncio.gather提交了 1 万个任务,当前瞬时向外发起网络连接的永远不会超过 20 个。return_exceptions=True:默认情况下,gather中只要有一个协程抛出未捕获的异常,整个gather会立即中断。开启该参数后,异常会被作为返回值装入结果列表,保证其他正常的协程继续跑完。
五、异常处理与智能重试机制:保障高可用抓取
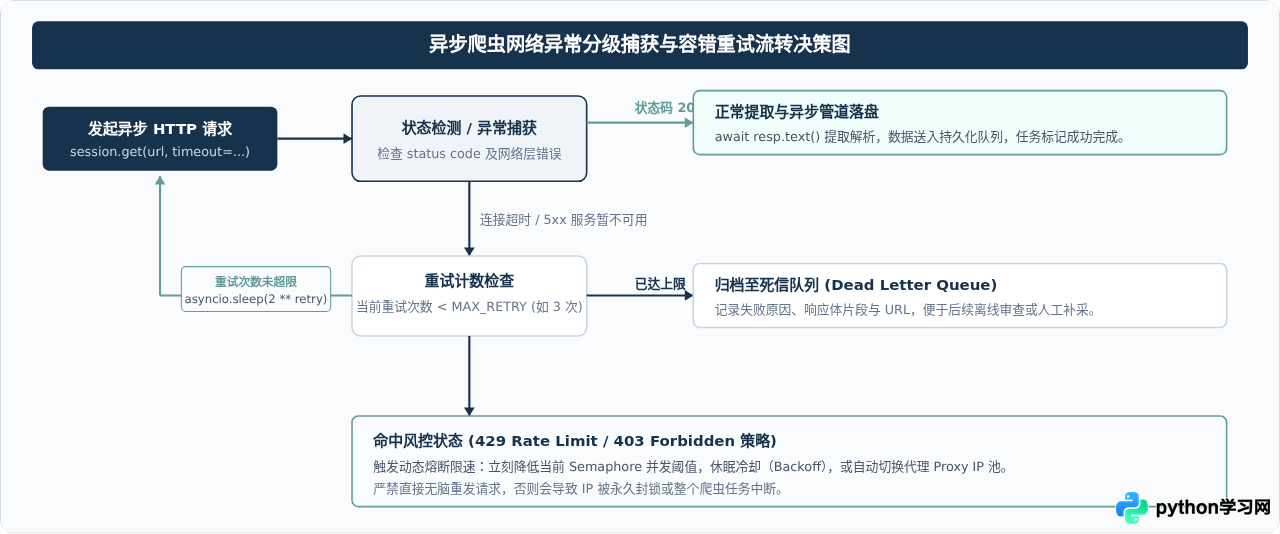
在大规模数据采集场景下,网络抖动、DNS 偶发超时、目标服务器负载过高导致的 502/503 或频控 429 是不可避免的。一个成熟的爬虫不能因单个 URL 的网络失败而直接抛弃任务,需要有明确的分级异常捕获与退避重试策略。
编写健壮的异步重试包装器
在实际编写爬虫时,我们可以使用重试装饰器或封装重试函数。以下是通过指数退避(Exponential Backoff)实现的安全重试模式:
async def fetch_with_retry(session: aiohttp.ClientSession, url: str, max_retries: int = 3) -> Optional[str]:
    """带有指数退避机制的稳健抓取函数"""
    for attempt in range(1, max_retries + 1):
        try:
            async with session.get(url) as response:
                if response.status == 200:
                    return await response.text()
                elif response.status == 429:
                    # 遭遇频控,按更长间隔退避冷却
                    wait_time = 5 * attempt
                    await asyncio.sleep(wait_time)
                elif 500 <= response.status < 600:
                    # 服务器临时内部错误,退避重试
                    wait_time = 1.5 ** attempt
                    await asyncio.sleep(wait_time)
                else:
                    # 404 等不可恢复的客户端错误,直接放弃重试
                    return None
        except (aiohttp.ClientError, asyncio.TimeoutError):
            if attempt == max_retries:
                # 记录最终失败日志,交由后续补偿机制处理
                return None
            # 指数退避等待后重试(如 1s, 2s, 4s...)
            await asyncio.sleep(1.0 * (2 ** (attempt - 1)))
    return None
六、高并发场景生产级避坑指南与架构全景
在真实的大规模生产环境中运行 Python 异步爬虫,除了代码语法外,系统环境与资源调度层面的细节同样决定了爬虫任务的成败。
七、总结
构建基于 aiohttp 的异步爬虫绝非简单地给函数加上 async 与 await。其核心竞争力来自于对事件循环运行模式的理解与对系统资源边界的精准管控:
- 机制选择:在网络 I/O 密集型任务中,异步事件驱动以极低内存和极小上下文切换代价,将网络等待时间完全折叠,是高并发抓取的首选方案。
- 组件复用:确保
ClientSession的全局唯一性与连接池生命周期管理,最大化利用底层 TCP Keep-Alive。 - 流量节流:始终使用
asyncio.Semaphore设立在网并发闸门,并搭配合理的ClientTimeout与指数退避重试,兼顾抓取效率与程序稳定性。 - I/O 解耦:杜绝在协程循环中混入同步磁盘写入或耗时 CPU 密集型任务,保持事件循环的快速流转。
按照上述架构与工程规范编写的爬虫,能够在有限的单机计算资源下平稳达到数千 QPS,轻松应对绝大多数企业级数据抓取需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















