


Python常用序列结构有哪些:列表、元组与字符串详解
深入解析Python核心序列结构:列表、元组与字符串的底层特征、常用操作、内存机制与多维对比,结合推导流程与选型指引,助你掌握Python序列的高效运用。
在 Python 编程中,序列(Sequence)是指一组具有固定先后顺序、可以通过整数下标访问特定位置项的有序数据集合。在日常业务逻辑和算法处理中,使用频率最高且内置于语言核心的三种序列结构分别是:字符串(str)、列表(list)与元组(tuple)。理解这三者的底层异同、操作边界与内存行为,是写出健壮且高性能 Python 代码的基础。
一、序列的公共基础特性与核心抽象
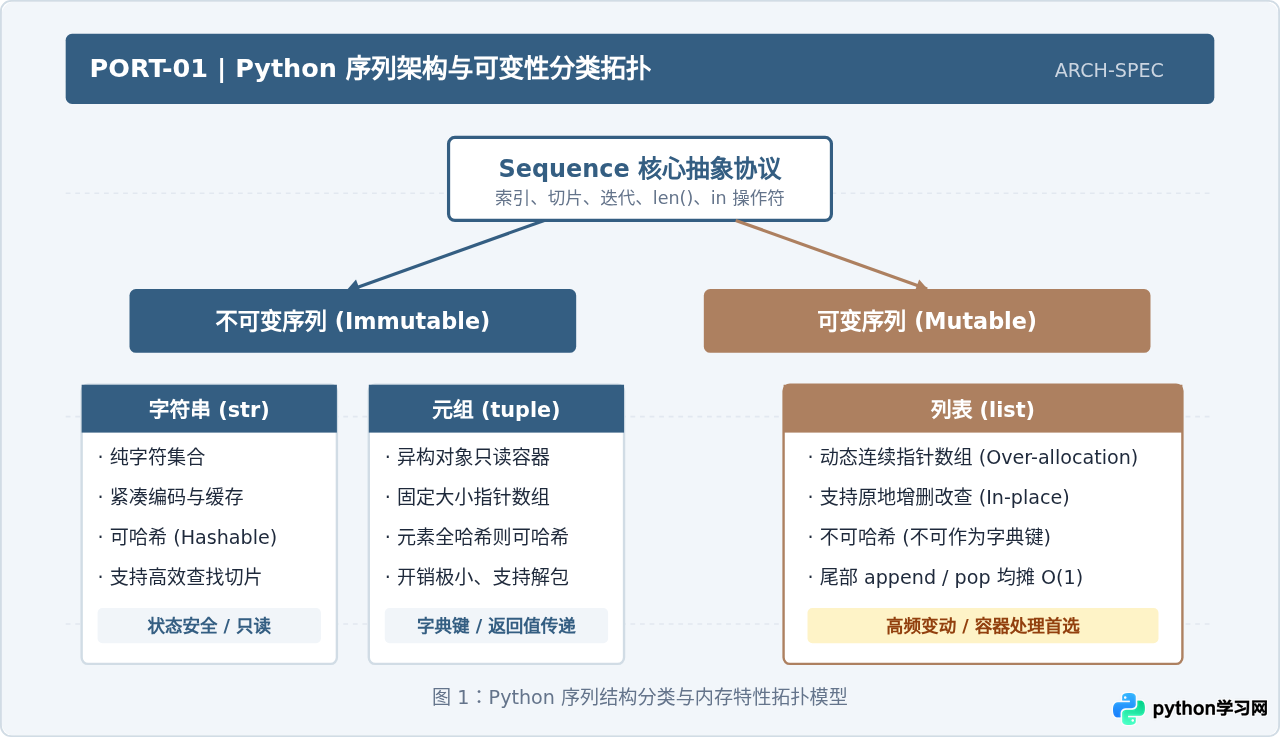
无论列表、元组还是字符串,作为序列类型都天然具备一组通用的操作范式:
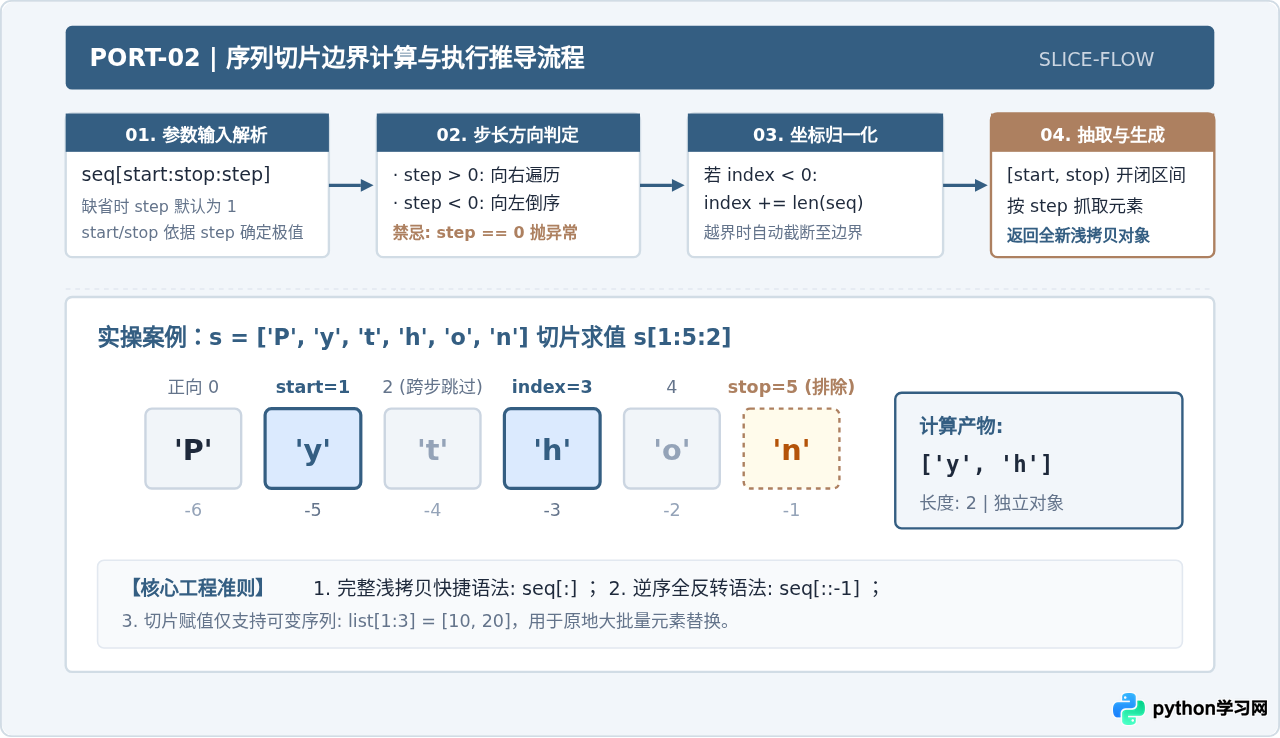
- 双向索引访问:从左往右以
0开始(0, 1, ..., n-1),从右往左以-1开始(-1, -2, ..., -n)。 - 切片支持:通过
seq[start:stop:step]语法截取子序列。 - 通用运算符与内置函数:支持连接
+、重复*、成员检测in / not in,以及len()、min()、max()等内置计算。
然而,它们之间最关键的分水岭在于可变性(Mutability)。列表是可变序列(Mutable),其内部元素可以在保持对象 ID 不变的前提下被追加、替换或剔除;而字符串与元组则是不可变序列(Immutable),一旦分配完成,内存中的原始数据内容不可更动,任何修改逻辑都必然产生全新的对象。
二、字符串(str):不可变的文本序列
在 Python 3 中,str 是由 Unicode 字符组成的有序序列。每一个字符在底层按照其最大码位以 1、2 或 4 字节的紧凑形式(PEP 393 灵活字符串表示)存储。
1. 常用操作与规范代码示例
字符串不能通过下标赋值直接修改。对字符串的操作通常依赖其丰富的方法族:
# 1. 基础声明与索引
text = "Python-Sequence"
first_char = text[0]    # 'P'
last_char = text[-1]    # 'e'

# 2. 分割与合并
parts = text.split("-")         # ['Python', 'Sequence']
rejoined = "::".join(parts)      # 'Python::Sequence'

# 3. 规整化与替换
raw_data = "  user_001 \n"
clean_data = raw_data.strip()   # 'user_001'
replaced = clean_data.replace("001", "999")  # 'user_999'

# 4. 字符串格式化 (推荐 f-string)
version = 3.12
info = f"Env: Python {version}, Status: Ready"first_char: 'P'
rejoined: 'Python::Sequence'
replaced: 'user_999'
info: 'Env: Python 3.12, Status: Ready'
+= 拼接字符串由于字符串不可变,每次使用
+= 都会向系统申请新内存并拷贝原有内容,时间复杂度会恶化为 \(O(n^2)\)。处理大量字符流或循环拼接时,应先将分段存入列表,最后统一调用 ''.join(list_obj) 完成拼接。
三、列表(list):灵活高效的可变动态数组
list 是 Python 中最常用的通用数据容器。其底层并非链表,而是一个动态分配的指针数组。数组内部保存着指向各个元素的指针地址,因此列表可以存放异构对象,且通过下标访问任意元素的时间复杂度恒为 \(O(1)\)。
1. 核心增删改操作
列表提供了丰富的原位(in-place)修改方法,调用这些方法不会创建新列表,而是直接更改原数组:
# 1. 创建与初始化
fruits = ["apple", "banana"]

# 2. 尾部追加与批量扩展
fruits.append("cherry")           # 添加单元素: ['apple', 'banana', 'cherry']
fruits.extend(["date", "fig"])    # 批量合并: ['apple', 'banana', 'cherry', 'date', 'fig']

# 3. 插入与删除
fruits.insert(1, "blueberry")     # 指定索引插入 (移动后续元素,O(n))
popped_item = fruits.pop()        # 弹出尾部元素 'fig' (O(1))
fruits.remove("apple")            # 按值删除首个匹配项

# 4. 原位排序与反转
scores = [88, 62, 95, 74]
scores.sort()                     # 原地升序: [62, 74, 88, 95]
scores.reverse() # 原地倒序: [95, 88, 74, 62]fruits 最终内容: ['blueberry', 'banana', 'cherry', 'date']
scores 最终内容: [95, 88, 74, 62]
append() 与 extend()list.append(item) 会将参数作为单一元素加入末尾;如果传入的是另一个列表,会形成嵌套列表(如 [1, 2, [3, 4]])。若需展平添加元素,必须使用 list.extend(iterable)。
四、元组(tuple):轻量只读的不可变序列
tuple 的语法表现为逗号分隔的元素对。它的底层同样是对象指针数组,但长度与内容在初始化后完全锁定,无法添加、删除或重新赋值。
1. 声明与解包特性
元组最强大的特性之一是优雅的“多值打包与解包”(Unpacking):
# 1. 声明与单元素注意点
empty_tup = ()
single_tup = (42,)      # 必须带逗号,若写成 (42) 则会被判定为普通括号表达式中的整数
point = (10, 20, 30)

# 2. 序列解包
x, y, z = point         # x=10, y=20, z=30

# 3. 扩展解包 (带 * 操作符)
record = ("Node-A", 192, 168, 1, 100)
name, *ip_bytes = record
# name = "Node-A"
# ip_bytes = [192, 168, 1, 100]x: 10, y: 20, z: 30
name: 'Node-A', ip_bytes: [192, 168, 1, 100]
2. 元组与字典键(Hashable 条件)
Python 字典的键(Key)和集合(Set)的元素要求必须是可哈希对象(Hashable)。不可变的字符串和整型天然可哈希。而元组只有在其内部所包含的所有元素均可哈希时,自身才是可哈希的:
# 合法:元素全为不可变类型
valid_key = (1, "config", 8080)
route_map = {valid_key: "Service-Running"}

# 非法抛错:元组内包含列表(可变对象)
invalid_key = (1, [2, 3])
try:
    bad_dict = {invalid_key: "Error"}
except TypeError as e:
print(f"抛出异常: {e}")抛出异常: unhashable type: 'list'
五、序列通用切片机制与边界推导原理
切片是 Python 序列操作中最具表现力的语法之一。其标准形式为 seq[start:stop:step],核心遵循左闭右开区间(包含 start,不包含 stop)与步长位移法则。
六、列表、元组与字符串的多维特性对比
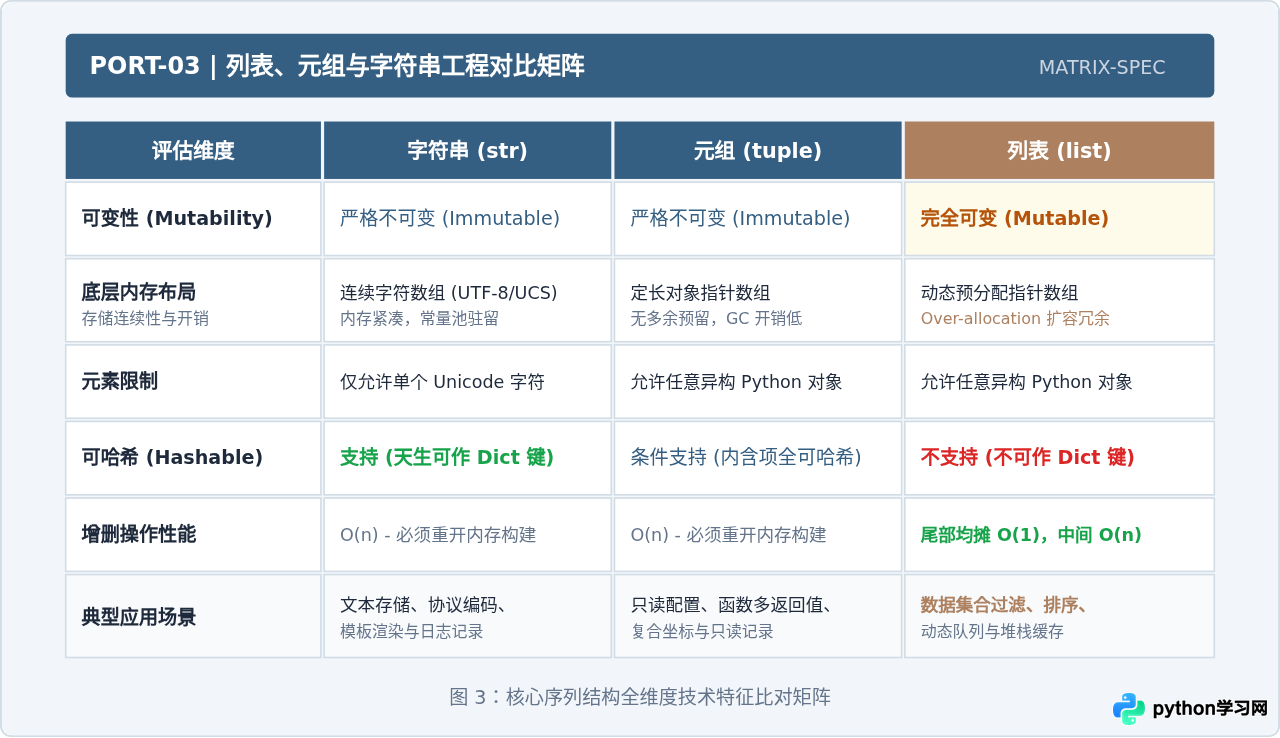
在设计系统模型与工程接口时,选择何种序列直接关系到系统内存占用、线程安全以及执行效率。以下从底层实现、性能特征及使用约束三个维度展开全面比对:
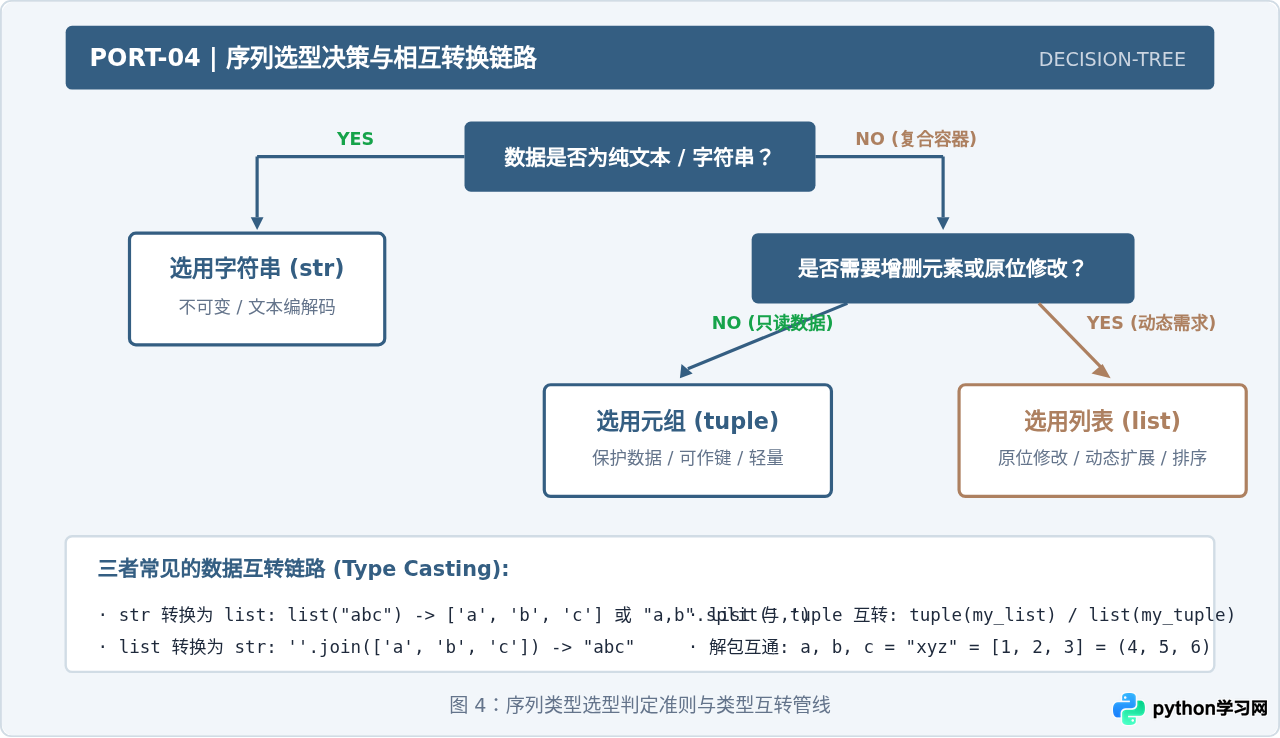
七、工程选型指南与场景决策树
在面对具体的业务场景时,应当遵循“最小权限与最匹配语义”的选型原则:
- 若数据表达的是自然文本、编码或字符标识:毫不犹豫选择
str。 - 若数据集合在初始化后不应被修改:例如经纬度坐标
(lng, lat)、数据库连接参数、多返回值返回等,优先选择tuple。元组不仅能向协同开发者传达“只读防篡改”的语义契约,还能节省内存并具备更高的迭代微观速度。 - 若数据需要动态伸缩、原地过滤或重排序:选择
list。这是绝大多数业务数据流(如 ORM 查询结果列表、批量任务收集)的标准载体。
八、三大常见工程陷阱与排查避坑
陷阱 1:列表乘法引发的浅拷贝浅引用灾难
在初始化多维列表(矩阵)时,初学者极易写出 [[0] * 3] * 3。由于外层乘法复制的是内部列表的指针引用,导致修改任意一行都会同步影响所有行:
# 错误方式:3 个子列表指向同一块堆内存
bad_matrix = [[0] * 3] * 3
bad_matrix[0][0] = 99
# bad_matrix 变为 [[99, 0, 0], [99, 0, 0], [99, 0, 0]]

# 正确方式:使用列表推导式生成独立的子列表对象
correct_matrix = [[0] * 3 for _ in range(3)]
correct_matrix[0][0] = 99
# correct_matrix 结果为 [[99, 0, 0], [0, 0, 0], [0, 0, 0]]
陷阱 2:遍历列表时原位删除元素导致漏检
在 for item in my_list: 循环体内直接执行 my_list.remove(item) 会改变列表长度与后续元素的偏移量,导致指针前移漏掉紧随其后的元素。正确做法是使用列表推导式生成新列表,或逆序遍历 for i in range(len(my_list)-1, -1, -1):。
陷阱 3:不可变元组中包含可变列表的“增量赋值异常”
如果元组包含列表元素:t = (1, [10, 20]),执行 t[1] += [30] 时,Python 会首先完成列表的原地扩展(列表内容实际变成了 [10, 20, 30]),但在试图将结果写回元组 t[1] 时抛出 TypeError: 'tuple' object does not support item assignment。因此,应严格避免在元组中嵌套可变对象进行变动操作。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















