


Python爬虫入门:requests+BeautifulSoup静态页面抓取代码示例
本教程针对初学者详细讲解如何使用 Python 的 requests 与 BeautifulSoup 库抓取静态网页。包含环境安装、HTTP 请求发送、DOM 树节点定位、数据清洗及完整可运行的代码示例与避坑指南。
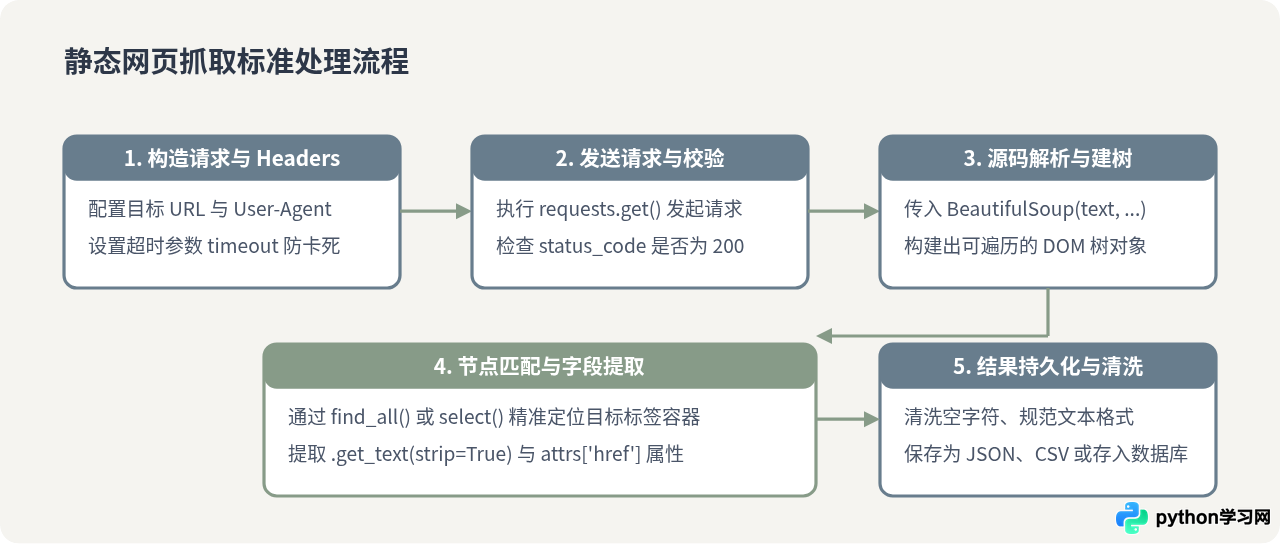
静态页面抓取是指直接向目标网站的服务器发送 HTTP GET 请求,获取服务端预先渲染完整的 HTML 文本,并在客户端通过解析器提取所需数据的技术。在 Python 生态中,requests 负责高效、稳定地建立网络连接与传输文本,而 BeautifulSoup 则将杂乱的 HTML 字符串构建为结构化树形文档,提供便捷的节点查找接口。本文将从运行原理、环境准备、核心方法到完整代码逐层展开,帮助读者掌握静态网页抓取的基础技能。
一、准备工作与依赖安装
在进行爬虫编写前,需在 Python 环境中安装第三方网络请求库 requests 与 HTML 解析库 beautifulsoup4。若需要更高效的底层解析,还可以选装 lxml 解析器。
打开终端或命令行工具,执行以下安装命令:
pip install requests beautifulsoup4 lxml安装完成后,这两个库的具体分工如下:
- requests:封装了底层 HTTP 协议的复杂细节,负责向目标服务器发送 GET、POST 等请求,并接收包含状态码、响应头与 HTML 源码的 Response 对象。
- BeautifulSoup:专门用于从 HTML 或 XML 文件中提取数据。它能够自动将输入文档转换为 Unicode 编码,并依据标签层级建立树状对象模型(DOM)。
二、步骤一:使用 requests 发送 HTTP 请求
获取网页内容的第一步是向服务器索取 HTML 文本。实际编写时,不能直接裸奔调用 requests.get(url),必须配置基础请求头并做好异常保护。
1. 配置 User-Agent 请求头
默认情况下,requests 发送的 HTTP 请求头中的 User-Agent 会标识为类似 python-requests/2.x.x。多数 Web 服务器或安全防护策略会直接阻断或返回 403 Forbidden 错误。因此,必须将其伪装为常规浏览器的标识。
2. 设置超时时间与检查状态码
网络请求可能因目标服务器故障或网络波动产生长时间挂起,参数 timeout 确保在指定秒数内无响应时主动抛出异常。请求发出后,使用 response.status_code 判断请求是否成功(状态码 200 表示成功)。
import requests

target_url = "https://example.com/books"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

try:
    response = requests.get(target_url, headers=headers, timeout=10)
    # 自动识别编码,防止中文出现乱码
    response.encoding = response.apparent_encoding

    if response.status_code == 200:
        html_content = response.text
        print("成功获取 HTML 源码,字节长度:", len(html_content))
    else:
        print(f"请求失败,HTTP 状态码: {response.status_code}")
except requests.exceptions.RequestException as e:
    print(f"网络请求发生异常: {e}")
三、步骤二:使用 BeautifulSoup 解析 DOM 树
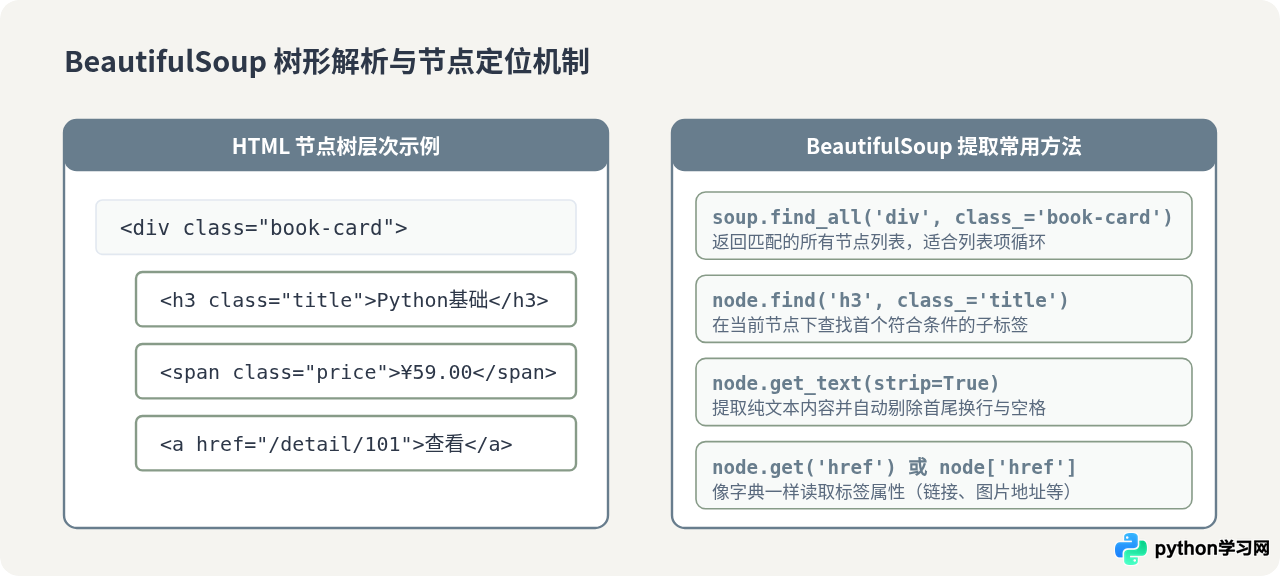
获取到 response.text 字符串后,需要将其解析为对象模型。BeautifulSoup 支持多种解析器,最常用的是 Python 内置的 html.parser 以及更快速容错的 lxml。
1. 查找元素的核心方法
find(tag, attrs):仅返回符合条件的第一个元素;未找到时返回None。find_all(tag, attrs):返回包含所有符合条件元素的列表;未找到时返回空列表[]。select(selector):使用 CSS 选择器语法查找。例如soup.select('div.book-card > h3.title'),语法更灵活,适合熟悉前端的开发者。
2. 提取文本与属性值
定位到特定标签对象后:
- 通过
.get_text(strip=True)或.text.strip()提取标签内的可见文字。 - 通过
tag.get('href')提取属性。推荐优先使用.get()方法,若属性不存在会返回None,避免直接使用tag['href']抛出KeyError异常。
四、核心差异辨析:静态抓取与动态异步渲染
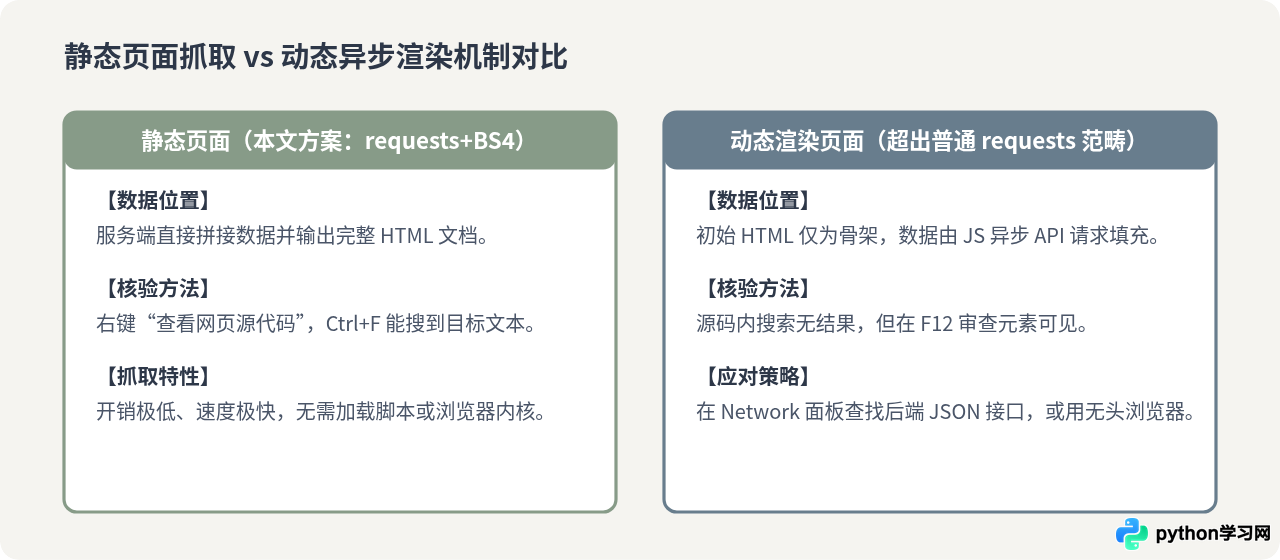
在开始抓取前,必须明确目标网页的生成原理。网络页面通常分为静态直出页面与动态异步渲染页面,两者的底层加载机制存在决定性差异。
这种差异为什么重要?因为工具的选择完全取决于页面的呈现方式:
- 使用 requests + BeautifulSoup 的适用条件:目标页面的 HTML 源代码中已包含了目标数据。如果页面是纯静态或由服务端模板引擎(如 Django、JSP、PHP)直接直出的,使用此组合是最轻量、最高效的方式。
- 限制条件:如果目标页面是单页面应用(SPA,如 Vue 或 React 开发),初始 HTML 只包含空标签与 JavaScript 脚本文件,直接用 requests 抓取到的只是一个空白框架,无法找到目标内容。此时需要通过开发者工具分析其背后的 API 接口,或者使用 Selenium/Playwright 等浏览器自动化引擎。
五、完整实战代码示例
下面是一个完整的、具备基础工业容错的静态爬虫代码示例。为了方便读者直接运行验证,本示例包含了模拟标准静态 HTML 结构的处理函数与真实请求流程逻辑:
import time
import requests
from bs4 import BeautifulSoup

def scrape_book_list(target_url):
    """
    抓取图书展示页面的书名、价格及详情链接
    """
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/122.0.0.0 Safari/537.36"
        ),
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    try:
        # 1. 发起网络请求并设置 10 秒超时
        response = requests.get(target_url, headers=headers, timeout=10)

        # 2. 检查网络响应状态码
        if response.status_code != 200:
            print(f"[错误] 请求失败,HTTP 状态码为: {response.status_code}")
            return []

        # 3. 自动纠正编码
        response.encoding = response.apparent_encoding
        html_doc = response.text

    except requests.exceptions.Timeout:
        print("[错误] 网络请求超时,请检查网络连接或目标地址")
        return []
    except requests.exceptions.RequestException as exc:
        print(f"[错误] 请求过程中发生不可恢复异常: {exc}")
        return []

    # 4. 解析 HTML 构建 DOM 树
    soup = BeautifulSoup(html_doc, "html.parser")

    # 5. 定位包含列表数据的容器节点(以 class="product_pod" 为例)
    items = soup.find_all("article", class_="product_pod")
    results = []

    for item in items:
        # 防御性解析:查找标题元素
        title_tag = item.find("h3")
        title = ""
        link = ""
        if title_tag:
            a_tag = title_tag.find("a")
            if a_tag:
                # 优先获取 title 属性,没有则提取文本
                title = a_tag.get("title") or a_tag.get_text(strip=True)
                link = a_tag.get("href", "")

        # 查找价格元素
        price_tag = item.find("p", class_="price_color")
        price = price_tag.get_text(strip=True) if price_tag else "N/A"

        # 仅在关键字段存在时记录
        if title:
            results.append({
                "title": title,
                "price": price,
                "link": link
            })

    return results

if __name__ == "__main__":
    # 该网址为爬虫入门常用的公共静态测试站点
    demo_url = "http://books.toscrape.com/"

    print("开始抓取测试网页...")
    books = scrape_book_list(demo_url)

    print(f"\n抓取完成,共提取到 {len(books)} 本图书信息:")
    for idx, b in enumerate(books[:5], start=1):
        print(f"[{idx}] 书名: {b['title']} | 价格: {b['price']} | 链接: {b['link']}")

    # 礼貌爬取间隔(当有后续多页遍历时必加)
    time.sleep(1)
示例运行结果输出
开始抓取测试网页...

抓取完成,共提取到 20 本图书信息:
[1] 书名: A Light in the Attic | 价格: £51.77 | 链接: catalogue/a-light-in-the-attic_1000/index.html
[2] 书名: Tipping the Velvet | 价格: £53.74 | 链接: catalogue/tipping-the-velvet_999/index.html
[3] 书名: Soumission | 价格: £50.10 | 链接: catalogue/soumission_998/index.html
[4] 书名: Sharp Objects | 价格: £47.82 | 链接: catalogue/sharp-objects_997/index.html
[5] 书名: Sapiens: A Brief History of Humankind | 价格: £54.23 | 链接: catalogue/sapiens-a-brief-history-of-humankind_996/index.html
六、爬虫编写常见陷阱与避坑清单
初学者在编写抓取脚本时,常常因为忽略了网页结构的动态变化或请求礼仪而导致程序崩溃或 IP 受限。以下是静态爬虫开发的关键检查清单:
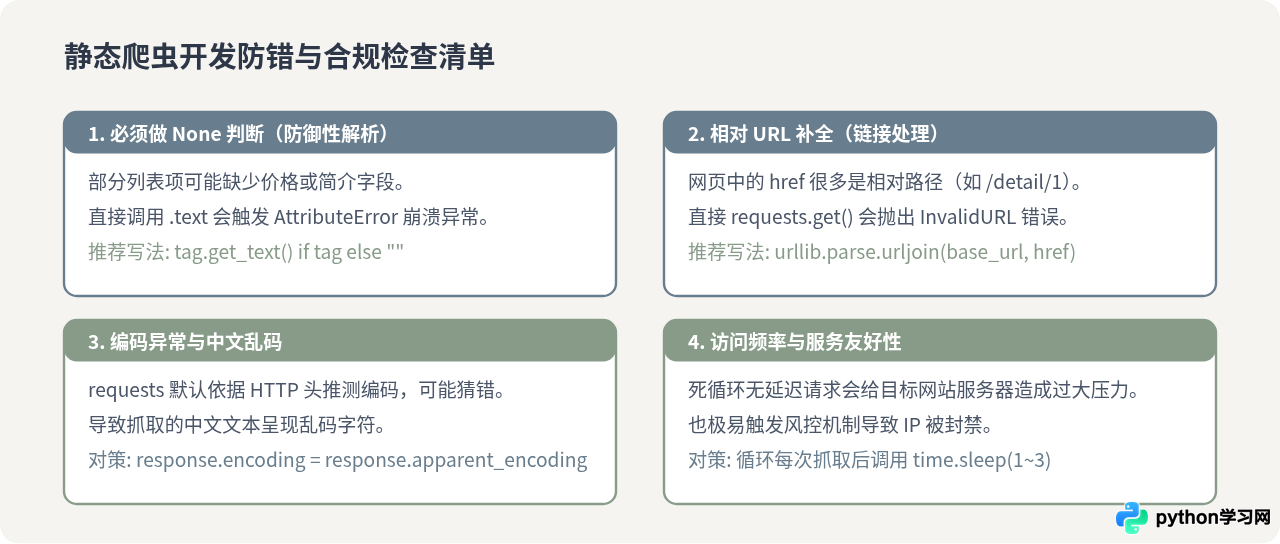
robots.txt 协议,尊重版权声明与服务条款。合理控制抓取频率,避免在业务高峰期大量发起并发请求,做到合规、礼貌抓取。
掌握了 requests 发起请求与 BeautifulSoup 解析 DOM 的协同工作机制后,读者便具备了处理绝大多数静态结构化网页的能力。当遇到更加复杂的分页、登录鉴权或文件下载需求时,只需在此核心流程上扩展会话管理(requests.Session)或参数拼装逻辑即可。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















