


Python学习遇到瓶颈怎么突破?从调包侠到源码阅读的能力跃迁路径
针对Python开发者从依赖第三方库到深入底层源码的学习瓶颈,提供清晰的能力跃迁路径、调试追踪技巧与经典源码剖析方法。
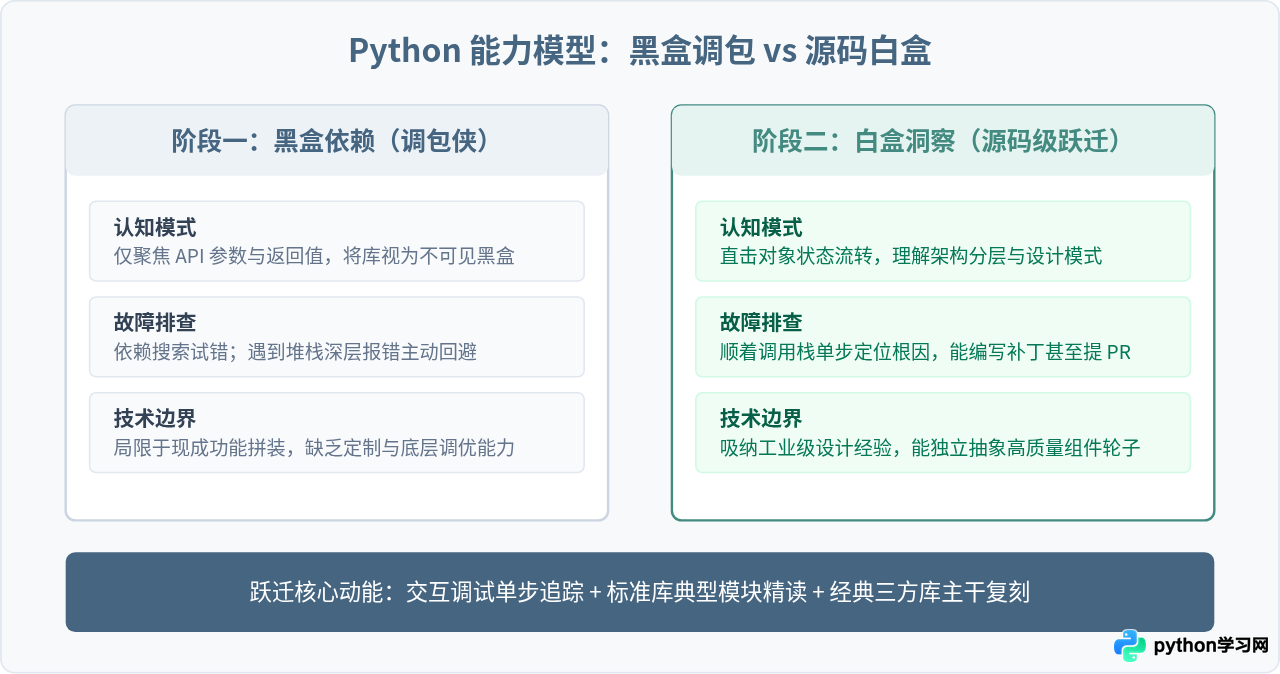
突破 Python 进阶瓶颈的核心,在于完成从“黑盒调用”到“白盒追踪”的思维转变:不再停留在记忆 API 参数和拼接三方库,而是掌握利用交互式调试、断点单步跟踪和关键调用链梳理深入底层实现的能力,建立清晰的内部对象模型与设计认知。
一、瓶颈诊断:为什么长期停留在“调包侠”阶段?
许多 Python 开发者在经历语法入门和几个业务项目的开发后,往往会陷入一种停滞状态:常用库如 Requests、Flask、Pandas 的接口调用非常熟练,但一旦遇到官方文档未覆盖的异常行为、性能瓶颈或者多线程上下文冲突,便只能依赖搜索引擎碰运气,难以快速推导出根本原因。
这种瓶颈通常由以下三个深层原因导致:
- 认知舒适区过窄:第三方库提供了高度抽象的高级 API,隐藏了协议处理、对象生命周期及资源管理的细节,长期使用容易将三方库视作不可拆解的黑盒。
- 被动式排错习惯:面对 Traceback(错误堆栈)时,注意力只集中在自己编写的最后一行业务代码上,遇到指向三方库内部的报错就主动避开,缺乏顺藤摸瓜的探查意识。
- 核心机制感知断层:对 Python 自身的类加载、属性查找(MRO)、描述符、上下文管理器协议以及魔术方法缺少真实场景下的感知,难以将语言特性与工程架构联系起来。
二、第一阶段:工具准备与轻量溯源(建立探查直觉)
直接下载一个包含数十万行代码的庞大框架去生读,往往会在复杂的异常处理和类型兼容逻辑中丧失信心。要跨过心理障碍,首先要在日常开发中使用轻量级内置工具培养“探查直觉”。
1. 善用 Python 内置自省工具
Python 具备极其强大的运行时自省(Introspection)能力,无需外部插件就能快速定位任何对象的定义位置与继承关系:
import inspect
import requests

# 1. 快速查看函数或类的实际定义源码所在文件
print(inspect.getfile(requests.Session))
# 示例输出: /path/to/site-packages/requests/sessions.py

# 2. 查看类的继承顺序列表 (MRO)
print(requests.Session.__mro__)

# 3. 在控制台直接获取函数定义的完整源码文本
print(inspect.getsource(requests.get))
2. 解除 IDE 的“仅我的代码”隔离
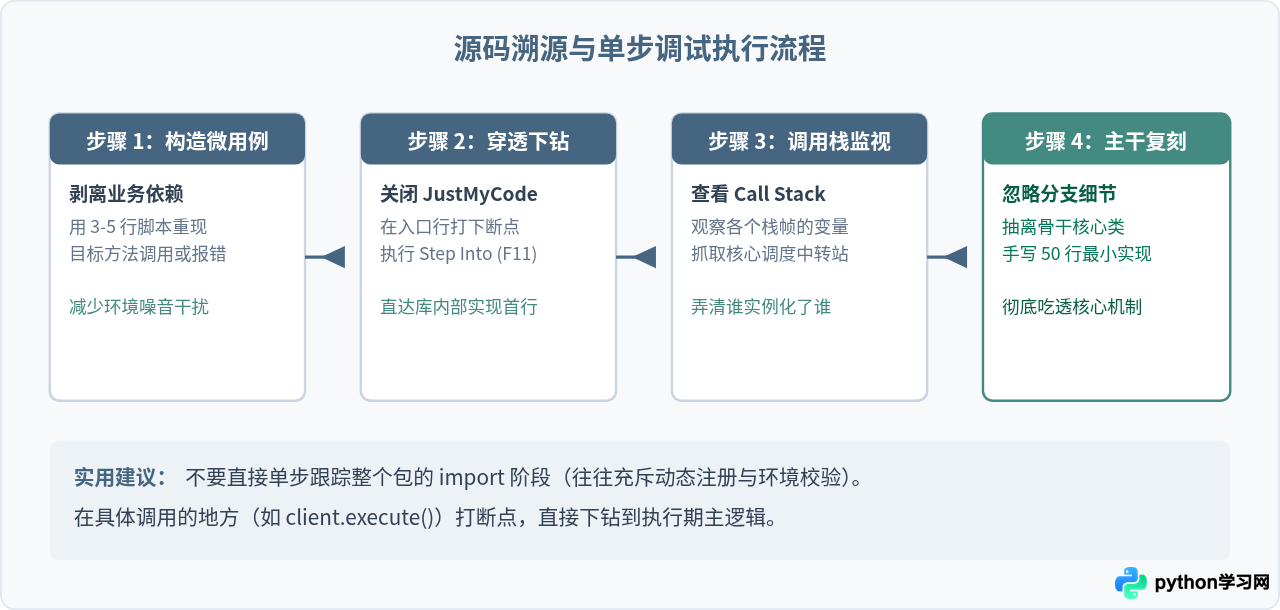
日常调试时,编辑器(如 VS Code 或 PyCharm)默认开启了“Just My Code”配置,单步调试(Step Into)会自动跳过三方库代码。进行源码探索时,需要显式放开这一限制:
- 在
VS Code的launch.json中,将调试配置中的"justMyCode": false设置为关闭状态。 - 在
PyCharm的Settings -> Build, Execution, Deployment -> Python Debugger中,取消勾选Do not step into library scripts。
三、第二阶段:从简入深——源码阅读的目标库选择与拆解顺序
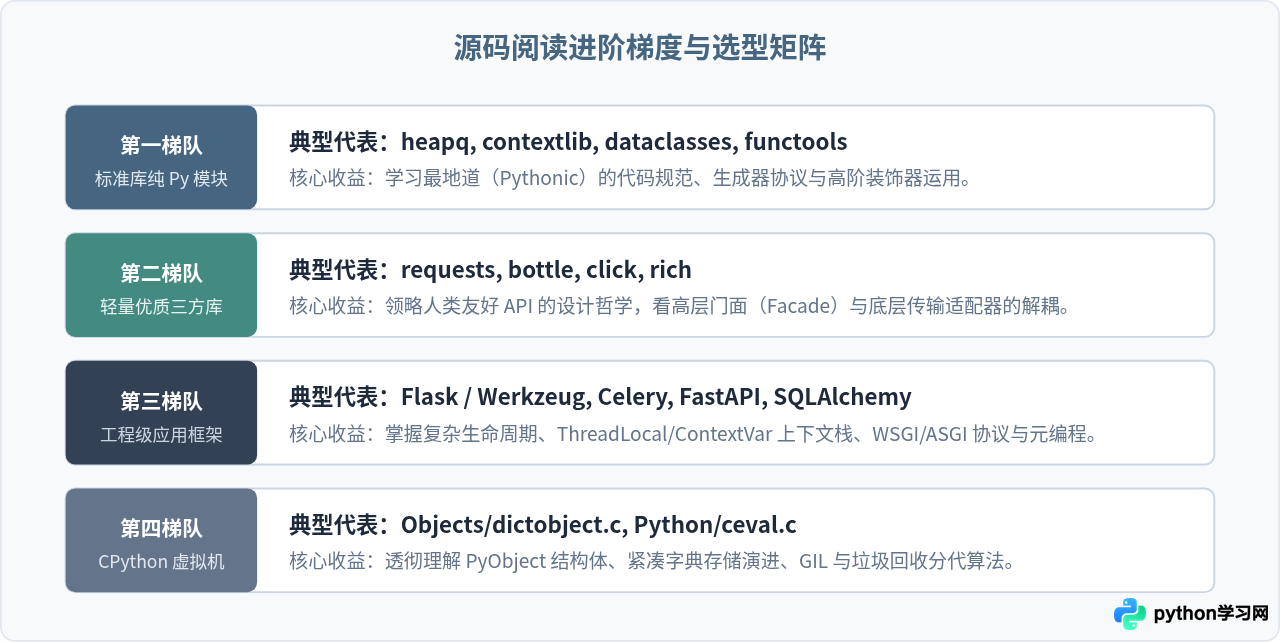
源码阅读最忌讳“直接啃大部头”。如果一开始就尝试精读 Django、Pandas 或 TensorFlow,庞大的历史包袱、C 扩展绑定和复杂的适配层会迅速消耗注意力。合理的跃迁路线必须遵循梯度原则。
1. 第一站:Python 标准库纯源码模块
Python 标准库是官方团队编写的范本,代码风格严谨且依赖极少。许多标准库文件直接保存在本地安装目录中(如 python/lib/contextlib.py)。
例如,阅读 contextlib.contextmanager 可以清晰了解:如何用一个生成器函数(yield)配合魔术方法 __enter__ 和 __exit__ 优雅地实现上下文管理器;阅读 heapq.py 可以观察纯 Python 如何实现二叉堆操作并在底部提供 C 加速版本的平滑降级处理。
2. 第二站:经典小巧的开源库
这一阶段的核心目标是学习优秀的软件工程分层。以 requests 为例,其核心代码量仅几千行,结构极为精简:
api.py:提供get(),post()等面向用户的门面函数;sessions.py:处理状态持久化、Cookie 合并与核心逻辑调度;models.py:定义数据模型Request,PreparedRequest,Response;adapters.py:挂载传输适配器,将上层封装交由底层的urllib3处理。
四、第三阶段:源码拆解的三步落地法(以 requests 为例实战推演)
掌握了选型与工具后,需要一套规范的方法论来指导阅读过程。以阅读 requests 为例,可以分为以下三个具体步骤:
步骤 1:构造最简用例,提取主干调用链
不要泛读,而是编写一段只包含最核心行为的代码并启动断点调试:
import requests

# 最简业务用例
resp = requests.get("https://httpbin.org/get", params={"id": "101"})
print(resp.status_code)
通过单步跟进(Step Into),可以迅速记录下核心链路的跃迁:
requests.api.get()内部调用requests.api.request('get', ...);requests.api.request()创建临时上下文sessions.Session()并调用session.request(...);session.request()将输入参数封装为未绑定的Request对象,并调用prep = session.prepare_request(req)生成PreparedRequest;session.send(prep, ...)根据 URL 的协议头(如https://)从适配器注册表中获取HTTPAdapter;adapter.send(prep, ...)调用urllib3.PoolManager进行真实的连接池提取和 Socket 数据传输。
关键收获:一旦绘制出这条仅包含 5 个关键调用的骨干链路,整个库的骨架就建立了。此时再去看重试机制、身份认证(Auth)或代理挂载,都不过是挂载在这条主干上的钩子(Hook)或中间处理步骤而已。
步骤 2:带着具体问题探索细节
建立骨架后,针对具体的设计意图提出问题,顺着代码找答案:
- 问题一:连接池是如何复用的?——在
adapters.py中查找HTTPAdapter.build_connection_pool_key,可以看到它以(scheme, host, port)为哈希键来管理urllib3.connectionpool.ConnectionPool实例。 - 问题二:为什么超时配置可以区分 connect 和 read?——跟踪
session.send()到adapter.send(),能看到元组格式的timeout=(3.0, 10.0)是如何解构成底层 Socket 的连接超时与读取等待时间的。
步骤 3:手写最小复刻实现(Mini-implementation)
验证是否真正理解源码的最高标准,不是“看懂了”,而是“能抽离核心写一个简版”。尝试用 50 到 80 行代码复刻核心设计模式:
# requests 核心设计架构的超简复刻版
import urllib.request

class SimpleResponse:
    def __init__(self, status_code, body):
        self.status_code = status_code
        self.body = body

class BaseAdapter:
    def send(self, request):
        raise NotImplementedError

class HTTPAdapter(BaseAdapter):
    def send(self, request):
        req = urllib.request.Request(request.url, method=request.method)
        with urllib.request.urlopen(req) as response:
            return SimpleResponse(response.status, response.read())

class SimpleSession:
    def __init__(self):
        self.adapters = {}
        # 挂载传输适配器模式
        self.mount("http://", HTTPAdapter())
        self.mount("https://", HTTPAdapter())

    def mount(self, prefix, adapter):
        self.adapters[prefix] = adapter

    def send(self, request):
        for prefix, adapter in self.adapters.items():
            if request.url.startswith(prefix):
                return adapter.send(request)
        raise ValueError(f"No adapter found for {request.url}")
五、源码阅读能力跃迁的闭环模型
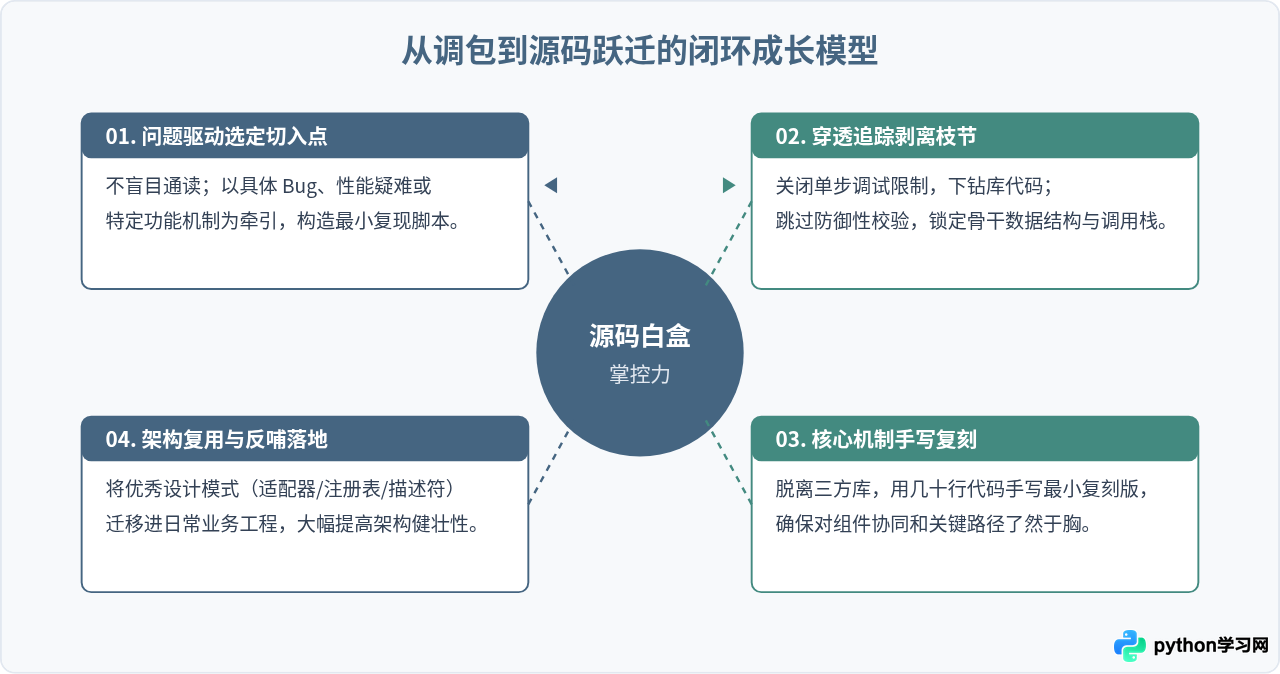
将上述实战经验沉淀下来,便形成了一个可复现的能力跃迁闭环:从具体的业务痛点出发,通过微用例定位调用链,再提炼出背后的通用架构范式,最终反哺到自己的业务架构中。
六、常见误区与避坑建议
在向源码阅读迈进的过程中,有几个常见误区容易让人事倍功半:
- 误区一:把读源码当成“读小说”。从项目第一个文件的第一行顺序往下读,极容易被环境兼容性、老版本降级逻辑或参数类型检验绕晕。正确做法:以运行时的动态执行流为主线,直奔核心触发点。
- 误区二:无目标闲逛。漫无目的地翻看代码库,往往过目即忘。正确做法:每次阅读前确立一个小问题,比如“我想弄明白 Flask 中的 g 变量在请求结束后是如何被自动销毁的”。
- 误区三:只读不记,只看不写。看完一遍觉得自己理解了,过两周全忘光。正确做法:在关键类和方法处绘制调用时序图,或者提炼出 50 行的骨干原型代码记录在技术博客或个人笔记中。
突破 Python 学习瓶颈并不是一蹴而就的记忆过程,而是不断推倒对黑盒的敬畏心、通过调试工具去亲手触碰真实对象的过程。当你习惯了从堆栈直达库源码底层的那一刻起,“调包侠”的瓶颈便已自然消除。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















