


Python读取Excel指定Sheet和行列数据的实现方法
详细讲解使用Python读取Excel指定工作表(Sheet)以及指定行、列数据的两种主流实现方法(pandas与openpyxl),包含原理剖析、坐标差异对比、完整代码示例与常见避坑指南。
在日常数据处理与办公自动化中,Excel文件往往包含多个工作表(Sheet)以及大量非目标数据。如果每次都将整个工作簿无差别读入内存,不仅增加程序耗时,还会产生多余的内存开销。本文将针对“指定Sheet”与“指定行列”这两个核心需求,详细讲解基于 pandas 和 openpyxl 的具体实现方案,并解析两者的机制差异与适用边界。
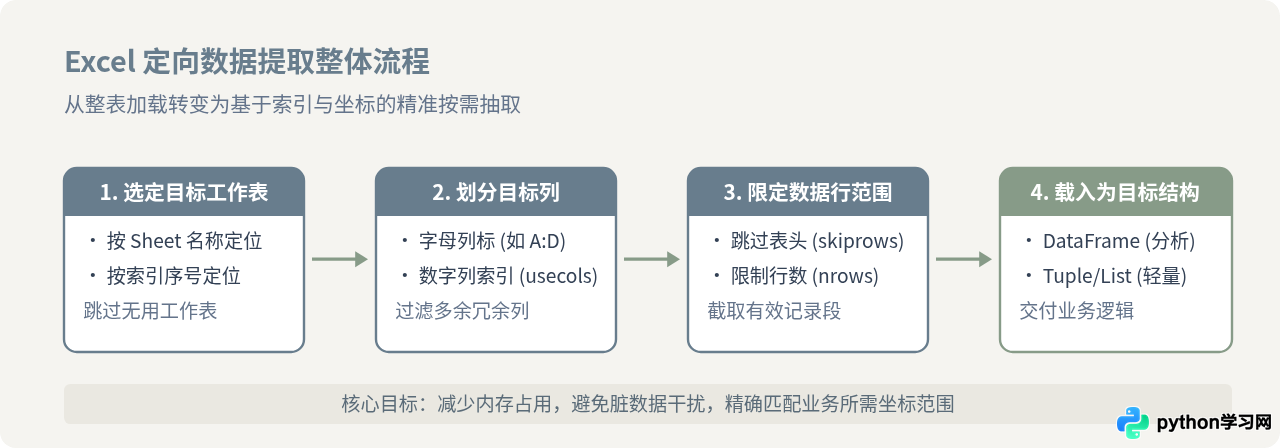
一、使用 pandas 读取指定 Sheet 与行列数据
pandas 是 Python 中处理表格数据的首选工具。其内置的 pd.read_excel() 函数封装了完整的参数体系,允许开发者在初次读入文件时直接过滤掉不必要的表格部分。
1. 环境准备
运行前确保安装了 pandas 以及处理 .xlsx 格式所必需的底层引擎 openpyxl:
pip install pandas openpyxl2. 指定 Sheet 的两种方式
通过参数 sheet_name 可以精确指定要加载的工作表:
- 按名称指定:如
sheet_name='销售明细'。适合工作簿内工作表顺序可能发生变动但名称固定的场景。 - 按索引编号指定:如
sheet_name=0(表示第1个Sheet)。适合Sheet名称动态生成但顺序恒定的场景。 - 同时读取多个Sheet:传入列表如
sheet_name=['Sheet1', 'Sheet2'],将返回一个以名称为键、DataFrame为值的字典。
3. 指定行与列的关键参数
pd.read_excel() 提供了非常直观的行与列过滤参数:
usecols(指定列):支持多种写法。可以传入 Excel 列字母范围(如"A:D,F"),也可以传入列索引列表(如[0, 1, 3])或列名列表。skiprows(跳过行):整数或列表。例如skiprows=2会跳过前2行,直接以第3行作为数据或表头。nrows(指定读取行数):整数。例如nrows=50,从有效起始行开始仅读取后50行数据。
4. 完整代码示例
import pandas as pd

# 目标文件路径
file_path = "financial_report.xlsx"

# 示例:读取名为 "Q3_Detail" 的工作表,仅读取 A、B、D 列,且跳过前两行说明文本,只取前100行数据
df = pd.read_excel(
    file_path,
    sheet_name="Q3_Detail",
    usecols="A:B,D",
    skiprows=2,
    nrows=100
)

# 查看读取结果的结构与前5行数据
print("读取形状 (行数, 列数):", df.shape)
print(df.head())注意:在默认情况下,pandas 会将 skiprows 之后的第1行视作列名(Header)。如果指定区域内本身不包含列名,请务必显式指定 header=None,否则第1行实际数据会被误当作字段名解析。
二、使用 openpyxl 精确按坐标读取数据
如果当前运行环境对资源要求极其苛刻,或者任务仅仅是提取少数几个特定单元格,引入整个 pandas 会显得较为臃肿。此时使用纯净的 openpyxl 库能够提供更轻量的解决方案。
1. 加载工作簿并选取工作表
openpyxl 采用面向对象的工作簿模型,通过字典索引方式直接获取目标工作表:
from openpyxl import load_workbook

# data_only=True 确保读取的是公式计算后的结果值,而非公式表达式本身
wb = load_workbook("financial_report.xlsx", data_only=True)

# 通过工作表名称获取 Worksheet 对象
ws = wb["Q3_Detail"]

# 或者通过 active 属性获取当前默认激活的 Sheet
# ws = wb.active
2. 指定行列读取的两种常用写法
openpyxl 提供了两种直观的读取模式:切片语法与迭代器。
- 切片坐标语法:使用类似
ws['A3:D10']的 Excel 风格范围表示法,返回一个嵌套元组。 - iter_rows 迭代器:使用
ws.iter_rows(min_row=3, max_row=10, min_col=1, max_col=4, values_only=True)。该方法支持指定最大/最小行列号,并且通过values_only=True直接返回单元格的数值,免去手动访问cell.value的繁琐操作。
3. 完整代码示例
from openpyxl import load_workbook

wb = load_workbook("financial_report.xlsx", data_only=True)
ws = wb["Q3_Detail"]

# 提取第3行到第10行、第1列(A)到第4列(D)的所有单元格数据
data_rows = []
for row in ws.iter_rows(min_row=3, max_row=10, min_col=1, max_col=4, values_only=True):
    data_rows.append(row)

# 打印提取到的行记录
for r in data_rows:
    print(r)

# 操作完毕后关闭工作簿句柄
wb.close()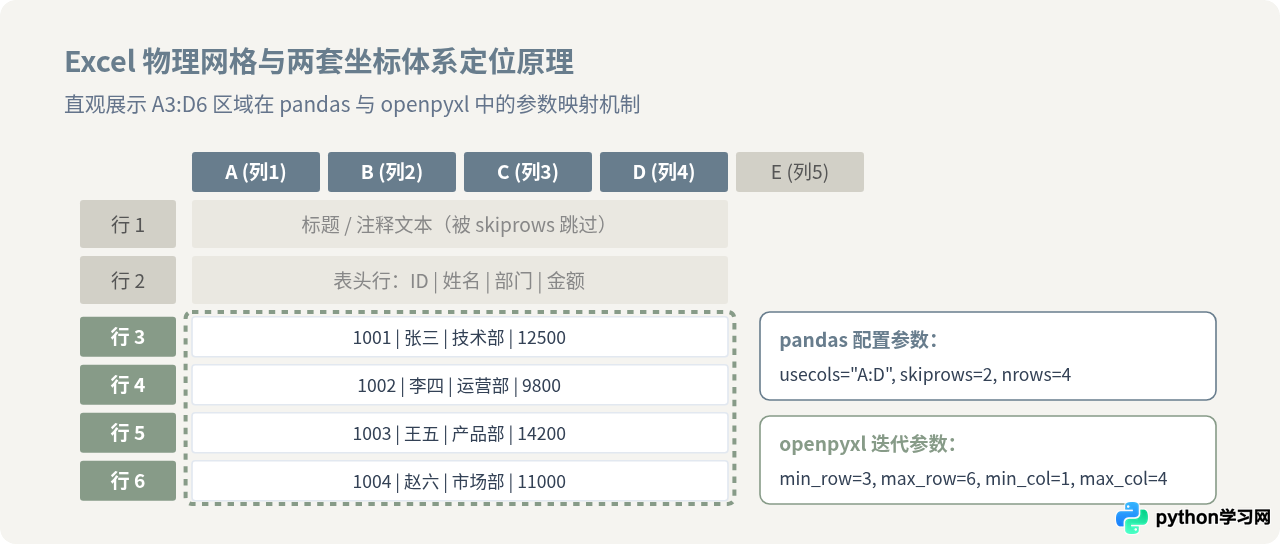
三、关键差异与技术方案对比
虽然两种方法均能实现指定工作表与行列的提取,但由于底层设计哲学不同,在索引基数、依赖体积及数据结构上存在显著差异:
为了在实际开发中快速抉择,下表归纳了两种做法在具体指标上的对照关系:
| 对比维度 | pandas.read_excel | openpyxl |
|---|---|---|
| 坐标系统 | 以 0 为起始索引(列名/数据切片) | 以 1 为起始索引(物理行号与列号) |
| Sheet 指定方式 | 名称字符串或 0-based 数字序号 | 工作表名称作为键(wb['name']) |
| 行列切片形式 | usecols="A:C", skiprows=n, nrows=m |
iter_rows(min_row, max_row, min_col, max_col) |
| 输出数据类型 | pandas.DataFrame |
tuple / 嵌套生成器 |
| 公式处理支持 | 自动转换为计算后结果 | 需设置 data_only=True 方可获取计算值 |
| 外部依赖重量 | 较重(需安装 numpy、pandas、openpyxl 等) | 轻量(仅依赖 openpyxl 原生库) |
四、实际应用中的常见易错点与注意事项
-
公式单元格读取出 None 的问题:
在使用openpyxl设置data_only=True读取含公式的表格时,如果该文件是由非 Excel 工具(如第三方脚本或简易导出库)生成的,且从未在真实 Excel 软件中打开保存过,Excel 缓存的结果值可能不存在,此时读取会返回None。如果必须读取公式计算值,需确保工作簿此前已被正规办公软件计算保存。 -
Sheet 名称前后的不可见空格:
经常有业务人员导出的工作表名称末尾带有空格(如"Sheet1 ")。在通过字符串匹配时会导致KeyError或警告。建议在动态脚本中先通过wb.sheetnames或pd.ExcelFile(path).sheet_names查看真实存在的表名列表,并配合strip()处理。 -
表头行导致行号发生偏移:
在pandas中使用skiprows=5时,第6行会被默认当成 DataFrame 的表头(columns),因此数据体(data rows)实际从第7行开始计算。若需保留第6行作为数据,必须设置header=None。 -
内存优化策略:
当目标 Excel 文件非常庞大(几十兆以上)而只需提取末尾几行时,openpyxl提供了只读模式load_workbook(..., read_only=True),它采用流式 XML 解析,极大减少了内存占用。
五、总结与技术选型建议
实现“Python读取Excel指定Sheet和行列数据”的技术核心在于:理清任务所处的数据形态,按需施加过滤参数。
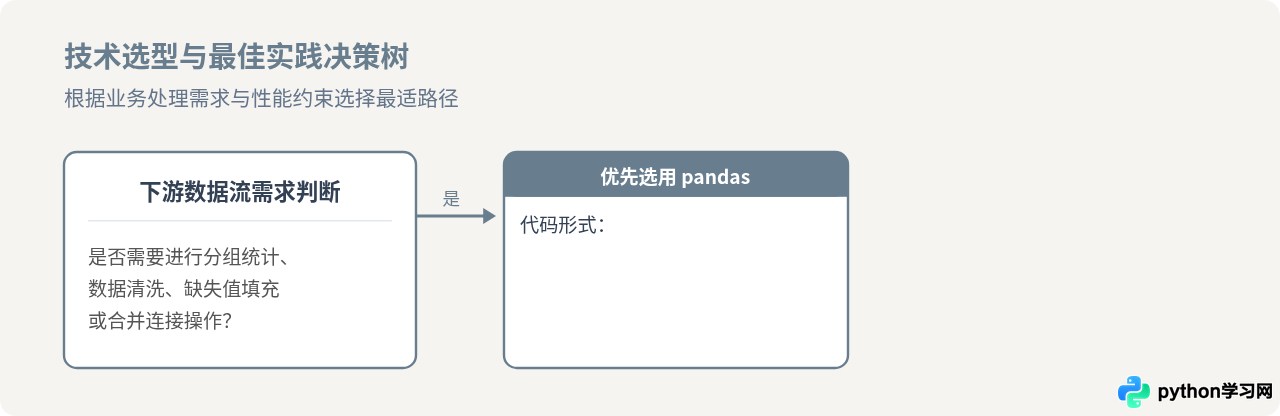
对于大部分面向报表汇总与数据统计的工程,直接使用 pandas.read_excel 配合 usecols、skiprows 和 nrows 是开发效率最高的选择;而在要求零重型依赖、极低资源占用、或者针对特定分散单元格坐标进行抽样的轻量级任务中,openpyxl 的坐标切片与 iter_rows 则具备不可替代的灵活性与确定性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















